


很多人在刚入门使用StableDiffusion(下文StableDiffusion我们简称SD)时候,会被各种各样的模型搞得一脸懵圈。什么是模型?什么Checkpoint模型,LoRa模型,VAE模型,究竟这些模型是干什么用的?
首先,我们要明白,模型是怎么来的,它是干什么用的?
我这里用一种比较通俗易懂的比喻,但是,不是很准确或者全面的解释,旨在大家都能听懂,给大家分享一下。模型,就是那些搞AI的程序员,给了一大堆数据给计算机,同时标记了这堆数据(后面都不用标记了)。例如,标记的数据是“猫”,然后电脑通过AI算法,能够将一大堆图片的里面像素数据跟“猫”这个字关联起来,形成复杂的数学公式(俗称算法)和数据。当计算机再遇到“猫”这个字的时候,通过数学公式和数据,也就是说这个模型,能够重新识别并把“猫”画出来。
好了,现在我们结合一下SD大名鼎鼎的模型库网站,C站,网址是:
https://civitai.com/(假如你上不了国外的网站,只能用国内的网站,这里,推荐一个国内的,https://tusiart.com/)梳理一下SD会用到的主要的模型,总结一下它们的主要作用:

上面这张图,是我在著名的C站上的一张截图,从截图的右侧可以看到,
StableDiffusion的模型主要分为几个种类,有CheckPoint,Embeding, Hypernetwork,Aesthetic
Gradient,LoRa,LyCORIS,Controlnet,Upscale,Motion,VAE,Poses,Wildcards,Workflows,Other。
1.CheckPoint模型。
我们俗称底模,一般模型体积较大,单个模型的大小一般在GB量级。这是使用StableDiffusion模型进行绘画的基础。它是别人训练,或者融合好的大型模型,里面集合了这个模型的参数、权重等。因此,一旦你选择了某个大模型,那么你SD出图的风格、画风已经相对确定了。
下面在我电脑找个模型, 和大家一起开启探索梳理之旅:
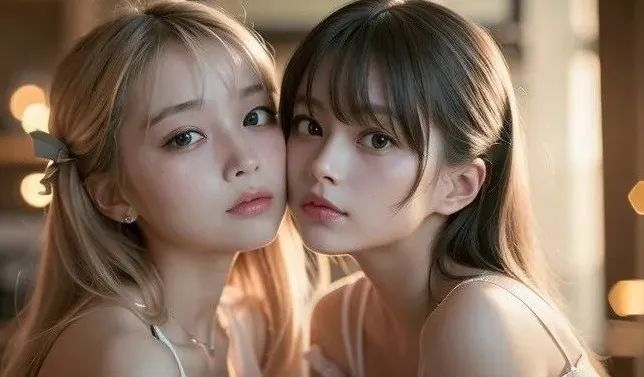

这个是在C站比较火的画美女的模型,生成出来的效果是这样子的:

我这里用到提示词:

使用SD进行绘画,必须要用到Checkpoint和VAE模型,不过现在有部分Checkpoint模型已经融合了VAE模型,所以就不需要单独下载和配置和VAE模型。
2.VAE模型
什么是VAE模型?我们用一种通俗的解释来讲,VAE模型主要有2种功能:
一种是滤镜(就像是PS、抖音、美图秀秀等)用到的滤镜一样,让出图的画面看上去不会灰蒙蒙的,让整体的色彩饱和度更高。
另一种是微调,部分VAE会对出图的细节进行细微的调整(个人觉得变化并不明显仅会对细节处微调)。
下面,我在C站下载一个Anything模型和VAE模型,体验和总结一下:


在没有使用VAE模型情况下,使用Angthing模型输出的照片,画风是这样子的:

我使用到的提示词是下面:

然后我们再外挂VAE模型之后,画风变成了这样:

提示词还是原来的那样,外挂刚才我再C站上下载的这个VAE模型,画风有很大变化:

从图片对比,可以很明显地看出来,添加VAE模型后,图片颜色饱和度更高,色彩更艳丽。
3、LoRa模型
我们知道,CheckPoint模型是整个绘画的基础,决定后续绘画内容基调和整体绘画风格,但是训练和修改一个基底模型需要大量的数据,较长的训练时间。那么,有没有一种办法能够,不通过重新训练基底模型,局部修改模型输出中我想要的那部分。例如,我希望上面输出的美女的长相比较接近某个人。模型实现微调面部的输出就可以了。那这时候,LoRa模型就出场了,LoRA模型一般体积不是很大,几十兆到一两百兆,主要用于处理大模型微调的问题。
简单来说,例如就是通过收集和整理某个人的面部数据,然后根据这些脸部数据,专门训练一个LoRA模型,为我们提供了更便捷,更自由的微调局部数据的输出。LoRA模型能够使我们在底模的基础上,进一步指定整体风格、例如指定人脸等等。例如所穿的衣服!
例如下面的例子,使用上面的底模,原始的输出,是这样子的:
下面是原来的提示词:
现在,我增加一个某知名明星刘姐姐的LoRA模型之后,就变成这样的输出:

这是更新后的提示词,可以发现,我们只需要引入LoRA模型,并设置该模型的权重,就可以改变整体的人物的面部输出的画风:

4、ControlNet模型
在说ControlNet模型之前,需要理解它的需求背景,在没有ControlNet模型前,输出结果的不稳定性,如下面提示词中,我们要求画4个女孩,画风是这样的,可以看到每次画画输出,每个女孩的姿势都是不一样的,没有办法稳定控制,那就没有办法商用,不然它只能是个玩具了。

提示词是这样的

ControlNet模型的主要作用,就是一种通过添加额外的模型,来控制大模型的某些方面的结果,ControlNet提供了一种增强稳定输出方法,使得StableDiffusion的输出能够变得更可控和预测,让StableDiffusion落地应用起到了重要的作用。其中,比如可以做出指定动作的姿势,下面四个女生的背影图曾经火爆一时,就是因为ControlNet模型的出现,解决了稳定控制这个问题。

上面只是ControlNet的简单应用之一,还有更多生成线稿图、线稿图上色(下图)、卡通变真人的各种神奇功能,这里面涉及很多的内容,都可以写一篇长的文章。在这里暂时就不多讲了,留到下篇文章,分享和讨论更多。

整体来讲ControlNet模型给出来的模型有8种,包括草图、边缘图像、语义分割图像、人体关键点特征、霍夫变换检测直线、深度图、人体骨骼等。其中每一种都有很多种应用方式,使用得好就能发挥神奇的功效。
5、HypernetWork模型
中文翻译为超文本网络模型,HypernetWork模型可以通过学习已知的图像集合,用于影响影响大模型的绘画的风格,生成新一种新风格的图像。这种模型可以被看作是一个风格生成器,它可以接收一些风格模型为输入,并输出一张新风格的图像。。
下面,C站下载一个叫Water element的模型给大家演示一下:

没有添加HypernetWork模型,输出画风是这样子的:

它的提示词是这样:

然后,我们在这个基础上,添加了HypernetWork模型后,输出的画风是这样子的:

可以看出HypernetWork,满屏水润的感觉,更新后的提示词是这样子的:

增加了一个water elemental的提示词,整个画面的风格,都变得非常的水润。
6、Embedding模型
也叫文本倒置(Textual
Inversion)模型,大家也称呼为私炉。通俗一点的解释是,我们训练出的大模型,通常都很粗范,也就是说当遇到想要生成特殊风格的图像时,往往很难通过提示词来让大模型生成。因为大模型在当初训练时难以做到面面俱到,没有含有这个场景和要素,对于特殊的新概念的风格并没有单独训练过,所以当你用这个大模型想生成某种只有你或少数人才知道的特殊的新风格时,对应的特殊的新提示词在这个大模型上就无法起到作用。

如何解决这个问题?此时,你便需要在这个大模型基础上进行 Textual Inversion
训练。你可以按照自己的需要起名字以描述这种特殊风格或物体的词汇,比如上图中的“S*”,我们用这个新词汇来代指一种新的风格。
上图中第一行里展示了用四张无头打坐的小雕像图形训练出一个“S* “。“S* ” 这个新词就代表了 Textual Inversion
训练的结果,也代表了生成出的 Embedding模型的名称。
下面,我在C站下载一个古埃及风格的Embedding模型给你大家演示一下:

在没有添加这个Embedding模型的时候,正常的画风是这样的:

添加了这个embedding模型之后,添加了这个模型的Style-Hamunaptra提示词之后,画风换成是这样的:

下面是这个这次绘画的提示词:

可以看到,整个画风有了很大的变化,只是添加了一个embedding模型和该模型的提示词。
7、Upscale模型
即我们常说的放大模型,这个模型主要用途是放大图片,增补细节,让生成更高质量的图片。要先理解这个模型的需求背景,显卡的显存资源是十分有限的,高端显卡是不便宜的,在绘画的时候,设置较大的图片尺寸,较高的精度,会让很多小显存的显卡吃不消,直接报错显存不足。如何解决这个问题?就是通过的这个放大模型进行解决,先画一张小的图片,当你获得一张或者是多张满意的图片之后,再一张或者多张,使用放大模型,进行图片批量放大。

下面我在C站,下载4x-Ultrasharp模型给大家演示一下
我们下载安装之后,就在后期处理中,新增了这个放大算法:

下面我们对比一下高清放大后的效果:

8、LyCORIS模型
我们可以理解它为LoRA模型算法的加强版本,LyCORIS比LoRA信息承载量更高,控制的信息更多,它比LoRA更强大一些,它修改了模型的更多部分。但是,不是说使用LyCORIS了的模型,就一定比使用LoRA的模型的效果好。模型效果好不好,很核心一点的是,在训练模型的时候所采用的训练数据的质量如何,使用,糟糕数据来训练LyCORIS模型,效果一定比不上使用优质数据训练LoRA的模型出来的模型的效果。只能说LyCORIS比LoRA的算法更优秀。
在C站暂时也没有找到使用同一批数据训练出来,LoRA和LyCORIS模型,也不好比较,大家只要知道,LyCORIS算法比LoRA更好,更高级就好。
9、Aesthetic Gradient模型
中文翻译为美学梯度模型,其实和上面Embedding模型要实现的目标差不多,
也就是说通过自己所训练的模型,实现照片的私有特殊的风格化。只是一种和Embedding比较新算法和实现方式。
同样,我们使用一张C站上的模型来测试一下效果:

它的提示词是这样的:

应用了官方的模型之后的效果是这样的:


10、Poses模型
Pose,顾名思义就是姿势,在Stable
Diffusion软件里面是没有专门的Pose模型选项,只是C站将一些用于控制姿势如ControlNet的模型,单独建立一个分类,方便用户查找这个功能类别,其本质都是一些用户控制输出的姿势ControlNet模型或者是其他类型模型集合。我们打开一个C站的模型看看就知道了。

关于如何控制姿势和使用ControlNet模型,放到另外一篇文章来梳理吧,确实知识点满满。
11、Motion模型
顾名思义,运动模型。这个模型主要是,要配合使用的SD的一个插件AnimateDiff,它的作用,是帮你将一张图片生成一个动画。在写这篇文章的时候OpenAI已经发布了Sora,能够秒杀这个SD插件的效果。从我测试来看,像我手上这台机器的40系列N卡的机器,6G显存,都是只是生成1秒的512*512的视频,还是算了吧,直接放弃。
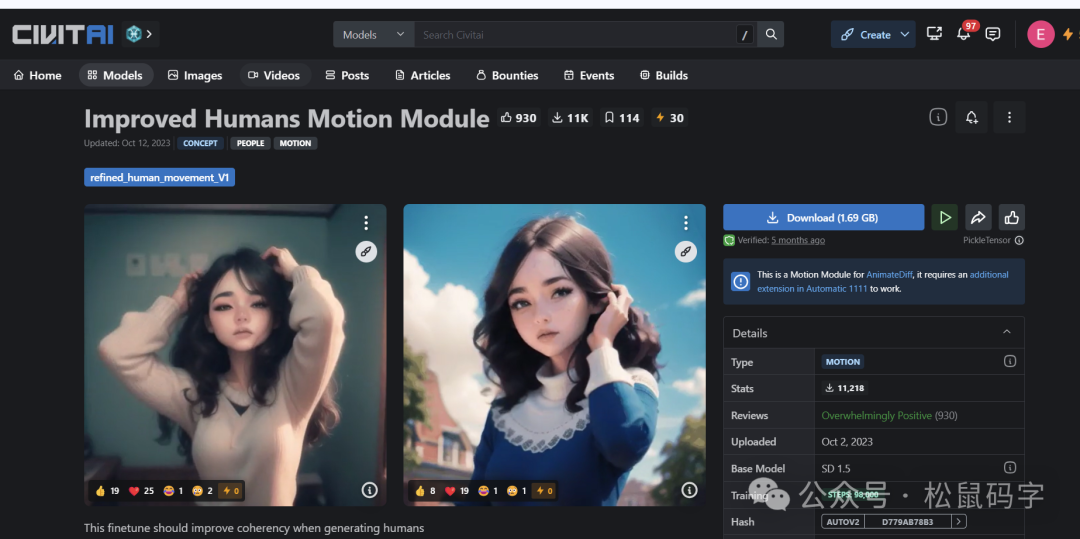
同样地,我们在C站下载模型来体验一下


生成了下面的动画:

12、Wildcards模型
Wildcards的中文意思就是*通配符。这些模型要配合SD的一个插件stable-diffusion-webui-
wildcards来使用。模型的文件就是一堆txt文件,这个插件的作用是允许你将一些提示词,写一个例如color.txt的txt文件,内容范例:
yellow
green
然后,你就可以在提示词中,使用类似 1 girl, wearing a color shirt
这样的通配符批量生成图片。我觉得可以在另外一篇文章介绍一下这个模型,更多的是需要讲这个插件的使用操作流程。
13、Workflow模型,
里面主要是ComfyUI模型,ComfyUI 是一个基于节点工作流形式的stable diffusion AI 绘图工具WebUI, 通过将stable
diffusion的流程拆分成节点,实现了更加精准的工作流定制和完善的可复现性。
经过上面的梳理。我们可以发现,SD用到的模型,可以简单归纳为几个方面下面:
Checkpoint模型:SD画图的底模,决定后续画风的内容和基本输出风格。
VAE模型:类似在底模上加一层滤镜,微调输出的风格,但是现在很多Checkpoint模型已经合并了VAE模型。
LoRA和LyCORIS模型:在底模的基础上,训练出某部分特征的模型,然后将这部分应用到底模,实现底模某部分的修改,如修改脸部外貌,修改衣服等元素。
ControlNet模型:主要解决了画图输出不稳定问题,通过使用ControlNet模型,稳定输出人物姿势,图像景深等。
Embedding/HypernetWork/Aesthetic Gradient模型,主要是在底模的基础修改画面的风格,只是实现的算法和方式有所不同。
Motion主要是AnimateDiff插件和对应的模型实现,Sora出来后,基本可以放弃了。
Workflow模型:主要是ComfyUI的工作流模板。
Wildcard模型:就是一堆txt文件,配合该SD插件,实现在提示词中使用通配符代表文件里面的每一行。
以上各大模型插件我已整理放在网盘中,有需要的小伙伴文末扫码获取~
针对各位AIGC初学者,这里列举了一条完整的学习计划,感兴趣的可以阅读看看,希望对你的学习之路有所帮助,废话不多说,进入正题:

目标应该是这样的:
第一阶段(30天):AI-GPT从入门到深度应用
该阶段首先通过介绍AI-GPT从入门到深度应用目录结构让大家对GPT有一个简单的认识,同时知道为什么要学习GPT使用方法。然后我们会正式学习GPT深度玩法应用场景。
-----------
- GPT的定义与概述
- GPT与其他AI对比区别
- GPT超强记忆力体验
- 万能GPT如何帮你解决一切问题?
- GPT表达方式优化
- GPT多类复杂应用场景解读
- 3步刨根问底获取终极方案
- 4步提高技巧-GPT高情商沟通
- GPT深度玩法应用场景
- GPT高级角色扮演-教学老师
- GPT高级角色扮演-育儿专家
- GPT高级角色扮演-职业顾问
- GPT高级角色扮演-专业私人健身教练
- GPT高级角色扮演-心理健康顾问
- GPT高级角色扮演-程序UX/UI界面开发顾问
- GPT高级角色扮演-产品经理
- GPT高级技巧-游戏IP角色扮演
- GPT高级技巧-文本冒险游戏引导
- GPT实操练习-销售行业
- GPT实操练习-菜谱推荐
- GPT实操练习-美容护肤
- GPT实操练习-知识问答
- GPT实操练习-语言学习
- GPT实操练习-科学减脂
- GPT实操练习-情感咨询
- GPT实操练习-私人医生
- GPT实操练习-语言翻译
- GPT实操练习-作业辅导
- GPT实操练习-聊天陪伴
- GPT实操练习-育儿建议
- GPT实操练习-资产配置
- GPT实操练习-教学课程编排
- GPT实操练习-活动策划
- GPT实操练习-法律顾问
- GPT实操练习-旅游指南
- GPT实操练习-编辑剧本
- GPT实操练习-面试招聘
- GPT实操练习-宠物护理和训练
- GPT实操练习-吸睛爆款标题生成
- GPT实操练习-自媒体爆款软件拆解
- GPT实操练习-自媒体文章创作
- GPT实操练习-高效写作推广方案
- GPT实操练习-星座分析
- GPT实操练习-原创音乐创作
- GPT实操练习-起名/解梦/写诗/写情书/写小说
- GPT提升工作效率-Word关键字词提取
- GPT提升工作效率-Word翻译实现
- GPT提升工作效率-Word自动填写、排版
- GPT提升工作效率-Word自动纠错、建议
- GPT提升工作效率-Word批量生产优质文章
- GPT提升工作效率-Excel自动化实现数据计算、分析
- GPT提升工作效率-Excel快速生成、拆分及合并实战
- GPT提升工作效率-Excel生成复杂任务实战
- GPT提升工作效率-Excel用Chat Excel让效率起飞
- GPT提升工作效率–PPT文档内容读取实现
- GPT提升工作效率–PPT快速批量调整PPT文档
- GPT提升工作效率-文件批量创建、复制、移动等高效操作
- GPT提升工作效率-文件遍历、搜索等高效操作
- GPT提升工作效率-邮件自动发送
- GPT提升工作效率-邮件自动回复
- GPT接入QQ与QQ群实战
- GPT接入微信与微信群实战
- GPT接入QQ与VX多用户访问实战
- GPT接入工具与脚本部署实战
第二阶段(30天):AI-绘画进阶实战
该阶段我们正式进入AI-绘画进阶实战学习,首先通过了解AI绘画定义与概述 ,AI绘画的应用领域 ,PAI绘画与传统绘画的区别 ,AI绘画的工具分类介绍的基本概念,以及AI绘画工具Midjourney、Stable Diffusion的使用方法,还有AI绘画插件和模板的使用为我们接下来的实战设计学习做铺垫。
- -----------
AI绘画定义与概述 - AI绘画的应用领域
- AI绘画与传统绘画的区别
- AI绘画的工具分类介绍
- AI绘画工具-Midjourney
- AI绘画工具-百度文心一格
- AI绘画工具-SDWebUI
- AI绘画工具-Vega AI
- AI绘画工具-微信中的AI绘画小程序
- Midjourney学习-Discord账号的注册
- Midjourney Bot界面讲解
- Midjourney提示词入门
- Midjourney高级提示词
- Midjourney版本参数学解读
- Midjourney功能参数
- Midjourney上采样参数
- AI绘画组合应用1-Midjourney + GPT
- AI绘画组合应用2-Stable Diffusion + GPT
- AI绘画组合应用3-AI绘画+ GPT +小红书
- AI绘画组合应用4-AI绘画+ GPT +抖音
- AI绘画组合应用5-AI绘画+ GPT +公众号
- AI绘画组合应用6-AI绘画+ GPT + AI视频
- AI绘画组合应用7-AI绘画+ GPT + 小说人物/场景
- AI绘画设计-Logo设计
- AI绘画设计-套用万能公式
- AI绘画设计-引用艺术风格
- AI绘画设计-GPT加速设计方案落地
- AI绘画设计-Vega AI渲染线稿生成设计
- AI绘画设计-摄影
- AI绘画设计-头像设计
- AI绘画设计-海报设计
- AI绘画设计-模特换装
- AI绘画设计-家具设计
- AI绘画设计-潘顿椅设计
- AI绘画设计-沙发设计
- AI绘画设计-电视柜设计
- AI绘画设计-包装设计的提示词构思
第三阶段(30天):AI-视频高段位
恭喜你,如果学到这里,你基本可以找到一份AIGC副业相关的工作,比如电商运营、原画设计、美工、安全分析等岗位;如果新媒体运营学的好,还可以从各大自媒体平台收获平台兼职收益。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- -----------
AI视频定义与概述 - AI视频制作-方案与创新
- AI视频制作-各种工具实操
- AI视频制作-美学风格(油画/插画/日漫/水墨)
- AI视频制作-形象设定(人物形象服装/造型/表情)
- AI视频画面特效处理
- AI视频画面拼接
- AI视频画面配音
- AI视频画面包装
- AI视频锁定人物逐一精修
- 多种表情动作/情节
- 动态模型转换-视频内部元素关键帧
- 动态模型转换-图像整体运动
- 动态模型转换-虚拟人
- 动态模型转换-表面特效
- AI自媒体视频-深问GPT,获取方案
- AI自媒体视频-风格设置(诗歌/文言文等)
- AI自媒体视频-各行业创意视频设计思路
- AI视频风格转换
- AI视频字数压缩
- AI视频同类型衍生
- AI视频Pormpt公式
第四阶段(20天):AI-虚拟数字人课程
- -----------
AI数字人工具简介 - AI工作台界面功能展示及介绍
- AI数字人任务确定
- AI数字人素材准备
- AI知识、语料的投喂
- AI模型训练
- AI训练成果展示及改进
- AI数字人直播系统工具使用
- AI人物在各平台直播
- AI数字人在OBS平台直播
第五阶段(45天以上):AIGC-多渠道变现课程
该阶段是项目演练阶段,大家通过使用之前学习过的AIGC基础知识,项目中分别应用到了新媒体、电子商务等岗位能帮助大家在主流的新媒体和电商平台引流和带货变现。
-----------
- AI-小红书引流变现
- AI-公众号引流变现
- AI-知乎引流变现
- AI-抖音引流/带货变现
- AI-写作变现
- AI-B站引流变现
- AI-快手引流变现
- AI-百家号引流变现
- AI-制作素材模板出售变现
- AI-周边定制变现
- AI-手机壳图案定制变现
- AI-周边产品定制变现
- AI-服装图案定制变现
- AI-个性头像定制变现
- AI-起号与知识付费变现
- AI-实现淘宝销售变现
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名AIGC的正确特征了。
这份完整版的AIGC资料我已经打包好,需要的点击下方二维码,即可前往免费领取!
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


