文生图技术的天花板:从Midjourney到Stable Diffusion 3的全面解析

Stable Diffusion 工作原理:潜在空间、扩散过程与交叉注意力三模块解析 潜在扩散模型(LDM)是当前主流文生图技术的底层范式,其核心在于将图像生成解耦为‘压缩—去噪—重建’三阶段工程流程。通过变分自编码器(VAE)构建语义密集的潜在空间,大幅降低计算复杂度;依托前向/后向扩散机制,将图像生成转化为稳定的噪声预测任务;再借助交叉注意力实现文本指令对像素级生成的动态引导。这种设计兼顾了生成质量、推理效率与可控性,广泛应用于AI绘画、设计辅助、游戏资产生成等场景。本文深入剖析 Stable Diffusion 中潜在空间、扩散过程与交叉注意力三大关键技术模块的协同逻辑与工程实现。 阅读详情

想象一下,你只需动动嘴,就能把脑海中的画面变成现实,这听起来是不是很神奇?这就是文生图技术的神奇之处!近年来,文生图(Text-to-Image)技术在人工智能领域的热度持续攀升。这项技术通过自然语言描述生成高质量的图像,结合了自然语言处理(NLP)和计算机视觉(CV)两大领域,在艺术创作、广告设计、虚拟现实等多个领域展现出广泛的应用前景。今天,我们将带你深入了解两大流行工具Midjourney和Stable
Diffusion,以及最新的Stable Diffusion 3版本的安装和使用方法。

第一章:Midjourney vs Stable Diffusion,你选哪一个?

Midjourney和Stable Diffusion都是目前最流行的AI图像生成工具,它们都可以根据文字描述(prompt)生成令人惊叹的图像。

Midjourney

主要在Discord服务器上运行,需要注册Discord账号并加入Midjourney服务器才能使用。

  • 使用方式:通过输入 /imagine 命令和文字描述生成图像。

  • 风格倾向:擅长生成梦幻、艺术性、富有想象力的图像,风格独特。

  • 操作简便性:相对容易上手,对新手友好,但参数控制较少。

  • 商业化:付费订阅制,根据订阅等级提供不同的功能和使用权限。

Stable Diffusion

开源软件,可以在本地电脑、云端服务器或在线平台上运行。

  • 使用方式:需要一定的技术基础,下载安装软件或配置环境,并学习使用代码或界面进行操作。

  • 风格倾向:风格多样化,可根据训练数据集和参数调整生成不同风格的图像。

  • 操作简便性:操作相对复杂,需要一定的学习成本,但参数控制精细,可定制化程度高。

  • 商业化:开源免费,可以自由使用和修改,但也有一些商业化版本和服务。

对比总结

Midjourney 和 Stable Diffusion
各有优势。前者更侧重于艺术创作和广告设计,提供多样化风格和快速生成的能力;后者则以高分辨率、稳定性和扩展性见长,适用于科学研究、游戏影视和虚拟现实等领域。根据具体需求和应用场景选择合适的技术,可以更好地发挥它们的优势。

当然,费用也是考虑的因素,Midjourney需要每月支付订阅费,而Stable Diffusion则是完全开源免费,可实现本地电脑部署。

第二章:Stable Diffusion 3的进化与应用

Stable Diffusion
发展迅速,从基础的1.0版本到高性能的2.0和2.1版本,再到扩展性强的XL版本和轻量化的Lite版本,已经上月刚推出的SD3。Stable
Diffusion 为文本生成图像提供了多种解决方案,满足了不同的技术需求和应用场景。不同版本的对比,如下图所示。

除了官方版本,Stable Diffusion
强大的开源特性催生了众多社区爱好者和研究者在其基础上进行改进和优化,衍生出各种各样的Checkpoint模型,例如:

  • Anything v3: 以生成二次元人物和场景著称,画风精美,细节丰富。

  • ChilloutMix: 擅长生成亚洲人像,人物真实自然。

  • Deliberate: 风格更加写实,擅长生成细节丰富的场景和物体。

  • Realistic Vision: 专注于生成高度写实的图像。

为了让更多用户能够在低配置设备上体验 Stable Diffusion,也出现了一些轻量化版本,例如:

  • Waifu Diffusion: 专门用于生成二次元人物,模型体积更小,对硬件要求更低。

  • Stable Diffusion WebUI: 提供网页版操作界面,无需安装软件,降低了使用门槛。

第三章:Stable Diffusion 3的安装指南

目前,使用最新的SD3有两种途径,分别是:本地部署和登录liblib.art进行在线生图。今天我们介绍本地电脑部署SD3的方法。

1. 下载模型

登录 Hugging Face ,根据需求下载相应的模型:

下载地址为:
https://huggingface.co/stabilityai/stable-diffusion-3-medium

sd3_medium.safetensors: 基础模型

sd3_medium_incl_clips.safetensors: 基础+clips模型

sd3_medium_incl_clips_t5xxlfp16.safetensors 和
sd3_medium_incl_clips_t5xxlfp8.safetensors: 两个训练后的向量化模型

2. 下载并安装ComfyUI

从 GitHub 下载ComfyUI,解压缩后可以直接使用,根据实际情况选择CPU计算或GPU计算。

下载地址如下:
https://github.com/comfyanonymous/ComfyUI

3. 安装汉化包

可选择安装汉化包
AIGODLIKE-ComfyUI-Translation,将 ZIP 包解压到 ComfyUI\custom_nodes 目录中。

下载地址如下:
https://github.com/AIGODLIKE/AIGODLIKE-ComfyUI-Translation

第四章:使用指南

1,执行批处理文件开启程序。

2,选择大模型。

3,分别在正向和反向提示词中输入提示词。

4,输入图片生成大小和数量。

5,载入并执行提示词。

第五章:总结回顾

文生图技术正以惊人的速度发展,Midjourney 和 Stable Diffusion 在这一领域各展所长。Midjourney
以其艺术创作和广告设计的独特风格吸引了大量用户,而 Stable Diffusion
则凭借其高分辨率、稳定性和开源特性,成为众多研究和应用项目的首选工具。通过了解和掌握这些技术,我们可以在各自的领域中创造出更多令人惊叹的作品和应用。

`

但由于AIGC刚刚爆火,网上相关内容的文章博客五花八门、良莠不齐。要么杂乱、零散、碎片化,看着看着就衔接不上了,要么内容质量太浅,学不到干货。

这里分享给大家一份Adobe大神整理的《AIGC全家桶学习笔记》,相信大家会对AIGC有着更深入、更系统的理解。

有需要的朋友,可以长按下方二维码,免费领取!

AIGC所有方向的学习路线思维导图

这里为大家提供了总的路线图。它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。如果下面这个学习路线能帮助大家将AI利用到自身工作上去,那么我的使命也就完成了:
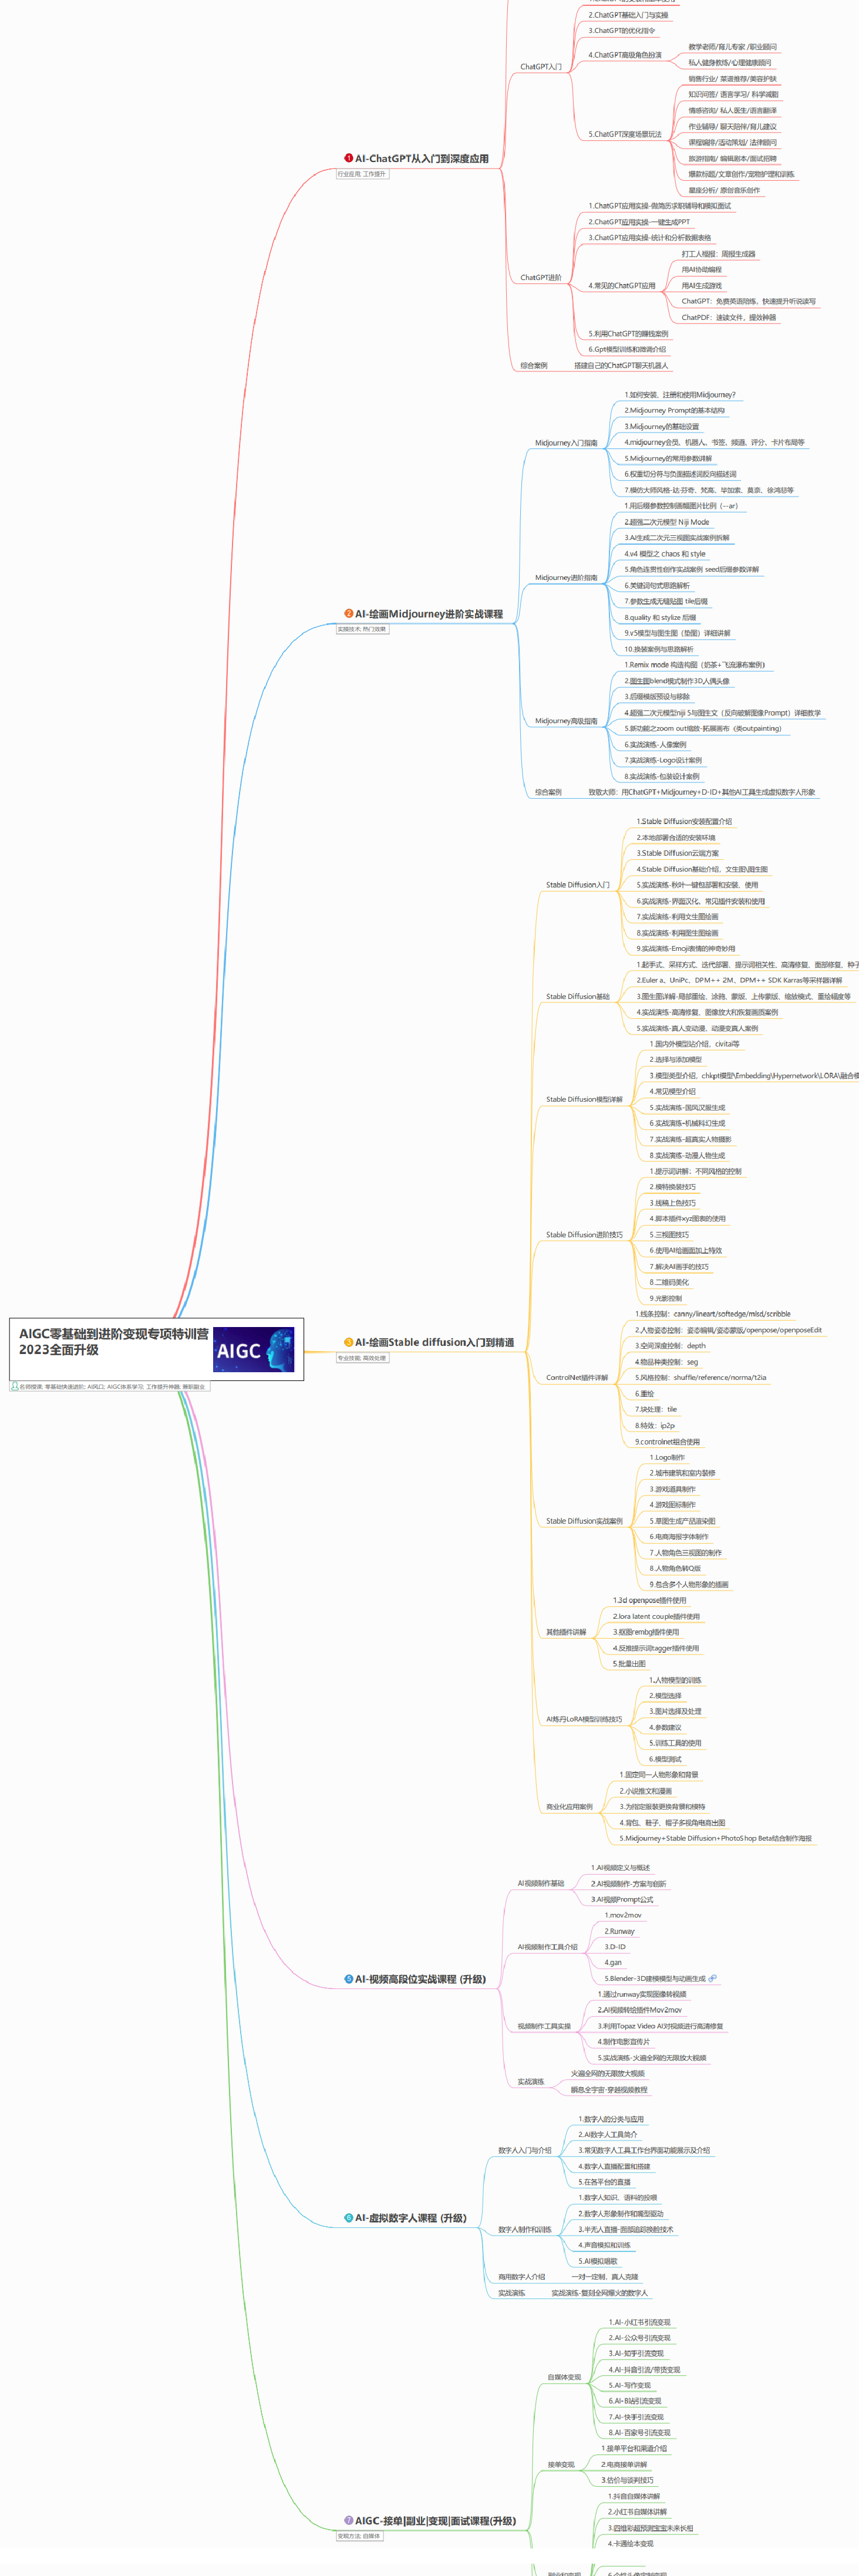
在这里插入图片描述

AIGC工具库

AIGC工具库是一个利用人工智能技术来生成应用程序的代码和内容的工具集合,通过使用AIGC工具库,能更加快速,准确的辅助我们学习AIGC
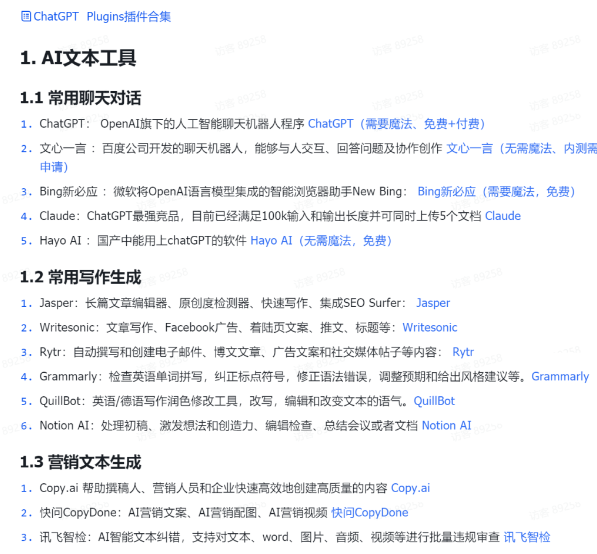
在这里插入图片描述

有需要的朋友,可以点击下方卡片免费领取!

精品AIGC学习书籍手册

书籍阅读永不过时,阅读AIGC经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验,结合自身案例融会贯通。
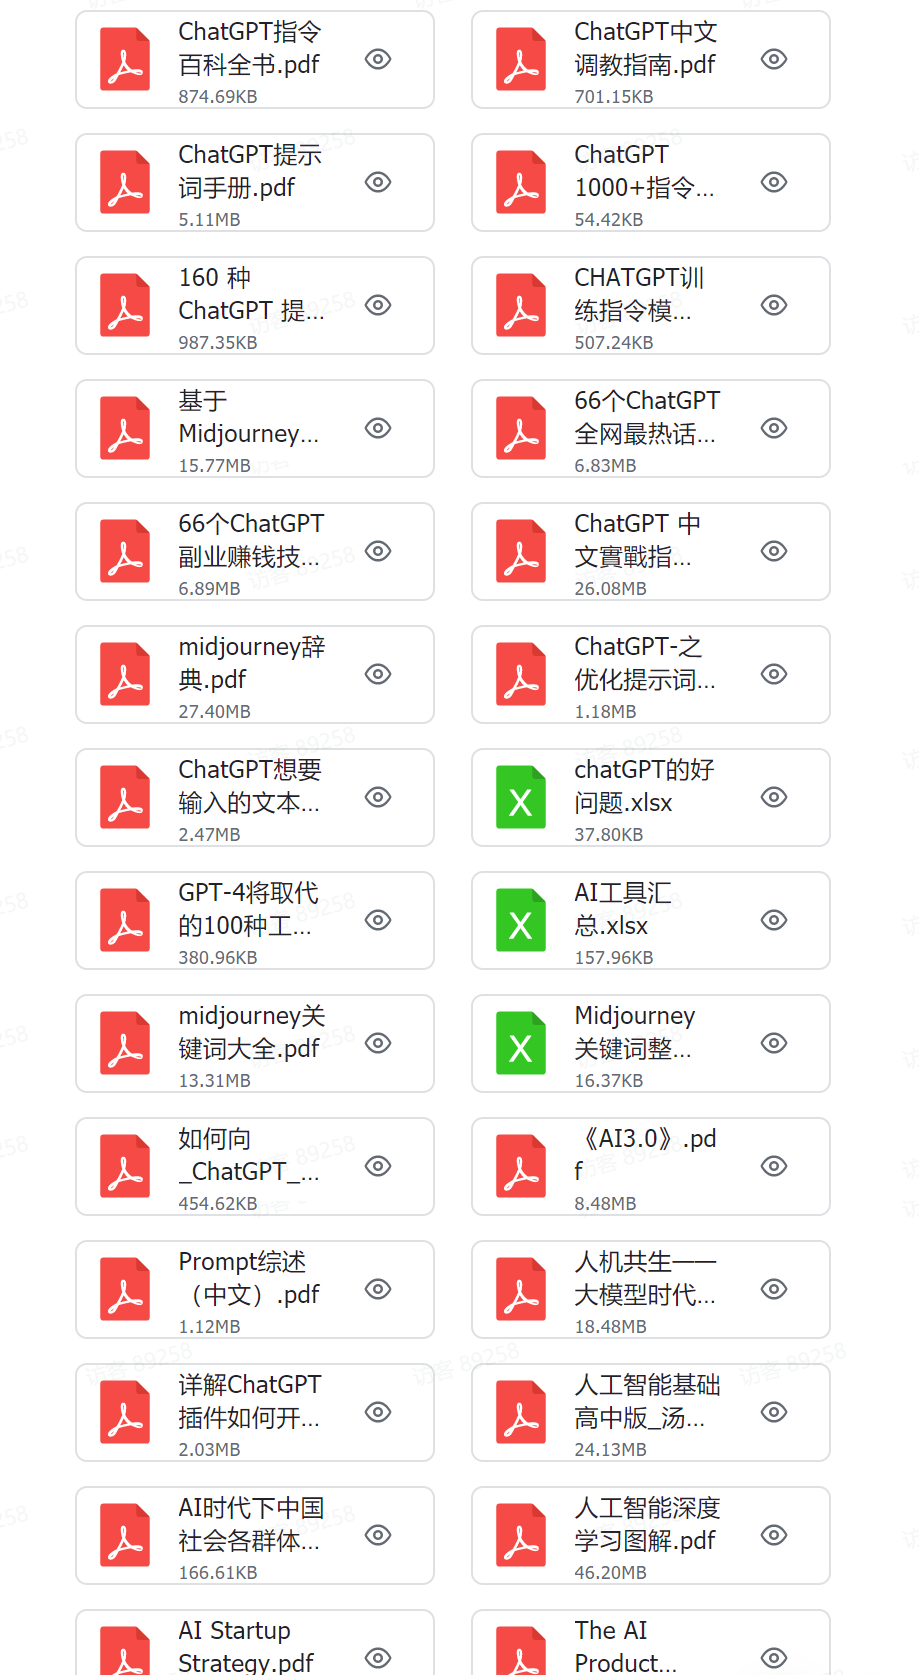
在这里插入图片描述

AI绘画视频合集

我们在学习的时候,往往书籍源码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,科学有趣才能更方便的学习下去。
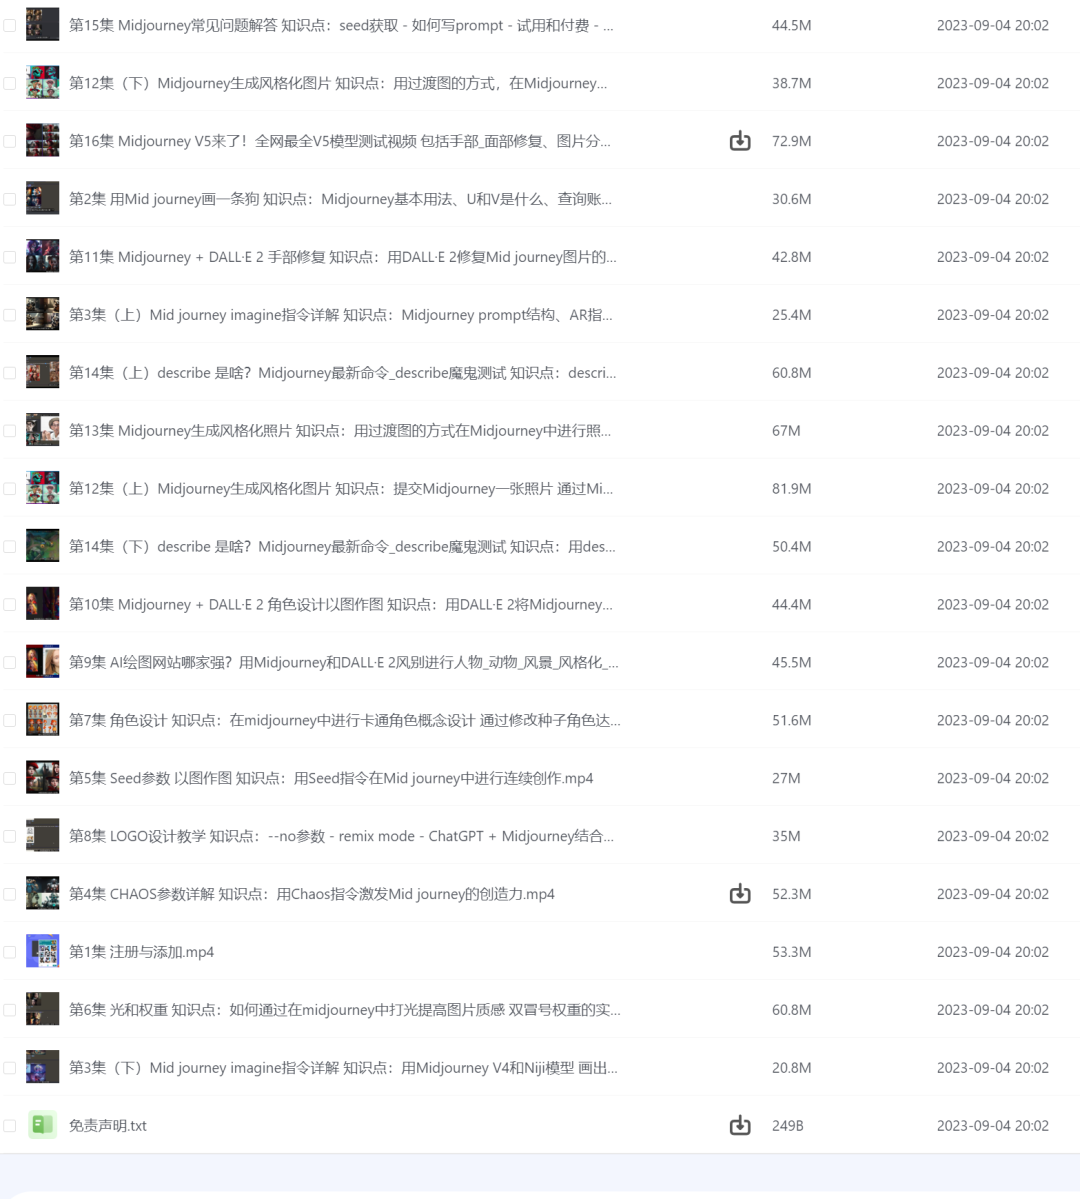
在这里插入图片描述

有需要的朋友,可以长按下方二维码,免费领取!

AIGC训练师面试指南:从模型原理到工程落地的核心能力解析 在人工智能生成内容(AIGC)领域,模型训练与微调是核心技术环节,它决定了生成内容的质量与可控性。其原理在于通过算法让模型从数据中学习特定模式或风格,例如使用LoRA等参数高效微调技术,可以在有限资源下快速适配新任务。这项技术的核心价值在于将前沿的大模型能力与具体业务需求高效对接,实现从技术潜力到商业价值的转化。其应用场景广泛,涵盖营销文案生成、游戏原画设计、电商素材制作等多个需要个性化、规模化内容生产的领域。本文聚焦于AIGC训练师这一新兴岗位,深入剖析其在模型调试、效果评估及全流程部署中所需的关键技能与 阅读详情

相关推荐

AI绘画工作流优化:infinite-canvas本地部署与批量出图实战

这类工具最值得先看的不是功能列表,而是能不能在普通环境里稳定跑起来,以及它到底解决了创作流程里的哪个具体痛点。 infinite-canvas (无限画布)这个项目,核心是提供了一个本地或可部署的“一站式工作台”,把素材管理、提示词工程和批量出图这几个原本割裂的环节串了起来。它瞄准的不是单次生成一张惊艳的图,而是为需要高频、批量、有组织地生产AI图像的用户(比如内容创作者、产品经理、独立开发者)提供一个可管理、可复现的工作流。 很多人用AI绘画工具,痛点在于:生成的图片散落在各处,提示词用过就忘,想批量生成

jackleechina2011212的博客 483

开源AI伴侣Clawra技术解析:从LLM、Stable Diffusion到向量数据库的实战架构

大语言模型(LLM)作为当前人工智能的核心技术,通过海量数据训练获得了强大的语言理解和生成能力。其工作原理基于Transformer架构,通过自注意力机制处理序列信息。这项技术的价值在于能够作为通用任务接口,驱动复杂的智能应用。在实际工程中,LLM常与文本到图像生成模型(如Stable Diffusion)和向量数据库组合使用,构建具备多模态交互能力的智能体。例如,在构建拟人化AI应用时,LLM负责对话理解和意图识别,Stable Diffusion根据生成的描述词创建视觉内容,而向量数据库则通过嵌入模型存

weixin_33708432的博客 369

AI Agent技术实战:从原理到实现桌面级PPT智能生成

AI Agent(智能体)作为人工智能领域的重要发展方向,其核心原理在于通过大语言模型(LLM)进行任务规划与多工具调度,实现从感知、决策到执行的自动化闭环。这项技术的核心价值在于将AI从单纯的内容生成升级为能够理解复杂意图、自主执行多步骤任务的“数字同事”,从而在工程实践中大幅提升工作效率。其典型应用场景已从早期的对话与问答,扩展到自动化办公、数据分析、智能辅助等众多领域。本文聚焦于一个极具代表性的应用——桌面级PPT智能生成,深入探讨如何利用开源模型(如Qwen2、Stable Diffusion)和本

weixin_33782386的博客 348

从“机场鸭子”看AIGC技术质变:Stable Diffusion复杂场景生成实战

扩散模型作为当前AI生成内容(AIGC)领域的核心技术,通过前向加噪与反向去噪的数学过程学习数据分布,实现了从随机噪声生成高质量图像的能力。其技术价值在于将创意视觉化的门槛从专业绘画技能大幅降低为自然语言描述能力,极大地赋能了数字内容创作、产品原型设计、广告营销等广泛的应用场景。这一过程的核心在于条件引导机制,尤其是通过CLIP等模型将文本语义嵌入,并利用交叉注意力在去噪过程中实现精准的文本到图像控制。面对“一只穿着紫色小背心的鸭在机场登机口等待”这类包含多对象关系与复杂叙事的提示词,现代文生图系统展现了在

weixin_30482383的博客 411

SolidWorks参数化建模实战:从规则定义到智能装配

本文深入探讨SolidWorks参数化建模的实战技巧,从规则定义到智能装配的全流程。通过实际案例展示如何提升设计效率300%,确保一致性,并加速系列化开发。重点解析草图阶段植入设计意图、装配体级参数化及高级技巧,帮助工程师掌握三维建模的核心竞争力。

weixin_29306317的博客 420

Cluster Computing投稿

在overleaf中新建picins.sty文件,该文件是导入的包在.tex文件中添加以下内容\usepackage{picins}%实现作者简介%下边这块有几个人复制几段\vspace{0\baselineskip} %这一行控制作者间隔,可视情况改数字!!!!!!!!

这里是萤石ym的学习路途,努力搬砖! 5539

AI虚拟角色创作全流程:从Stable Diffusion到TTS的完整技术栈实践

AI驱动的虚拟角色IP创建与内容生成,是AIGC领域的重要应用方向。其核心原理在于利用大语言模型(LLM)生成角色设定,结合文生图模型(如Stable Diffusion)进行视觉化,并通过语音合成(TTS)与视频生成技术赋予角色动态表现力。这套技术栈的价值在于,它使个人创作者能以较低成本实现从0到1的角色视觉化与跨媒体内容量产,大幅降低了游戏开发、动漫设计和新媒体内容生产的美术与制作门槛。在应用场景上,它特别适合用于打造虚拟IP、快速生成角色设定图与宣传物料,以及进行实验性艺术创作。本文将以一个具体的AI

weixin_33831196的博客 509

MATLAB实战:Gardner定时同步算法实现与BER曲线优化指南

本文详细介绍了Gardner定时同步算法在MATLAB中的实现与优化方法,重点解析了算法原理、关键步骤实现及BER曲线绘制中的常见问题解决方案。通过优化参数设置和系统架构,提升数字通信系统的符号同步性能,为QPSK、QAM等调制系统提供实用参考。

weixin_29085865的博客 233

保姆级Stable Diffusion本地部署与AI绘画入门实战指南

AI绘画技术,特别是基于扩散模型的生成式人工智能,正深刻改变数字内容创作领域。其核心原理是通过学习海量图像数据分布,逐步去噪生成全新图像,实现了从文本描述到视觉内容的智能转换。这项技术的价值在于极大地降低了专业图像创作的门槛,并为个性化、高效率的内容生产提供了可能,广泛应用于概念设计、插画创作、游戏美术及营销素材生成等场景。本文聚焦于当前最流行的开源模型Stable Diffusion,针对新手用户,详细解析如何在本地计算机上完成从环境部署、参数配置到生成第一幅作品的完整流程,并深入探讨了提示词工程、模型选

cnvdkx2837的博客 363

【020】基于51单片机智能路灯系统Proteus仿真与实物设计

【020】基于51单片机智能路灯系统Proteus仿真与实物设计

小邓子分享官的博客 1882

16、保障Azure应用安全:密钥管理与身份认证

本文深入探讨了保障Azure应用安全的关键措施,包括使用网络安全工具(如Application Gateway和Azure Front Door)防范攻击,解决传统密钥和机密存储方式的安全隐患,以及通过Azure Key Vault实现敏感信息的安全管理。同时,介绍了使用托管标识实现Azure资源间安全访问的方法,并结合实际操作步骤展示了如何配置Key Vault、设置访问策略、存储机密以及授予Web应用对SQL Server的访问权限。最后,对不同安全措施进行了比较,并提出了在开发、测试及生产环境中的综合

rock5的博客 73

OPC DA远程失效根因与OPC UA迁移实战指南

OPC DA作为工业数据交换的传统协议,依赖DCOM通信机制,在现代Windows系统和复杂网络环境中暴露出状态泄漏、注册表权限脆弱、Windows更新兼容性差等结构性缺陷,导致远程连接‘突然’中断、CPU异常占用、修复ROI持续走低。OPC UA则以跨平台、内置安全、订阅模型和可扩展架构,成为替代DA的必然选择。本文从DCOM故障机理切入,解析DA远程失效的三大技术根源,结合KEPServerEX、C#、Qt、WinCC等真实开发场景,提供分阶段迁移路径、证书配置避坑、Wireshark抓包调试及轻量级A

weixin_34279246的博客 509

ROS从入门到精通1-1:ROS核心架构、常用指令与计算图

本文介绍ROS的核心架构,各个文件、目录的用途、常用命令行工具、动态计算图原理。

FRIGIDWINTER的博客 6374

AI视频生成实战:从剧本到成片,手把手教你制作百万播放叙事视频

AI视频生成技术正通过文本到视频、图像到视频等核心模型,为内容创作带来革命性变化。其原理基于扩散模型等深度学习技术,通过理解文本或图像提示,生成连贯的动态画面。这项技术的价值在于大幅降低了视频制作的门槛,使个人创作者无需专业设备和庞大团队,也能高效产出高质量视频内容。在应用场景上,它广泛适用于个人短片制作、小说推文可视化、产品演示及社会叙事内容创作。本文以《印度女孩的一生》为案例,深入解析了从剧本分镜设计、使用Midjourney或Stable Diffusion生成静态画面,到利用Runway Gen-2

weixin_30416871的博客 489

【法如faro】三维激光软件Scene2023数据处理(自动配准并转换坐标)流程

法如faro Scene2023数据处理(自动配准并转换坐标)的主要流程为:新建项目、导入数据、处理、自动注册、坐标系转换、模型导出立和面模型导出等。

智慧空间实验室 2387

手把手教你学 Simulink (1.3)--Simulink 的模块库及其模块介绍

Simulink 提供了丰富的模块库,涵盖了从基本的信号生成和处理到复杂的数学运算和系统建模的各种功能。通过熟悉这些模块库及其模块,你可以更高效地构建和仿真动态系统。

MHD0815的博客 5158

混元图像3.0一句话P图技术原理与实操指南

AI图像编辑正从‘能生成’迈向‘敢交付’的关键阶段。‘一句话P图’并非简单文生图,而是融合多模态语义理解、可控生成建模与端侧推理优化的系统性突破。其核心在于将自然语言指令精准解耦为空间定位、属性保留、光照对齐等可计算任务,通过意图解析层识别用户潜台词,可控生成层固化高频操作原子模块,端侧优化层实现全平台亚秒级响应。该技术显著降低修图门槛,适用于电商运营、营销设计、人像精修等强时效性场景,让语义精准控制和端到端可用性成为AI视觉生产力的新基线。

dielucui7698的博客 507

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

混元图像3.0:原生多模态大模型驱动的文生图范式革命

文生图(Text-to-Image)技术正从‘条件扩散’走向‘多模态联合推理’,其核心在于打破语言与视觉的系统割裂。原生多模态大模型通过统一架构实现文本理解、逻辑推理与图像生成的端到端协同,显著提升对数学推导、艺术隐喻、跨风格指令等复杂意图的准确建模能力。相比传统拼接式方案,它依托广义因果注意力、二维RoPE位置编码与思维链训练,使模型具备世界知识内化、空间结构感知与语义一致性保持等关键能力。在教育可视化、电商设计、游戏美术等需高精度意图落地的场景中,该范式大幅降低提示词工程依赖,推动AI从‘画图工具’升级

weixin_34293246的博客 360

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

文生图模型选择指南:从潜空间到训练数据的三层决策逻辑

文生图(Text-to-Image)并非单一技术,而是由底层模型驱动的多维能力系统。其核心原理在于扩散模型对文本语义的潜空间映射、训练数据构建的知识边界,以及推理采样策略决定的可控性下限。技术价值体现在语义解析精度、领域适配度与生产稳定性三重提升;典型应用场景涵盖电商主图生成、文物复原、人像写实、HDR场景渲染及风格化创意探索。尤其在中文提示词响应与高密度语义理解方面,SDXL 1.0与DALL·E 3展现出显著差异——前者依赖中文标签覆盖率,后者依托跨模态对齐优化。本文聚焦模型选型的本质逻辑,不谈提示词技

weixin_33739523的博客 351

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

百花奖首设AIGC单元:影视工业AI化实战指南与开发者入局路径

AIGC(人工智能生成内容)是基于深度学习模型,特别是扩散模型和Transformer架构,自动生成文本、图像、音频和视频的技术。其原理是通过海量数据训练,学习内容分布与生成规律,实现从噪声到结构化内容的逐步构建。该技术的核心价值在于大幅降低高质量内容创作门槛,提升创意生产效率,推动创作民主化。在影视工业等应用场景中,AIGC已深入概念设计、动态分镜、特效生成及音频处理等环节,成为关键的效率工具与创意放大器。本文结合百花奖设立AIGC单元这一行业标志性事件,探讨其背后的技术逻辑与产业影响,并为开发者提供从提

weixin_33695082的博客 373

AI短视频制作全攻略:从文本、图片到视频的三种生成模式详解

视频生成技术正成为内容创作领域的热点,其核心原理在于利用人工智能模型理解和生成视觉序列。从技术价值看,它极大地降低了专业视频制作的门槛,使单人创作者也能高效产出高质量内容。在应用场景上,该技术广泛应用于创意原型制作、产品广告、动态壁纸、视频风格化及画质修复等领域。本文聚焦于当前主流的三种生成路径:文本生成视频实现了从无到有的创意可视化;图片生成视频为静态作品注入动态灵魂;而视频生成视频则能对现有素材进行风格转换与增强修复。掌握这些方法,尤其是结合提示词工程与后期工作流,能有效提升创作效率与作品表现力。

weixin_30756499的博客 459

AI工具导航:AI绘图、AI视频、AI短剧、AI Agent一站式指南

2026年的AI工具生态已经形成了从“思考大脑”(大模型)、到“感官创造”(AIGC)、再到“手脚执行”(AI Agent)的完整体系。对于个人,这意味着前所未有的创作自由和效率提升;对于企业,这代表着工作流程的智能化重构。面对这个快速演进的技术丛林,选择一个优秀的导航起点至关重要。一个优秀的AI工具聚合平台,无疑是您开启AI赋能之旅、抓住这波生产力革命红利的高效门户。

2601_95697535的博客 675
上一篇: Stable diffusion的SDXL模型,针不错!(含实操)
下一篇: 我们在使用AI绘图软件时会出现哪些问题?
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1481原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值