深度解析:大模型三大生成参数Top-k、Top-p和温度,小白也能懂!!

大模型推理常见采样策略:Top-k, Top-p, Temperature, Beam Search 大模型推理采样策略,举例通俗易懂汇总介绍 阅读详情

前言

在大模型(如GPT)中,生成文本时的控制参数对于最终输出的质量至关重要。Top-k、Top-p 和温度是三个非常重要的超参数,它们决定了模型在生成文本时的“创造力”和“多样性”。让我们通过这篇文章和一张图,一起来秒懂它们的作用。

1. Top-k 采样

Top-k 是一种控制模型生成文本时选择词汇的策略。简单来说,Top-k 采样意味着在生成每个词时,模型只从概率排名前 k 的词汇中进行选择。如下图:我们设定Top-k = 3,当输出的token个数到达3个时,模型停止输出,并从3个tokens中选出概率最大的进行输出。

  • 工作原理:在生成一个词时,模型会计算每个词的概率,然后将概率最高的 k 个词选出作为候选。接着,从这 k 个候选词中随机选一个作为下一个词。
  • 作用:Top-k 限制了候选词的数量,从而避免了模型在生成过程中选择到一些极其低概率的词汇。这可以有效避免生成不相关或荒谬的文本,同时也保证了一定的多样性。

Top-k 的优缺点:

  • 优点:限制了模型的选择范围,可以减少生成过程中不合适的词汇,同时保留了一定的创造性。
  • 缺点:如果 k 过小,可能会导致文本生成过于单一,缺乏多样性。

2. Top-p 采样(核采样)

Top-p 采样,也被称为核采样(nucleus sampling),是另一种根据概率分布来选择词汇的方法。与 Top-k 不同,Top-p 并不预设一个固定的候选词数量,而是根据概率累积选择,累计概率是我们可以设定的参数,如下图:我们设定Top-p=0.7,当输出的tokens概率值累加大于等于0.7时停止,然后从中选出概率最大的token进行输出。

  • 工作原理:在每个词的生成过程中,模型会按概率从大到小排列所有词汇,然后累加概率,直到累积概率达到 p(通常是 0.9 或 0.95)。这时,所有累积概率之和超过 p 的词汇构成候选词池。接着,从这个池中随机选择下一个词。
  • 作用:Top-p 采样灵活性更高,可以根据实际情况动态调整候选词的数量,避免了固定选择数量可能导致的限制。

Top-p 的优缺点:

  • 优点:相较于 Top-k,Top-p 更加灵活,可以根据实际情况调整生成的多样性,并避免生成无意义或不合适的词汇。
  • 缺点:如果 p 设定得过高,生成的文本可能会变得过于“自由”,有时缺乏连贯性。

3. 温度(Temperature)

温度 是控制生成词汇分布平滑度的超参数。它直接影响模型生成词汇的概率分布。说白了,其实就是在softmax函数上,除一个一个T值 ,

P(x) 是词汇 xxx 的原始概率,P′(x) 是温度调整后的概率

  • 当 T=1 时,概率分布保持不变,直接按照模型预测的概率进行选择。
  • 当 T<1 时,概率会更加集中在高概率词汇上,模型更加保守。
  • 当 T>1时,概率分布会更加平滑,低概率词汇的选择机会增大,模型变得更加“大胆”。

  • 工作原理:在生成每个词时,模型根据当前温度对概率分布进行调整。具体来说,温度值控制着概率分布的“尖锐度”:
  • 当温度较低时,生成概率较高的词更有可能被选中,生成的文本更加确定、稳定。
  • 当温度较高时,概率分布变得更加平滑,生成的词汇更具多样性,但可能会增加错误和不连贯的风险。
  • 作用:温度参数的主要作用是控制生成文本的创造性。低温度使模型更“保守”,高温度则让模型更加“大胆”并产生更多可能的输出。

温度的优缺点:

  • 优点:可以调节模型生成文本时的多样性,低温度有助于生成高质量且一致的文本,而高温度适合创意性和探索性的任务。
  • 缺点:温度设定过高可能导致文本不连贯,过低则可能使生成内容过于单一和机械化。

通过合理调整 Top-k、Top-p 和温度这三个超参数,我们可以在文本生成过程中平衡稳定性与创造性,从而优化模型的输出。下面是这三者的总结作用:

  • Top-k:限制候选词数量,避免过于极端的词汇选择,保持一定的多样性。
  • Top-p:动态调整候选词池,避免固定限制,同时保持生成的自然性和灵活性。
  • 温度:控制输出的创造性,低温度生成高质量、一致性强的文本,高温度则增加多样性和创新性。

这三个超参数相辅相成,通过巧妙调整,可以帮助我们得到更加理想的文本生成结果,既能保证语义的连贯性,也能提供创意的空间。

最后唠两句

为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选

很简单,这些岗位缺人且高薪

智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
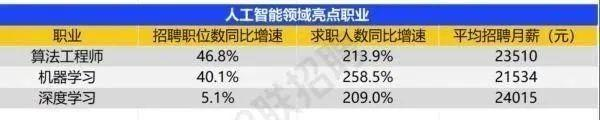
在这里插入图片描述

AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。

那0基础普通人如何学习大模型 ?

深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。

我整理出这套 AI 大模型突围资料包【允许白嫖】:

  • ✅从入门到精通的全套视频教程

  • ✅AI大模型学习路线图(0基础到项目实战仅需90天)

  • ✅大模型书籍与技术文档PDF

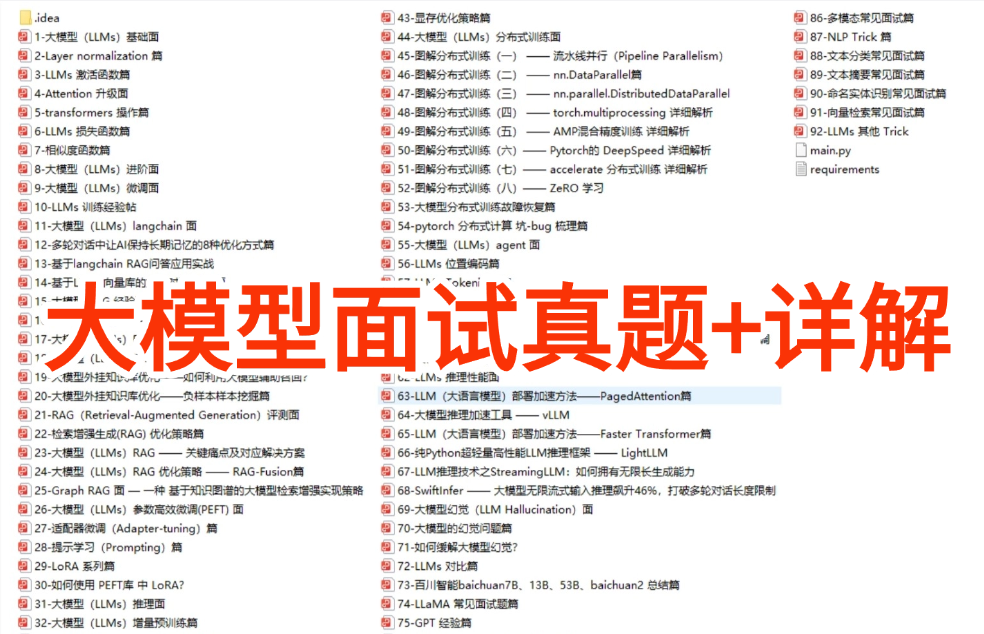
  • ✅各大厂大模型面试题目详解

  • ✅640套AI大模型报告合集

  • ✅大模型入门实战训练

这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

①从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点

在这里插入图片描述

② AI大模型学习路线图(0基础到项目实战仅需90天)

全过程AI大模型学习路线
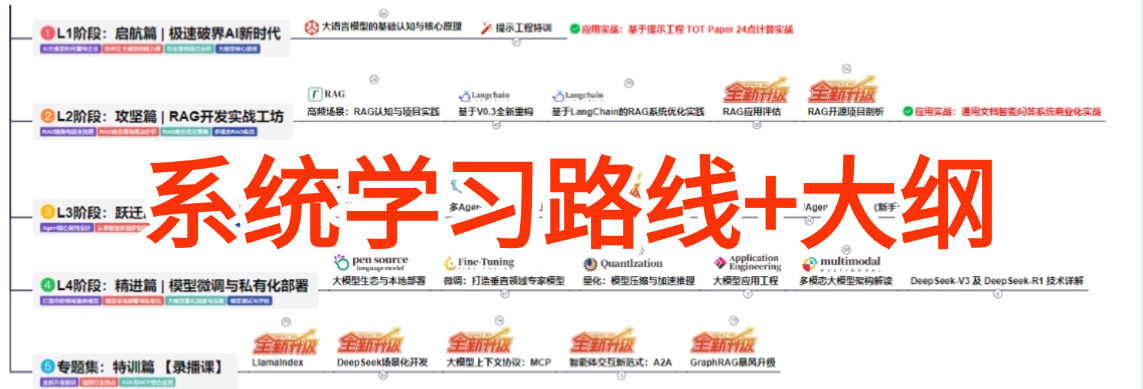
在这里插入图片描述

③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述

④各大厂大模型面试题目详解

在这里插入图片描述

⑤640套AI大模型报告合集

在这里插入图片描述

⑥大模型入门实战训练

在这里插入图片描述

如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

在这里插入图片描述

具有温度系数(Temperature)的Softmax函数 softmax 函数是一种激活函数,通常用作神经网络最后一层的输出函数。该函数是两个以上变量的逻辑函数的推广。Softmax 将实数向量作为输入,并将其归一化为概率分布。softmax函数的输出是与输入具有相同维度的向量,每个元素的范围为0到1。并且所有元素的总和等于1。 阅读详情

相关推荐

大模型推理参数详解:温度、Top-k与Top-p采样实战指南

在自然语言处理领域,大模型推理参数是控制文本生成质量的关键技术。其核心原理是通过调整softmax概率分布,影响候选词的采样策略。温度参数(Temperature)作为最基础的控制变量,通过调节概率分布的平滑程度,平衡生成结果的确定性与多样性。Top-k和Top-p采样则从不同维度实现候选词筛选,前者固定候选数量,后者动态控制质量阈值。这些参数在对话系统、创意写作、代码生成等场景中具有重要应用价值。特别是在处理长文本生成时,合理的参数组合能显著提升生成效果。当前行业实践表明,温度参数与top-p采样的组合策

weixin_29038303的博客 307

什么是Top-p采样与Top-k采样?大模型推理时如何同时设置?解析Transformers库源代码

Top-k可能会限制候选词的数量,导致生成文本的多样性降低。通过引入Top-p,可以保证在保证概率约束的同时,仍然有一定的多样性。

阿正的梦工坊 3776

LLM生成参数深度解析:temperature、top-p、top-k与max_tokens实战指南

大语言模型(LLM)的文本生成并非黑箱随机输出,而是由temperature、top-p、top-k和max_tokens四大核心参数共同调控的概率决策过程。temperature控制输出分布的平滑度,决定模型在确定性与创造性间的权衡;top-p与top-k则分别通过动态核采样和静态候选池机制,约束有效token集合,直接影响事实准确性与幻觉风险;max_tokens不仅是输出长度上限,更是模型推理步数与计算资源的硬性配额。这些参数协同构成LLM应用的‘行为定义层’,在代码生成、法律审查、医疗问答、电商文案

weixin_29062823的博客 353

top-k问题详解

目录 1.TOP-K问题的定义以及思想: (1)TOP-K问题的定义: (2)解决TOP-K问题的思路: ①排序法(不推荐使用): ②堆函数操作法(不推荐使用): 最终算法: 复杂度: 完整实现(每一部都有详细的过程): 1.TOP-K问题的定义以及思想: (1)TOP-K问题的定义: 即求数据结合中前K个最大的元素或者最小的元素,一般情况下数据量都比较大。 比如:专业前10名、世界500强、富豪榜、游戏中前100的活跃玩家等。 我们以求n个数据中前K个最大的元素为例进

zhang_si_hang的博客 4198

大模型采样策略调优:温度、Top-k与Top-p实战指南

大语言模型推理并非简单‘选概率最高的词’,而是通过采样策略动态调控输出分布的实时决策过程。温度(Temperature)控制模型自信程度,影响输出确定性与多样性;Top-k限制候选词数量,守住语义底线;Top-p(核采样)则依据累积概率自适应截断,更贴合语言不确定性本质。这些策略共同决定生成内容的事实准确性、逻辑连贯性与业务适配度,在金融报告生成、医疗摘要、代码辅助等高要求场景中尤为关键。忽视参数调优,往往导致幻觉频发、术语错误或逻辑断裂——默认配置不是最优解,而是需工程化调试的起点。

weixin_34208185的博客 324

LLM探索:GPT类模型的几个常用参数 Top-k, Top-p, Temperature

上一篇文章介绍了几个开源LLM的环境搭建和本地部署,在使用ChatGPT接口或者自己本地部署的LLM大模型的时候,经常会遇到这几个参数,本文简单介绍一下~top_ptop_k。

具身机器人和通用AI 7322

大语言模型生成控制参数详解:温度、Top-K与Top-P

温度、Top-K和Top-P的灵活组合,为LLM生成结果的可控性提供了多层次解决方案。开发者需深入理解各参数的数学本质,结合实际场景需求,通过系统化实验找到最佳配置。随着自适应参数调整技术的发展,未来或将实现更智能的上下文感知生成策略。

石榴姐yyds 3813

理解大语言模型的关键生成参数:温度、Top-p 与 Top-k

温度:控制整体随机性水平,是基础调节参数Top-k:限制候选词数量,提供硬性边界Top-p:基于累积概率动态选择,更智能灵活理解这些参数的工作原理和相互作用,是有效使用大语言模型的关键。在实际应用中,建议根据具体任务需求进行实验和调整,找到最适合的参数组合。记住,没有"一刀切"的最佳配置。最有效的参数设置总是依赖于你的具体应用场景、质量要求和多样性需求。通过系统的测试和优化,你可以充分发挥大语言模型的潜力,生成符合期望的高质量文本。

Ven%的博客 379

深度解析LLM参数:Top-K、Top-p和温度如何影响输出随机性?

大语言模型(LLM)在生成文本时,通过控制推理参数来调节输出的随机性和确定性。常见的参数包括Top-K、Top-p和温度。Top-K和Top-p是采样策略,分别通过限制候选词的数量或累积概率来影响输出。Top-K选择概率最高的K个词,而Top-p选择累积概率达到p的最小词集。温度则通过调整Softmax函数的输出,影响概率分布的形状。高温使概率分布更均匀,增加输出的随机性和创造性;低温则放大高概率词的优势,使输出更确定和常规。这些参数共同作用于LLM的输出概率分布,帮助模型在不同场景下生成符合需求的文本。

weixin_44245188的博客 1279

使用python排八字 计算八字的相合相冲五行分值等 ...

简介 八字术是一种古老的算命术。它运用阴阳、五行、干支、八卦等理论,把人的出生年月日时转化为八个字,进而推算人的富贵贫贱、祸福吉凶、穷通寿天、名利地位、家庭六亲等方面的情况 八字源自古代的中国,是一种利用天干和地支来准确记录年、月、日、时的方式,由“年干,年支”、“月干,月支”、“日干,日支”、“时干,时支”,共八个干支所组成(共八个字),年、月、日、时...

weixin_33717298的博客 5310

Tina Linux WiFi驱动移植避坑指南:以RTL8733bs为例,详解设备树、Kconfig与固件依赖

本文详细解析了在Tina Linux上移植RTL8733bs WiFi驱动的关键步骤与常见问题,涵盖设备树配置、内核依赖、固件加载及启动时序等核心环节。通过实战案例和排查清单,帮助开发者规避SDIO控制器配置、电源管理、GPIO极性等典型陷阱,确保驱动稳定运行。

weixin_29164185的博客 263

大模型温度参数如何设置

大模型温度参数设置指南 摘要 本文系统介绍了大模型温度参数(Temperature)的设置原理与实践方法。温度参数控制语言模型输出的随机性和创造性,是影响生成质量的关键超参数。文章从技术原理、应用场景到实践设置进行了全面解析: 核心概念:温度参数调节softmax输出的概率分布,值越高输出越随机(>1),值越低输出越确定(<1) 技术原理: 数学上调整logits分布形状 影响采样策略(top-k/top-p)的效果 与模型其他参数协同工作 应用场景: 高温度(0.7-1.0):创意写作、头脑风暴 中温度(

输出倒逼输入,写作驱动成长。 2563

山东大学软件学院计算机组成原理课程设计实验三

文章目录一、实验时间二、实验内容1. 实验目的2. 设计要求3. 实验基本思路三、电路图1. 可预置初值的模256异步计数器2. 8位ALU电路3. 总图四、补充 一、实验时间 第三次实验:2021年4月8日星期四,第六周 第一次部件级实验,开始算分 二、实验内容 微程序控制的运算器设计 1. 实验目的 (1)熟悉简单运算器的结构 (2)熟悉微命令的产生和时序 (3)熟悉运算器功能测试。 2. 设计要求 利用之前设计的具有超前进位功能的8位ALU,实现简单算术或逻辑运算 两操作数由八位寄存器R0、R1提供,

叶卡捷琳堡的博客 1万+

温度参数深度解析:大模型生成的“创意旋钮”怎么调?

温度参数是大模型生成中最直观但也最容易被滥用的旋钮。理解它的数学原理,知道不同温度下的输出风格,掌握与top_p/top_k的配合,并在生产环境中按任务动态调整,你就能让模型的输出在“严谨”与“创意”之间自由切换。没有最佳的温度,只有最适合任务的温度。下次调参时,不妨多问自己一句——这个任务,我需要的是“确定”还是“惊喜”?

闵浮龙的博客 794

学习QT之应用程序打包发布

一、编译QT程序(release编译) 二、将release文件夹中的可执行文件复制到一个空的文件夹中 三、使用windeployqt打包工程 切换到可执行文件路径,执行windeployqt xxx.exe: 然后就会将程序所需要用到的资源以及库文件生成到可执行文件路径下: 此时应用程序就可以点击运行了。 四、使用Enigma Virtual Box封包(将文件夹内的文件集成为单可执...

贝勒里恩的博客 762

SerDes系列之如何选择AC耦合电容

交流耦合电容用于隔离PCB互连时的直流分量(Common-mode voltage),同时传递交流分量(Voltage swing),其作用类似于一个高通滤波器,但是,如果电容容值选取不当,使用过程中会产生信号质量问题,典型的应用场景:当包含相同的长串1或0的NRZ数据应用于该高通滤波器时,会发生低频电压跌落,导致低频模式相关抖动(PDJ)。

一只豌豆象的博客 2351

大模型训练与微调(4)——Top-k 和 Top-p 采样策略介绍

在自然语言生成任务中,**Top-k** 和 **Top-p** 是两种广泛使用的采样策略,用于控制大模型生成结果的多样性与可靠性。它们通过动态筛选候选词的概率分布,避免生成低质量或不合逻辑的文本。以下从定义、数学原理、实际应用和对比分析四个方面详细解析这两种方法。

m0_55996694的博客 2182

HotSpot G1 GC 的分区记账、SATB 并发标记与停顿目标调优解析

线上GC毛刺该调停顿目标、加大新生代还是换收集器?本文从HotSpot G1的设计出发,梳理分区与巨型对象、卡表与记忆集、写屏障与细化线程、停顿预测、SATB并发标记、自适应IHOP、混合回收规则及Full GC兜底,并注明JDK8至JDK27的版本差异。文中在JDK8与JDK17上实测:停顿目标从200ms降到20ms,伊甸区缩小四成、P99下降但仍超目标;巨型对象会反复触发又撤销并发标记;JDK17并行Full GC平均停顿约为JDK8的三成。最后给出日志解读、参数清单、调优流程与选型。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 170万+

如何自定义gemma-4-e4b-it-nvfp4的生成参数:温度、top-k和top-p调优指南

想要让gemma-4-e4b-it-nvfp4模型生成更符合你需求的内容吗?🤔 掌握**温度、top-k和top-p参数调优**是解锁AI生成内容潜力的关键!这篇完整指南将带你深入了解如何在Apple silicon上优化这个强大的多模态模型,获得更精准、更富创意的输出结果。 ## 什么是生成参数?为什么它们如此重要? 生成参数就像是AI模型的"创作调节器",它们控制着模型生成文本时的随机性

gitblog_00862的博客 940

微信小程序 - {“errMsg”:”requestPayment:fail banned”} 微信小程序调用wx.requestPayment支付失败返回错误(uniapp微信小程序微信支付报错)

{“errMsg”:”requestPayment:fail banned”},微信小程序调用wx.requestPayment报错requestPayment:fail banned,uni-app微信小程序wx.requestPayment支付报错requestPayment:fail banned,拉起小程序支付报错,iPhone苹果ios真机微信支付报错,Android安卓手机微信支付报错,支付报错,商户配置,签名验证,uniapp 小程序支付微信支付一场,设置过b2b类目,确认了商户号相关功能正常

🏆 前端领域优质创作者 3344

推荐11个顶级的Claude Code Skills

ClaudeCode的Skills系统为程序员提供了11个强大的AI辅助工具,包括代码审查、重构建议、单元测试生成、API文档自动生成、性能分析、安全扫描、数据库迁移脚本生成、CI/CD配置、依赖管理、ER图生成和日志分析等功能。这些"技能包"可大幅提升开发效率,从代码质量到协作沟通全方位优化工作流程。用户可根据需求选择2-3个核心功能开始尝试,熟练后还可自定义Skills。该系统需要配合Anthropic的API使用,建议先在小型项目测试再应用于核心业务。

分享AI、区块链技术及应用,未来已来 1852

全任务零样本学习-mT5中文-base参数详解:温度/Top-K/Top-P调优指南

本文介绍了如何在星图GPU平台自动化部署全任务零样本学习-mT5分类增强版-中文-base镜像,实现中文文本的零样本增强与改写。该镜像通过调整温度、Top-K、Top-P等参数,可广泛应用于电商文案生成、社交媒体内容创作等场景,提升文本处理效率与多样性。

weixin_35578748的博客 912

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

调教AI的“脑洞开关“:大模型参数top_p深度解析

top_p参数(又称核采样/Nucleus Sampling)是控制AI生成文本多样性的关键参数,它像动态过滤器一样,决定每次预测时从多大范围的候选词中选择输出。其工作原理如下:每次生成token时,模型会输出所有可能词的概率分布。

catastrophe_zy的博客 2933

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

MARS5-TTS推理参数调优手册:温度、top_k、top_p的黄金设置

MARS5-TTS是CAMB.AI推出的革命性语音合成模型,采用创新的自回归(AR)与非自回归(NAR)双阶段架构,能够仅凭5秒音频和文本片段生成具有惊人韵律的语音。本文将为您详细解析MARS5-TTS推理参数调优的黄金法则,帮助您快速掌握温度、top_k、top_p等关键参数的最佳配置。 ## 🎯 核心参数调优原理 ### 温度(Temperature)参数详解 温度参数控制着模型输出的

gitblog_00288的博客 1201

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

KoboldCpp终极指南:自定义采样器与生成参数深度解析

KoboldCpp是一款轻量级工具,让用户能够轻松运行各种GGML和GGUF模型并搭配KoboldAI的用户界面。本文将深入解析如何自定义采样器和生成参数,帮助新手用户快速掌握模型输出的优化技巧。 ## 认识KoboldCpp的核心功能 KoboldCpp的核心优势在于其简洁的单文件部署方式和强大的模型兼容性。通过[common/sampling.h](https://link.gitcode

gitblog_01095的博客 1063

从零开始学大模型输出:温度采样、top-p策略与结构化控制,小白到高手的必经之路,建议收藏!

本文详细解析了大模型输出环节的三种核心采样策略(温度、top-k和top-p),探讨如何通过不同方法实现结构化输出,并讨论了模型输出的不确定性本质。文章强调理解和管理大模型的不确定性是发挥其创造力的关键,为开发者和用户提供实用的输出控制方法。

lyy2017175913的博客 1038
上一篇: 2026年AI大模型工程师岗位大全:全国名企职位一网打尽,抓住AI风口,机遇就在你手中!
下一篇: 100个AI Agent应用场景合集丨来看看Agent能在你的行业做什么!
Agent学习路线
博客等级 码龄6年 1万+粉丝 1903原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值