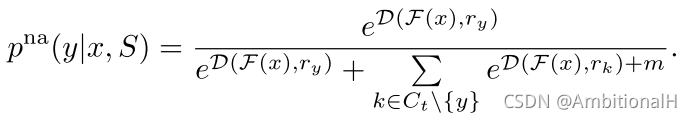论文阅读《Boosting Few-Shot Learning With Adaptive Margin Loss》

【论文阅读】【元学习/小样本学习】【CVPR2020】Boosting Few-Shot Learning With Adaptive Margin Loss Boosting Few-Shot Learning With Adaptive Margin Loss回顾Naive Additive Margin Loss (NAML)Class-Relevant Additive Margin Loss(CRAML)Task-Relevant Additive Margin Loss (TRAML)Extension to Generalized Few-Shot LearningExperiments and Discussions总结参考文献代码(待续) 论文链 阅读详情

Background & Motivation

各种度量学习方法的不同之处就在于特征的提取方法和嵌入空间内距离的度量方法不同。

交叉熵损失常用来监督模型提取区别度高的视觉特征,在此之前还有人提出各种不同的 margin loss。最简单的 Naive Additive Margin Loss:
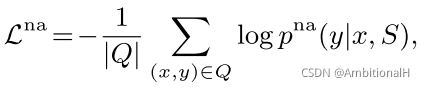
这个方法是假设所有的类都应该平等的远离彼此,因此增加了一个固定的常数 m。但是对相似的类别并不能很好地区分,尤其是在小样本的设定下。

除此之外还有 angular margin 和 cosine margin 等等。

By observing that the weights from the last fully connected layer of a classification DCNN trained on the softmax loss bear conceptual similarities with the centers of each class.

没读太懂。

但是之前的 margin loss 并不适合小样本学习任务这种数据很稀缺的情况,这也是本文的 Motivation。

Methodology

第一次看到 standard FSL 和 genrealized FSL 这两种说法。

  • Standard FSL

where the test data contain novel class samples only.

  • Generalized FSL(更贴合实际

where the label space of test data covers both base and novel classes.

提出了一个 adaptive margin loss,旨在嵌入空间中更好的分离不同类的物体,特别是使相似的类尽可能分离地远,更适合小样本学习,示意图如下:

使用了一种之前没有看到过的方法,将类别的语义相似性(词嵌入 word embedding)加入到了提出的 naive additive margin loss 中。

Training strategy

模型在训练时采用 adaptive margin loss,测试时只用简单的 softmax 来完成分类。

Class-Relevant Additive Margin Loss(CRAML)

为了更适合小样本学习任务,在 naive additive margin loss 的基础上应该自适应地使不同的类别间的距离不相同。基于这个想法提出了 CRAML,引入了类别的语义特征(word embedding)来调整类别间距。构建了一个 class-relevant margin 产生器 M,输入类别对的名字来获得其 adaptive margin:

sim 是度量函数,另外两个是超参数,分别来调整 M 的尺度和偏置参数。CRAML 的公式如下:

TRAML 可以看作是 CRAML 的升级版。

Task-Relevant Additive Margin Loss(TRAML)

同样,先根据语义特征来度量类别对的 margin:

这个公式的示意图为:

Generator 前是一个全连接网络,将其融合到 naive additive margin loss 上:

最终使用的 Adaptive Margin Loss 就是 TRAML。

Experiment

Standard FSL

特征提取模块使用的是 ResNet12。

Generalized FSL

特征提取模块采用 ResNet10。

对损失函数进行了消融实验:

Conclusion

用词嵌入的方法来使类别间的间隔不同,是个很新颖的方法。这个损失函数是对交叉熵损失函数的改进,可以结合到现有的模型中。

还有提到了 Standard FSL 和 Generated FSL 的概念。

论文分享:ArcFace: Additive Angular Margin Loss for Deep Face Recognition ArcFace 阅读详情

相关推荐

CVPR2020|WACV2020 |ICLR2021 小样本学习论文合辑

CVPR2020|小样本论文合辑 Few-Shot Object Detection With Attention-RPN and Multi-Relation Detector FGN: Fully Guided Network for Few-Shot Instance Segmentation Revisiting Pose-Normalization for Fine-Grained Few-Shot Recognition Adaptive Subspaces for Few-Shot Lear

wangs1996 3543

论文阅读笔记《Boosting Few-Shot Learning with Adaptive Margin Loss》

核心思想   本文在基于度量学习的小样本分类算法的基础上,通过引入类别相关(class-relevant)或任务相关(task-relevant)的自适应边缘损失(Adaptive Margin Loss),改进了原有算法的分类效果。本文的核心观点是可以利用不同类别之间的语义相似性来生成自适应边缘(Margin虽然翻译为边缘,但其实应该理解为两种类别之间的边界距离),具体地说就是让相似类别之间的边界类别比不相似类别之间的边界距离更大,如下图所示。   我们希望增大“狗”和“狼”之间的边界距离,以增强相似类

深视 3972

论文(ArcFace: Additive Angular Margin Loss for Deep Face Recognition)翻译

使用特征学习的主要挑战之一深度卷积神经网络(DCNN)用于大规模人脸识别是适度损失的设计可以增强判别力的功能。中央损失会惩罚深层特征之间的距离他们相应的班级中心在欧几里得空间实现类内的紧凑性。 SphereFace假设最后完全连接的线性变换矩阵层可以用作类的表示在角度空间中居中并因此惩罚角度在深层特征及其相应权重之间以乘法的方式最近,热门研究将保证金纳入公认的亏损函数为了最大化人脸分类的可分离性。在本文中,我们提出了一个附加的角余量损失(ArcFace)获得用于面部识别的高度区分性功能。拟议的ArcFace具有清晰的几何解释由于它与测地距离精确对应在超球上。我们可以说是最广泛的针对所有最新技术的实验评估十种面部识别基准的面部识别方法其中包括一个新的大型图像数据库拥有成千上万的货币对和大规模的视频数据集。我们表明ArcFace的性能始终优于且可以通过微不足道的计算轻松实现高架。

20年(CVPR)Boosting Few-Shot Learning with Adaptive Margin Loss

Adaptive Margin Loss is used in Few-Shot Learning

m0_55384957的博客 257

Keil环境下单片机串口通信实战:如何用printf发送中文(附完整代码)

本文详细解析了在Keil开发环境下,单片机通过串口通信发送中文信息时产生乱码的根本原因及解决方案。核心在于理解并统一编码(如GB2312或UTF-8),并正确重定向printf函数。文章提供了针对STC89C52和STM32F103的完整代码示例,涵盖工程配置、编码设置、调试技巧,帮助开发者实现稳定可靠的中文串口输出。

weixin_29168675的博客 467

CMU开源NavRL:深度强化学习如何破解无人机动态避障难题?

卡内基梅隆大学(CMU)开源了NavRL框架,利用深度强化学习解决无人机在复杂环境中的动态避障难题。该框架通过创新的状态表示、多目标奖励函数设计以及独立的安全屏障机制,使无人机能够通过仿真训练自主学会灵活、安全的导航策略,并成功实现从仿真到真实环境的零样本迁移。

hope8的博客 720

视频异常检测论文

首先,提出了一种新的变分正态推理(VNI)模块,用于在条件变分自编码器(CVAE)框架中进行图像重构,该框架学习概率决策模型而不是传统的确定性决策模型。1.问题:大多数现有方法的视觉表征受到短期观察序列的限制,不能为实现合理的检测提供足够的线索。现有方法在 UCF-crime 和 DOTA 数据集上的 AUC 普遍较低,可能是因为这些数据集的场景相对复杂,变化和噪声较多。异常事件的及时定位也是未来研究的发展方向。3.现有的方法假设训练视频和测试视频来自同一个场景,当遇到不可见的场景时,泛化性能较差。

qq_52259359的博客 311

人形机器人五大核心零部件技术解析与国产化实况

人形机器人并非简单机械集成,而是物理、能量、感知、决策与执行五层系统毫秒级协同的复杂体。其性能瓶颈往往不在于整机算法,而深植于谐波减速器的刚度稳定性、无框力矩电机的功率密度与温升控制、六维力传感器的动态响应与温漂抑制、运动控制器的实时OS生态及灵巧手的多指协同精度等底层硬件能力。这些部件共同构成整机68.3%的成本,且国产化率差异显著——谐波减速器达72%,而高精度力矩传感器仍受制于日德厂商。本文聚焦‘谐波减速器’和‘六维力传感器’两大热词,从材料工艺、参数定义、失效模式到产线验证,揭示真正卡脖子的技术关卡

weixin_29065959的博客 406

论文阅读笔记TRAML《Boosting Few-Shot Learning with Adaptive Margin Loss》

来源:CVPR2020  原文下载:https://arxiv.org/pdf/2005.13826.pdf 源码地址:未开源 解读转载自原作者:https://zhuanlan.zhihu.com/p/144538053?from_voters_page=true 1、背景     近年来,在深度网络的帮助下,计算机已经在图像识别上取得了超越人类的效果。然而,深度神经网络参数量巨大,因此需要大量有标签的数据来训练。现实世界中,有很多场景没有这么多的标注数据,获取标注数据的成本也非常大,例如在医疗领域、.

海淀小天的blog 489

axi ps读写pl_PL读写DDR:Datamover能干什么

最近发现工程项目中一直在用AXI-DMA。这玩意儿搬数据倒是没问题,就是用axi-lite配置起来非常反人类。。。简单的办法其实是用datamover ip核。这个ip核能干嘛呢。准备写个文章解析一下。由于好多feature没用过,所以仅仅看文档可能理解有误,欢迎指出错误。首先扫个盲:MM2S指的是Memory map to stream. 读DDR. S2MM指的是steam to memory...

weixin_35908791的博客 1597

SillyTavern 向量存储配置踩坑记:从卡死到本地部署 Ollama 跑通

用此命令看到镜像就算成功。

qq_62483451的博客 1259

Boosting【文献精读、翻译】

在本文中,我们回顾了Boost方法,这是分类和回归中最有效的机器学习方法之一。虽然我们也讨论了边际观点(margin point of view),但主要采用梯度下降的视角。文章特别介绍了分类中的 AdaBoost 和回归中的各种 L2Boosting 版本。同时,我们还为实践者提供了如何选择基础(弱)学习器和损失函数的建议,并给出了相关软件的使用指引。Boosting 是一种现代统计方法,起源于20世纪90年代中期的机器学习,用于分类和回归。

qq_22841387的博客 1350

Allegro17.2 出gerber文件详细流程 - 干货

Allegro17.2 出gerber文件详细流程 - 干货

u010614434的博客 1万+

神经网络中的损失函数

在《神经网络中常见的激活函数》一文中对激活函数进行了回顾,下图是激活函数的一个子集——而在神经网络领域中的另一类重要的函数就是损失函数,那么,什么是损失函数呢?损失函数是将随机事件或其有关随机变量的取值映射为非负实数以表示该随机事件的“风险”或“损失”的函数,用于衡量预测值与实际值的偏离程度。在机器学习中,损失函数是代价函数的一部分,而代价函数是目标函数的一种类型。在应用中,损失函数通常作为学习准...

我相信...... 3064

Windows 11 安装、使用 Git:下载、安装、概念、命令、分支模型

本文详细介绍了在 Windows 11 系统上安装与使用 Git 的完整流程,涵盖从官方或国内镜像下载安装包、关键安装选项配置,到 Git 核心概念(如工作区、暂存区、分支、远程仓库等)的通俗解释。同时梳理了常用命令与五种主流 Git 分支模型(如 Git Flow、GitHub Flow 等),帮助开发者根据项目规模选择合适的工作流,是面向初学者与进阶用户的实用指南。

寒水馨 · 轻量级技术文档 · hanshuixin.org 2387

2026年数学建模国赛B题无线电干扰源的快速自动定位与清除 论文详细解析

数学建模竞赛论文无线电干扰源的快速自动定位与清除2026 年高教社杯全国大学生数学建模竞赛 B 题完整求解论文交会定位、极大极小测点优化、自适应多频道搜索与定向源恢复的统一建模模型、算法、代码、图表与验证一体化交付本文研究圆形目标区域中多个未知无线电干扰源的快速检测、定位与清除问题,建立了由误差楔交会模型、角度观测信息模型、分层勘测模型、鲁棒射线交会模型和定向覆盖反馈模型组成的统一求解框架。模型同时覆盖题目中的四个子问题:多测向射线形成的多边形定位区域及直径、第二个测点的极大极小优选、全向源自动搜索清除策略

YOLO 357

小样本论文:Boosting Few-shot Fine-grained Recognition withBackground Suppression and Foreground Alignm

原始图像经过背景激活抑制模块得到精细图像,分为两路进入特征提取器(文献代码提到两种模型:C-conv4、R-resnet12)得到raw与refined的特征向量,之后二者一起进入特征对其模块,得到对齐的支持特征(raw与refined),最后把处理得到的对齐的支持特征和查询特征送入局部到局部的相似性度量模块进行度量,得到两组相似性分数,进行加权求和得到最终的相似性分数。阈值分割是一种基本的图像处理技术:阈值是指将图像中的像素值分成两个或更多个不同的区域,通常是为了将图像中的对象从背景中分离出来。

moonslater的博客 1746

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

【论文理解】ArcFace: Additive Angular Margin Loss for Deep Face Recognition(InsightFace)

论文地址:https://arxiv.org/abs/1801.07698github:https://github.com/deepinsight/insightface这篇论文基本介绍了近期较为流行的人脸识别模型,loss变化从softmax一路捋到CosFace,然后提出ArcFace,可以说起到很好的综述作用。论文评价对比方面也做了非常详细的对比策略方案分析。数据清洗工作也对后续研究应用有...

VivienFu的专栏 2万+

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

深度学习-常用损失函数详细介绍

深度学习常用损失函数介绍, 本文主要收集和整理了深度学习常用的损失函数,包括softmax,arcface,centerloss等常见损失函数,给出函数表达式,以及使用介绍和应用场景

算法之美 9699

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

精度验证的样本_CVPR 2020 | TRAML:利用自适应边际损失增强小样本学习

简单介绍一下我们被 CVPR 2020 录用的一个小样本学习的工作《Boosting Few-Shot Learning With Adaptive Margin Loss》(代码稍后放出),论文地址如下:Boosting Few-Shot Learning With Adaptive Margin Loss​www.weiranhuang.com1、背景近年来,在深度网络的帮助下,计算机已经在图...

weixin_39623050的博客 408

深度学习——知识点总结3(损失函数Loss)

Q:损失函数有几种?原理是什么?有什么特点? 损失函数(loss function)是用来估量模型的预测值f(x)与真实值Y的不一致程度,它是一个非负实值函数,通常使用L(Y, f(x))来表示,损失函数越小,模型的鲁棒性就越好。损失函数是经验风险函数的核心部分,也是结构风险函数重要组成部分。模型的结构风险函数包括了经验风险项和正则项,通常可以表示成如下式子:   其中,前面的均值函数表示...

8782

ArcFace: Additive Angular Margin Loss for Deep Face Recognition

open source:https://github.com/deepinsight/insightface 摘要 一个主要的挑战在特征学习,使用深度卷积神经网络(DCNNs)对大尺度人脸识别,是设计合适loss函数,它能够增强区别。中心损失距离在深度特征和他们相应的类中心在欧几里得空间去实现类内紧度。球体猜测这个线性转换矩阵在最后全卷积层,能够使用作为一个表示类中在欧几里得空...

CSS360的博客 1543

Boosting Few-shot Fine-grained Recognition with Background Suppression and Foreground Alignment

通过经验揭示了显著提高小样本任务性能的两个关键点,一是减弱背景干扰,二是对准前景响应。提出的少样本细粒度识别方法通过引入背景激活抑制、前景对象对齐、局部到局部相似度度量和双重相似性推断机制,显著提高了少样本细粒度分类任务的性能。实验结果验证了方法的有效性和普适性,为少样本细粒度识别领域提供了新的思路和解决方案。

2403_84226839的博客 654

CVPR 2020 & AAAI 2020元学习(Meta-learning)及小样本学习(Few-shot learning)等方向上接收论文总结

目录CVPR 2020AAAI 2020参考资料 CVPR 2020 官网链接:http://cvpr2020.thecvf.com/ 时间:Seattle, Washington,2020年6月14日-6月19日 Meta-Transfer Learning for Zero-Shot Super-Resolution 论文:https://arxiv.org/abs/2002.12213...

yyywxk的博客 6278

读文献 Domain-Adaptive Few-Shot Learning 心得

这篇文章主要讲的是 域自适应小样本学习。 当前主流的小样本学习有个关键的隐性假设是小样本的类与源类样本具有近似的样本空间。 然而很多情况下,小样本问题的样本空间和源样本空间并不完全一致。 所以提出了域自适应小样本学习。 解决方案是在DAPN中嵌入领域自适应特征学习之前,显式地增强每类的源/目标分离,以减轻领域对齐对FSL的负面影响。大量实验表明,DAPN优于最先进的FSL和DA模型 The go...

m0_37929824的博客 1758

小样本学习&元学习经典论文整理

  本文整理了近些年来有关小样本学习的经典文章,并附上了原文下载链接以及论文解读链接。文末有我个人公众号“深视”的二维码链接,关注公众号回复“小样本学习”,可以打包下载全部文章。该文我会持续更新,不断增添新的文章和相关解读,大家可以收藏关注一下。 一、基于度量学习的小样本学习算法 1.《Siamese Neural Networks for One-shot Image Recognition》   网络名称:Siamese Network   文章来源:ICML2015   原文下载:http://www

深视 4万+
上一篇: 论文阅读《Few-Shot Object Detection via Classification Refinement and Distractor Retreatment》
下一篇: 论文阅读《Incremental Few-Shot Object Detection》
不说话装高手H
博客等级 码龄7年 43粉丝 45原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值