用python编写简单合法的线上爬虫并存储在记事本中

网络爬虫是否合法? 网络爬虫合法吗? 网络爬虫领域目前还属于早期的拓荒阶段,虽然互联网世界已经通过自身的协议建立起一定的道德规范(Robots协议),但法律部分还在建立和完善中。从目前的情况来看,如果抓取的数据属于个人使用或科研范畴,基本不存在问题;而如果数据属于商业盈利范畴,就要就事而论,有可能属于违法行为,也有可能不违法。 1.2.1 Robots协议 Robots协议(爬虫协议)的全称是“网络爬虫排除标准”(R... 阅读详情

第一步:选择目标网页

第二步:进行代码编写
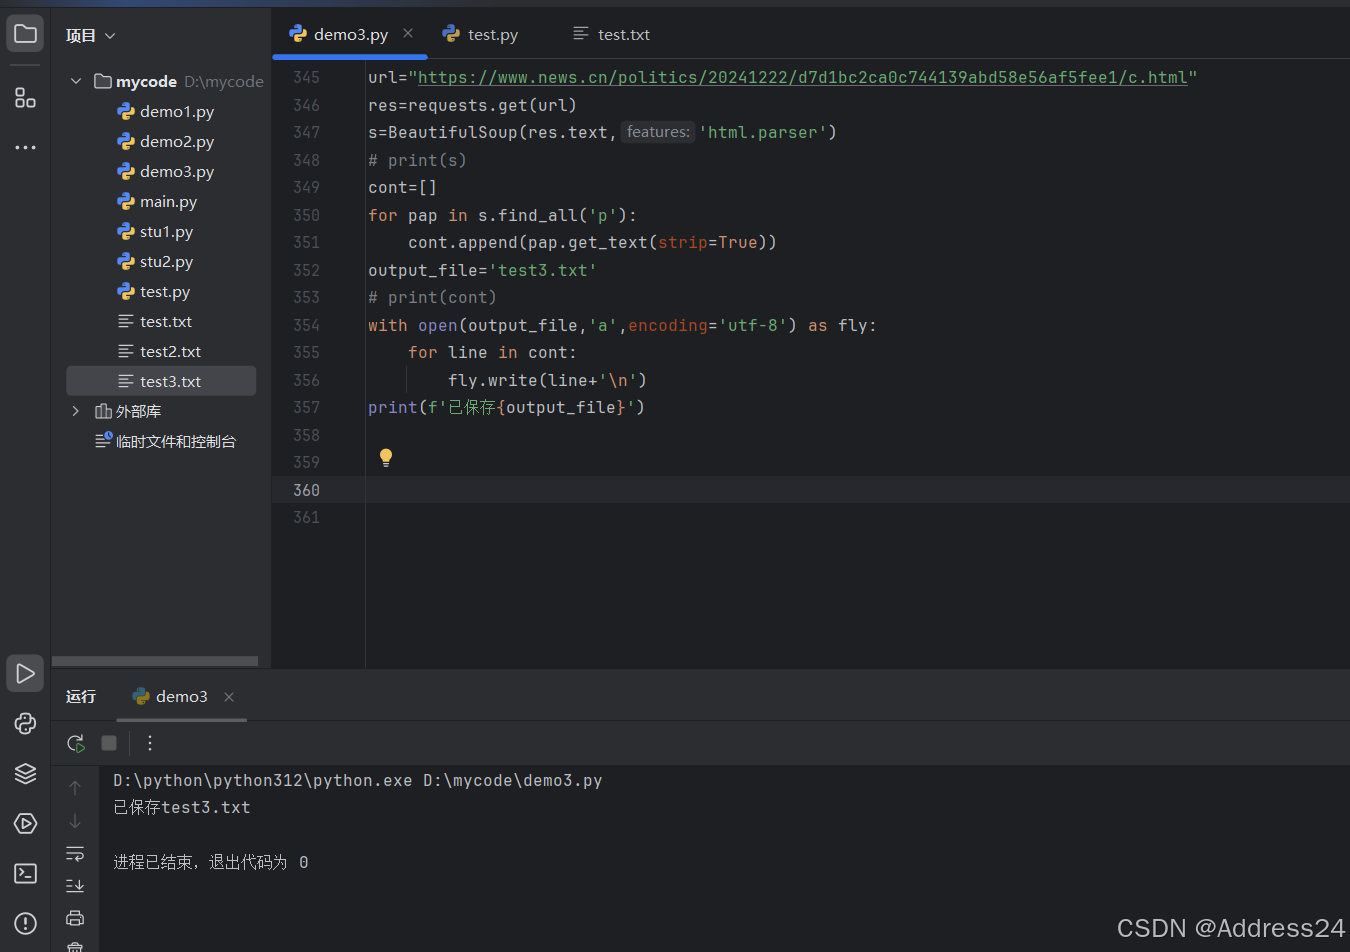
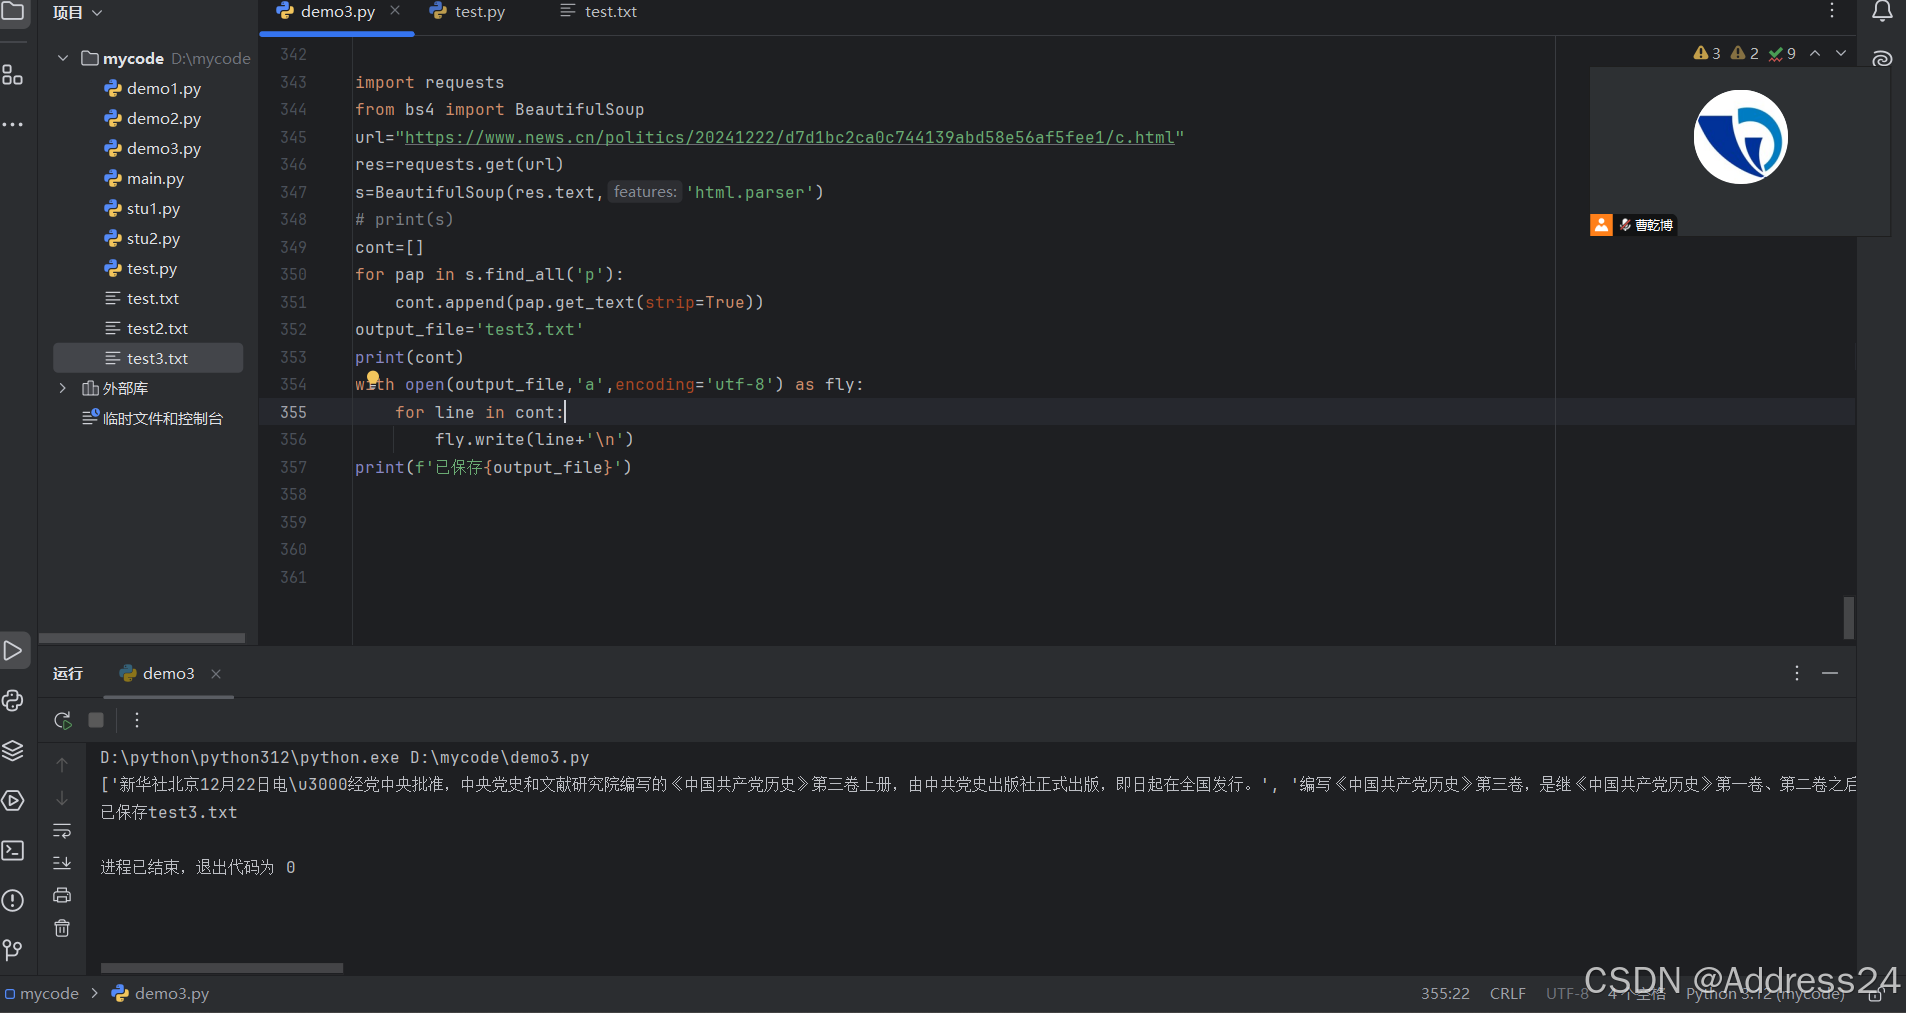
在第二步中可以进行测试,看网页是否解析成功
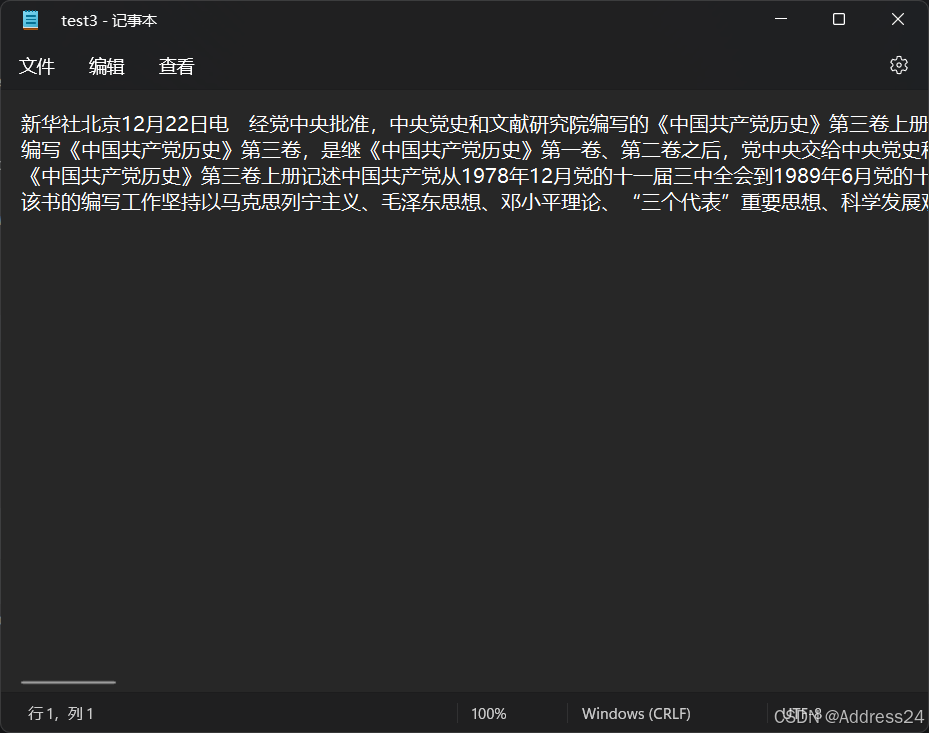
最后则是记事本的结果查看
以下是代码内容

import requests
from bs4 import BeautifulSoup
url="https://www.news.cn/politics/20241222/d7d1bc2ca0c744139abd58e56af5fee1/c.html"
res=requests.get(url)
s=BeautifulSoup(res.text,'html.parser')
# print(s)
cont=[]
for pap in s.find_all('p'):
    cont.append(pap.get_text(strip=True))
output_file='test3.txt'
# print(cont)
with open(output_file,'a',encoding='utf-8') as fly:
    for line in cont:
        fly.write(line+'\n')
print(f'已保存{output_file}')

Python 网络爬虫进阶教学全指南 本次博客将深入探究 Python 网络爬虫的核心知识与实用技巧,引领大家从入门迈向精通 阅读详情

相关推荐

Python 网络爬虫入门全知道

Python 网络爬虫入门全知道

安年的小小博客有大大的梦想 2742

Python 网络爬虫

自动发送 HTTP 请求访问网页;下载网页资源(HTML、图片、文件等);解析并提取所需信息;实现数据存储与后续处理。网络爬虫在数据采集、搜索引擎、舆情监控等方面有着广泛的应用。

专注于C/C++、Python、嵌入式、Linux与算法研究的技术分享者,记录成长,分享干货,积累价值。 3241

Python 网络爬虫入门与实践:从基础到高级技巧

详细介绍了 Python 网络爬虫的基础知识、常用库、实战案例以及高级技巧

AI+全栈,AI+应用,实操落地,前沿技术 1691

一文带你掌握Python网络爬虫

Python 网络爬虫作为数据获取的有力工具,在当今数字化时代发挥着重要作用。通过本文,我们深入了解了爬虫的基本概念、工作流程、常用库以及实战应用。从简单的网页请求与解析,到复杂的反爬虫策略应对,每一个环节都蕴含着丰富的技术知识和实践技巧。在实际应用中,爬虫已经广泛渗透到各个领域,如市场调研、数据分析、舆情监测等。它帮助企业和研究人员快速获取大量有价值的数据,为决策提供了有力支持。但我们也不能忽视爬虫使用过程中的法律和道德问题,遵守 Robots 协议、保护数据隐私和合法使用数据是我们必须坚守的原则。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 4661

【基础】【Python网络爬虫】【1.认识爬虫】什么是爬虫,爬虫分类,爬虫可以做什么

认识爬虫 1.什么是爬虫 2.爬虫可以做什么 3.为什么用 Ptyhon 爬虫 4.爬虫的分类 通用爬虫 聚焦爬虫 功能爬虫 增量式爬虫 分布式爬虫 5.爬虫的矛与盾(重点) 6.盗亦有道的君子协议robots 7.爬虫合法性探究

weixin_43612602的博客 2533

python网络爬虫从入门到实践第2版pdf-Python网络爬虫从入门到实践 第2版

前言第1章 网络爬虫入门11.1 为什么要学网络爬虫21.1.1 网络爬虫能带来什么好处21.1.2 能从网络上爬取什么数据31.1.3 应不应该学爬虫31.2 网络爬虫是否合法31.2.1 Robots协议41.2.2 网络爬虫的约束51.3 网络爬虫的基本议题61.3.1 Python爬虫的流程71.3.2 三个流程的技术实现7第2章 编写第一个网络爬虫92.1 搭建...

weixin_39683163的博客 3495

Python网络爬虫简介与环境配置

Python网络爬虫简介以及环境配置,包括conda环境下载安装、PyCharm编辑器下载安装以及解释器配置,网络爬虫所需库安装,MySQL数据库安装、MongoDB数据库安装。

shield911的博客 6080

1-认识网络爬虫

​ 网络爬虫(Web Crawler)又称网络蜘蛛、网络机器人,它是一种按照一定规则,自动浏览万维网的程序或脚本。通俗地讲,网络爬虫就是一个模拟真人浏览万维网行为的程序,这个程序可以代替真人自动请求万维网,并接收从万维网返回的数据。与真人浏览万维网相比,网络爬虫能够浏览的信息量更大,效率也更高。

qwy715229258163的博客 1846

Python网络爬虫技术

Python网络爬虫作为一种强大的数据获取工具,在数据分析、信息检索、搜索引擎优化等领域发挥着重要作用。然而,在使用爬虫时,我们必须遵守相关法律法规和网站的访问政策,确保数据的合法性和隐私保护。同时,随着技术的不断发展,我们也应积极探索和创新爬虫技术的新应用和新方法。

jun778895的博客 3952

Python之网络爬虫(爬虫基本认知、网络爬虫之路)

文章目录一、爬虫基本认知二、爬虫之路初级爬虫工程师中级爬虫工程师高级爬虫工程师 一、爬虫基本认知 1、爬虫的简单定义 网络爬虫,又称为网页蜘蛛、蚂蚁、蠕虫、模拟程序,在FOAF社区中,被称为二王爷追逐者。是一种按照一定的规则,自动抓取万维网信息的程序或者脚本。简单来说,网络爬虫就是使用事先写好的程序去抓取网络上所需要的数据。 2、通用网络爬虫 搜索引擎的第一步就是爬虫,但是搜索引擎中的爬虫是一种广泛获取各种网页信息的程序,除了HTML文件外,搜索引擎通常还会抓取和索引文字为基础的多种文件类型,如TXT,WO

Viewinfinitely的博客 888

Python网络爬虫技术详解与实践

本文还有配套的精品资源,点击获取 简介:随着信息技术的发展,网络数据获取和处理变得至关重要。Python以其强大的库支持和简洁语法,成为开发网络爬虫(Spider)的首选工具。本文详细介绍了Python爬虫的基本原理、常用库、实战技巧,框架构建,数据存储,反爬策略,多线程/异步处理,分布式爬虫等关键技术点,并通过新闻网站、电商平台和社交媒体数据爬取的实战案例,阐述了Pyth...

weixin_42510243的博客 1628

一文搞懂,Python网络爬虫

爬虫(crawler)也经常被称为网络蜘蛛(spider),是按照一定的规则自动浏览网站并获取所需信息的机器人程序(自动化脚本代码),被广泛的应用于互联网搜索引擎和数据采集。使用过互联网和浏览器的人都知道,网页中除了供用户阅读的文字信息之外,还包含一些超链接,网络爬虫正是通过网页中的超链接信息,不断获得网络上其它页面的地址,然后持续的进行数据采集。正因如此,网络数据采集的过程就像一个爬虫或者蜘蛛在网络上漫游,所以才被形象的称为爬虫或者网络蜘蛛。

Jernnifer_mao的博客 1716

IEC 62056协议栈深度拆解:从物理层握手到应用层AARQ,一次完整的DLMS通讯抓包分析

本文深入解析IEC 62056协议栈(DLMS/COSEM)的全流程通信机制,从物理层握手到应用层AARQ建立,提供详细的抓包分析和实战指南。涵盖RS-485配置、HDLC帧解析、OBIS编码解读等核心内容,并附有常见故障排查技巧,助力开发者高效实现电能表数据采集。

weixin_29182481的博客 312

Python网络爬虫

Python以简单高效著称,在日常工作中用处非常多,处理文件、群发网络请求、爬网页信息等等,现把Python语法总结如下,供后续方便复习查阅。 文章目录一、变量 一、变量

Captain_RB的博客 5704

PyTorch实战:用FGSM攻击MNIST分类器(附可视化对比)

本文通过PyTorch实战演示了如何使用FGSM对抗攻击方法攻击MNIST手写数字分类器。文章详细解析了FGSM攻击原理,提供了从环境搭建、模型准备到攻击实施、可视化对比的完整代码实战流程,并探讨了对抗样本的生成与模型鲁棒性评估。

3a9bq4r8t2y的博客 216

时间序列分析:ARCH、GARCH、TGARCH与DCC-GARCH波动率模型(含代码)

关注TGARCH模型和DCC-GARCH的应用,通过在沪深300和中证500指数上应用TGARCH和DCC-GARCH模型,揭示这两个指数之间的条件异方差及动态相关性的变化规律。

celiaweiwei的博客 1万+

Python爬虫-认识网络爬虫

熟悉网络爬虫的概念及分类,能够归纳通用网络爬虫和聚焦网络爬虫的区别。

csy20230322065的博客 1847

3分钟搞定!QQ音乐歌单导出Excel保姆级教程(含歌单ID获取技巧)

本文提供了一份详细的QQ音乐歌单导出Excel保姆级教程,帮助用户轻松备份和管理个人音乐收藏。教程核心在于获取歌单ID,并利用浏览器开发者工具执行脚本提取数据,最后通过Excel导入功能快速生成结构化表格。整个过程无需编程基础,3分钟即可搞定,是个人数据管理的实用技巧。

weixin_29008691的博客 1401

python网络爬虫

使用浏览器开发者工具(Network 标签)分析 XHR/Fetch 请求。(Scrapy 内置):结合 CSS 和 XPath。:自动化浏览器(支持 Chrome/Firefox)。:抓取电商网站商品价格(JavaScript 渲染)。:跨浏览器自动化工具(比 Selenium 更快)。(Chrome 插件):快速生成 XPath。:自动化抓取网页数据(文本、图片、视频等)。:简单易用的 HTTP 库(同步请求)。:处理请求/响应(如代理、UA 轮换)。尊重数据版权(禁止商用未授权数据)。

李昭的博客 2137

Cadence仿真数字电路功耗

Cadence仿真数字电路功耗 数字电路的功耗采用平均电流乘电源电压获得,所以本文的关键是测量平均电流。 仿真前设置好仿真参数后,在仿真的ADE街边选择:outputs➡to be saved➡select on design 选择电源的负端电流(若选择正端,则电流为负): 选择完成后,在ADE界面讲所选节点的plot也勾选上,点击run。仿真完成后自动显示波形。在波形上选中该电流曲线,右击选择:send to➡calculator 注意上图中,商店前的波形不稳定,需要进行截取。在calculator

qq_41519780的博客 1万+

AD-Copilot 论文解读:把“大模型看图”升级为“对照检验”的工业异常检测助手

本文提出AD-Copilot,一个面向工业异常检测的视觉语言助手,通过视觉上下文比较解决现有方法的不足。针对工业场景中多模态大模型表现不佳的问题,作者指出核心原因在于缺乏工业数据和比较能力不足。为此,论文提出三个关键贡献:构建Chat-AD数据集,设计Comparison Encoder显式建模图像差异,以及采用多阶段训练策略。实验表明,该方法在MMAD基准上达到82.29%准确率,定位任务提升3.35倍,并展现出良好的泛化能力。消融实验验证了比较模块的有效性,表明其成功源于高质量比较数据与显式比较模块的协

blanokvaffy的博客 333
上一篇: 设计一个简单的计算机程序,在其中加入各种异常捕获并能保证指定范围内整数的四则运算
下一篇: 用python编写简单合法的线上爬虫并存储在记事本中
Address24
博客等级 码龄2年 55粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值