


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于机器学习的智能手写数字识别系统
项目背景
手写数字识别是计算机视觉领域的经典任务,广泛应用于银行支票识别、邮政编码识别和表单自动化等场景。随着数字化进程的加快,手写数字识别的需求不断增加。传统图像处理方法在处理手写数字时常常面临准确率低、鲁棒性差等问题。手写数字识别系统,可以自动提取图像特征,克服传统方法的不足,进而实现更高的识别精度和实时处理能力。
数据集
通过问卷、在线平台或专门的采集设备获得多样化的数字样本,以确保数据集的代表性和广泛性。样本应包括不同书写风格、笔画粗细和数字大小,以提高模型的泛化能力。对收集到的手写样本进行图像预处理(灰度化、尺寸归一化和噪声去除)。灰度化将彩色图像转换为灰度图像,减少了计算复杂度。每张图像应对应一个数字标签,通常使用0到9的数字表示进行标注。将处理后的图像和对应的标签保存为训练集和测试集。

设计思路
卷积神经网络(CNN)是一种特别设计用于处理数据具有类似网格结构的深度学习模型,尤其在图像处理领域表现突出。CNN通过局部连接、权重共享和池化操作等技术,有效减少了模型的参数数量,降低了计算复杂度,提高了训练速度。卷积层是CNN的核心组件,它使用卷积核(或滤波器)对输入图像进行滑动窗口操作,从而提取局部特征。每个卷积核通过学习不同的特征,可以捕捉到边缘、角点、纹理等基本特征。

CNN的架构通常由多个卷积层、池化层和全连接层组成。每个卷积层后面通常会跟随一个池化层,池化层通过下采样操作减少特征图的尺寸,同时保留重要信息,降低了过拟合的风险。通过堆叠多个卷积层,CNN能够形成多层次的特征表示,从低级特征(如边缘和纹理)到高级特征(如形状和对象)。在手写数字识别任务中,CNN能够有效区分不同数字的形状和结构,提升识别精度,相比传统的图像处理方法,CNN在处理复杂图像时展现出更强的能力。

注意力机制是一种模拟人类视觉注意力的技术,旨在提高模型对关键信息的关注程度。传统的神经网络通常对输入的所有部分给予相同的权重,而注意力机制通过动态调整每个输入部分的权重,使模型能够自适应地聚焦于最重要的特征。这种机制尤其在处理复杂数据(如图像和文本)时发挥了重要作用,有助于提升模型的性能和解释性。注意力机制可以通过强调数字的特定区域(如边缘、笔划等)来增强模型的识别能力。通过加权不同区域的特征,模型能够在不同的输入图像中自适应地选择最相关的部分,提高了对模糊或复杂数字的识别率。注意力机制还能够提供对模型决策过程的可解释性,帮助理解哪些特征对最终识别结果起到了关键作用。

结合卷积神经网络与注意力机制,对于手写数字识别任务而言,能够获得显著的性能提升。CNN作为特征提取的基础,能够高效地从数字图像中获取重要信息,而注意力机制则进一步增强了模型对这些特征的聚焦能力。CNN负责提取数字的基本形状、边缘和纹理特征,而注意力机制则通过加权这些特征,使模型能够更精准地识别出不同数字之间的细微差别。
收集手写数字样本,对收集到的手写样本进行图像预处理。预处理步骤包括图像灰度化、尺寸归一化和噪声去除。噪声去除可以使用高斯模糊等技术,减少图像中的干扰信息。每张图像应对应一个数字标签,通常使用0到9的数字表示。可以利用Python的图像处理库(如OpenCV或PIL)进行标注。将处理后的图像和对应的标签保存为训练集和测试集,通常以70%的数据用于训练,30%的数据用于测试。
import cv2
import os

def preprocess_image(image_path):
    image = cv2.imread(image_path)
    gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
    resized_image = cv2.resize(gray_image, (28, 28))
    return resized_image

# 示例:对图像进行预处理
image_path = 'path_to_handwritten_digit_image.jpg'
processed_image = preprocess_image(image_path)
cv2.imwrite('processed_image.jpg', processed_image)
加载预处理后的图像和对应标签,通常使用深度学习框架的内置数据加载功能。数据应分为训练集和验证集,以便在训练过程中监控模型性能。选择合适的批量大小和数据增强方法,可以提高模型的泛化能力,减少过拟合风险。采用卷积神经网络(CNN)架构。构建时定义卷积层、池化层和全连接层。卷积层用于提取特征,池化层用于降低维度,全连接层用于最终分类。选择激活函数和损失函数,激活函数通常使用ReLU,损失函数使用交叉熵。通过使用Dropout等正则化技术,进一步提高模型的鲁棒性。
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D, Flatten, Dense, Dropout

model = Sequential()
model.add(Conv2D(32, kernel_size=(3, 3), activation='relu', input_shape=(28, 28, 1)))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Conv2D(64, kernel_size=(3, 3), activation='relu'))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Flatten())
model.add(Dense(128, activation='relu'))
model.add(Dropout(0.5))  # Dropout层用于减少过拟合
model.add(Dense(10, activation='softmax'))  # 输出层,10个类别对应数字0到9
使用训练集对模型进行训练,设置训练轮数和批量大小。使用Adam或SGD等优化器进行权重更新。通过验证集监控训练过程,调整超参数以防止过拟合。可以使用EarlyStopping回调函数,在模型性能不再提升时提前终止训练。
from keras.callbacks import EarlyStopping

model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])
early_stopping = EarlyStopping(monitor='val_loss', patience=3)

model.fit(train_images.reshape(-1, 28, 28, 1), train_labels, epochs=20, batch_size=32, validation_split=0.2, callbacks=[early_stopping])
使用测试集评估训练好的模型性能,通过计算准确率和损失等指标判断模型的有效性。可以绘制混淆矩阵,以可视化分类结果。计算模型在测试集上的准确率,以评估其泛化能力。
import numpy as np
from sklearn.metrics import confusion_matrix
import matplotlib.pyplot as plt
import seaborn as sns

test_loss, test_accuracy = model.evaluate(test_images.reshape(-1, 28, 28, 1), test_labels)

# 预测测试集
predictions = np.argmax(model.predict(test_images.reshape(-1, 28, 28, 1)), axis=-1)

# 绘制混淆矩阵
conf_matrix = confusion_matrix(test_labels, predictions)
plt.figure(figsize=(10, 8))
sns.heatmap(conf_matrix, annot=True, fmt="d", cmap="Blues")
plt.xlabel('Predicted')
plt.ylabel('True')
plt.title('Confusion Matrix')
plt.show()

print(f'Test accuracy: {test_accuracy}')
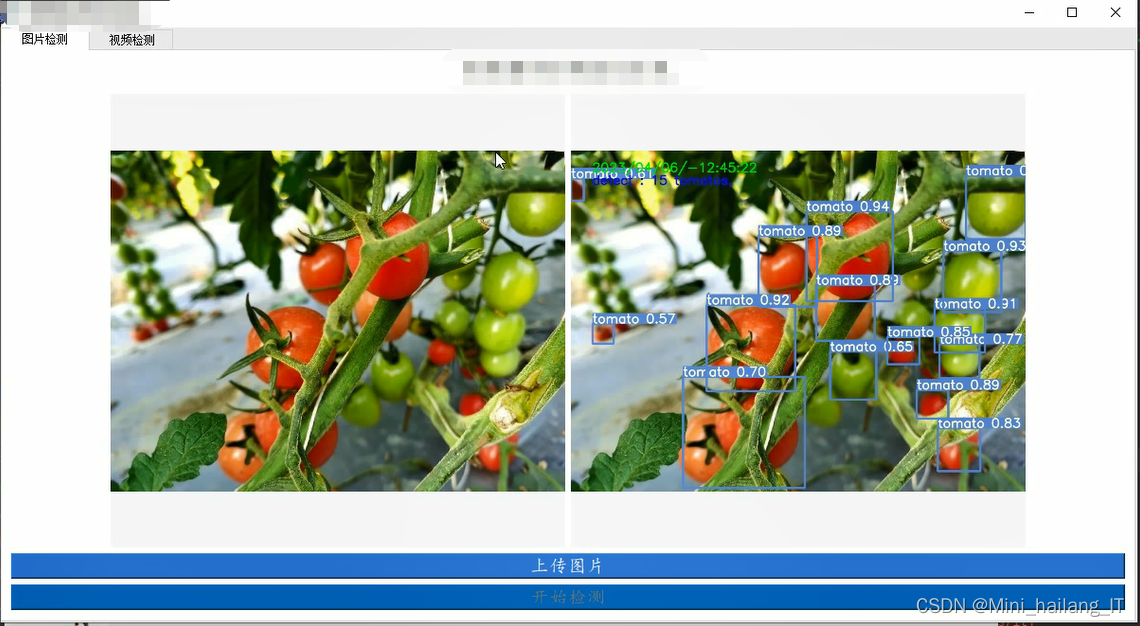
海浪学长项目示例:


 2359


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


