毕业设计:基于深度学习的淡水鱼种类自动检测系统

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情

目录

前言

项目背景

数据集

设计思路

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

       🎯基于深度学习的淡水鱼类自动检测系统研究

项目背景

       鱼类检测在渔业管理、生态研究和环境保护等领域具有重要意义。传统的鱼类识别方法通常依赖于人工观察和专家知识,不仅耗时且容易受到主观因素的影响。随着计算机视觉和深度学习技术的发展,利用图像处理方法进行鱼类的自动检测和分类,能够提高识别的速度和准确性,促进可持续渔业管理和生态环境保护。

数据集

       淡水鱼种类图像采集在自然栖息地、鱼市或水族馆中拍摄真实的淡水鱼种类,获得不同角度和光照条件下的图像。利用已有的在线资源,如专业的鱼类数据库、社交媒体和自然观察平台,抓取公开发布的淡水鱼图像。这种方法能够快速收集到大量样本,尤其是稀有或难以拍摄的鱼种,为数据集的丰富性提供了保障。为了准确地标识每个图像中的鱼种,可以使用专业的标注工具进行数据标注,如LabelImg或VoTT等。标注过程中,研究人员需要为每张图像分配标签,包括鱼种名称、特征和其他相关信息。

       将数据集分为训练集、验证集和测试集,常见的比例为70%、15%和15%。这种划分有助于在模型训练过程中进行性能评估。同时,为了增强数据集的多样性和鲁棒性,可以应用数据扩展技术,包括旋转、缩放、翻转和颜色调整等方式,以生成更多的变体图像。

设计思路

       卷积神经网络(CNN)是一种深度学习模型,广泛应用于图像识别、图像分类和目标检测等领域。CNN 的核心思想在于通过卷积操作从原始图像数据中自动提取特征,而不需要手动设计特征。CNN 由多层组成,包括卷积层、池化层和全连接层,其中卷积层负责特征提取,池化层则用于减少特征图的维度,从而降低计算复杂度和模型参数量。卷积层中的卷积核能够学习到图像的局部特征,例如边缘、纹理等,而通过层叠多个卷积层,CNN 可以逐渐学习到更高级、更抽象的特征。由于 CNN 的结构设计使得它能够有效捕捉图像中的空间层次关系,因此在处理图像任务时表现出色。

       CNN 的训练通常采用反向传播算法(Backpropagation),该算法通过最小化损失函数来学习模型参数。在图像分类任务中,常用的损失函数包括交叉熵损失和均方误差损失。训练过程开始时,模型会通过前向传播计算预测值,并与真实标签进行比较,从而计算损失。接着,通过反向传播算法,计算损失相对于模型参数的梯度,并使用梯度下降法更新模型参数。这一过程会不断迭代,直到模型在训练集上的损失达到可接受的水平。

       训练过程中,CNN 将通过卷积层提取鱼类图像中的特征,如鱼的形状、颜色、纹理等,再通过池化层降低特征图的维度,减少计算量。经过多层特征提取后,最后通过全连接层将提取到的特征映射到具体的鱼类类别上。模型训练完成后,可以使用测试集对其进行评估,以确保模型在未见数据上的表现良好。

       YOLOv5是一种高效的目标检测模型,广泛应用于实时物体检测任务,包括鱼类自动检测系统。YOLOv5 的核心思想是将目标检测问题转化为回归问题,通过一个单一的神经网络直接预测边界框和类别概率。与传统的目标检测方法相比,YOLOv5 在速度和精度上取得了显著的提升,使其特别适合于需要实时处理的应用场景,如水下监控和水产养殖管理。在鱼类自动检测任务中,YOLOv5 可以快速识别和定位图像中的不同鱼类,提高监测效率。

       在构建鱼类自动检测系统时,首先需要准备一个标注好的鱼类图像数据集,以便用于训练 YOLOv5 模型。数据集应包含多种鱼类的图像,并标注出每种鱼类的边界框及其类别。YOLOv5 提供了便捷的数据集格式支持,用户只需将数据集组织为相应的文件结构,便可进行训练。训练过程中,YOLOv5 会利用增强技术提升模型的泛化能力,例如图像的旋转、缩放和裁剪等,从而保证模型在不同环境下的鲁棒性。训练完成后,YOLOv5 模型可以用于实际的鱼类检测任务。通过将待检测的图像输入到模型中,系统能够快速输出每个检测到的鱼类的边界框及类别信息。

       使用YOLOv5支持的标注格式(如YOLO格式),每张图像的标注文件应包含目标的类别及其在图像中的位置(边界框坐标)。在标注过程中,建议使用LabelImg等工具进行可视化标注,以便于准确框选每个鱼种。完成标注后,要将图像数据和相应的标注文件组织到YOLOv5所需的目录结构中,通常包括‘images’和‘labels’两个文件夹,分别存放图像和标注文件。

# 示例:组织数据集文件结构
import os
import shutil

# 创建所需的目录结构
os.makedirs('dataset/images/train', exist_ok=True)
os.makedirs('dataset/images/val', exist_ok=True)
os.makedirs('dataset/labels/train', exist_ok=True)
os.makedirs('dataset/labels/val', exist_ok=True)

# 复制图像和标签到相应目录
shutil.copy('raw_images/image1.jpg', 'dataset/images/train/image1.jpg')
shutil.copy('raw_labels/image1.txt', 'dataset/labels/train/image1.txt')

       YOLOv5提供了多种预训练模型(如YOLOv5s、YOLOv5m、YOLOv5l),用户可以根据数据集的大小和计算资源选择合适的模型。配置文件中需要指定数据集的路径、类别数量以及学习率等超参数。然后,使用YOLOv5的训练脚本启动训练过程。训练过程中,模型会不断优化权重,以降低损失函数,并通过验证集监测模型性能,避免过拟合。

import os
import shutil

# 创建目录结构
def create_dataset_structure(base_dir):
    os.makedirs(os.path.join(base_dir, 'images/train'), exist_ok=True)
    os.makedirs(os.path.join(base_dir, 'images/val'), exist_ok=True)
    os.makedirs(os.path.join(base_dir, 'labels/train'), exist_ok=True)
    os.makedirs(os.path.join(base_dir, 'labels/val'), exist_ok=True)

# 移动文件到相应的目录
def organize_files(image_files, label_files, base_dir):
    for img_file in image_files:
        shutil.copy(img_file, os.path.join(base_dir, 'images/train', os.path.basename(img_file)))
    for lbl_file in label_files:
        shutil.copy(lbl_file, os.path.join(base_dir, 'labels/train', os.path.basename(lbl_file)))
# 示例使用
create_dataset_yaml(base_directory, 3)

# 使用YOLOv5进行训练
os.system('python train.py --img 640 --batch 16 --epochs 50 --data dataset.yaml --weights yolov5s.pt')

       使用YOLOv5提供的评估脚本,对测试集进行推理,计算指标如平均精度均值(mAP)、召回率和精确率等。这些指标可以帮助判断模型在实际应用中的表现。同时,通过可视化工具,可以在图像上绘制预测的边界框,以直观地展示模型的识别效果。根据评估结果,可以考虑进一步调优模型参数或进行数据增强,以提高识别精度。

# 对测试集进行评估
def evaluate_model(weights_path, data_yaml):
    os.system(f'python val.py --weights {weights_path} --data {data_yaml} --img 640')

# 进行推理
def inference_on_images(weights_path, images_folder):
    os.system(f'python detect.py --weights {weights_path} --img 640 --conf 0.25 --source {images_folder}')

# 示例使用
evaluate_model('runs/train/exp/weights/best.pt', os.path.join(base_directory, 'dataset.yaml'))
inference_on_images('runs/train/exp/weights/best.pt', 'test_images/')

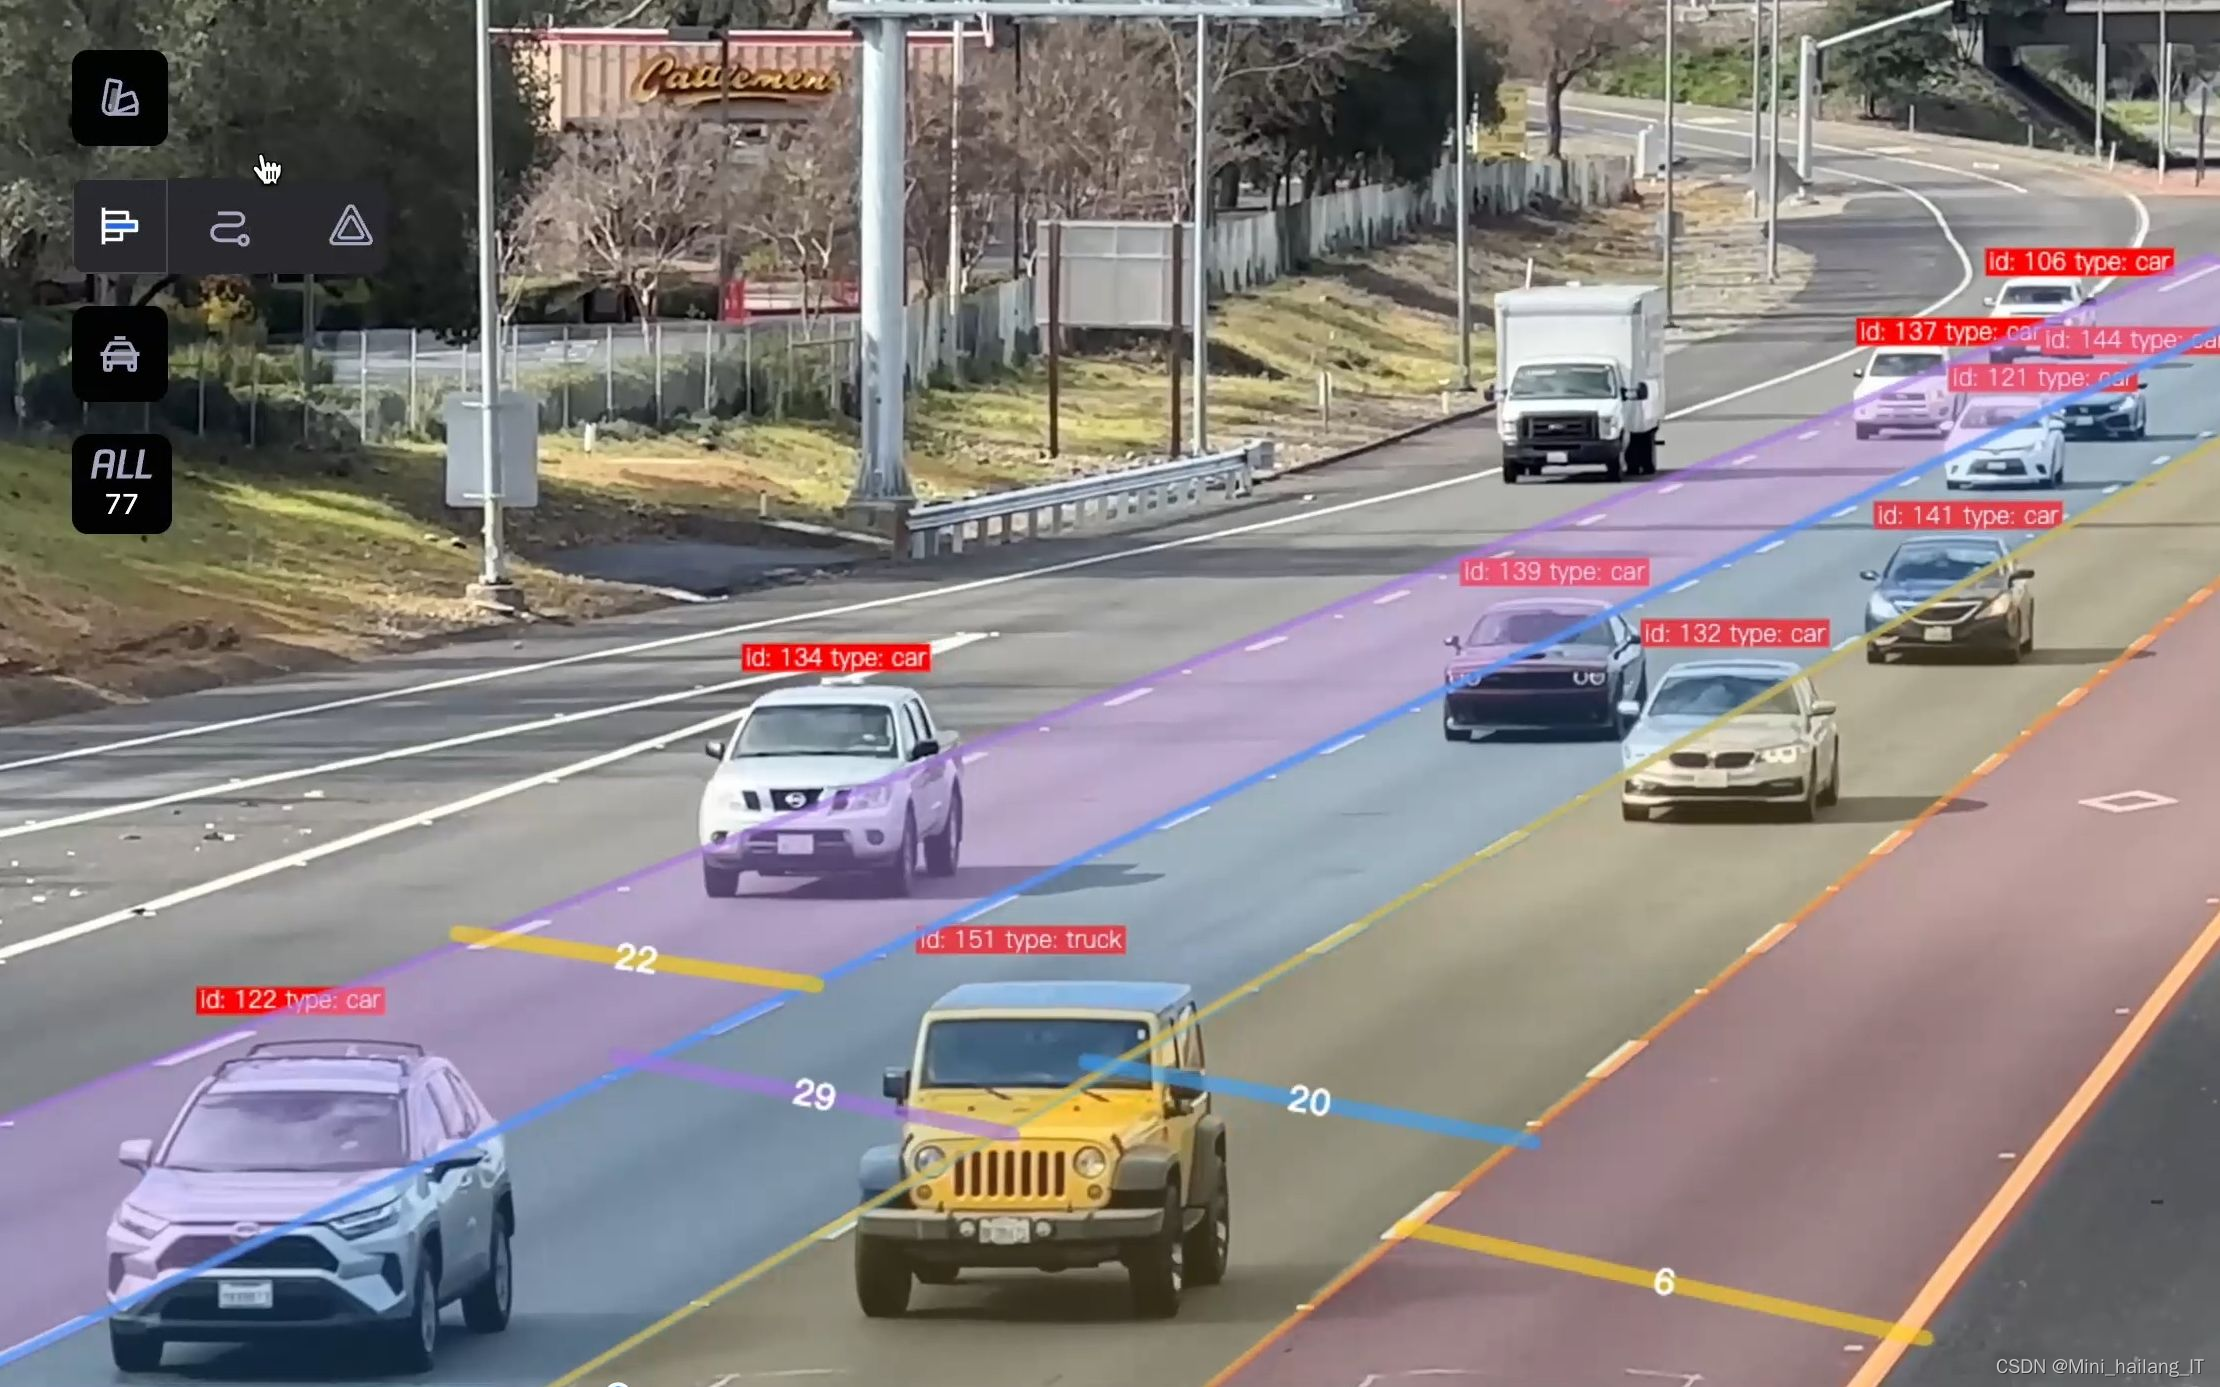
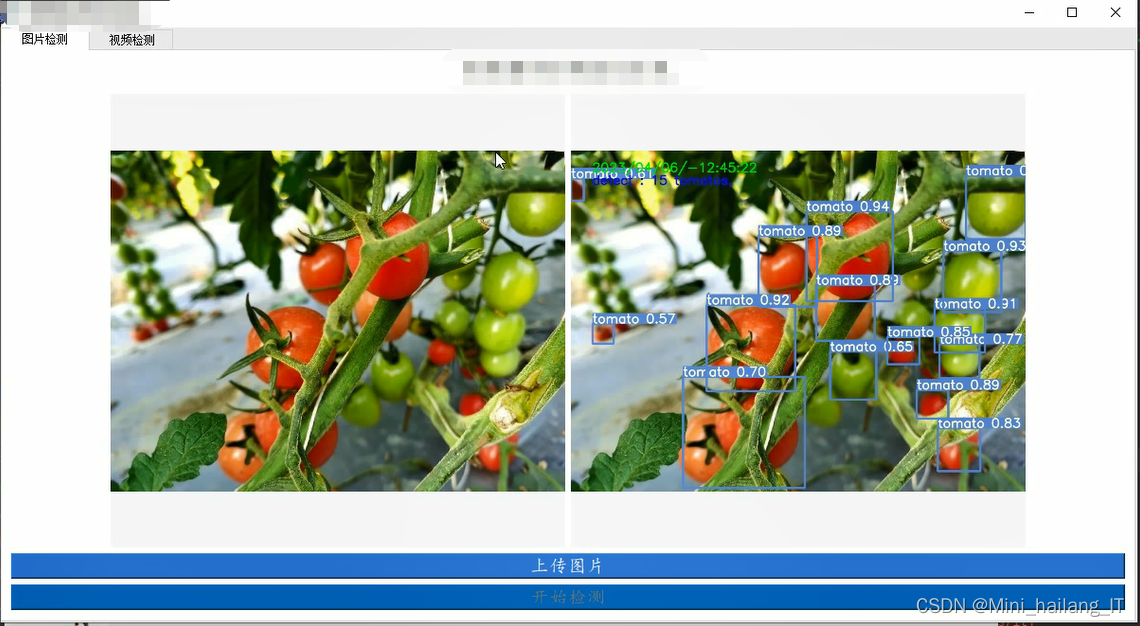
海浪学长项目示例:
更多帮助

深度学习之Seq2Seq原理与实战 【代码】深度学习之Seq2Seq原理与实战。 阅读详情

相关推荐

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 187

基于深度学习YOLOv10的水下鱼类检测系统(YOLOv10+YOLO数据集+UI界面+模型)

项目背景水下鱼类识别在海洋生态研究、渔业资源管理、水产养殖等领域具有重要意义。传统的水下鱼类识别方法依赖于人工观察或声呐技术,效率较低且容易受到水下环境的干扰。基于深度学习的目标检测技术能够自动识别鱼类,并在复杂水下环境中提供准确的检测结果。项目目标本项目旨在利用 YOLOv10 目标检测算法,构建一个高效、准确的水下鱼类识别系统。系统能够实时检测图像或视频中的鱼类,并输出检测结果。通过训练和优化模型,系统能够在复杂水下环境中准确识别鱼类,满足海洋生态研究和渔业资源管理的需求。技术栈。

斌擎科技 750

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 258

基于深度学习的水下鱼类识别系统(YOLOv8+YOLO数据集+UI界面+Python项目+模型)

本项目基于YOLOv8深度学习框架,开发了一套专用于水下环境的高效鱼类识别系统。系统针对单一鱼类类别进行优化,采用1463张精心标注的水下图像数据集(训练集1170张、验证集146张、测试集147张)进行模型训练。通过特殊的数据增强技术和水下图像复原算法,系统能够克服水下环境特有的光线衰减、散射干扰和低对比度等挑战,实现高精度的鱼类目标检测。

斌擎科技 1803

深度学习之词袋(Bag-of-Words, BoW)原理与实战

【代码】深度学习之词袋(Bag-of-Words, BoW)原理与实战。

yumiwangzi30的博客 224

深度学习之LSTM原理与实战

【代码】深度学习之LSTM原理与实战。

yumiwangzi30的博客 130

【深度学习笔记】深度学习用于图片的分类和检测总结

前言: 主要总结一下自己最近看文章和代码的心得。 1. CNN用于分类:具体的过程大家都知道,无非是卷积,下采样,激活函数,全连接等。CNN用于分类要求它的输入图片的大小是固定的(其实不单单是CNN,很多其它的方法也是这样的),这是它的一个不足之处之一。目前的大部分CNN都是用来做分类比较多。 2. CNN用于检测:主要的方法有两种,细分一下有三种, 第一种最为简单和暴力的,

1983的专栏 8156

AI对战五子棋——深度学习策略网络

在本篇博文中,我们完成了:✔ 构建一个 CNN 五子棋策略网络✔ 让神经网络输出落子概率✔ 使用 Policy Gradient 强化学习训练 AI✔ 让 AI 实现人与 AI、AI 自对弈博弈。

X2829352498的博客 25

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 196

dmx512协议c语言编程,DMX512协议+c程序代码.pdf

DMX512 协议1.协议简介DMX 是Digital MultipleX 的缩写 ,意为多路数字传输。DMX512 控制协议是美国舞台灯光协会(USITT)于1990 年发布的灯光控制器与灯具设备进行数据传输的工业标准 ,全称是 USITT DMX512(1990) ,包括电气特性、数据协议、数据格式等方面的内容。2. 电气特性和物理层2.1. 电气特...

weixin_39928993的博客 2543

从ARCore到AICore:揭秘Google如何通过系统级服务推动Android生态创新

本文深入探讨了Google如何通过AICore等系统级服务推动Android生态创新。从ARCore到AICore,Google通过分层解耦策略将AI能力下沉至系统层,实现端侧大模型推理,如Gemini Nano在Pixel 8 Pro中的应用。文章剖析了AICore的技术架构、开发者赋能路径及场景化实践,展示了其在通信、内容创作和生产力工具中的卓越表现。

rust6ferris的博客 545

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 358

PTA 学生信息的那些操作:添加记录(结构体)

这是河南工业大学自主命题的一道基础题,题目如下: 有一学生成绩表,包括学号、姓名、3门课程成绩。已知该成绩表按学号升序排序。请编程实现,添加一个新的学生信息,且使成绩表仍按学号有序;若待添加的学号与已有学号重复,则输出错误信息,拒绝添加。 输入格式: 首先输入一个整数n(1<=n<=100),表示学生人数; 然后输入n行,每行包含一个学生的信息:学号(12位)、姓名(不含空格且不超过20位),以及3个整数,表示3门课成绩,数据之间用空格隔开。 最后一行输入一个待添加的学生信息,包括学号

weixin_63617665的博客 3156

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 215

DaVinci Configurator BswM模块配置

BswM是AUTOSAR(Automotive Open System Architecture)系统架构中的模块之一,它是基础软件模块(BSW)之一。BswM全称为Basic Software Module Manager(基础软件模块管理器),它负责管理和协调其他BSW模块的行为和交互,以实现整个系统的功能。BswM可以被看作是一个状态机,通过监控系统的状态和事件触发,来控制其他BSW模块的运行状态和互相配合,以达到整个系统的预期行为。

qq_59258431的博客 3947

组态王7.5和SQLsever数据库交互

摘要:本文详细介绍了组态王7.5与SQL Server 2016数据库交互的实现流程,包括建立连接、数据存储与查询操作。主要内容涵盖ODBC数据源配置、数据库表格创建、数据插入及查询功能实现(含日期控件查询)

gsjkwg的博客 1580

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 353

光谱数据计算CIE值(三刺激值、CIE1931、CIE1976、CCT)软件

软件界面如下,免安装,拷贝即可使用 导入光谱数据即可计算三刺激值、CIE1931、CIE1976、CCT CIE1931、CIE1976色坐标图形只管显示 导入的光谱数据格式如下,txt文本 波长380到780,间隔1nm 注意:缺省的数据默认写0即可 下面为一些CIE相关介绍: CIE(国际发光照明委员会):原文为Commission Internationale de L’Eclairage(法)或International Commission on Illumination(英)。这个委员会创

业余程序员小徐的博客 2万+

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 385

特殊通信领域场景应用:基于Simulink的数字预失真(DPD)算法仿真建模示例

增益压缩:高功率输入时输出信号的增益下降。相位失真:输入信号的相位随功率变化而改变。带外干扰:非线性失真会引入额外的频谱分量,影响邻道信号。多项式模型:用多项式拟合功率放大器的非线性特性。查找表(LUT):通过离线训练生成预失真映射表。自适应算法:实时调整预失真参数以动态补偿失真。发送端:生成随机比特流并调制为射频信号。预失真模块:对输入信号进行预失真处理。功率放大器模块:模拟非线性失真。接收端:解调信号并评估误码率(BER)。

xiaoheshang_123的博客 273

OSG第三方库编译之二十一:minizip编译(Windows、Linux、Macos环境下编译)

OSG编译;第三方库;跨平台编译;minizip编译(Windows、Linux、Macos环境下编译)

LuckyHanMo的博客 2621

CNN 卷积神经网络深度解析:卷积、池化与特征提取的底层原理

卷积核(Kernel),也叫滤波器(Filter),本质上是一个可以训练的权重矩阵。1 0 -11 0 -11 0 -1这个卷积核可以对图像中的局部像素进行加权计算。不同的卷积核能够提取不同类型的特征:水平边缘特征垂直边缘特征纹理特征角点特征局部形状特征在传统图像处理中,滤波器通常由人工设计。而在 CNN 中,卷积核的权重通过训练数据和反向传播自动学习得到。这也是 CNN 能够自动提取图像特征的关键。# 第一层卷积padding=1# 第二层卷积padding=1。

2503_90237586的博客 239

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

图解常用深度学习优化器

来隐式构造 Hessian 逆的近似,从而直接估计出“谷底在哪”,而非仅仅判断“哪边最陡”。即SGD/Adam 主要看“当前坡度”,LBFGS 还会看“最近几步坡度怎么变”,像用局部地形图来规划路线。训练 Transformer 时,有些层梯度大,有些层梯度小。如果用 Adam + L2,梯度大的参数反而可能被“少衰减”,正则效果不稳定;:你要下山,但每次迈步前都要派侦察兵把整座山的每一个坡面都测量一遍,算出“绝对最陡”的方向才走一步。:还是下山,但这次你只问身边一个路人“哪边最陡”,然后就走。

技术管理两手抓,两手都要硬. 200

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

证件阅读机如何用多光谱光学成像、端到端深度学习 OCR 与 MRZ 解析、13.56MHz 射频芯片认证三层能力,把单证核验压缩到 1–2 秒

"说走就走"的外国游客多了,酒店前台的压力也就跟着一起"入境"了。复印件在红外图里会丢掉层次,屏幕翻拍件在紫外图里会暴露像素网格和屏幕的摩尔纹,PS 改过的资料页在红外和可见光的交叉比对下常常"对不上"。客人只觉得"这家酒店办入住挺快",前台只觉得"今天没被催",店长只觉得"这个月没收到整改通知"。三只眼睛和一个 AI 大脑在 1–2 秒里跑完的一整套核验,被压缩成了体验里那句轻飘飘的"好的,您的房卡"。有意思的是,真正在缓解这个压力的,不是多招几个前台,而是柜台上多了一台巴掌大的小设备——证件阅读机。

智能图像识别 346

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

基于深度学习的猫图像目标检测方法研究:YOLOv8s模型海选、多种子对比训练与Django+ONNX部署实现详解

本课题基于深度学习研究猫图像目标检测问题。数据集含1000张猫图像、1188个标注框,按固定比例划分并冻结清单;训练前在多个候选族中短训海选,确定YOLOv8s为主模型,经学习率搜索与显存标定后完成150轮训练,验证集mAP50达到0.92,并以7个随机种子的对比实验验证稳定性。最优权重导出为ONNX接入Django系统,提供图片、视频、摄像头三种识别方式,配套识别记录管理与统计大屏,形成从训练到应用的完整闭环。

WEIXIN_JSJBSZDS的博客 167

深度学习0:数学知识:正态分布2(积分,幂函数积分公式)

积分符号∫(\int∫= 把无数个极窄的小矩形面积(高度×dx(\times dx×dx))“拼接”起来。dx(dxdx= 无穷小的宽度。定积分的结果= 曲线下方的总面积(一个具体的数字)。不定积分= 寻找求导前的那个原函数。这就是“积分求面积”最朴素的意思!

tellmewhoisi的博客 209
上一篇: 毕业设计:基于Python的济南市天气数据的爬取与可视化的实现
下一篇: 大数据领域毕业设计选题灵感集合:新颖课题推荐
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值