


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于神经网络的垃圾分类图像识别方法研究
项目背景
随着城市化进程加快,垃圾处理问题日益严重,正确的垃圾分类是实现资源回收和环境保护的关键。然而,传统的人工分类方法效率低且容易出错,难以满足现代城市管理的需求。利用图像处理与深度学习技术,尤其是卷积神经网络(CNN),可以实现对垃圾图像的自动分类识别。这种方法不仅可以提高分类的准确性,还能在实时监控和智能管理方面发挥重要作用,为城市垃圾管理提供更为高效的解决方案。
数据集
数据集的制作过程主要包括三个步骤:图像采集、数据标注和数据集划分与数据增强。首先,图像采集可以通过自主拍摄和互联网采集两种方式进行。自主拍摄允许研究者在控制环境和条件下获取真实的商场垃圾图像,以确保样本的多样性和代表性;而互联网采集则可以快速获取大量已有的垃圾图像,丰富数据集的多样性。这两种方式结合,可以构建一个覆盖多种垃圾类型和背景场景的数据集。

为了确保模型训练的有效性,使用标注工具(如LabelImg或LabelMe)对收集到的垃圾图像进行准确标注。标注过程中,需要为每个图像中的垃圾对象指定对应的标签,并确保标注的一致性和准确性。这一过程关系到后续模型的学习效果,因此必须严格把控数据标注的质量,以便让模型能够更好地学习和识别不同类型的垃圾。

数据集应划分为训练集、验证集和测试集,其中训练集用于模型训练,验证集用于调参,测试集用于模型评估。同时,数据增强技术(如旋转、缩放、翻转和颜色变换等)可以在训练过程中生成更多样本,增加数据的多样性,帮助模型更好地学习和适应不同场景下的垃圾图像,降低过拟合的风险。

设计思路
卷积神经网络(CNN)是一种深度学习模型,专门设计用于处理图像数据。CNN的基本构建块包括卷积层、激活层、池化层和全连接层。卷积层通过卷积操作提取输入图像的局部特征,使用共享权重的方式显著减少参数数量,从而提高模型的计算效率。激活层引入非线性,使得网络能够学习复杂的函数映射。池化层(如最大池化)用于降低特征图的维度,减少计算量并提高模型的鲁棒性。通过多层的特征提取,CNN能够有效地实现图像分类、目标检测和图像分割等任务。

CNN的结构通常是层叠的,随着层数的增加,网络能够逐步学习从简单到复杂的特征。例如,前面的卷积层可能提取边缘和纹理特征,而后面的层则可能识别更高级的形状和模式。这种层次化的特征学习使得CNN在各种计算机视觉任务中表现出色,尤其是在大规模图像数据集上,CNN的性能得到了显著提升。由于其优越的特征提取能力,CNN已成为深度学习研究和应用中的基础模型。

YOLOv5是YOLO系列的最新版本,采用了更加先进和高效的设计理念。其主要特点是使用了CSPNet作为骨干网络,进一步提高了特征提取的效果,同时减少了计算复杂度。YOLOv5在检测精度和速度之间达到了良好的平衡,能够在多种硬件条件下实现实时检测。其结构包括骨干网络、特征融合模块和检测头,支持多种输入尺寸,使得模型在不同应用场景中具有更大的灵活性。YOLOv5还引入了数据增强和自动化超参数搜索等技术,进一步提升了模型的训练效率和准确性。通过采用最新的训练策略和优化技术,YOLOv5在多个数据集上表现出色,成为目标检测领域的热门选择。其灵活的架构设计和高效的推理速度使得YOLOv5尤其适合在边缘计算和嵌入式设备上部署,为实时应用提供了强大的支持。

数据准备,包括数据加载、预处理和分割。首先,需要将图像数据加载到内存中,并进行必要的预处理,如归一化和尺寸调整。接着,将数据集划分为训练集、验证集和测试集,以保证模型的训练和评估能够在不同的数据上进行。这一过程对于模型的性能至关重要,因为数据的质量和多样性直接影响到模型的学习效果。
from torchvision import datasets, transforms

# 数据预处理和加载
transform = transforms.Compose([
    transforms.Resize((224, 224)),  # 调整图像尺寸
    transforms.ToTensor(),  # 转换为Tensor
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))  # 归一化
])

train_dataset = datasets.ImageFolder(root='data/train', transform=transform)
train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=32, shuffle=True)
根据任务需求构建商场垃圾图像识别分类模型。可以选择基于卷积神经网络(CNN)或YOLO等结构,结合目标检测任务的特点,设计合适的模型。模型的设计应考虑到输入数据的特征和任务的复杂性,以确保模型能够有效地学习到垃圾图像的特征。在模型构建完成后,进行模型训练。使用交叉熵损失函数和优化器(如Adam或SGD)来更新模型参数。在训练过程中,通过迭代多个epoch,逐步调整模型权重,以最小化损失函数。同时,可以使用验证集监控模型的性能,防止过拟合。
import torch.nn as nn

class GarbageImageClassificationModel(nn.Module):
    def __init__(self):
        super(GarbageImageClassificationModel, self).__init__()
        self.cnn = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=3, stride=1, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),
            nn.Conv2d(32, 64, kernel_size=3, stride=1, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )
        self.fc = nn.Linear(64 * 56 * 56, num_classes)  # num_classes为垃圾类别数

    def forward(self, x):
        x = self.cnn(x)
        x = x.view(x.size(0), -1)  # 展平
        x = self.fc(x)
        return x
训练完成后,使用测试集对模型进行评估。通过计算准确率、召回率和F1值等指标,分析模型性能。评估结果可以帮助识别模型在特定类别上的不足之处,并为后续的改进提供指导。
model.eval()  # 设置模型为评估模式
total, correct = 0, 0

with torch.no_grad():
    for images, labels in test_loader:
        outputs = model(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

accuracy = correct / total
print(f'Accuracy of the model on the test set: {accuracy:.2f}')
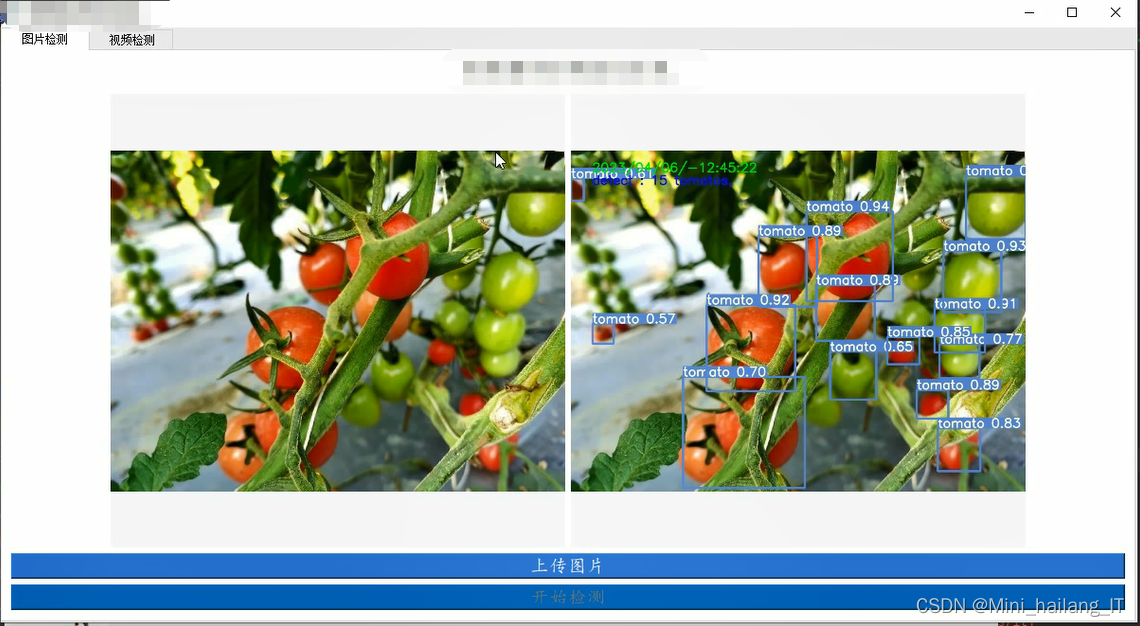
海浪学长项目示例:


 542


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


