毕业设计:基于机器学习的电子秤数字识别-带小数点

paddle ocr电子仪表数字识别(自制数据+训练和预测,含代码) 目前对于电子仪表的数字识别,调api接口可能效果存在不足。因此,通过自己收集一些电子仪表数据,构建自己的电子仪表数据集,并实现了检测与识别。在自建数据集基础上,分两步走:第一步,数字目标区域定位;第二步,数字识别。 阅读详情

目录

前言

项目背景

数据集

设计思路

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

       🎯基于机器学习的电子秤数字识别-带小数点

项目背景

       电子秤作为日常生活中常见的测量工具,其准确性和智能化程度越来越受到关注。传统的电子秤主要依赖于简单的模拟电路和固定程序进行数据处理和显示,而缺乏灵活性和智能分析能力。数字识别技术可以显著提高电子秤的读数准确性和鲁棒性。通过训练模型识别带小数点的数字,电子秤能够在不同的环境条件下(如光照变化、角度偏差等)保持稳定的识别性能。这是传统方法无法比拟的,能够有效减少用户因读数错误而导致的误操作。

数据集

       图像采集选择自主拍摄和互联网采集相结合的方式。自主拍摄可以确保图像的清晰度和准确性,适合在控制环境下拍摄不同重量和小数点位置的数码管,例如在实验室或家庭环境中进行拍摄。而互联网采集则可以通过爬虫技术获取大量的公开数据,涵盖不同品牌和类型的电子秤显示屏,以增加数据集的多样性和丰富性。

毕业设计:基于机器学习的电子秤数字识别-带小数点数码管

       使用专门的标注工具,例如LabelImg或其他图像标注软件,对采集到的图像进行逐一标注。标注的内容包括每个图像中数字的具体值以及小数点的位置,确保每个样本的准确性与完整性。为了提高标注效率和准确性,可以采用多轮审查机制,让不同的标注人员对同一图像进行审核,确保最终的标注结果高质量且一致。

       将数据集划分为训练集、验证集和测试集,以便在模型训练和评估过程中合理使用。常见的划分比例为70%用于训练,15%用于验证,15%用于测试。此外,为了增强模型的泛化能力,可以进行数据扩展,例如对图像进行旋转、缩放、平移等变换,或通过添加噪声等方式来生成新的样本,从而提高模型对不同环境和条件下数字识别的鲁棒性。

设计思路

       YOLOv5是一种高效的单阶段目标检测算法,旨在通过快速处理实现实时目标检测。其核心思想是将目标检测问题转化为回归问题,直接从输入图像中预测边界框和类别概率。YOLOv5的结构由三个主要部分组成:骨干网络、颈部网络和检测头。骨干网络(如CSPDarknet)用于提取图像特征,颈部网络(如PANet)则负责聚合不同层次的特征信息,以增强对小目标的检测能力。检测头将提取的特征映射转换为最终的检测输出。相较于传统的两阶段检测方法,YOLOv5具有更快的速度和较高的准确性,适合实时应用场景。

       卷积块注意模块(CBAM)是一种轻量级但有效的注意力机制,旨在提升卷积神经网络的特征表达能力。CBAM通过引入通道注意力和空间注意力机制,自动关注输入特征图中的重要部分。通道注意力模块首先通过全局平均池化和最大池化生成通道描述符,并通过多层感知机(MLP)生成通道权重,从而加权各个通道的特征,突出重要特征。空间注意力模块则利用特征图的平均池化和最大池化生成空间描述符,通过卷积生成空间注意力图,强调特征图中的关键空间位置。通过这两种注意力机制,CBAM显著增强了网络对目标特征的捕捉能力,提高了检测性能。

       PANet是一种先进的特征融合网络,主要用于目标检测任务,以提高对小目标的检测能力。PANet通过特征金字塔结构提取多层次特征,并利用路径聚合机制增强特征信息的传递和利用。特征金字塔网络(FPN)将高层次的语义信息与低层次的细节信息进行融合,确保多尺度目标的有效检测。路径聚合通过在不同层之间创建直接连接,使得特征能够在网络层之间流动,从而增强信息的传递。最终,PANet将处理后的特征图输入到检测头中,生成边界框和类别概率的输出,显著提升了目标检测的精度与鲁棒性。

       构建一个多种类电子秤图像数据集。该数据集应包含不同型号和环境下的电子秤图像,以确保能够覆盖各种可能的使用场景。数据集需要严格划分为训练集、验证集和测试集。通常采用70%用于训练,15%用于验证,15%用于测试的比例。通过数据增强技术(如旋转、缩放、翻转、加噪声等)扩充训练集样本,可以有效提升模型对环境变化的鲁棒性。数据增强不仅增加了样本数量,也增强了模型对不同情况的适应能力。

import os
import cv2
from torchvision import transforms

def augment_data(image_path):
    image = cv2.imread(image_path)
    # 数据增强示例:旋转和翻转
    rotated = cv2.rotate(image, cv2.ROTATE_90_CLOCKWISE)
    flipped = cv2.flip(image, 1)
    return rotated, flipped

# 示例数据集路径
dataset_path = 'path/to/dataset'
for img_file in os.listdir(dataset_path):
    augmented_images = augment_data(os.path.join(dataset_path, img_file))

       YOLOv5因其在速度和准确性上的优越表现成为理想的选择。YOLOv5通过单阶段的检测方式,能够快速地处理图像并实时输出检测结果。这对于电子秤数字识别任务尤为重要,因为实时性是使用场景中的一个关键要求。YOLOv5的骨干网络采用了CSPDarknet,这种结构特别适合高分辨率图像中的小目标检测。CSPDarknet通过分阶段提取特征,能够更好地捕捉电子秤图像中的细节信息,从而提高模型的检测精度。

# 引入YOLOv5库
from yolov5 import YOLOv5

# 加载YOLOv5模型
model = YOLOv5(model='yolov5s.pt')  # 使用YOLOv5小模型

       CSP结构应用于YOLOv5的骨干网络,分为CSP1和CSP2两个部分。CSP1主要用于提取高级语义信息,而CSP2则专注于低级细节信息。这样的设计确保了模型能够有效捕捉多层次特征,使得最终的检测结果更加准确。加入卷积块注意模块(CBAM),使模型能够集中注意力于重要特征区域,提升特征的表达能力。引入PANet作为颈部网络,进一步丰富特征信息的融合效果。PANet通过有效的特征传递机制,增强了对小目标的检测能力。

# 示例:构建CSP结构和CBAM,假设使用PyTorch框架
import torch.nn as nn

class CSPBlock(nn.Module):
    def __init__(self, in_channels, out_channels):
        super(CSPBlock, self).__init__()
        # CSP结构的实现
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1)
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1)

    def forward(self, x):
        return self.conv2(self.conv1(x))

class CBAM(nn.Module):
    def __init__(self, in_channels):
        super(CBAM, self).__init__()
        # CBAM的实现
        self.channel_attention = ChannelAttention(in_channels)
        self.spatial_attention = SpatialAttention()

    def forward(self, x):
        x = self.channel_attention(x) * x
        x = self.spatial_attention(x) * x
        return x

       采用Adam或SGD优化器能够有效提高模型的收敛性和稳定性。通过设置合理的学习率、批大小等超参数,确保模型在训练过程中的稳定性和收敛速度。通过监控验证集的表现,及时调整模型参数,如学习率衰减、早停等策略,防止过拟合现象的发生。通过这样的方式,可以确保模型在面对新数据时具有良好的泛化能力。通过排序算法实现对识别数字的按位输出,并准确添加小数点。设计合理的后处理流程,能够确保最终输出的精确性和实用性。

def post_process(outputs):
    # NMS算法实现
    boxes = outputs['boxes']
    scores = outputs['scores']
    selected_indices = non_max_suppression(boxes, scores, threshold=0.5)
    final_output = []
    for idx in selected_indices:
        box = boxes[idx]
        final_output.append(box)
    return final_output

# 进行后处理
final_results = post_process(model_outputs)

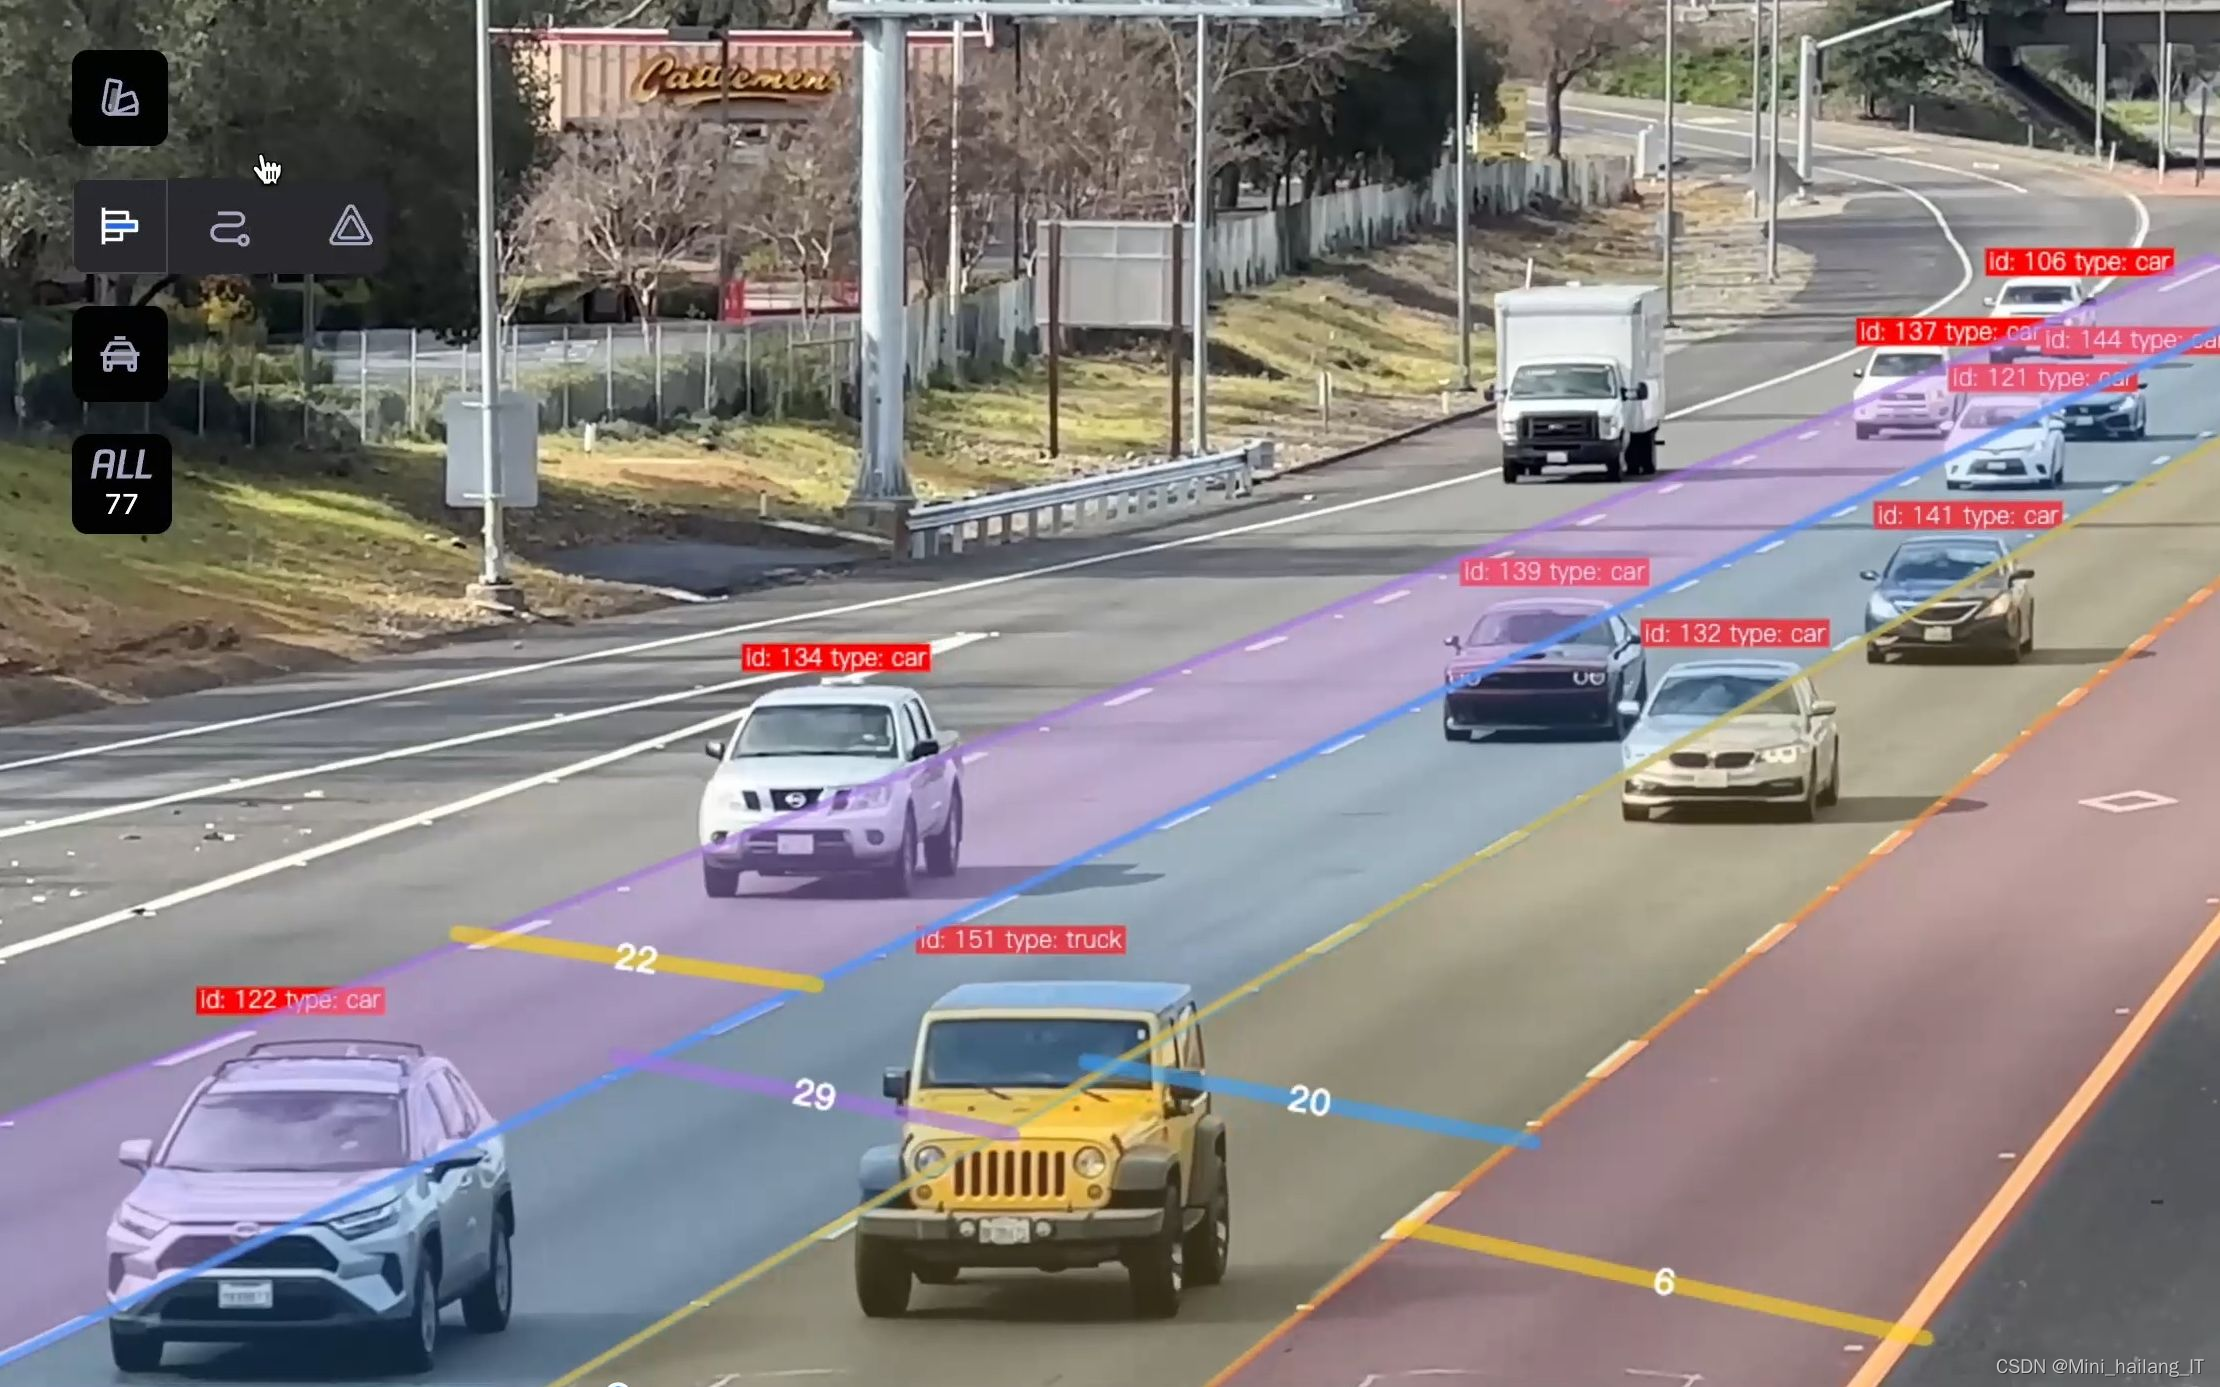
海浪学长项目示例:
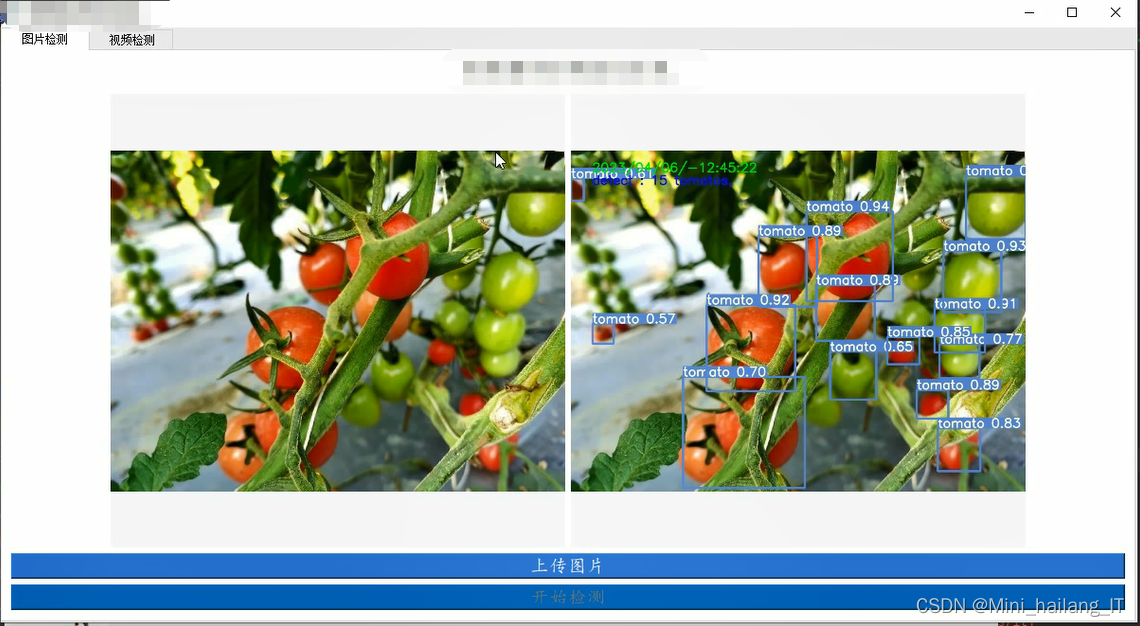
更多帮助

快速识别图片中数字小工具 快速获取图片上的数字;截图后在粘贴图片框内双击,截图显示在框内,点击识别即可识别数据并且已经复制识别出来的数据(识别快捷键:空格)。 立即下载

相关推荐

Cadence Virtuoso IC617:从零构建传输门与反相器的Schematic设计实战

本文详细介绍了使用Cadence Virtuoso IC617进行传输门与反相器Schematic设计的完整流程,包括环境准备、原理图绘制、Symbol创建、仿真验证及实用技巧。通过分步指导和实战经验分享,帮助初学者快速掌握集成电路设计基础,提升EDA工具应用能力。

weixin_29194693的博客 600

小项目:手写数字识别,可识别小数点(一)(2020.7.3)

小项目:手写数字识别,可识别小数点(一) 完整代码已经上传 GitHub(https://github.com/wwwwkd/Digit-Recognition) 代码是自己写的,有些不严谨,有更好的方法或者思路,希望大家之间相互指点相互进步。首先提供思路,然后在提供部分代码,然后在展示效果图。 功能要求:可以根据自己手工书写一个数字得带小数,拍照后,程序能将该手写数字转换成对应的数字。 经过查阅资料,将其大致分为一下三个部分: ① 数字的定位、分割、保存. ② 小数点的识别. ③ 网络的训练、测试和最佳

qq_45363979的博客 4585

【VS Code+Verilog+Vivado使用】(1)常用插件

VS Code + Verilog + Vivado联合使用说明

XDUryan的博客 5637

AI数字识别

通过神经网络可以正确预测1-9的数字 首先导入相应的包 Tensorflow后台 keras框架 import tensorflow as tf from tensorflow import keras import random import numpy as np 创建数据和标签列表 datas=[] labellist=[] 随机出五百个数据,分别放在datas和labellist中,数据就是数字1-9 for i in range(500): num = random.ran

紫一的博客 1212

西电2023秋季机器学习复习提纲

西电2023秋季机器学习复习提纲,希望对学弟学妹有帮助

weixin_62083045的博客 5658

OpenPose 论文理解

OpenPose: Real-time multi-person keypoint detection library for body, face, hands, and foot estimation paper: Realtime Multi-Person 2D Pose Estimation using Part Affinity Fields link: OpenPose paper...

JustForYou的博客 2万+

如何使用YOLOv5来——数字电表读数检测数据集数字电表读数检测图像数据集,数据集总共3300张图片,标注为voc格式 电表数据集 仪表数据集

数字电表读数检测图像数据集,数据集总共3300左右张图片,标注为voc格式 仪表数据集 电表数据集

2401_88440984的博客 1485

逆向实战:基于内存态匿名段分析的 DexProtector 检测绕过策略

本文深入探讨了针对DexProtector加固方案的Frida检测绕过策略。通过分析运行时动态加载到匿名内存段的核心检测逻辑,提出了一套基于内存态分析、定位并转储匿名可执行段,进而通过精准Hook与“等式化替换”等技术实现稳定绕过的实战方法。该方法不仅适用于DexProtector,也对采用类似内存隐藏技术的加固方案具有参考价值。

ik678901的博客 514

自己训练的可以识别小数点和负号的yolo v8n模型

手持式多用表的自动校准项目中,用opencv及OCR等方式,对于数字、小数点、负号识别效果都不太好,自己采集数据,训练了yolov8n的模型,效果很好。

f_lilin的博客 123

保姆级教程:用ROS2 Humble + Gazebo Classic 从零搭建一个能键盘控制的差分AGV模型

本文提供了一份详细的ROS2 Humble与Gazebo Classic教程,指导用户从零开始搭建一个键盘控制的差分AGV模型。内容涵盖环境配置、Xacro文件设计、Gazebo仿真集成以及键盘控制实现,特别针对常见问题提供解决方案,帮助开发者快速掌握ROS2机器人仿真技术。

weixin_30387423的博客 168

基于STM32、HAL库的CH9434总线转UART驱动程序设计

CH9434是一款USB转4串口控制芯片,可以将单个USB接口扩展为4个独立的串口(UART)。支持多种数据格式(数据位5-8,停止位1/1.5/2,奇偶校验或无校验)// 读取接收到的数据。// 重新启动接收中断。// 向所有4个串口发送数据。// UART初始化函数示例(USART1)// 其他UART初始化函数类似...// 初始化CH9434。// 初始化UART1。// 初始化UART2。// 初始化UART3。// 初始化UART4。工作电压:3.3V/5V兼容。

corlin6688的博客 990

AI辅助开发实战:基于智能体重秤毕业设计的端到端技术实现

通过这个项目,我们实践了一条完整的“端-云-智”物联网应用开发链路。更重要的是,我们探索了如何利用AI辅助开发工具,将开发者从繁琐、重复的代码编写和调试中解放出来,更聚焦于架构设计和业务逻辑创新。这个以“智能体重秤”为载体的架构,具有很强的可迁移性。试想,如果我们把HX711传感器换成心率传感器(MAX30102)、血氧传感器、或者肌电信号(EMG)采集模块,将体重趋势预测模型换成心律失常初筛模型、睡眠阶段分类模型,整个技术栈——嵌入式数据采集、滤波、无线传输、端侧AI推理、云端数据聚合——几乎可以复用。

2600_94959957的博客 202

生成EtherCAT从站XML图片信息方法

详细介绍了EtherCAT从站XML文件中图片元素的生成方法。

kevin1499的博客 2128

【YOLOv8】 用YOLOv8实现数字式工业仪表智能读数(一)

数字式工业仪表的智能读数三步走,本篇主要介绍第一步,通过数据集和Python源码进行详解数字式工业仪表表盘位置识别。

向上生长的程序媛的博客 4949

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

C# 自制OCR获取图片中的电子数字

C# 自制OCR获取图片中的电子数字0.前言1.项目背景1.思路分析1.1 找对应电子数字字体1.2 数字字体分析1.2.1 将数字【8】截图1.2.2 根据数字【8】截图像素标识辨识点1.2.2.1 上下部分的中点 O~1~、O~2~1.2.2.2 笔画中点 A ~ G1.2.2.3 外围点2. 流程图3.初见代码4.运行效果4.1运行结果*4.2 黑白二值化、柔化后的效果图*4.3 运行效率*4.3.2 如果想效率高点的话可以试下*4.3.2.1 只黑白化、二值化、柔化识别范围内的图像区域*4.3.2.

GuestingNew的博客 3930

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

基于PaddleOCR的数字显示器字符识别

基于PaddleOCR的数字显示器字符识别

m0_63642362的博客 2237

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

小项目:手写数字识别,可识别小数点(二)(20202.7.3)

小项目:手写数字识别,可识别小数点(二) 完整代码已经上传 GitHub(https://github.com/wwwwkd/Digit-Recognition)有帮助的话给个小星星!!! 代码是自己写的,有些不严谨,有更好的方法或者思路,希望大家之间相互指点相互进步。首先提供思路,然后在提供部分代码,然后在展示效果图。 功能要求:可以根据自己手工书写一个数字得带小数,拍照后,程序能将该手写数字转换成对应的数字。 经过查阅资料,将其大致分为一下三个部分: ① 数字的定位、分割、保存. ② 小数点的识别.

qq_45363979的博客 2259

【实战】OpenCV+Python项目实战--信用卡数字识别

参考网址:https://blog.youkuaiyun.com/qiao_lili/article/details/89371418 1 准备 1.1 argparse模块的使用 使用argparse模块创建一个ArgumentParser解析对象,可以理解成一个容器,将包含将命令行解析为Python数据类型所需的所有信息。 parse_args()是将之前add_argument()定义的参数进行赋值,...

weixin_41874898的博客 4990

2021年全国大学生电子设计竞赛F题中数字识别这一技术分支实践与学习笔记

文章目录Chapter 1 简介Chapter 2 制作思路Section 1 环境与成像效果及思路Section 2 制作并训练数据集Section 3 电脑环境配置Section 4 程序讲解Part 1 从摄像头获取照片Part 2 按照阈值裁剪照片Part 3 筛选照片Part 4 识别照片Chapter 3 小结Chapter 4 完整程序Section 1 main.pySection 2 camera.pySection 3 take_and_recog.pySection 4 images_

Kuang Da's Blog 5083

机器学习识别电子数字-制作字体文件

机器学习制作字体文件

zhulin40的专栏 3166

小项目:手写数字识别,可识别小数点(三)(2020.7.3)

小项目:手写数字识别,可识别小数点(三) Recognition)(https://github.com/wwwwkd/Digit-Recognition)有帮助的话给个小星星!!! 代码是自己写的,有些不严谨,有更好的方法或者思路,希望大家之间相互指点相互进步。首先提供思路,然后在提供部分代码,然后在展示效果图。 功能要求:可以根据自己手工书写一个数字得带小数,拍照后,程序能将该手写数字转换成对应的数字。 经过查阅资料,将其大致分为一下三个部分: ① 数字的定位、分割、保存. ② 小数点的识别. ③ 网

qq_45363979的博客 1674

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 226

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 399
上一篇: 毕业设计:基于神经网络的图像相似度检索方法研究
下一篇: 毕业设计:基于神经网络的生活垃圾分类图像识别方法研究
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值