


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于机器学习的带小数点数码七段管数字识别系统
项目背景
随着自动化技术的发展,数码显示器在各种设备中的应用愈发广泛,尤其是在仪器仪表、家电和交通工具等领域。数码七段管作为一种常见的数字显示器,通常用于显示整数和小数。然而,传统的识别方法在处理带小数点的数字时往往面临挑战,尤其是在复杂环境中,干扰和光照变化可能导致识别准确率下降。针对带小数点的数码七段管数字的识别技术进行深入研究,提高识别的准确性与可靠性。
数据集
图像采集可以选择自主拍摄和互联网采集相结合的方式。自主拍摄时,使用高质量的相机在不同光照条件下拍摄真实的七段管显示器,确保采集到的图像覆盖不同的数字和小数点位置。此外,可以通过网络搜索获取现成的数码七段管图像,以丰富数据集的多样性和样本数量,确保模型训练的全面性和鲁棒性。为了使得图像数据具有良好的可用性,采用专业的标注工具(如LabelImg或Labelbox)对采集到的图像进行标注。为每张图像分配正确的标签,以标识数字和小数点的具体位置。

在数据集划分时,通常将数据分为训练集、验证集和测试集,以确保模型在未见数据上的泛化能力。常见的划分比例为70%训练集、20%验证集和10%测试集。此外,为了增强数据集的多样性,可以通过图像增强技术(如旋转、缩放、平移和颜色变换等)对训练集进行扩展,从而增加样本数量,提升模型的鲁棒性。这些步骤共同构建了一个高质量的带小数点数码七段管数据集,为后续的数字识别模型训练奠定了坚实的基础。
设计思路
卷积神经网络是一种广泛应用于图像处理领域的深度学习算法。在茶叶病害检测的应用中,卷积神经网络具有显著优势。CNN能够自动从原始图像中学习特征,减少了手动特征提取的复杂性和专业要求。通过2D卷积算法,CNN考虑了图像中各像素点的相互影响,能够更有效地提取二维空间图像特征,提高目标分类的准确性。模型结构简洁,减少了全连接层,增加了卷积层,以提高特征提取的效率。同时,在训练过程中引入Dropout层以增强系统的鲁棒性。

实验中构建的卷积神经网络模型主要包括输入层、三个卷积层、三个池化层、全连接层和输出层。输入层接受预处理后的28×28单通道灰度图像,卷积层使用3×3的卷积核进行卷积操作,经过填充以保持图像尺寸不变。在第二层卷积层中,使用12个卷积核提取特征,接着通过最大池化层进行下采样,将特征图尺寸减半。随后,经过第三层和第四层的卷积和池化操作,最终连接到全连接层,形成完整的神经网络结构。

在带小数点数码七段管数字识别系统中,字符图像预处理是确保识别准确性的关键步骤。首先,通过灰度化将彩色图像转换为单通道灰度图像,简化后续处理的复杂度。接着,应用中值滤波技术有效去除图像中的噪声,平滑图像细节,同时保留边缘信息,减少对字符识别的干扰。随后,进行二值化处理,将灰度图像转换为黑白图像,使字符与背景对比更加明显,便于后续分析。最后,采用形态学处理方法(如膨胀和腐蚀)对二值图像进行进一步优化,增强字符的连通性和清晰度,以适应后续的特征提取和识别步骤。

数据收集是模型训练的第一步,涉及到收集包含带小数点的七段管数字图像的数据集。数据集应涵盖不同的数字(0-9)以及小数点的各种位置和样式。确保样本的多样性和丰富性,以提高模型的泛化能力。可以通过拍摄真实的数码七段管显示器,或利用合成图像生成器生成带小数点的数字图像。将图像转换为灰度图像,以简化处理。然后,使用中值滤波去除噪声,接着进行二值化处理以突出字符与背景的对比。最后,应用形态学处理来增强字符的连通性和清晰度。
def preprocess_image(image):
    # 灰度化
    gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

    # 中值滤波
    denoised_image = cv2.medianBlur(gray_image, 5)

    # 二值化
    _, binary_image = cv2.threshold(denoised_image, 127, 255, cv2.THRESH_BINARY_INV)

    # 形态学处理
    kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (3, 3))
    processed_image = cv2.morphologyEx(binary_image, cv2.MORPH_CLOSE, kernel)

    return processed_image

# 预处理所有图像
processed_images = [preprocess_image(img) for img in images]
特征提取阶段,首先需要从预处理后的图像中提取有效特征,以便于后续的模型训练。可以使用传统的特征提取方法(如HOG特征)或深度学习方法(如CNN)来提取特征。在本例中,我们将使用HOG特征。使用提取的特征和对应的标签来训练分类模型。可以选择支持向量机(SVM)、随机森林或卷积神经网络(CNN)等算法。因此使用SVM进行分类。
from sklearn import svm
from sklearn.model_selection import train_test_split

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(features, labels, test_size=0.2, random_state=42)

# 训练SVM模型
model = svm.SVC(kernel='linear')
model.fit(X_train, y_train)
模型评估是验证训练模型性能的关键步骤。通过对测试集进行预测,计算模型的准确率、召回率等指标,以评估其在未见样本上的表现。同时,可以使用混淆矩阵可视化分类结果。
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt

# 进行预测
y_pred = model.predict(X_test)

# 计算准确率
accuracy = accuracy_score(y_test, y_pred)
print(f'Model Accuracy: {accuracy * 100:.2f}%')

# 显示分类报告
print(classification_report(y_test, y_pred))

# 混淆矩阵
conf_matrix = confusion_matrix(y_test, y_pred)
sns.heatmap(conf_matrix, annot=True, fmt='d', cmap='Blues')
plt.xlabel('Predicted')
plt.ylabel('True')
plt.show()
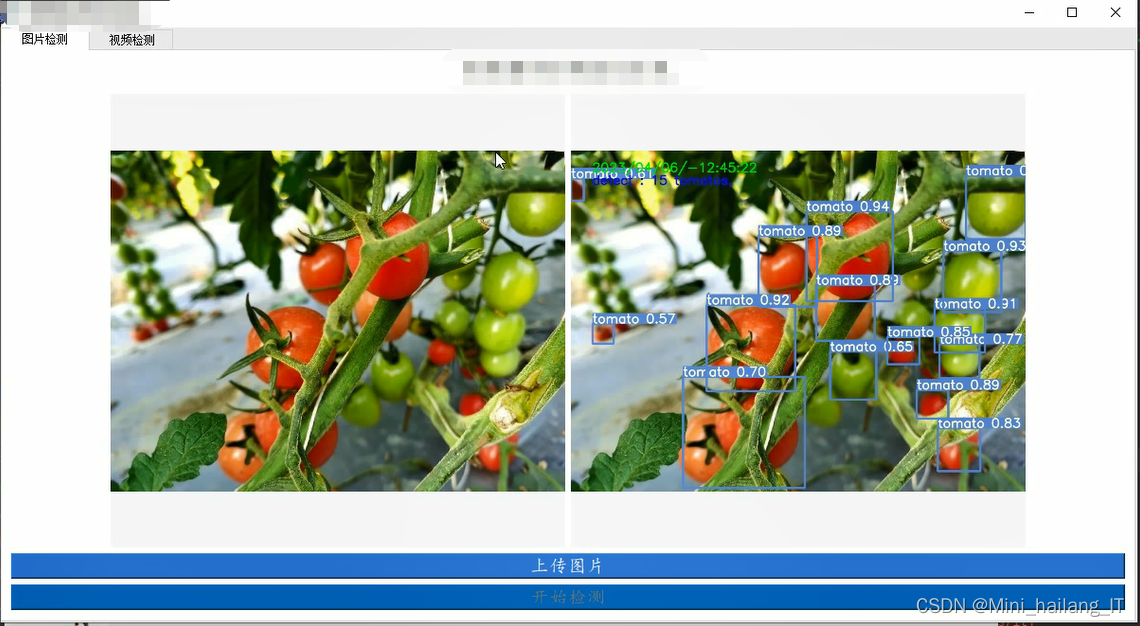
海浪学长项目示例:


 1360


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


