


目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
大家好,这里是海浪学长计算机毕设专题,本次分享的课题是
🎯基于卷积神经网络的交通信号灯检测和识别
项目背景
交通信号灯在道路交通管理中起着至关重要的作用,对驾驶员和行人的安全具有重要意义。传统的交通信号灯检测和识别方法通常采用基于规则和特征工程的方式,面临识别准确性和鲁棒性的挑战。基于卷积神经网络的图像识别技术在目标检测和分类领域表现出色,能够有效识别复杂场景中的交通信号灯。
数据集
为了确保数据的多样性和代表性,采用自主拍摄和互联网采集相结合的方式。在自主拍摄时,可以选择不同的城市、乡村和高速公路等多种场景,使用高分辨率相机拍摄各种类型的交通标志,如限速标志、停车标志、指示标志等。为了进一步丰富数据集,还可以通过互联网收集公共数据集和开源项目中的交通标志图像,确保涵盖不同的交通标志设计和各种环境条件下的图像。
数据标注可以使用专业的标注工具,比如LabelImg,对每张图像中的交通标志进行准确的框选和标注。标注时需确保每个标志的类型、位置和边界框的准确性,生成包含图像路径和对应标志类别的标注文件。这一过程需要严格遵循统一的标注标准,以确保数据集的质量和一致性,从而为后续的模型训练奠定基础。

数据集的划分与扩展是提高模型泛化能力的关键步骤。通常将数据集按照70%、15%、15%的比例划分为训练集、验证集和测试集,以便于后续模型的训练与评估。此外,为了提升数据集的丰富性和多样性,可以应用数据扩展技术,如随机旋转、翻转、缩放、亮度调整和添加噪声等。通过这些扩展技术,可以生成更多的变换样本,从而增强模型的鲁棒性,降低过拟合的风险,使得交通标志识别系统在实际应用中表现更加出色。
设计思路
卷积神经网络是一种深度学习模型,专门设计用于处理具有网格结构的数据,特别是图像。CNN的核心思想是通过卷积层、激活层和池化层等多种结构,自动提取和学习输入数据中的特征。在卷积层中,卷积核(或滤波器)通过与输入图像进行局部感知操作,提取出边缘、角点、纹理等低级特征,进而逐层构建出越来越抽象的特征表示。激活函数(如ReLU)则引入非线性因素,使得网络能够学习到更复杂的模式。池化层的作用是对特征图进行下采样,减少特征的维度,同时保留重要信息,这不仅减轻了计算负担,还增强了模型的鲁棒性。在训练过程中,CNN通过反向传播算法不断调整网络中的权重,以最小化预测结果与真实标签之间的损失。

深度残差网络引入了“残差学习”的概念,通过使用跳跃连接来缓解深层网络训练中的梯度消失问题。在传统的深度神经网络中,随着层数的增加,网络的性能往往会出现饱和或下降的现象,这使得训练非常深的网络变得困难。ResNet通过引入残差块,将输入信号与通过几个卷积层处理后的输出相加,从而形成一个“学习残差”的目标,而不是直接学习输入与输出之间的映射。残差块的结构相对简单,通常包括两个或三个卷积层和一个跳跃连接。跳跃连接使得信息能够直接从前面的层流向后面的层,从而有效地减轻了信息衰减的影响。这种结构不仅提高了深层网络的训练效率,还使得网络能够实现更深的层级结构,ResNet的架构可以扩展到数百甚至上千层而不出现性能下降的问题。此外,ResNet的设计还引入了批量归一化和激活函数,进一步增强了模型的表现。

ResNet-18是深度残差网络(ResNet)系列中的一个重要模型,具有18层深度,旨在通过引入残差学习的概念来解决深层网络训练中的难题。该模型主要由卷积层、批量归一化层、ReLU激活函数和残差块构成。每个残差块由两个卷积层和一个直接连接的跳跃连接组成,使得网络能够有效地学习到输入与输出之间的残差,而不仅仅是原始的映射。ResNet-18通过这一结构,能够在不显著增加模型复杂度的情况下,训练出更深的网络,有效提高图像分类和特征提取的性能。在交通信号灯识别模型的设计中,我们可以通过调整网络的通道数来优化模型的计算开销,从而实现轻量化的交通信号灯识别模型。通过这种设计,ResNet-18能够在不显著增加模型复杂度的情况下,训练出更深的网络,从而提升图像分类和特征提取的性能。

import torch
import torch.nn as nn
import torchvision.models as models

# 加载ResNet-18模型并调整通道数
class ModifiedResNet18(nn.Module):
    def __init__(self, num_classes):
        super(ModifiedResNet18, self).__init__()
        self.model = models.resnet18(pretrained=True)
        self.model.fc = nn.Linear(self.model.fc.in_features, num_classes)  # 修改最后一层

    def forward(self, x):
        return self.model(x)

# 实例化模型
model = ModifiedResNet18(num_classes=3)  # 假设有3种交通信号灯类型
由于采集的交通信号灯数据中不同类型数据的数量和占比差异过大,因此需要对训练数据集进行重新采样,以使各种类型的样本数量均衡。这可以通过随机删除数量多的样本中的部分数据,从而降低这类数据的占比;同时,对于数量少的样本,则进行复制以增加其占比。然而,处理过程中可能会因为随机删除操作丢失部分重要数据,也可能因复制操作导致过拟合。因此,在进行均衡处理时,需要谨慎选择样本,以确保模型训练的有效性和稳定性。
import numpy as np
import random

def balance_dataset(data, labels):
    unique_labels, counts = np.unique(labels, return_counts=True)
    min_count = min(counts)

    balanced_data = []
    balanced_labels = []

    for label in unique_labels:
        label_data = data[labels == label]
        if len(label_data) > min_count:
            # 随机删除部分样本
            label_data = random.sample(list(label_data), min_count)
        else:
            # 复制样本以平衡
            label_data = np.tile(label_data, (min_count // len(label_data) + 1, 1))[:min_count]

        balanced_data.extend(label_data)
        balanced_labels.extend([label] * min_count)

    return np.array(balanced_data), np.array(balanced_labels)

# 假设data和labels是原始数据和标签
balanced_data, balanced_labels = balance_dataset(data, labels)
在网络训练前,需要将不同大小的交通信号灯候选区域提取出的不同分辨率的数据进行统一。在交通信号灯识别实验中,我们将图像分辨率统一调整为16×16。由于数据集中交通信号灯区域的形状通常为长方形,因此首先将图像长边的长度调整为16,并进行等比例缩放,以不改变信号灯的形状。对于短边,使用黑色背景进行填充以统一为16,最终得到分辨率为16×16的交通信号灯数据。这种预处理步骤确保了输入图像的尺寸一致性,有助于提高模型的训练效率和准确性。
import cv2

def preprocess_image(image):
    # 计算长边和短边
    h, w = image.shape[:2]
    if h > w:
        scale = 16 / h
    else:
        scale = 16 / w

    # 等比例缩放
    new_h, new_w = int(h * scale), int(w * scale)
    resized_image = cv2.resize(image, (new_w, new_h))

# 假设image是待处理的图像
processed_image = preprocess_image(image)
在模型训练完成后,使用评价指标来评估网络模型的性能。首先是精确度(Precision)和召回率(Recall),这两个指标是衡量模型在分类任务中表现的重要标准。精确度表示被模型正确分类的样本占所有预测为正类样本的比例,而召回率则表示被模型正确分类的样本占所有真实正类样本的比例。通过计算精确度和召回率,可以更全面地了解模型在交通信号灯检测与识别任务中的表现,进而进行模型的优化和调整。
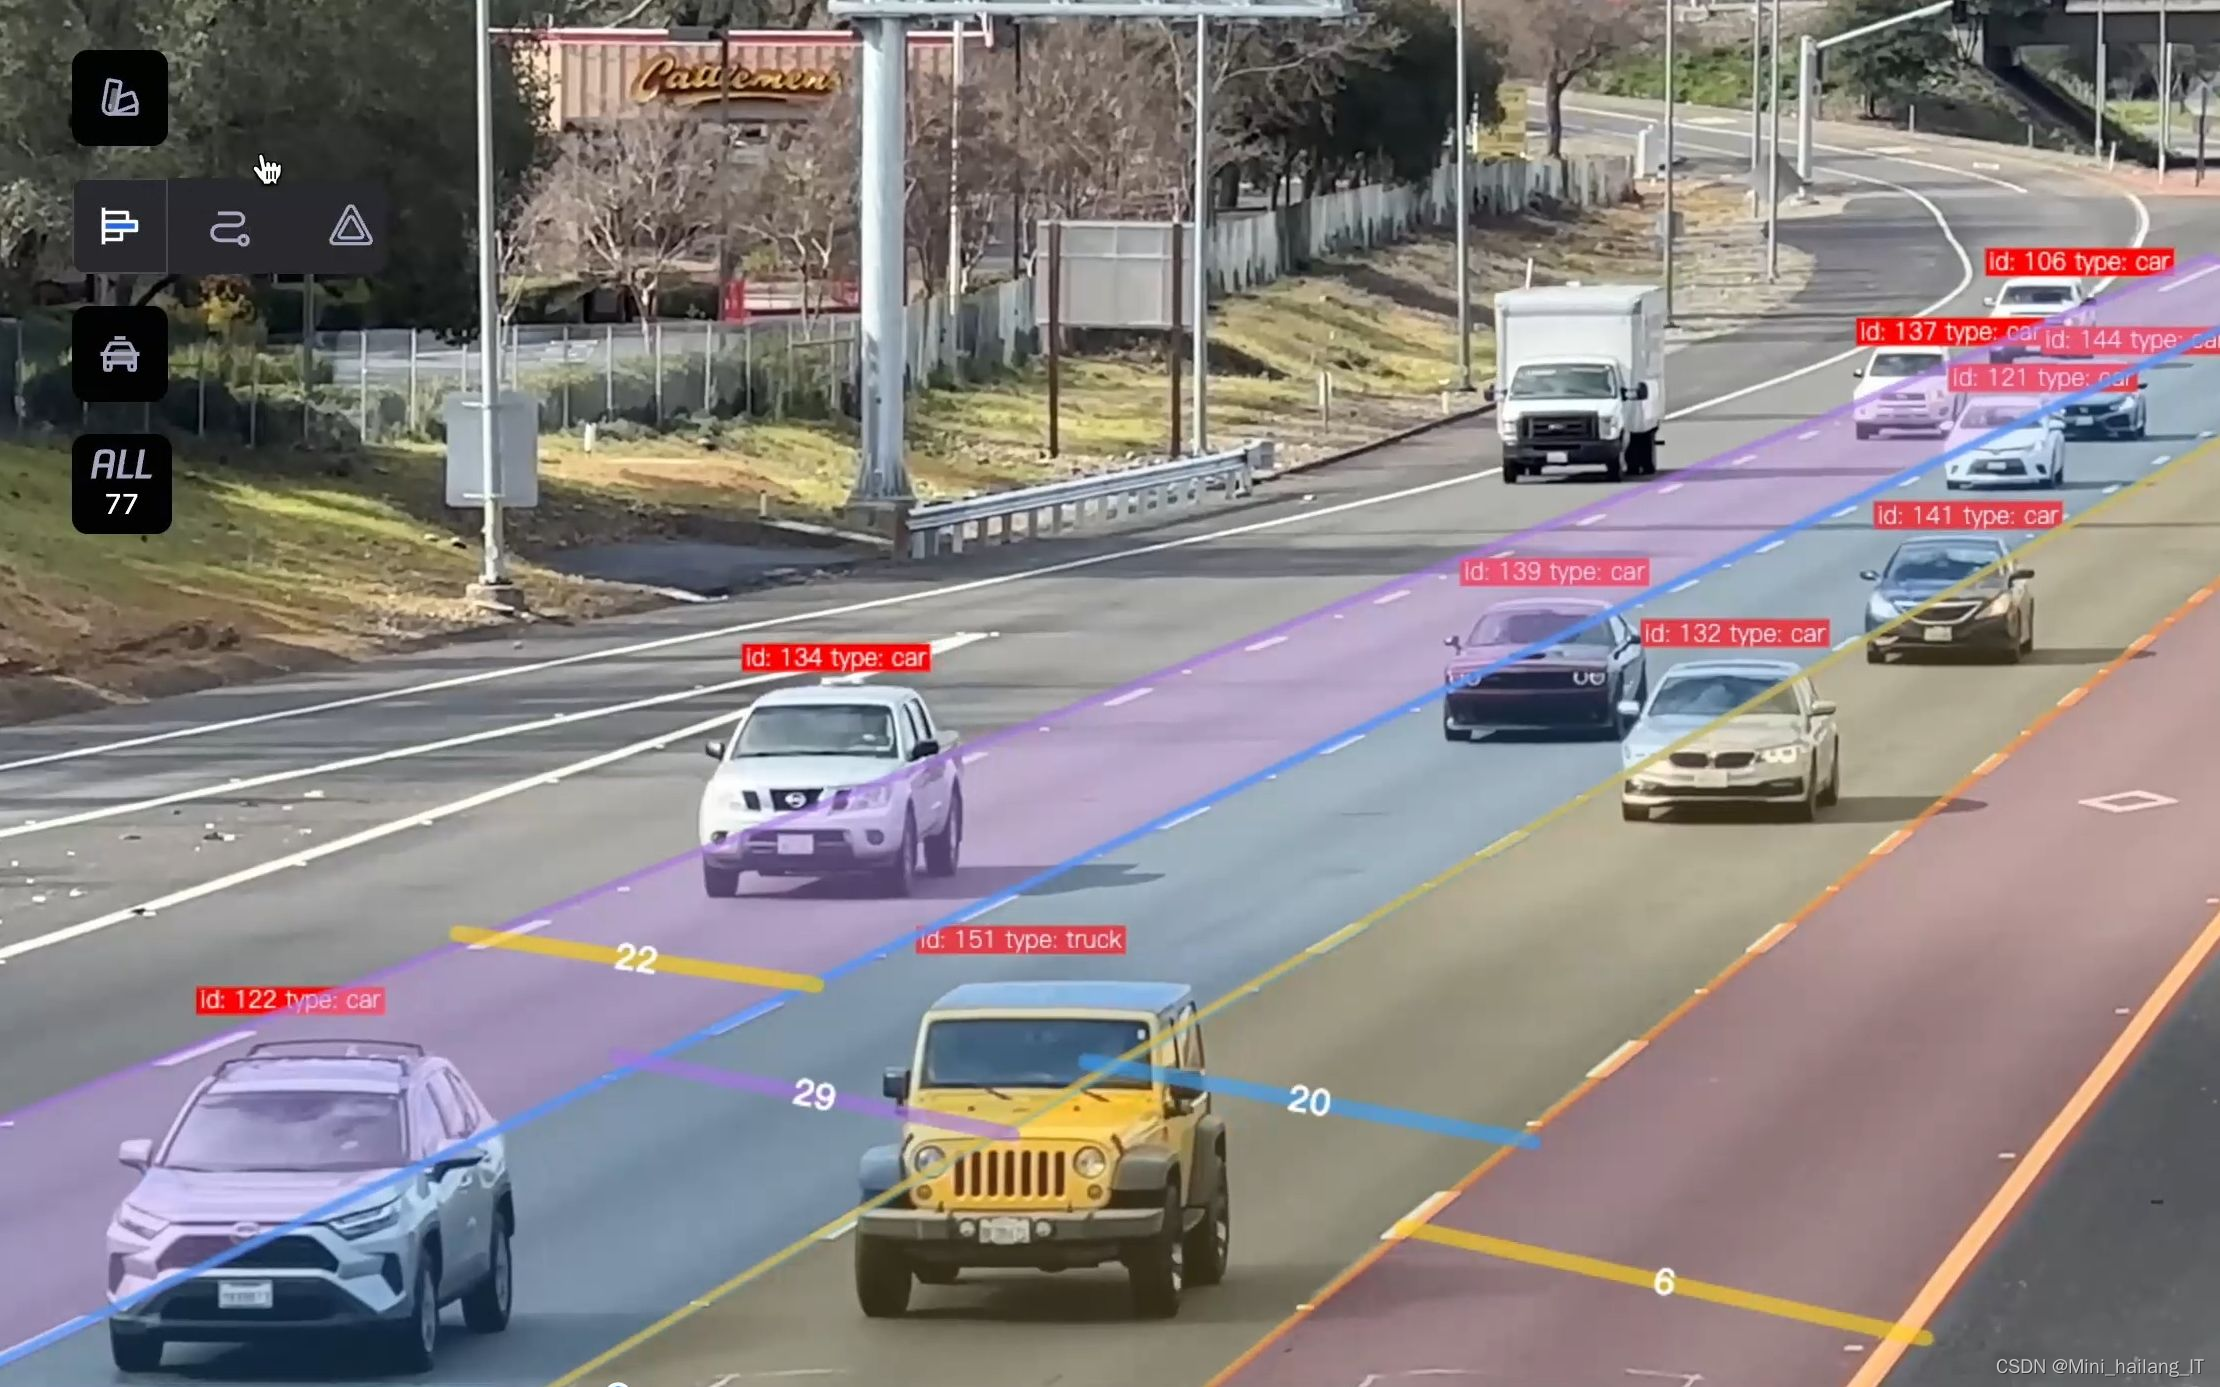
海浪学长项目示例:


 8762


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


