毕业设计:基于python的图书馆大数据可视化分析系统

数据分析案例-图书书籍数据可视化分析 数据集来源于Kaggle,这个数据集包含了从wonderbk.com(一个受欢迎的在线书店)抓取的信息。该数据集包含103,063本书的详细信息,其中包含标题、作者、描述、类别、出版商、起始价格和出版日期等关键属性。Title:书的标题。Authors:本书的作者。Description :对本书的简要描述。Category:书籍所属的类别或流派。Publisher:负责本书的出版社。Price:书籍的初始价格。Publish Date:出版年份。 阅读详情

目录

前言

项目背景

设计思路

数据集

模型训练

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

       🎯基于python的图书馆大数据可视化分析系统

项目背景

       随着数字化时代的到来,图书馆作为知识传播和文化交流的重要场所,积累了大量的图书馆数据。这些数据包含了图书馆的藏书信息、借阅记录、读者行为等丰富的信息,对于图书馆管理和服务的优化具有重要价值。然而,如何有效地分析和利用这些大数据成为一个挑战。基于Python的图书馆可视化分析系统旨在结合深度学习和计算机视觉技术,开发一种创新的系统,能够从图书馆大数据中提取有用的信息,并通过可视化方式呈现,帮助图书馆管理者和研究人员更好地理解和利用图书馆数据。

设计思路

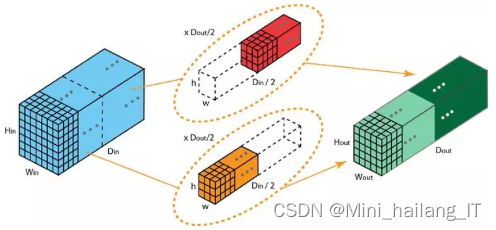
       CNN在处理图像数据方面表现出色。图书馆大数据可视化分析系统中,图书馆可能会收集大量的图书封面、用户照片等图像数据。CNN能够有效地提取图像中的特征,如边缘、纹理和形状等,从而实现图像分类、目标检测和图像生成等任务。CNN利用卷积层和池化层进行特征学习和降维,能够自动从原始数据中学习到具有层次结构的特征表示。这使得CNN在处理图书馆大数据可视化分析系统中的复杂数据时具有优势,可以自动提取数据中的有用特征,减少了手工特征工程的需求。此外,CNN中的权重共享机制可以大幅减少网络参数的数量,提高模型的训练效率和泛化能力。
毕业设计:基于python的图书馆大数据可视化分析系统

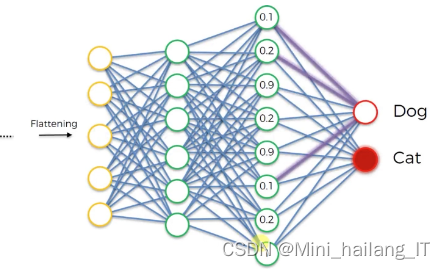
       卷积神经网络的原理是基于神经网络的一种深度学习模型。它通过多层卷积层、激活函数、池化层和全连接层等组件构成。卷积层用于提取输入数据中的局部特征,通过卷积操作和权重共享实现对不同位置的特征的提取和识别。激活函数引入非线性变换,增加模型的表达能力。池化层用于降低特征图的维度,减少参数数量和计算量。全连接层将卷积层的输出映射到最终的分类或回归结果。整个网络通过反向传播算法进行训练,优化网络参数以最小化损失函数。
毕业设计:基于python的图书馆大数据可视化分析系统

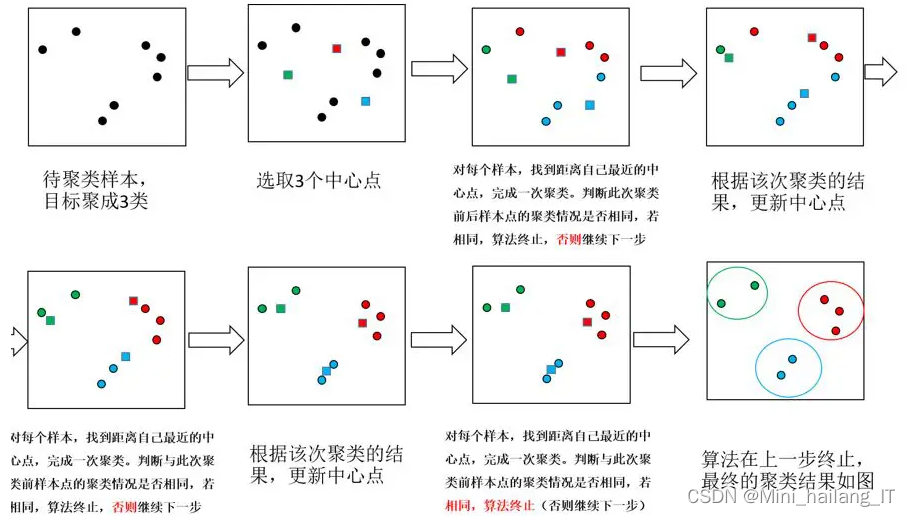
       k-means算法是一种常用的无监督学习算法,可用于将数据集划分为具有相似特征的不同群集。在图书馆大数据可视化分析系统中,可以使用k-means算法对图书馆的数据进行聚类,例如对图书进行自动分类、对用户进行分群等。这有助于发现数据的内在模式和关联性,为图书馆提供更深入的洞察。k-means算法具有较高的计算效率。它使用迭代优化的方法,通过不断更新聚类中心来最小化数据点与质心之间的距离。由于简单的计算操作,k-means算法的执行速度相对较快,适用于处理大规模的图书馆数据。

k-means聚类算法的原理如下:

  • 初始化:随机选择k个质心作为初始聚类中心。
  • 分配数据点:将每个数据点分配到与其最近的质心所属的聚类中。
  • 更新聚类中心:计算每个聚类中的数据点的均值,更新聚类中心。
  • 重复步骤2和步骤3,直到聚类中心不再变化或达到预定的迭代次数。
  • 得到最终的聚类结果。

毕业设计:基于python的图书馆大数据可视化分析系统

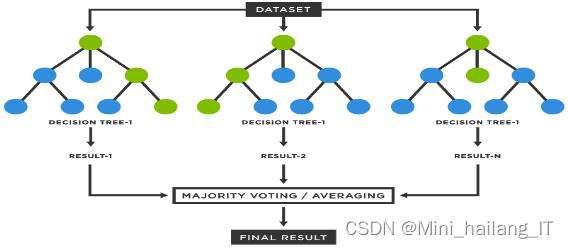
       随机森林算法是一种集成学习方法,通过构建多个决策树并进行集成来进行预测和分类任务。它的优势包括高准确度、可处理高维数据、可解释性和抗过拟合能力。随机森林的基本原理是通过随机选择样本和特征子集构建决策树,并通过投票或取平均值集成多个决策树的预测结果。在Python中,可以使用机器学习库来实现随机森林算法。
毕业设计:基于python的图书馆大数据可视化分析系统

数据集

       由于网络上缺乏现有的合适的图书馆大数据集,为了进行基于Python的系统研究,我决定自己制作数据集。我首先收集了多个图书馆的数据,包括图书藏书信息、借阅记录、读者注册信息等。然后,我使用Python编程语言和相关的数据处理工具对数据进行清洗和整理,以确保数据的准确性和一致性。通过自制的数据集,我能够获取真实的图书馆数据,并为系统的训练和评估提供可靠的基础。我相信这个自制的数据集将为基于Python的图书馆大数据可视化分析系统的研究提供有力的支持,并为图书馆数据分析和服务优化领域的发展做出积极贡献。

模型训练

       基于Python的图书馆大数据可视化分析系统的设计思路可以包括以下几个方面:

  • 数据采集与预处理:首先,需要确定需要分析的图书馆数据的来源,例如图书借阅记录、图书信息、用户数据等。使用Python编写数据采集程序或脚本,从不同的数据源中获取数据,并进行预处理,如数据清洗、去重、格式转换等,以确保数据的准确性和一致性。
  • 数据存储与管理:设计数据库或使用适当的数据存储机制,例如关系型数据库(如MySQL、PostgreSQL)或非关系型数据库(如MongoDB),以存储和管理采集到的图书馆数据。Python提供了多个数据库操作库和框架,可用于与数据库交互。
  • 可视化分析模块选择:根据具体的分析需求,选择合适的可视化分析库或框架。Python中有许多强大的可视化工具,如Matplotlib、Seaborn、Plotly等,它们提供了各种图表类型和交互性,可用于展示图书馆数据的不同方面,如数据分布、趋势、关联性等。
  • 可视化分析功能开发:基于选定的可视化分析库,使用Python编写相应的功能模块,实现对图书馆数据的可视化分析。这可能包括生成各种图表、图形、地图等可视化元素,以及开发交互式界面或仪表板,以便用户能够灵活地探索和分析数据。

 相关代码示例:

import matplotlib.pyplot as plt
import pandas as pd

# 导入图书馆数据
data = pd.read_csv('library_data.csv')

book_counts = data['book_count']
categories = data['category']

plt.figure(figsize=(10, 6))
plt.bar(categories, book_counts)
plt.xlabel('图书分类')
plt.ylabel('图书借阅量')
plt.title('图书借阅量统计')
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()

更多帮助

使用Python爬取在线图书馆的图书馆藏和阅读记录 通过使用Python编写爬虫程序,我们可以从在线图书馆上获取图书馆藏和阅读记录,帮助人们更好地管理和利用图书馆资源。本文简要介绍了爬虫程序的准备工作、网页解析和数据提取、数据的保存和处理的关键步骤,并提供了一个示例代码。在实际应用中,我们需要注意遵守在线图书馆的使用规则和爬虫道德准则,确保合法、合规地进行爬取操作。以上仅为概述,实际应用的过程中可能需要根据具体需求进行适当的调整和改进。 阅读详情

相关推荐

用Python爬虫探索网络图书馆:发现丰富的电子书籍与阅读推荐!

同时,网络图书馆还能根据读者的阅读历史和喜好,提供个性化的阅读推荐,帮助读者发现更多感兴趣的图书和文献。首先,我们介绍了网络图书馆的价值和电子书籍与阅读推荐的无限可能性,分析了数字时代读者的阅读选择。网络图书馆是一扇通向知识世界的大门,通过Python爬虫技术,我们可以轻松地从网络图书馆中获取丰富的电子书籍和阅读推荐。电子书籍和阅读推荐数据已经成功保存到文件中,但是这些数据目前还是原始的HTML格式,我们需要进一步解析和处理,将其转换为结构化的信息,以便后续分析和展示。列表中,供后续的数据处理和分析使用。

2201_76125393的博客 247

python+vue 图书馆读者行为分析系统-书友会

根据图书馆读者行为分析系统的功能需求,进行系统设计。 前台功能:用户进入系统可以实现首页、图书信息、热门图书、书友会、在线论坛、图书资讯、个人中心、后台管理等进行操作; 后台主要是管理员,管理员功能包括个人中心、用户管理、图书信息管理、图书分类管理、热门图书管理、书友会管理、报名信息管理、行为分析管理、在线论坛、系统管理等;

QQ511008285的博客 886

图书馆大数据可视化分析系统的Python实践项目

在当今信息技术高速发展的时代,Python作为一种高级编程语言,其在Web开发和大数据处理领域中的应用愈发重要。其简洁的语法、强大的库支持和跨平台兼容性使其成为许多开发者的首选。本章将概述Python在Web开发与大数据处理中的角色,并分析其应用优势和面临的挑战。Python数据库适配器,也称为数据库驱动,允许Python代码与数据库进行通信。最常用的适配器包括sqlite3, 和psycopg2。# SQLite连接示例# MySQL连接示例# PostgreSQL连接示例。

weixin_35762258的博客 1074

图书数据可视化——实验报告

图书数据可视化是将清洗后的图书数据以可视化的方式展示出来,以帮助用户更好地理解和解释数据。通过可视化,可以直观地呈现图书的各种属性和关系,例如图书的类别分布、销售趋势、作家之间的关联等。常用的图书数据可视化方法包括柱状图、折线图、散点图、热力图等。

weixin_75079701的博客 1755

Python+Bootstrap图书馆大数据可视化分析系统

数据可视化是将原始数据转化为可理解洞察的关键技术,其核心在于数据处理、交互呈现与业务闭环。Python凭借Pandas、SQLAlchemy和Flask构成轻量高效的数据分析栈,Bootstrap则提供响应式前端保障多端一致体验。相比Excel和PPT等静态工具,该技术组合支持实时下钻、动态筛选与自动化报告,显著提升图书馆借阅行为分析、读者画像构建及馆藏效能评估的工程落地能力。本文聚焦高校与中小型公共图书馆场景,详解如何用Python清洗异构日志、用SQLite实现免运维存储、用Chart.js+Boots

weixin_30607125的博客 73

Python图书馆大数据可视化分析系统:从数据管道到交互大屏实战

数据可视化是让海量业务数据产生决策价值的核心手段,而真正的可视化系统不是一块静态大屏,而是一条贯通数据存储、聚合计算与前端展示的管道。在图书管理场景中,借阅流水不断增长,管理者需要从数十万条记录中洞察借阅趋势、读者偏好与馆藏优化方向。Python作为数据分析与后端开发的通用语言,配合MySQL存储、pandas预聚合以及ECharts交互图表,能够构建出高复用性的可视化分析系统。本文从业务数据建模、Flask接口开发、缓存策略到前端联调与部署,完整呈现一套图书馆大数据可视化分析系统的工程实践路径,为图书管理

weixin_35755434的博客 194

基于Python+Django的毕业设计-图书馆大数据可视化分析系统项目实战(附源码+论文)

本文介绍了基于Python Django框架开发的图书馆大数据可视化分析系统。系统实现了用户注册登录、图书搜索浏览、借阅归还、信息管理等功能模块,采用MySQL数据库存储数据,通过Navicat进行管理。文章详细展示了系统设计架构、数据库表结构、核心功能界面截图以及部分爬虫代码,并提供了演示视频链接。该系统支持匿名访问基础功能,注册用户可解锁完整服务,管理员具备后台管理权限,具备良好的用户体验和实用性。

岛上程序猿 704

人工智能-项目实践-信息检索-图书馆借阅数据可视化,图书检索与推荐系统

图书馆借阅数据可视化,图书检索与推荐系统

计算机毕业设计-基于Python+Django的图书馆大数据可视化分析项目开发实战(附源码+论文)

本文介绍了一个基于Python Django框架开发的图书馆大数据可视化分析系统。系统支持用户注册登录、图书搜索查询、借阅归还、个人信息管理等功能,管理员可进行图书和用户信息维护。开发环境包括Python 3.7.7、MySQL 5.7和Navicat等工具。系统设计包含用户、图书、管理员等实体,采用模块化设计实现前后端交互。核心功能包括匿名浏览、图书列表展示、智能推荐和借还书流程,并提供了部分爬虫代码示例用于数据采集。系统界面简洁美观,操作便捷,满足图书馆基本管理需求。

2301_76953549的博客 1371

【openEuler容器镜像部署指南】

【代码】【List集合排序 】

weixin_43878094的博客 1111

常见的电容有哪些

电容在电路板中非常常见,类别纷繁复杂,本文化繁为简,主要介绍下常见电容。

qq_40170041的博客 768

2026 数据可视化分析方向毕业设计选题推荐 大数据

数据可视化分析方向毕业设计选题合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

毕设帮助,疑难解答,欢迎打扰! 1万+

【STM32】基于STM32F103C8T6实现步进电机精准调速控制

本文详细介绍了如何使用STM32F103C8T6微控制器实现步进电机的精准调速控制。通过利用其内置定时器生成PWM脉冲,替代低效的延时方法,并结合TB6600驱动器进行硬件连接,可实现平滑、高效的电机速度控制。文章提供了基于HAL库的代码实战,包括速度与方向设置函数,并探讨了加减速规划等高级应用,帮助开发者彻底掌握步进电机驱动技术。

weixin_29169899的博客 486

计算机毕业设计推荐-基于python的电子图书馆数据可视化分析

在数字化时代,信息的获取和处理变得尤为重要。电子图书馆作为知识信息的重要载体,其数据量庞大且更新迅速,涵盖了丰富的文献资源和用户行为数据。随着大数据技术的发展,如何有效管理和分析这些数据,以提供更加精准的信息服务,成为了一个迫切需要解决的问题。基于Python的电子图书馆数据可视化分析,正是在这样的背景下应运而生。Python作为一种强大的编程语言,以其丰富的数据处理库和灵活的可视化工具,为电子图书馆的数据管理提供了新的可能性。

m0_73272351的博客 1696

hi3516cv610在PQStream上实现拉出图像,windows和板端操作记录

PQStream拉出图像

weixin_51838255的博客 728

WebVTT中的文本轨道(Text Tracks,TT)到底是什么鬼?

WebVTT,全称是The Web Video Text Tracks Format,意思是网络视频文本轨道格式。那么到底什么是文本轨道(Text Tracks)呢?这篇文章希望一探究竟。

码农1479的博客 1985

基于python的图书馆大数据可视化分析系统(源码+文档)

本文介绍了一个基于Python+Django框架开发的图书馆大数据可视化分析系统。系统分为前台和后台两大模块,前台包含首页、图书列表、数据可视化等功能,后台则提供权限认证、图书管理、借阅管理等管理功能。系统实现了用户注册登录验证、图书查询等核心功能,采用MySQL数据库存储数据,使用Navicat进行数据库管理。系统设计注重用户体验和数据安全,包含输入验证、数据比对等机制。该项目是完整的毕业设计解决方案,作者提供多种技术栈的成品项目源码和技术支持。

luoluoal的博客 458

TMS320F28377D的sys/bios双核工程配置详解——从零搭建到RAM优化

本文详细解析了TMS320F28377D双核系统在sys/bios环境下的工程配置与RAM优化策略。从开发环境搭建、SYS/BIOS工程创建到双核CMD文件配置,提供了实战技巧和常见问题解决方案,帮助开发者高效实现电力电子控制系统中的双核协作与性能优化。

weixin_28292761的博客 600

基于大数据的高校图书馆书籍借阅数据分析系统毕业设计项目源码

本课题聚焦基于大数据的高校图书馆书籍借阅数据分析系统设计与实现,旨在解决图书馆资源利用率低、读者需求洞察不足、馆藏优化滞后等问题。系统涵盖数据采集、清洗处理、多维分析、可视化展示等核心模块,采用 Hadoop 存储海量借阅数据,Spark 进行分布式计算,通过前后端分离架构构建图书馆智能分析平台。 管理员可实时监控图书借阅量、热门馆藏、读者借阅行为等数据,获取图书资源利用效率评估;学科馆员分析各专业书籍借阅趋势、文献引用关联,辅助馆藏资源建设;读者通过个性化推荐看板获取同类书籍推荐、借阅高峰提示,优化借阅体

专注于大学生项目实战开发,讲解,毕业答疑辅导,java就业辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。全网粉丝10w+,平台优质创作者。 839

笔试题-2023-芯动-数字IC设计【纯净题目版】

笔试题-2023-芯动-数字IC设计【纯净题目版】

w0shishabi的博客 6396

Onnxruntime之YOLOP部署过程记录

魔改YoloP部署过程记录

如果想成为中心,那么就到中心去吧。 1924

毕业设计之图书馆大数据可视化分析系统(python完整源码+说明文档+演示视频)

本系统和其他的图书馆系统的功能差不多。主要的就是包括登录注册这些基本操作。还有用户可以在系统上输入关键词来搜索图书信息。用户也可以通过这些信息来进行一个有效的管理和查询。

haoyanlikeJava的博客 613

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

大数据技术的高校电子图书馆数据统计可视化分析系统

通过Python来满足相关诉求;系统主要采用前后端分离、MVC模式进行开发,前端使用HTML、Css、Javascript、Vue等技术完成开发,后端使用Mysql数据库等技术开发,项目完成后,将系统给用户体验,定期对用户体验进行回访调查,不断的优化修改系统的相关功能。开发语言:Python框架:flask和djangoPython版本:python3.7+开发软件:PyCharm/vscode数据库:mysql数据库工具:Navicat。

专注分享bishe530的博客 1106

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

2025-2026 数据科学与大数据专业毕业设计选题合集 (26届)

数据科学与大数据专业毕业设计选题合集涵盖了管理系统、小程序、深度学习、机器学习、算法、人工智能、大数据、网络安全、嵌入式、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、通信工程专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感

2301_79555157的博客 2万+

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【Python大数据+AI毕设实战】阅读情况数据可视化分析系统、计算机毕业设计、包括数据爬取、Spark、数据分析、数据可视化、Hadoop、实战教学

【Python大数据+AI毕设实战】阅读情况数据可视化分析系统、计算机毕业设计、包括数据爬取、Spark、数据分析、数据可视化、Hadoop、实战教学

biyesheji88的博客 921

数据科学与大数据技术专业毕业设计选题合集:创新研究 技术应用

数据科学与大数据技术专业毕业设计选题合集合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

毕设帮助,疑难解答,欢迎打扰! 2121
上一篇: 毕业设计:基于python的旅游评论情感分析系统
下一篇: 毕业设计:基于python的校园舆情信息检测系统
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值