毕业设计:基于深度学习的药品外包装识别系统

药品名称识别系统:OCR与模板匹配的工程实践 文字识别(OCR)是计算机视觉中应用最广泛的技术之一,但在复杂场景下,仅靠通用OCR模型往往无法直接输出干净的结构化信息。以药品包装识别为例,图片中常混有厂牌、规格、批准文号等大量噪声,识别结果还需经过图像预处理、文字检测、文本清洗与匹配等多重处理才能真正落地。本文将围绕药品名称识别这一具体场景,介绍如何将OCR与模板匹配相结合:通过图像预处理提升输入质量,利用PaddleOCR完成文字检测与识别,再借助药品名词库、剂型后缀规则和相似度算法对识别结果进行后处理优化。该方案既降低了纯深度学习模型的标注成本,又 阅读详情

目录

前言

项目背景

设计思路

数据集

模型训练

更多帮助


前言

    📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。

        🚀对毕设有任何疑问都可以问学长哦!

       大家好,这里是海浪学长计算机毕设专题,本次分享的课题是

       🎯基于深度学习的药品外包装识别系统

项目背景

       在药品行业中,准确识别和追踪药品外包装的重要性不言而喻。当前,许多药品识别任务仍然依赖于人工操作,这种方式存在着效率低下、易出错和成本高昂的问题。因此,开发一种基于深度学习的药品外包装识别系统具有重要的背景和意义。这样的系统可以提高药品识别的速度和准确性,为药品监管、溯源追踪以及库存管理等方面带来巨大的便利和效益。

设计思路

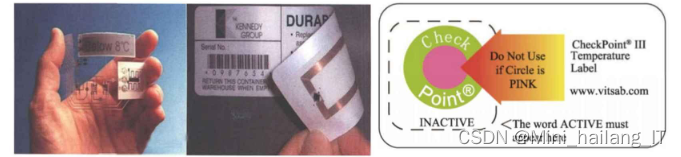
       RFID射频识别技术是一种常用的智能包装技术,通过在药品包装盒外贴上RFID标签,并通过传感器读取标签内容。该技术可以实现药品追踪、监测和信息可视化,并记录药品在冷链运输和流通过程中的实时状态和位置。相比传统标签,RFID智能标签具有扫描速度快、扫描数量多、体积小、信息安全度高和数据存储量大等优点。在扫描过程中,RFID智能标签可以同时识别多个物品,识别距离可达20米,在药品冷链运输中保证高效率获取信息。这项技术对于监测药品出库和库存情况,并进行可视化设计,对药品供应系统有很大帮助。
毕业设计:基于深度学习的药品外包装识别系统

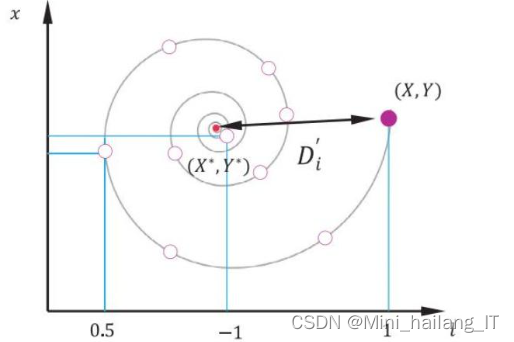
       鲸鱼算法是一种基于优化的算法,灵感来源于鲸鱼群体的行为。通过改进鲸鱼算法,可以提高其搜索能力和收敛速度,以更好地适应图像分割的需求。二维最大熵图像分割是一种基于信息论的图像分割方法,它通过最大化图像分割后的互信息来实现自适应的分割结果。在药品包装识别系统中,可以利用二维最大熵图像分割来提取药品包装的关键信息和特征,例如药品标签、批号和有效期等。将改进的鲸鱼算法与二维最大熵图像分割相结合,可以实现更准确和高效的药品包装识别。通过优化算法的搜索能力和收敛速度,可以提高分割结果的质量和准确性。
毕业设计:基于深度学习的药品外包装识别系统

       LeNet-5是一种早期经典的神经网络,由计算机科学家Yann LeCun提出,并采用了反向传播算法进行有监督的训练。因其在机器学习等领域的杰出贡献,被誉为卷积神经网络之父。LeNet-5网络在字符识别方面取得了极好的效果,推动了该领域的发展。相对于多层感知机,卷积神经网络的参数数量大大减少,因此在特征提取方面得到广泛应用。LeNet-5的设计和训练方法为后续的卷积神经网络奠定了基础,其结构和思想影响了许多后续的神经网络模型,成为了深度学习和计算机视觉领域的重要里程碑。

毕业设计:基于深度学习的药品外包装识别系统

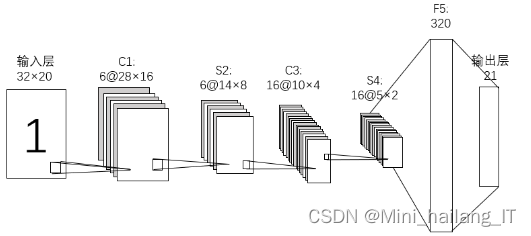
       对传统的LeNet算法进行改进的内容如下:首先,在输入层将32×32像素大小归一化为32×20,以适应国药准字字符的8:5高宽比,避免字符拉伸变形情况,并减少网络训练参数以提高运算速率。其次,使用ReLU激活函数替代传统LeNet-5网络中的sigmoid函数,以避免易饱和和梯度消失等问题。然后,取消C5层,并将F5层与S4层和输出层进行全连接,减少训练参数并提高运算效率,避免过拟合现象。在优化器方面,采用Adam优化器进行权重更新,相较于随机梯度下降法具有更高的效率和较好的收敛效果。为了防止过拟合,引入Dropout,在F5全连接层中设置失活概率为0.5。最后,在输出层将识别类别分为21类,包括0-9的阿拉伯数字、大写字母"BFHJSTZ"以及"国药准字"4个汉字。这些改进措施可以提高LeNet算法的性能和准确性,适应国药准字识别任务的特点,并减少运算负载,提升计算效率。
毕业设计:基于深度学习的药品外包装识别系统

数据集

       由于网络上没有现有的合适的数据集,我们决定自己进行药品外包装的拍摄和数据集制作。我们前往药品生产企业和药店等地,收集了大量不同类型的药品外包装照片。在拍摄过程中,我们特别关注药品外包装的各种细节和特征,以保证数据集的全面性和准确性。通过现场拍摄,我们能够捕捉到真实的药品外包装样本,包括各种不同药品的不同规格和包装形式。通过这种自制的数据集,我们相信能够为药品外包装识别系统的研究提供更准确、可靠的数据,为该领域的发展做出积极贡献。
       为了增加数据集的样本多样性和泛化能力,我们采用了数据扩充技术对收集到的药品外包装图像进行处理。我们使用了旋转、缩放、平移和镜像等操作,并添加了不同的噪声和变换,以增加数据集的样本多样性。通过数据扩充,我们能够训练出更鲁棒的模型,提高系统对于不同药品外包装的识别准确性,进一步提升系统的实用性和可靠性。数据扩充是本课题中一个重要的步骤,它能帮助我们克服数据集规模有限的问题,提高模型的泛化能力,从而更好地适应各种不同的药品外包装样本。

ef data_augmentation(image):
    augmented_images = []

    # 旋转操作
    rotated_image = cv2.rotate(image, cv2.cv2.ROTATE_90_CLOCKWISE)
    augmented_images.append(rotated_image)

    # 镜像操作
    flipped_image = cv2.flip(image, 1)
    augmented_images.append(flipped_image)

    # 缩放操作
    scaled_image = cv2.resize(image, None, fx=0.5, fy=0.5)
    augmented_images.append(scaled_image)

    # 平移操作
    rows, cols, _ = image.shape
    translation_matrix = np.float32([[1, 0, 50], [0, 1, 50]])
    translated_image = cv2.warpAffine(image, translation_matrix, (cols, rows))
    augmented_images.append(translated_image)

    return augmented_images

# 载入原始图像
image = cv2.imread('original_image.jpg')

# 进行数据扩充
augmented_images = data_augmentation(image)

# 保存扩充后的图像
for i, augmented_image in enumerate(augmented_images):
    cv2.imwrite(f'augmented_image_{i}.jpg', augmented_image)

模型训练

       本实验基于Windows 10 64位平台,使用i5-9300H处理器、8GB DDR3内存和NVIDIA GTX1650独立显卡。开发环境采用Visual Studio 2017,并结合计算机视觉库OpenCV进行实验。这样的配置可以提供足够的计算资源和性能来处理图像和进行计算机视觉相关的任务。通过结合OpenCV库,可以实现图像处理、特征提取、图像识别和目标检测等功能。

       为了对国药准字字符进行识别,使用改进的LeNet-5网络需要进行训练。首先,使用Xavier初始化函数对模型的权值进行初始化,以确保网络的初始参数合理。然后,将训练数据标号并输入到模型中,每次随机选择64张图像进行批量训练。使用Adam算法代替传统的随机梯度下降法来更新网络的权重和偏置参数,以提高训练效果。最后,统计识别率来评估模型的性能。

import numpy as np
import tensorflow as tf
from tensorflow.keras import layers

# 定义LeNet-5网络结构
model = tf.keras.Sequential([
    layers.Conv2D(6, kernel_size=5, activation='relu', input_shape=(32, 20, 1)),
    layers.MaxPooling2D(pool_size=2),
    layers.Conv2D(16, kernel_size=5, activation='relu'),
    layers.MaxPooling2D(pool_size=2),
    layers.Flatten(),
    layers.Dense(120, activation='relu'),
    layers.Dense(84, activation='relu'),
    layers.Dense(21, activation='softmax')
])

# 初始化模型权重
model.build((None, 32, 20, 1))
model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=0.0001),
              loss=tf.keras.losses.SparseCategoricalCrossentropy(),
              metrics=['accuracy'])

# 加载训练数据和标签
train_images = ...  # 训练图像数据
train_labels = ...  # 训练标签

# 进行模型训练
model.fit(train_images, train_labels, batch_size=64, epochs=10)

# 加载测试数据和标签
test_images = ...  # 测试图像数据
test_labels = ...  # 测试标签

# 评估模型性能
test_loss, test_accuracy = model.evaluate(test_images, test_labels)
print('Test Loss:', test_loss)
print('Test Accuracy:', test_accuracy)

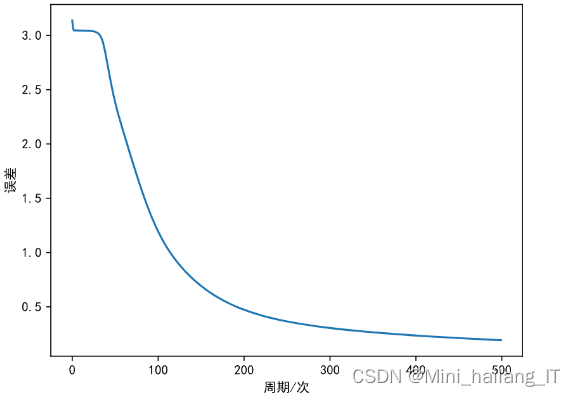
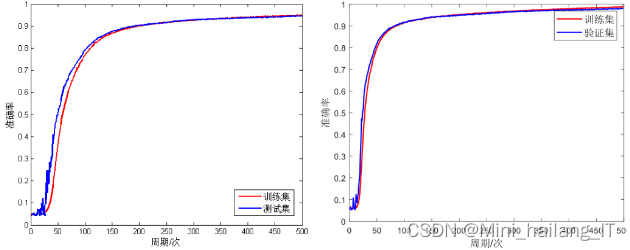
       改进的LeNet-5网络的误差曲线图是用来展示训练过程中模型的误差变化情况。它可以帮助我们了解模型在训练过程中的收敛情况和性能表现。通过观察误差曲线图,我们可以判断模型是否收敛,是否存在过拟合或欠拟合等问题。误差曲线图还可以用来选择适当的训练轮数或提前停止训练,以获得性能最佳的模型。因此,误差曲线图在训练过程中起着重要的指导和评估作用。
 改进的LeNet-5相比传统的LeNet-5在识别准确率和识别时间上都有所提高,并且由于针对性的改进,前向传播的时间也缩短了。
model = tf.keras.Sequential([
    layers.Conv2D(32, kernel_size=3, activation='relu', input_shape=(64, 64, 3)),
    layers.MaxPooling2D(pool_size=2),
    layers.Conv2D(64, kernel_size=3, activation='relu'),
    layers.MaxPooling2D(pool_size=2),
    layers.Flatten(),
    layers.Dense(128, activation='relu'),
    layers.Dense(num_classes, activation='softmax')
])

# 编译模型
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

gyz_labels = tf.keras.utils.to_categorical(gyz_labels, num_classes)

model.fit(gyz_images, gyz_labels, batch_size=32, epochs=10)

更多帮助

Python药品名称识别系统:模板匹配方法的实现 Python是一种解释型编程语言,由Guido van Rossum于1989年底发起。它的设计哲学强调代码的可读性和简洁的语法(尤其是使用空格缩进来定义代码块,而不是使用大括号或关键字)。Python支持多种编程范式,包括面向对象、命令式、函数式和过程式编程。要开始编写Python代码,首先需要在计算机上安装Python解释器。您可以从Python官网下载最新版本的Python,并按照安装指南完成安装。安装完成后,可以在命令行中输入来验证安装是否成功。 阅读详情

相关推荐

药品名称检测数据集.zip

计算机视觉数据集,想预览内容可私信作者

基于深度学习的药盒药名识别技术研究

实际检测实验表明,本文的CRAFT文本检测与Tesseract-OCR相结合的药名识别方法,药名定位准确率达98.02%,药名文字识别准确率,本文的Tesseract-OCR方法与百度OCR相比,识别准确率较低,主要原因有以下两点:(1)百度OCR是百度公司较为成熟的人工智能技术,经过了大量训练以及语义模型纠错,能够适应不同的场景,并且针对图像倾斜、翻转等情况进行优化,鲁棒性强,可支持2万多大字库,其文字识别准确率高。拉普拉斯算子是一种微分算子,其应用可增强图像中灰度突变的区域,减弱灰度的缓慢变化区域。

zsw119的博客 4578

YOLO包装盒纸板破损检测数据集

1、YOLO包装盒纸板破损检测数据集,1000多张使用lableimg标注软件,标注好的真实场景的高质量图片数据,图片格式为jpg,标签有两种,分别为VOC格式和yolo格式,分别保存在两个文件夹中,可以直接用于YOL包装盒纸板破损识别,数据场景丰富,类别名为break_board 2、数据集和检测结果参考:https://blog.youkuaiyun.com/zhiqingAI/article/details/124230743

毕业设计选题- 基于深度学习的药品外包装质量检测系统 人工智能 机器视觉 YOLO

毕业设计-基于深度学习的药品包装质量检测系统的毕业设计项目。药品包装质量对于保障药品的安全和有效性至关重要。然而,传统的药品包装质量检测方法存在繁琐、耗时和主观性的问题。本设计项目采用了深度学习技术,特别是卷积神经网络(CNN),开发了一种高效准确的药品包装质量检测系统。该系统能够自动识别和检测药品包装上的缺陷,如破损、污渍和标签错误等。通过大量的训练数据和精细调整的模型,我们证明了该系统在药品包装质量检测方面的出色性能和准确性。介绍了算法的设计原理、数据集的构建和训练过程,以及系统的实现和性能评估结果。

Hai_Lang_IT的博客 1602

yolo算法-香烟包装盒数据集-1878张图像带标签.zip

yolo系列算法目标检测数据集,包含标签,可以直接训练模型和验证测试,数据集已经划分好,包含数据集配置文件data.yaml,适用yolov5,yolov8,yolov9,yolov7,yolov10,yolo11算法; 包含两种标签格:yolo格式(txt文件)和voc格式(xml文件),分别保存在两个文件夹中; yolo格式:<class> <x_center> <y_center> <width> <height>, 其中: <class> 是目标的类别索引(从0开始)。 <x_center> 和 <y_center> 是目标框中心点的x和y坐标,这些坐标是相对于图像宽度和高度的比例值,范围在0到1之间。 <width> 和 <height> 是目标框的宽度和高度,也是相对于图像宽度和高度的比例值

药品包装盒数据集1032张VOC+YOLO格式.rar

数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件) 图片数量(jpg文件个数):1032 标注数量(xml文件个数):1032 标注数量(txt文件个数):1032 标注类别数:1 标注类别名称:["box"] 每个类别标注的框数: box 框数 = 1468 总框数:1468 使用标注工具:labelImg 标注规则:对类别进行画矩形框 重要说明:暂无 特别声明:本数据集不对训练的模型或者权重文件精度作任何保证,数据集只提供准确且合理标注

AI应用说 | 百度专家&行业大咖畅谈AI技术与落地应用

这是 AI 应用的时代。 工厂:高速照相机拍下传送带上的零部件,机器识别出有缺陷的零件剔除; 农场:拍摄虫体照片,识别害虫名称和数量并能防控虫害,减少农药使用量,发展绿色农业; 小区:智能垃圾箱可以基于图像识别准确判断垃圾种类,提升分类准确度; 医院:智能无人药柜避免冗长队伍,人员密集接触。而且可以 24H 不间断取药 …… AI “小场景”的业务提升为企业带来了“大能量” 但企业管理者在业务智能化升级过程中还是会面临更多切实难题,比如: 企业管理者说: 我们是传统制造业,没有 AI 方面

百度大脑 752

鹿数据集VOC格式+yolo格式504张1类别.7z

数据集格式:Pascal VOC格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件) 图片数量(jpg文件个数):504 标注数量(xml文件个数):504 标注数量(txt文件个数):504 标注类别数:1 标注类别名称:["Deer"] 每个类别标注的框数: Deer 框数 = 664 总框数=664 使用标注工具:labelImg 标注规则:对类别进行画矩形框 重要说明:暂无

药品包装盒数据集1032张VOC+YOLO格式

今天,介绍药品包装盒数据集1032张VOC+YOLO格式: 数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件) 图片数量(jpg文件个数):1032 标注数量(xml文件个数):1032 标注数量(txt文件个数):1032 标注类别数:1 标注类别名称:["box"] 每个类别标注的框数: box 框数 = 1468 总框数:1468 使用标注工具:labelImg

2402_83140078的博客 1315

盒子标注数据集盒子标注数据集

盒子标注数据集

【人工智能】人工智能基础概念、流派、发展史

人工智能初衷就是让计算机能够像人类一样具有自我思考、自我学习、自我决策的能力。依据百度百科上对人工智能定义:人工智能是研究、开发用于模拟、扩展和延伸人的智能的理论、方法、技术及应用系统的一门新的技术学科。人工智能是研究使计算机来模拟人的某些思维过程和智能行为的学科,主要包括计算机实现智能的原理、制造类似于人脑智能的计算机,使计算机能实现更高层次的应用。

WEL测试 1882

【毕业设计】python基于模板的药品名称识别系统

本文介绍了一个基于Python的药品名称识别系统,采用MySQL和HTML技术实现。系统具有简洁的左右结构界面,包含用户登录注册、文本提取、文本管理和用户管理四大功能模块。用户可通过输入文本提取药品名称,并能查看、查询和删除提取记录。管理员可重置用户密码并审核信息修改。系统提供严格的表单验证和数据管理功能,适用于药品名称识别需求。文章末尾提供源码获取方式和技术支持服务。

陈辰学长的博客 310

经典脉冲激光测距原理&雷达方程

脉冲激光测距机的工作过程如下:首先用瞄准光学系统瞄准目标,然后接通激光电源,储能电容器充电,产生触发闪光灯的触发脉冲,闪光灯点亮,激光器受激辐射,从输出反射镜发射出一个前沿陡峭、峰值功率高的激光脉冲,通过发射光学系统压缩光束发射角后射向目标。通过计算激光发射功率经介质传输的衰减,目标表面截获和反射的光功率,到达接收视场的光功率,以及接收光学系统接收到的光功率,就可以得到到达光电探测器的光功率,即接收功率。⑤光東路程上的折射率变化;),测量光脉冲到达目标并由目标返回到接收机的时间,由此计算出目标的距离。

weixin_46153372的博客 2524

【计算机毕设】python基于模板的药品名称识别系统

本文介绍了一个基于Python的药品名称识别系统,采用MySQL数据库和HTML前端技术。系统实现了用户注册登录、文本提取药品名称、历史记录管理等功能模块。用户输入医疗文本后,系统可自动识别药品名称(如阿莫西林),并支持记录查询和删除。管理员可进行用户管理和密码重置等操作。系统界面简洁直观,采用左右布局设计,适合医疗文本处理和药品信息识别需求。该项目可作为毕业设计或学习参考,提供源码和数据库支持。

hong161688的博客 598

2024年【MCM/ICM】美国大学生数学建模竞赛优秀论文(免费下载)

美国大学生数学建模竞赛(MCM/ICM)由美国数学及其应用联合会主办,是最高的国际性数学建模竞赛,也是世界范围内最具影响力的数学建模竞赛,一般也指数学建模竞赛。赛题内容涉及经济、管理、环境、资源、生态、医学、安全、等众多领域。竞赛要求三人(本科生和研究生均可参加)为一组,在四天时间内,就指定的问题完成从建立模型、求解、验证到论文撰写的全部工作,体现了参赛选手研究问题、解决方案的能力及团队合作精神。为现今各类数学建模竞赛之鼻祖。

weixin_43608857的博客 1841

Cesium中级开发教程之二十二:视锥体

教程示例网站:https://thomaz529.github.io。

883

【毕设】python基于模板的药品名称识别系统

本文介绍了一个基于Python的药品名称识别系统,采用MySQL数据库和HTML前端技术实现。系统主要功能包括:1)用户注册登录模块,提供严格的表单验证;2)文本提取模块,可从输入文本中识别药品名称;3)文本管理模块,支持历史记录的查询和删除;4)用户管理模块,管理员可进行密码重置和信息审核。系统界面采用左右布局设计,左侧为导航菜单,右侧展示具体内容。该系统可应用于医疗文本处理领域,帮助用户快速识别药品信息。作者提供相关技术支持,包括毕设选题咨询和开发指导。

m0_70066267的博客 92

最大面积验证码通用解法

最大面积验证码、面积验证通用解法

九月镇灵将的博客 1044

基于机器学习的药品种类识别系统的设计与实现(源码+万字报告+讲解)(支持资料、图片参考_相关定制)

摘 要现代医学西医在给人类的健康带来福音的同时,亦给人类生活带来了无尽的恐惧和灾难。由于药品具有“治病又致病”的特点,药品安全一直是世界各国关注的焦点。2020年的整个上半年,一场没有硝烟的战争席卷了整个国家,很多人感染了新冠病毒,甚至很多人因此失去了生命。本次疫情对整个国家的影响非常大,很多人因此失去了工作,很多企业都面临倒闭,当然与工作相比,人们的生命健康更为重要。在整个春节期间,我相信很多人都是一起床就去关注当前的疫情数据,关注自己所在的地区有没有新增的确诊病例或疑似病例。除此之外,在整个疫情期间,

d1_189的博客 460

[RK-Linux] 移植Linux-5.10到RK3399(十)| 配置AP6256模组使能WIFI、BT功能

[RK-Linux] 移植Linux-5.10到RK3399(十)| 配置AP6256模组使能WIFI、BT功能

Systemcall名屋 2979

PyCharm 2024最新版图文安装教程(python环境搭建+PyCharm安装+运行测试+汉化+背景图设置)

PyCharm 2024新版图文安装教程(python环境搭建+PyCharm安装+运行测试+汉化+背景图设置)

Code_流苏:在代码中寻诗意,在实践中觅真知 4万+

2024年基于计算机视觉,深度学习卷积神经网络计算机毕业设计选题

随着深度学习、机器学习和神经网络技术的快速发展,计算机视觉领域的应用变得越来越广泛和有趣。本毕业设计旨在探索这一领域的前沿技术,将深度学习模型、神经网络架构、OpenCV图像处理工具,以及卷积神经网络(CNN)的强大能力结合起来,以解决实际图像处理问题。本设计将为计算机视觉的学术研究和工程应用做出贡献,并为毕业生提供一个深入研究和实践的机会。

1万+

[Dify实战] [安全合规] 用 Dify 优化安全巡检:从经验驱动到标准闭环-带绑定资源

摘要:企业信息系统安全管理中,安全合规巡检面临标准不统一、整改难追踪等痛点。本文提出基于Dify工具的智能化解决方案,通过自动化工作流实现标准检查清单生成、风险等级标注、整改建议输出及审计记录归档。方案采用结构化Prompt模板和Markdown输出格式,涵盖账号权限、数据安全等核心维度,并提供证据收集建议和闭环管理机制,帮助组织从人工经验驱动转向数据流程驱动的合规管理。配套可导入Dify的工作流文件将随后发布。

技术小甜甜:传播可落地技术,帮助个人和企业降低解决真实场景问题的成本 272

2024-2025 机器学习毕设选题 深度学习毕业设计题目汇总

机器学习深度学习 选题合集涵盖了管理系统、小程序、深度学习、机器学习、算法、人工智能、大数据、网络安全、嵌入式、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、通信工程专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。不论是对于对深度学习技术感兴趣的同学,还是希望探索机器学习、算法或人工智能的领域的同学,本合集都能为您提供丰富的选题资源和灵感。

Hai_Lang_IT的博客 5731

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

机器视觉类优秀毕业设计选题题目汇总:热门选题

机器视觉类的毕业设计选题涵盖多个研究方向,包括图像分类、目标检测、人脸识别、工业视觉检测、图像分割、视觉SLAM和运动分析等。合集涵盖了深度学习、机器学习、算法、人工智能、大数据、信息安全、推荐系统、目标检测等多个热门领域。对于计算机专业、软件工程专业、人工智能专业、大数据专业的毕业生而言,选择一个合适的毕业设计选题至关重要。在这个毕业设计选题合集中,我们精心收集了各种有趣且具有挑战性的选题,旨在帮助学生们在毕业设计中展现他们的技术实力和创新能力。

Hai_Lang_IT的博客 2736

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

深度学习毕业设计选题题目 机器学习毕设选题全合集

深度学习毕业设计选题 计算机毕业设计选题-机器学习毕业设计 选题题目大全合集。毕设选题汇集了各种关于深度学习和机器学习的选题题目,涵盖了目标检测、图像处理、语音识别、自然语言处理等多个领域。无论你是对深度学习还是机器学习感兴趣,无论你是想从事学术研究还是应用开发,本合集中的选题都能帮助你找到适合自己的毕业设计项目。为你的毕业设计选题提供灵感和指导。无论是新手还是有经验的同学,都将为你提供有价值的信息和资源帮助你开展一项成功的深度学习或机器学习毕业设计。

2301_79555157的博客 1875

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 2024 数据科学与大数据毕设选题汇总 开题指导
下一篇: 毕业设计:基于人脸识别的酒店客房入侵检测系统
Mini_hailang_IT
博客等级 码龄9年 5936粉丝 640原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值