从GPT-1到GPT-3:生成式预训练语言模型的演进之路

从GPT-1到GPT-3:大语言模型进化史与Few-Shot Learning的崛起 本文系统梳理了从GPT-1到GPT-3的大语言模型进化历程,重点剖析了Few-Shot Learning能力的涌现机制。GPT-1确立了“预训练-微调”范式,GPT-2探索了零样本学习,而GPT-3凭借1750亿参数和高质量数据,实现了少次学习的质变,展示了模型规模与数据工程如何催生上下文学习等高级能力。 阅读详情

GPT-1

GPT-1(Generative Pre-Training)是 OpenAI 于 2018 年提出的首个 GPT 系列模型,其论文题为《Improving Language Understanding by Generative Pre-Training》。GPT-1 的核心思想是通过无监督预训练 + 有监督微调的两阶段范式,提升模型在多种自然语言理解(NLU)任务上的表现。

第一阶段:无监督预训练(Unsupervised Pre-training)

在大规模无标注文本语料上训练一个语言模型,目标是学习通用的语言表示。

架构

  • 基于 Transformer 的解码器(Decoder-only),共 12 层,隐藏层维度为768,12个注意力头。
  • 每层包含:
    • 掩码多头自注意力机制(Masked Multi-head Self-Attention)
    • 位置前馈网络(Position-wise Feed-Forward Network)
    • 残差连接(Residual Connection)和层归一化(Layer Normalization)
  • 使用 字节对编码(Byte Pair Encoding, BPE) 作为子词分词器,词表大小为 40,000。

注意:GPT-1 的 Transformer 解码器去掉了掩码多头注意力中的“编码器-解码器注意力”部分,仅保留带掩码的自注意力,确保预测第 t t t 个词时只能看到前 t − 1 t-1 t−1 个词。

预训练目标函数:标准语言模型(自回归)

GPT-1 的预训练目标是最大化给定前文条件下下一个词的对数似然,即标准的自回归语言建模目标。

设无标注语料为序列 U = { u 1 , u 2 , … , u n } U = \{u_1, u_2, \dots, u_n\} U={u1​,u2​,…,un​},模型参数为 Θ \Theta Θ,则目标函数为:

L 1 ( U ) = ∑ t = 1 n log ⁡ P ( u t ∣ u 1 , u 2 , … , u t − 1 ; Θ ) \mathcal{L}_1(U) = \sum_{t=1}^{n} \log P(u_t \mid u_1, u_2, \dots, u_{t-1}; \Theta) L1​(U)=t=1∑n​logP(ut​∣u1​,u2​,…,ut−1​;Θ)

其中,条件概率通过 Transformer 解码器建模:

h 0 = U W e + W p h l = t r a n s f o r m e r _ b l o c k ( h l − 1 ) ∀ l ∈ [ 1 , L ] P ( u t ∣ u < t ; Θ ) = softmax ( h L W e ⊤ ) \begin{align} h_0&= U W_e + W_p \\ h_l&=transformer\_block(h_{l-1})\forall l \in[1,L]\\ P(u_t \mid u_{<t}; \Theta) &= \text{softmax}(h_LW_e^\top) \end{align} h0​hl​P(ut​∣u<t​;Θ)​=UWe​+Wp​=transformer_block(hl−1​)∀l∈[1,L]=softmax(hL​We⊤​)​​

  • h l h_l hl​ 是 Transformer 在第 l l l 层输出的隐藏状态
  • L L L 是 Transformer 层数
  • W e ∈ R ∣ V ∣ × d W_e \in \mathbb{R}^{|V| \times d} We​∈R∣V∣×d 是输出词表投影矩阵( ∣ V ∣ |V| ∣V∣ 为词表大小, d d d 为隐藏维度)
  • W p ∈ R n × d W_p \in \mathbb{R}^{n \times d} Wp​∈Rn×d 是位置嵌入矩阵
  • U W e UW_e UWe​把 U U U 当作 one-hot 矩阵,但实际实现上是通过索引查表, u t ∈ [ 1 , 2 , … , ∣ V ∣ ] u_t \in [1,2,\dots,|V|] ut​∈[1,2,…,∣V∣], E m b e d ( u t ) = W e [ u t , : ] Embed(u_t)=W_e[u_t,:] Embed(ut​)=We​[ut​,:]

第二阶段:有监督微调(Supervised Fine-tuning)

在特定下游任务(如文本分类、问答、蕴含等)的小规模标注数据上,对预训练模型进行微调,以适配具体任务。

假设有一个带标签的下游任务数据集 C = { ( x 1 , y 1 ) , ( x 2 , y 2 ) , … , ( x n , y n ) } \mathcal{C} = \{(x^1, y^1), (x^2, y^2), \dots, (x^n, y^n)\} C={(x1,y1),(x2,y2),…,(xn,yn)},其中:

  • x = ( x 1 , x 2 , … , x m ) x = (x_1, x_2, \dots, x_m) x=(x1​,x2​,…,xm​) 是输入序列(如句子或句子对)
  • y y y 是标签(如分类类别、是否蕴含等)

GPT-1 将输入序列送入预训练好的 Transformer,取最后一个 token 的隐藏状态 h l h_l hl​(即第 m m m 个位置的输出),通过一个可训练的线性分类头 W y W_y Wy​ 预测标签:

P ( y ∣ x 1 , x 2 , … , x m ) = softmax ( h l W y ) P(y \mid x_1, x_2, \dots, x_m) = \text{softmax}(h_lW_y) P(y∣x1​,x2​,…,xm​)=softmax(hl​Wy​)

微调阶段的目标函数由两部分组成:

L 2 ( C ) = ∑ ( x , y ) ∈ C log ⁡ P ( y ∣ x 1 , x 2 , … , x m ) + λ ⋅ L 1 ( C ) \mathcal{L}_2(\mathcal{C}) = \sum_{(x,y) \in \mathcal{C}} \log P(y \mid x_1, x_2, \dots, x_m) + \lambda \cdot \mathcal{L}_1(\mathcal{C}) L2​(C)=(x,y)∈C∑​logP(y∣x1​,x2​,…,xm​)+λ⋅L1​(C)

  • 第一项:标准的监督分类损失(负对数似然)
  • 第二项:语言模型辅助目标(可选),对输入序列本身(不含标签)进行自回归语言建模,即预测每个 token 的下一个 token(和预训练阶段一致),以防止模型遗忘预训练学到的语言知识,有助于提升性能。
  • λ \lambda λ 是一个超参数(论文中设为 0.5)

不同任务的输入格式

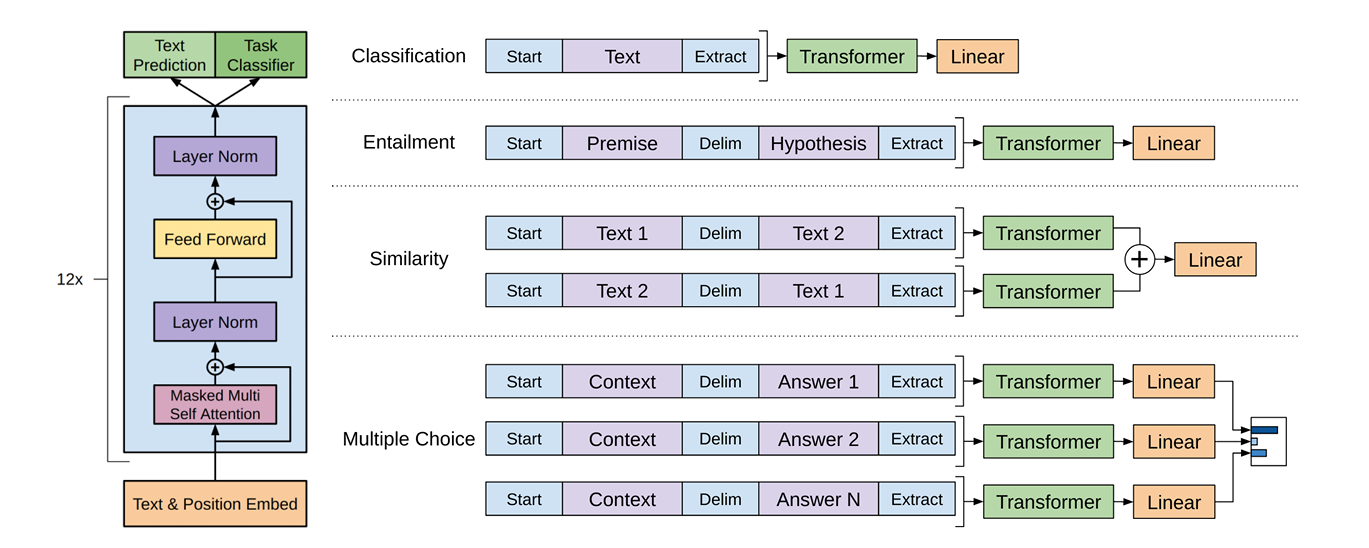
GPT-1 通过统一的序列格式处理不同任务,如下图:
**插图**

所有任务都使用相同的 Transformer 架构,仅在最后加任务特定的分类头。

GPT-1 VS BERT

GPT-1

  • 架构:基于Transformer的解码器(Decoder)部分,采用单向自注意力机制。
  • 特点:仅关注当前及之前的上下文信息,通过预测下一个词实现自回归生成。这种设计使其天然适合生成任务(如文本补全、对话系统),但无法利用未来信息,对上下文的理解存在局限性。
  • 任务类型:自回归语言建模(Autoregressive Language Modeling)。
  • 微调策略:目标函数为下游任务目标+语言模型目标(辅助目标)。由于保留语言模型目标,微调阶段需足够数据平衡两个目标。数据量不足时,辅助目标可能主导训练,导致任务性能下降。

BERT

  • 架构:基于Transformer的编码器(Encoder)部分,采用双向自注意力机制。
  • 特点:同时捕捉左右上下文信息,通过掩码语言模型(MLM)学习双向表示。这种设计使其在理解型任务(如问答、分类)中表现卓越,但不适合直接用于文本生成。
  • 任务类型:掩码语言模型(MLM)和下一句预测(NSP)。
  • 微调策略:仅使用下游任务目标函数进行微调。预训练已学习丰富的语言表示,微调阶段仅需少量任务数据即可达到较好性能。

GPT-2

GPT-2 是 OpenAI 于 2019年推出的第二代生成式预训练模型,其论文题为Language Models are Unsupervised Multitask Learners,它通过无监督学习在海量文本数据上预训练,展现了强大的文本生成能力和多任务适应性。

模型架构

  • 沿用了GPT-1 的结构,基于单向 Transformer 解码器结构,通过堆叠多层Transformer块实现自回归生成。
  • 最大版本参数规模达 1.5 B,是前代GPT-1的10倍以上,显著提升了生成质量和泛化能力。
  • 在分词上,GPT-2 引入了一种 字节级 Byte Pair Encoding(BPE) 分词器,该分词器具有 完全可逆性(reversible),即从 token 序列可以无损地还原原始文本。

下游任务输入

GPT-1

在构建下游任务输入时,需引入模型未见过的特殊符号来标记任务类型。特殊符号需在微调阶段学习,无法直接处理零样本任务。这种方式虽然有效,但每个任务都需要独立的标注数据和训练流程,任务之间隔离性强,迁移成本高。

GPT-2

GPT-2 采用零样本学习(zero-shot learning) 范式,无需任务特定微调即可完成多种任务。它仅通过预训练阶段学习通用语言建模能力,在执行下游任务时,不使用任何任务特定的标注数据,也不更新模型参数,而是直接通过自然语言提示(prompt)引导模型完成任务。例如在做翻译时,输入为 Translate English to French: The house is wonderful,模型直接生成法语翻译。这种零样本学习方式相较于 GPT - 1 的微调方式,大大降低了对任务特定标注数据的依赖,提高了模型的通用性和迁移能力。

Zero-shot learning 指模型在未见过任何特定任务的标注数据的情况下,仅通过任务描述或上下文提示,直接完成新任务的能力。其核心在于模型通过预训练阶段学习到的通用知识,能够理解并执行从未明确训练过的任务。

GPT-3

GPT-3(Generative Pre-trained Transformer 3)是由美国人工智能公司 OpenAI 于2020年6月发布的第三代大型语言模型,论文题为 Language Models are Few-Shot Learners。它是自然语言处理(NLP)领域的一项重要突破,以其强大的语言生成和理解能力而广受关注。

核心特点:

规模庞大:

  • GPT-3 拥有约 1750亿个参数,是当时公开发布的最大语言模型之一(在其发布时远超前代 GPT-2 的 15 亿参数)。

无监督预训练:

  • GPT-3 采用“预训练+提示(prompting)”的方式工作,无需针对特定任务进行微调(fine-tuning)。

少样本/零样本学习

  • 支持零样本学习(zero-shot)、单样本学习(one-shot)和少样本学习(few-shot):只需在输入中提供任务描述或几个示例,模型就能完成新任务,如翻译、问答、写作、编程等。

多功能性:

  • 能够生成高质量的文本,包括新闻文章、诗歌、故事、技术文档、代码等。
  • 可用于多种应用场景:聊天机器人、内容创作、自动摘要、语言翻译、教育辅助、代码生成(如通过 Codex 衍生模型)等。

GPT系列:从GPT1到GPT3的技术演进 1.背景介绍 1.1 自然语言处理的挑战 自然语言处理(NLP)是计算机科学和人工智能交叉领域的一个重要分支,它的目标是让计算机能够理解、生成和交互人类语言。然而,由于人类语言的复杂性和多样性,这一目标一直以来都是一个巨大的挑战。 1.2 从规则 阅读详情

相关推荐

NLP之GPT-1:GPT-1的简介(两大意义/模型结构/三大创新点/两阶段/两大特点/为何单向/模型结构/训练过程)、安装和使用方法、案例应用之详细攻略

​ NLP之GPT-1:GPT-1的简介(两大意义/模型结构/三大创新点/两阶段/两大特点/为何单向/模型结构/训练过程)、安装和使用方法、案例应用之详细攻略 目录 相关文章 相关论文 GPT-1的简介 GPT-1的安装和使用方法 GPT-1的案例应用 相关文章 PTMs:预训练大模型算法衍生发展图及其参数对比、基于Transformer的三类基础架构及其代表性算法(BERT/RoBERTa/ALBERT、GPT/LLaMA系列、XLNet/BART/T5)之详细攻略

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 3632

大型语言模型训练的三个阶段:Pre-Train、Instruction Fine-tuning、RLHF (PPO / DPO / GRPO)

当前的大型语言模型训练大致可以分为如下三个阶段: 1. **Pre-train**:根据大量可获得的文本资料,采用自监督学习-预测 next token 的方式,训练得到预训练模型; 2. **Instruction Fine-tuning**:根据大量任务上的指令标记数据,采用监督学习的方式微调模型,使得模型可以理解人类指令; 3. **RLHF**:基于人类的反馈,采用强化学习的方式,使模型可以产出符合人类偏好的回答。

lucius-liu.cn 1944

大规模语言模型从理论到实践 生成式预训练语言模型GPT

大规模语言模型从理论到实践 生成式预训练语言模型GPT 作者:禅与计算机程序设计艺术 1. 背景介绍 1.1 自然语言处理的发展历程 1.1.1 早期的规

AI架构师小马 874

GPT 系列论文1-2 两阶段半监督 + zero-shot prompt

GPT开创了解码器预训练+微调的两阶段模式,将Transformer架构推向通用NLP任务;BERT则以编码器+更大规模数据实现超越,迅速成为研究热点。面对竞争,GPT2转向零样本学习,证明大模型无需微调即可通过Prompt理解任务;GPT3更以规模暴力碾压,开启“预训练即一切”的时代。这段历程不仅是技术迭代,更是NLP从监督学习走向通用智能的关键跃迁!

nju_spy的博客 1235

AI大语言模型概述:从GPT到BERT的技术演进

大语言模型是一种基于深度学习的自然语言处理技术,它可以理解和生成人类语言。这些模型通过学习大量的文本数据,捕捉到语言的语法、语义和情感等信息,从而实现对自然语言的理解和生成。模型规模:随着计算能力的提高,大语言模型的规模将继续增长,从而实现更好的性能。多模态学习:将大语言模型与其他模态的数据(如图像、音频等)结合,实现更丰富的表示学习。可解释性:提高大语言模型的可解释性,使其在实际应用中更加可靠和可信。低资源语言:将大语言模型应用于低资源语言,缩小语言差距。

AI架构师小马 397

PCB Layout总结

PCB Layout作为硬件设计中的一个环节,也是很重要的一个环节;在硬件电路设计合理的情况下,他其实是影响性能的一个绝对重要的指标。现在很多的PCB Layout工程师都是按照硬件工程师或者PI SI工程师给出的约束规则来完成布局布线的,这些也就是俗称的 “拉线工”。他们重复而机械的完成一块块PCB设计,一段时间设计后,他们中的一些或许已经有了这样的一些经验:哪些要做等长,哪些要走粗、哪些要平...

xydlxd118的博客 2582

ChatGPT发展历程图解析:从GPT-1到GPT-4的技术演进与关键突破

对于刚接触大语言模型(LLM)领域的开发者而言,面对ChatGPT及其背后GPT系列模型的快速迭代,常常会感到困惑:从GPT-1到GPT-4,每一代究竟改进了什么?仅仅是参数量的堆砌吗?理解这条清晰的技术演进脉络,不仅能帮助我们把握LLM发展的内在逻辑,更能为未来的技术选型和预判趋势提供坚实的历史视角。本文将通过梳理一张清晰的“发展历程图”,系统解析GPT系列模型的核心演进路径。

2600_94959826的博客 863

LTspice 导入 PSpice 模型实战指南 --(解决语法兼容性与模型优化问题)

本文提供了将PSpice模型成功导入LTspice的详细实战指南。针对两者间的语法兼容性问题,文章以TI UCC23513为例,逐步讲解模型获取、符号创建、常见语法错误修改及仿真验证方法,并分享了模型优化与个人库管理技巧,帮助用户高效解决模型导入与仿真难题。

weixin_28278377的博客 818

GPT系列演进:从GPT-1到GPT-4的生成式预训练范式升级

从GPT-1到GPT-4的演进,浓缩了生成式预训练范式从验证可行性到迈向通用人工智能的完整历程。GPT-1以Transformer解码器与自回归语言建模,确立了“预训练+微调”的迁移学习范式;GPT-2通过数据与模型规模的量变引发质变,首次展现零样本学习潜力;GPT-3以1750亿参数量引爆上下文学习与涌现能力,使提示工程成为人机交互新范式;GPT-4则进一步融合多模态感知、提升推理精度与对齐程度,推动大模型向产业级智能体迈进。本文系统梳理各代GPT的架构设计、训练策略、核心突破与能力跃迁,剖析规模扩展法则

AladdinEdu,你的AI学习实践工作坊。让想法落地,让研究加速。助力高校AI人才成长,点亮创新未来。 545

Arduino IDE 2.3.2 配置 UNO R4 WIFI 开发环境避坑指南(附LED矩阵驱动测试)

本文详细介绍了如何在Arduino IDE 2.3.2中配置UNO R4 WIFI开发环境,并提供了LED矩阵驱动的实战指南。从开发环境搭建到硬件连接,再到LED矩阵的初始化和弹球动画实现,手把手教你避开常见配置陷阱,最终实现流畅的动画效果。特别适合刚接触UNO R4 WIFI的开发者快速上手。

weixin_28675839的博客 219

zemax显微镜设计

光学显微镜(Optical Microscope,简写OM)是利用光学原理,把人眼所不能分辨的微小物体放大成像,以供人们提取微细结构信息的。我这里是插入进来之后才反转,如果之前已经在目镜的单独文件夹反转过了就不用了。将目镜的焦距设定为25mm,通过缩放,然后将镜头调转过来。镜头数据中的曲率半径、物距像距都设置为变量。将镜头的焦距整体变为16.25mm。将孔径类型设置为按照光阑尺寸浮动。打开物镜的文件,选择插入镜头。由英国物理学家虎克制作。2、像空间孔径0.25。3、像面大小-0.9。

fendoudecheng的博客 8544

预训练语言模型与其演进

语言模型在自然语言处理领域扮演着关键角色,其基本任务是根据前面的词预测后面的词,涉及概率问题。预训练语言模型的发展经历了多个阶段,从word2vec到当前的GPT(Generative Pre-trained Transformer)和BERT(Bidirectional Encoder Representations from Transformers),每一代模型都在特定任务上取得显著的成就。

cooldream2009的博客 1380

8-阿里云服务器 ECS配置R及Studio Server

步骤概览:(首先要明确自己的系统然后进行安装)

hx2024的博客 1570

【深度解析】从GPT-1到GPT-4:ChatGPT背后的核心原理全揭秘

本文深入介绍了生成式预训练模型(GPT)的演进历程及核心技术创新,从GPT-1到GPT-4的技术演变展示了大语言模型在自然语言处理领域的飞速发展。文章详细解析了各代模型的关键突破:GPT-1通过无监督预训练和有监督微调奠定基础;GPT-2以Zero-shot学习和架构优化提升任务迁移能力;GPT-3提出Few-shot学习,实现少样本任务泛化;ChatGPT结合人类反馈强化学习(RLHF),优化对话交互表现;GPT-4通过多模态输入扩展了任务范围和应用场景。最后,文章总结了GPT系列的技术启示与未来展望,强

吴师兄大模型的博客 3801

Python 爬虫实战:爬取 B 站 UP 主的全部视频数据

本文详细介绍了基于Python开发B站UP主视频数据爬虫的技术方案。通过分析B站API接口,使用requests库发送HTTP请求并处理JSON数据,结合pandas进行结构化存储。文章重点解决了接口鉴权、分页爬取、反爬策略等核心难点,实现获取视频标题、播放量、点赞数等关键指标。同时强调数据爬取需遵守平台规范,仅限技术研究使用。该方案为B站视频内容分析提供了可靠的数据采集基础,具有实际应用价值。

2503_91057718的博客 2492

授时中心被攻击?Windows 11 电脑时间不准?手把手教您如何更换国内稳定高速的时间服务器(时间服务器整理)

近期授时中心被攻击,时间同步重要性凸显。Windows 11 默认服务器在国内常遇网络问题。本文教你轻松修改时间服务器,选择更稳定、快速的国内优质服务器,彻底解决电脑时间不准的烦恼,让你的系统时间永远精准如一!🚀

XiaoqiangClub的博客 1082

从Transformer到GPT:演进轨迹

这不是简单的技术路线选择问题,而是对语言本质的不同理解。从Transformer的横空出世到GPT系列的迭代演进,我们见证的不仅是模型架构的优化,更是人工智能对语言理解范式的根本性转变。是注意力机制的提出,还是生成式预训练的范式转换,或者是规模效应的发现?2017年,Google团队在《Attention Is All You Need》中提出的Transformer架构,彻底改变了序列建模的游戏规则。这让我意识到,从Transformer到GPT的演进不仅是技术的进步,更是我们对智能本质理解的深化。

aifs2025的博客 1149

【WRF-Chem工具】pyVPRM 计算大气与陆地植被之间的 CO₂ 交换通量

pyVPRM 计算大气与陆地植被之间的 CO₂ 交换通量

WW、forever的博客 210

论文串读--OpenAI-GPT系列1.2.3.4--大语言模型标准架构和预训练流程

本文系统梳理了GPT系列模型的技术演进路线,从GPT-1到GPT-4的核心技术始终基于Decoder-only Transformer架构。GPT-1首创无监督预训练+微调范式,通过任务特定输入表示实现迁移学习;GPT-2转向纯预训练,探索zero-shot能力;GPT-3突破性地提出few-shot上下文学习,利用1750亿参数实现元学习;GPT-4则实现多模态突破,通过RLHF提升对齐能力。

zhuai.blog.youkuaiyun.com 2736

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

GPT-1、GPT-2、GPT-3 的区别和联系

GPT-1、GPT-2 和 GPT-3 是 OpenAI 推出的三代生成式预训练语言模型,它们在架构上都采用 Transformer 解码器,具备单向语言建模能力。GPT-1 奠定了“预训练 + 微调”的范式;GPT-2 在模型规模上扩大十倍,显著提升生成质量;GPT-3 参数量跃升至 1750 亿,引入了 In-Context Learning,实现了强大的零样本和少样本泛化能力。三者的核心联系在于持续扩大模型规模与训练数据,推动了模型能力的非线性跃升,应用方式也从依赖微调过渡到 prompt 控制。GP

weixin_67868534的博客 1372

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

GPT系列模型从GPT-1到InstructGPT的技术演进与未来展望

每一代GPT模型的升级都带来了显著的技术进步,从最初的GPT-1到如今的GPT-4,每一代都在模型的规模、性能、推理能力和应用领域上做出了重要的突破。尽管 OpenAI 并未公开 GPT-4 的确切参数量,但根据其表现推测,GPT-4 的参数规模可能超过了 GPT-3 的1750亿,进一步提升了模型的能力。此外,GPT-2 在生成文本时还引发了对其潜在滥用风险的担忧,因为它能够生成与人类编写难以区分的长篇文本,这也使得 OpenAI 在最初发布时对 GPT-2 的发布采取了谨慎的策略。

hello.reader 2991

生成式预训练Transformer(GPT)简介

GPT是基于Transformer架构的大型语言模型,通过预训练和微调两阶段学习处理语言任务。其发展历程从2018年GPT到2025年GPT-5,参数规模不断扩大,性能持续提升,具备多模态能力和更强的推理性能。GPT广泛应用于内容创作、客户支持、教育等领域,具有多功能性和小样本学习等优势,但也面临偏差、资源消耗等挑战。模型采用自注意力机制处理文本,通过嵌入层、位置编码和多层Transformer模块实现语言理解和生成。

zencartmoban的博客 523

从 GPT 到 GPT-2:解密生成式预训练模型的架构演进

摘要: GPT 和 GPT-2 是基于 Transformer 解码器的生成式语言模型,通过单向自回归方式实现文本生成。GPT-2 在 GPT 基础上通过扩大模型规模(最高 48 层)和训练数据(40GB),验证了缩放法则的有效性。两者采用 Masked Self-Attention 保证生成因果性,并通过预训练+微调两阶段训练,其中 GPT-2 引入 Top-K 采样提升生成多样性。这些创新为后续大语言模型发展奠定了基础。

higerwy的博客 444

【自然语言处理】生成式语言模型GPT复现详细技术方案

本文详细介绍了GPT模型的完整复现流程,涵盖了从理论基础到工程实践的全链路技术方案。主要内容包括:1. 提出了基于Transformer解码器架构的GPT模型设计,详细阐述了自注意力机制、前馈网络等核心组件;2. 构建了包含数据清洗、BPE分词、序列处理等环节的训练数据预处理流程;3. 设计了混合并行训练策略,整合了数据并行、模型并行等技术;4. 实现了预训练和微调流程,包括RLHF人类反馈强化学习;5. 建立了多维度的评估体系;6. 提供了模型优化和工程化部署方案,包括量化压缩、KV缓存加速等。

2401_84149564的博客 1959
上一篇: 位置编码(绝对位置,相对位置)
下一篇: Llama 模型架构解析:从 Pre-RMSNorm 到 GQA 的技术演进
LETTER•
博客等级 码龄3年 62粉丝 16原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值