


1、案例概述
图像识别是机器学习领域一个非常重要的应用场景,本次通过一个较为经典的手写数字识别模型来讲解如何在具体场景中应用K近邻算法。
2、数据集
手写数字识别,或者说图像识别的本质就是把下图所示的图片中的数字转换成计算机能够处理的数字形式。
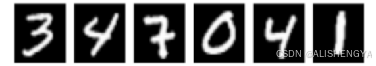
(1) 图像二值化
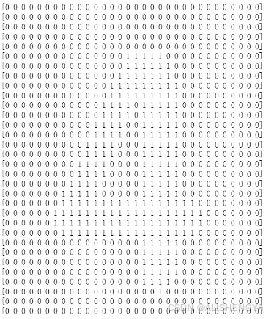
通过图像二值化可以将图片大小为32×32的手写数字“4”的图片转换成由0和1组成的“新的数字4”,如下图所示。数字1代表有颜色的地方,数字0代表无颜色的地方,这样就完成了手写数字识别的第一步。
(2)二维数组转换为一维
数组经过图像二值化处理获得32×32的0-1矩阵,为了方便进行机器学习建模,还需要对这个二维矩阵进行简单的处理:在第1行数字之后依次拼接第2~32行的数字(也即32*32=1024),得到一个1×1024的一维数组。利用这种一维数组就可以计算不同手写数字之间的距离(利用上文讲到的明氏距离或皮尔森距离计算),从而进行手写数字识别。
MNIST数据集是一个手写体识别数据集,来自美国国家标准与技术研究所。它包含了各种手写数字图片以及每张图片对应的数字标签,图片大小为28*28,且为黑白图片。其中,60000张手写数字图片作为训练数据,由来自 250 个不同人手写的数字构成, 其中 50% 是高中学生, 50% 来自人口普查局的工作人员;10000张图片作为测试数据。数据集链接:
链接: https://pan.baidu.com/s/10dl5f5EXEd2IiZc1NdhCdQ?pwd=hz6j 提取码: hz6j
本案例使用的数据集共有1934个二值化处理好的手写数字0~9,每一行是一个手写数字的一维数组。“对应数字”列是手写数字,也是目标变量;其余列为该手写数字对应的1024维特征值,也是预测变量。
(4)Python实现过程
Ⅰ数据读取
首先通过pandas库读取数据,代码如下:
import pandas as pd
df = pd.read_excel('手写字体识别.xlsx')
df.head()
通过这段代码,我们可以把数据读取到变量df中,为了更好的使用变量,现在需要使用type()函数查看df的类型是什么,如下:

通过打印df.head()查看表格的前5行,结果如下所示:

其中第1列“对应数字”为目标变量y,其余1024列为特征变量X,接下来我们将利用这些数据搭建手写数字识别模型。
Ⅱ 提取特征变量和目标变量
在建模前,首先将特征变量和目标变量分别提取出来,代码如下:
X = df.drop(columns='对应数字')
y = df['对应数字']
x为特征变量,y为目标变量。
Ⅲ 划分训练集和测试集
提取完特征变量和目标变量后,将数据划分为训练集和测试集,代码如下:
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=123)
这里将test_size设置为0.2,表示选取20%的数据用于测试。random_state设置为123,使每次运行程序得到的数据划分结果保持一致。
Ⅳ 模型构建
划分好训练集和测试集之后,可以从Scikit-Learn库中引入K近邻算法进行模型训练,代码如下:
from sklearn.neighbors import KNeighborsClassifier as KNN
knn_model = KNN(n_neighbors=5)
knn_model.fit(X_train, y_train)
代码创建了一个KNN类的实例对象knn_model,并通过参数n_neighbors=5指定了在K近邻算法中选择的邻居数量为5。也就是在进行分类预测时,会根据新数据与训练集中5个最相似的数据(最近邻)的类别来确定新数据的类别。
☀这儿有个疑问,K近邻的第一篇文章中讲到,K近邻算法不需要进行模型训练,为什么这儿仍然有模型训练,这和决策树的模型训练有什么区别?
K近邻算法被称为“lazy-learning”(惰性学习)算法,它不需要像传统的参数化模型(如决策树、神经网络等)一样通过训练数据来学习模型参数。但在代码中看到的fit方法,实际上是在存储训练数据,以便后续在预测阶段进行距离计算。
当调用fit方法时,K近邻模型只是简单地记录了训练集中的样本特征和对应的标签。在手写数字识别的例子中,knn_model.fit(X_train,y_train)这一步就是把训练集中手写数字的特征(存储X_train中)和对应的数字标签(存储在y_train中)保存起来。在预测新数据时,会将新数据与这些保存的训练数据进行距离比较,而不是像传统模型那样通过训练得到一个固定的决策边界或者函数形式。
☀ 是存储全部的训练数据还是存储n_neighbors=5个?
在K近邻算法中,模型会存储全部的训练数据,而不仅仅是n_neighbors=5个数据点。当执行knn_model.fit(X_train,y_train)时,模型会将整个训练集X_train(包含所有的特征向量)和对应的标签y_train保存下来。
n_neighbors=5这个参数是在预测阶段使用的。当有一个新的数据点需要分类时,模型首先会计算这个新数据点与存储的所有训练数据点之间的距离(通常使用欧氏距离、明氏距离等)。
Ⅴ 模型评估与预测
通过如下代码即可对测试集数据进行预测,预测对应的数字,同时可以使用accuracy_score()函数,查看测试集所有数据的预测准确度:
y_pred = knn_model.predict(X_test)
a = pd.DataFrame()  # 创建一个空DataFrame
a['预测值'] = list(y_pred)
a['实际值'] = list(y_test)
a.head(10)

from sklearn.metrics import accuracy_score
score = accuracy_score(y_pred, y_test)
print(score)
将score打印输出,结果为0.9793,也就是说,模型对整个测试集的预测准确度为97.93%。
对于分类模型,不仅关心整体的预测准确度,也关心模型在每一类样本里面的表现,Python可以通过如下代码计算每一个类别的精准率和命中率:
from sklearn.metrics import classification_report
print(classification_report(y_test, y_pred))


 3993


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


