MFCC

深入理解MFCC(梅尔频率倒谱系数) 取得13个系数后,还会在时序上,对13个系数求一阶差分和二阶差分,二阶差分等价于对一阶差分求一阶差分。表示第n帧的13个系数,将一阶差分和二阶差分与原函数值拼接起来,得到39个系数。通常选取前12个系数,再拼接一个当前frame的能量,共13个。MFCC的输出可以表示为一个二维数组,shape为。越靠前的系数,包含越多的基频和共振峰的信息。,由于是二维数组,所以可以用热力图可视化。 阅读详情
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
本文链接: https://blog.youkuaiyun.com/u013538664/article/details/18678861

原来对语音特征参数MFCC的提取过程不是很了解,最近做实验需要自己手动去提取,所以借此机会,深入的学习了一下,所以记录下来,希望能够对日后的学习有一定的帮助。

一、MFCC概述


在语音识别(SpeechRecognition)和话者识别(SpeakerRecognition)方面,最常用到的语音特征就是梅尔倒谱系数(Mel-scaleFrequency Cepstral Coefficients,简称MFCC)。根据人耳听觉机理的研究发现,人耳对不同频率的声波有不同的听觉敏感度。从200Hz到5000Hz的语音信号对语音的清晰度影响对大。两个响度不等的声音作用于人耳时,则响度较高的频率成分的存在会影响到对响度较低的频率成分的感受,使其变得不易察觉,这种现象称为掩蔽效应。由于频率较低的声音在内耳蜗基底膜上行波传递的距离大于频率较高的声音,故一般来说,低音容易掩蔽高音,而高音掩蔽低音较困难。在低频处的声音掩蔽的临界带宽较高频要小。所以,人们从低频到高频这一段频带内按临界带宽的大小由密到疏安排一组带通滤波器,对输入信号进行滤波。将每个带通滤波器输出的信号能量作为信号的基本特征,对此特征经过进一步处理后就可以作为语音的输入特征。由于这种特征不依赖于信号的性质,对输入信号不做任何的假设和限制,又利用了听觉模型的研究成果。因此,这种参数比基于声道模型的LPCC相比具有更好的鲁邦性,更符合人耳的听觉特性,而且当信噪比降低时仍然具有较好的识别性能。
      

梅尔倒谱系数(Mel-scale Frequency Cepstral Coefficients,简称MFCC)是在Mel标度频率域提取出来的倒谱参数,Mel标度描述了人耳频率的非线性特性,它与频率的关系可用下式近似表示:


式中f为频率,单位为Hz。下图展示了Mel频率与线性频率的关系:


图1 Mel频率与线性频率的关系

二、语音特征参数MFCC提取过程

基本流程:


图2 MFCC参数提取基本流程

1.预加重

预加重处理其实是将语音信号通过一个高通滤波器:

 (1)

式中的值介于0.9-1.0之间,我们通常取0.97。预加重的目的是提升高频部分,使信号的频谱变得平坦,保持在低频到高频的整个频带中,能用同样的信噪比求频谱。同时,也是为了消除发生过程中声带和嘴唇的效应,来补偿语音信号受到发音系统所抑制的高频部分,也为了突出高频的共振峰。

2.分帧

先将N个采样点集合成一个观测单位,称为帧。通常情况下N的值为256或512,涵盖的时间约为20~30ms左右。为了避免相邻两帧的变化过大,因此会让两相邻帧之间有一段重叠区域,此重叠区域包含了M个取样点,通常M的值约为N的1/2或1/3。通常语音识别所采用语音信号的采样频率为8KHz或16KHz,以8KHz来说,若帧长度为256个采样点,则对应的时间长度是256/8000 1000=32ms。

3.加窗(Hamming Window)

将每一帧乘以汉明窗,以增加帧左端和右端的连续性。假设分帧后的信号为S(n), n=0,1,…,N-1, N为帧的大小,那么乘上汉明窗后,W(n)形式如下:
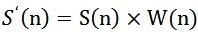
(2)

不同的a值会产生不同的汉明窗,一般情况下a取0.46

4.快速傅里叶变换

由于信号在时域上的变换通常很难看出信号的特性,所以通常将它转换为频域上的能量分布来观察,不同的能量分布,就能代表不同语音的特性。所以在乘上汉明窗后,每帧还必须再经过快速傅里叶变换以得到在频谱上的能量分布。对分帧加窗后的各帧信号进行快速傅里叶变换得到各帧的频谱。并对语音信号的频谱取模平方得到语音信号的功率谱。设语音信号的DFT为:

(3)

式中x(n)为输入的语音信号,N表示傅里叶变换的点数。

5.三角带通滤波器
将能量谱通过一组Mel尺度的三角形滤波器组,定义一个有M个滤波器的滤波器组(滤波器的个数和临界带的个数相近),采用的滤波器为三角滤波器,中心频率为 。M通常取22-26。各f(m)之间的间隔随着m值的减小而缩小,随着m值的增大而增宽,如图所示:


图3 Mel频率滤波器组

三角滤波器的频率响应定义为:

(4)
式中:

三角带通滤波器有两个主要目的:

对频谱进行平滑化,并消除谐波的作用,突显原先语音的共振峰。(因此一段语音的音调或音高,是不会呈现在MFCC 参数内,换句话说,以MFCC 为特征的语音辨识系统,并不会受到输入语音的音调不同而有所影响)此外,还可以降低运算量。

6.计算每个滤波器组输出的对数能量为
(5)
7.经离散余弦变换(DCT)得到MFCC系数
(6)
将上述的对数能量带入离散余弦变换,求出L阶的Mel-scale Cepstrum参数。L阶指MFCC系数阶数,通常取12-16。这里M是三角滤波器个数。
8.对数能量

此外,一帧的音量(即能量),也是语音的重要特征,而且非常容易计算。因此,通常再加上一帧的对数能量(定义:一帧内信号的平方和,再取以10为底的对数值,再乘以10)使得每一帧基本的语音特征就多了一维,包括一个对数能量和剩下的倒频谱参数。

注:若要加入其它语音特征以测试识别率,也可以在此阶段加入,这些常用的其它语音特征包含音高、过零率以及共振峰等。

9.动态查分参数的提取(包括一阶差分和二阶差分)

标准的倒谱参数MFCC只反映了语音参数的静态特性,语音的动态特性可以用这些静态特征的差分谱来描述。实验证明:把动、静态特征结合起来才能有效提高系统的识别性能。差分参数的计算可以采用下面的公式:

(7)

式中,dt表示第t个一阶差分;Ct表示第t个倒谱系数;Q表示倒谱系数的阶数;K表示一阶导数的时间差,可取1或2。将上式中结果再代入就可以得到二阶差分的参数。

总结:

因此,MFCC的全部组成其实是由:

N维MFCC参数(N/3MFCC系数+ N/3一阶差分参数+ N/3二阶差分参数)+帧能量(此项可根据需求替换)

三、MATLAB实现方法(不含有关能量的维数)

注:在提取MFCC参数之前需要加载并使用VOICEBOX工具包

实现代码:

<span style="font-size:18px;">[x fs]=wavread('000.wav');
bank=melbankm(24,256,fs,0,0.4,'t');%Mel滤波器的阶数为24,fft变换的长度为256,采样频率为16000Hz
%归一化mel滤波器组系数
bank=full(bank);
bank=bank/max(bank(:));
for k=1:12			%归一化mel滤波器组系数
n=0:23;
dctcoef(k,:)=cos((2*n+1)*k*pi/(2*24));
end
w=1+6*sin(pi*[1:12]./12);%归一化倒谱提升窗口
w=w/max(w);%预加重滤波器
xx=double(x);
xx=filter([1-0.9375],1,xx);%语音信号分帧
xx=enframe(xx,256,80);%对x 256点分为一帧
%计算每帧的MFCC参数
for i=1:size(xx,1)
y=xx(i,:);
s=y'.*hamming(256);
	t=abs(fft(s));%fft快速傅立叶变换
t=t.^2;
	c1=dctcoef*log(bank*t(1:129));
c2=c1.*w';
m(i,:)=c2';
end
%求取一阶差分系数
dtm=zeros(size(m));
for i=3:size(m,1)-2
dtm(i,:)=-2*m(i-2,:)-m(i-1,:)+m(i+1,:)+2*m(i+2,:);
end
dtm=dtm/3;
%求取二阶差分系数
dtmm=zeros(size(dtm));
for i=3:size(dtm,1)-2
dtmm(i,:)=-2*dtm(i-2,:)-dtm(i-1,:)+dtm(i+1,:)+2*dtm(i+2,:);
end
dtmm=dtmm/3;
%合并mfcc参数和一阶、二阶差分mfcc参数
ccc=[m dtm dtmm];
%去除首尾两帧,因为这两帧的一阶差分参数为0
ccc=ccc(3:size(m,1)-2,:);
ccc
% subplot(2,1,1) 
% ccc_1=ccc(:,1);
% plot(ccc_1);title('MFCC');ylabel('幅值');
% [h,w]=size(ccc);
% A=size(ccc);
% subplot(212)    
% plot([1,w],A);
% xlabel('维数');
% ylabel('幅值');
% title('维数与幅值的关系')
</span>
结果:


四、HTK实现

运行:

HCopy config 8.wav 8.mfcc

注:涉及mfcc的参数为:

TARGETKIND=MFCC_E_D_A

-目标是MFCC文件,以及energy(E),delta(D),delta-delta(A)

TARGETRATE=100000

-窗间隔为10ms

WINDOWSIZE=250000

-窗长为25ms

注:HTK中时间单位为100ns

ZMEANSOURCE=T

-将来源文件取zeromean,即去掉DC值

USEHAMMING=T

-使用hammingwindow

PREEMCOEF=0.97

-预加重系数0.97

NUMCHANS=31

-在MEL刻度下等分成31个频带

USEPOWER=F

-不使用c(0)参数

NUMCEPS=13

-最后使用13阶MFCC

CEPLIFTER= 22                     

-倒谱滤波系数

ENORMALISE=T

-窗的能量值做正规化

LOFREQ=200

-设定频带的下截止频率

HIFREQ=3500

-设定频带的上截止频率

注:电话线品质,如果麦克风的话,L为0,H为8000

DELTAWINDOW=2

ACCWINDOW=2

-设定delta和delta-delta的计算参数

此处config如下所示:


生成的mfcc文件可以使用HList工具查看

全部输出:

HList–h –o 000.mfcc > 000.txt


只输出mfcc便于使用:

HList–r 000.mfcc > 000.txt


以上即是语音特征参数MFCC提取过程的详细解释和具体实现。


MFCC语音特征值提取算法 MFCC意为梅尔频率倒谱系数,顾名思义,MFCC语音特征提取包含两个关键步骤;将语音信号转化为梅尔频率,然后进行倒谱分析。梅尔频谱是一个可用来代表短期音频的频谱,梅尔刻度(Mel Scale)则是一种基于人耳对等距的音高变化的感官判断而确定的非线性频率刻度。梅尔频率和正常的频率f之间的关系:当梅尔刻度均匀分布,则对应的频率之间的距离会越来越大。梅尔刻度的滤波器组在低频部分的分辨率高,跟人耳的听觉特性比较相符,这也是梅尔刻度的物理意义。 阅读详情

相关推荐

语音识别之MFCC

在进行端点处理之后,就可以得到需要处理的信号。但是要进行语音识别就必须进行一个处理:特征提取。进行特征提取我们这里采用的就是梅尔谱。 在进行特征提取的时候需要一些操作: 1、DFT         首先是把时域的信号通过DFT变成频域的信号。         把信号转换到频域之后就更好处理了。在这里我们对于DFT做一些简单的介绍:离散傅立叶变化不能对非周期信号进行处理。

I AM BACK 1万+

语音特征参数MFCC提取过程详解

原来对语音特征参数MFCC的提取过程不是很了解,最近做实验需要自己手动去提取,所以借此机会,深入的学习了一下,所以记录下来,希望能够对日后的学习有一定的帮助。

James Zhang's Blog 16万+

MATLAB实现MFCC分析

一、基本概念 Mel频率倒谱系数(MFCC)的分析时基于认得听觉机理,依据人的听觉实验结果来分析语音的频谱,期望能获得更好的语音特性。梅尔频率倒谱系数(Mel Frequency Cepstrum Coefficient, MFCC)考虑到了人类的听觉特征,先将线性频谱映射到基于听觉感知的Mel非线性频谱中,然后转换到倒谱上。 在Mel频域内,人对音调的感知度为线性关系。举例来说,如果两段语音的Mel频率相差两倍,则人耳听起来两者的音调也相差两倍。 ​ 我们将频谱通过一组Mel滤波器就得到Mel频谱。公式表

Tristan的博客 2615

MFCC理解

MFCC 在语音识别(SpeechRecognition)和话者识别(SpeakerRecognition)方面,最常用到的语音特征就是梅尔倒谱系数(Mel-scaleFrequency Cepstral Coefficients,简称MFCC)。根据人耳听觉机理的研究发现,人耳对不同频率的声波有不同的听觉敏感度。从200Hz到5000Hz的语音信号对语音的清晰度影响对大。两个响度不等的声音作用于...

James_bobo的博客 9481

MFCC程序参数详解

本文程序来源于宋知用老师编著的《MATLAB在语音信号分析与合成中的应用》

intersting的博客 6109

MFCC特征介绍

MFCC特征介绍 在语音识别技术中,需要提取音频的特征,然后就可以使用该音频进行模型的训练或者是进行识别,目前很常用的一种特征叫做MFCC特征,又叫做梅尔倒谱系数特征。MFCC特征保留了语义相关的一些内容,过滤掉了诸如背景杂音等无关的信息。MFCC的特点是使用一组用来创建梅尔倒谱的关键系数,这样使得它的倒频谱和人类非线性的听觉系统更为接近。 具体步骤如下: 对音频信号进行分帧加窗 将信号进行傅里叶变换 将频谱映射到梅尔刻度 取对数 进行DCT变换 为什么要对音频信号进行分帧加窗? 因为音频信号本身是非平

DataBaker的博客 5730

matlab实现MFCC

MFCC MFCC(Mel-frequency cepstral coefficients):梅尔频率倒谱系数。 梅尔频率是基于人耳听觉特性提出来的, 它与Hz频率成非线性对应关系。 MFCC提取过程: 首先对语音进行预处理。 预处理又包括对语音进行预加重、分帧、加窗。 快速傅里叶变换 对分帧加窗后的每帧语音数据进行fft变换。 计算谱线能量 对fft变换后的每帧信号取平方。 梅尔滤波器组滤波 将求出的每帧谱线能量谱与梅尔滤波器组相乘。 DCT变换 经过梅尔滤波器滤波后的每帧信号进行DCT(离散余弦变换

qq_44420246的博客 1万+

mfcc

MFCC(Mel-frequency cepstral coefficients):梅尔频率倒谱系数。梅尔频率是基于人耳听觉特性提出来的, 它与Hz频率成非线性对应关系。梅尔频率倒谱系数(MFCC)则是利用它们之间的这种关系,计算得到的Hz频谱特征。主要用于语音数据特征提取和降低运算维度。例如:对于一帧有512维(采样点)数据,经过MFCC后可以提取出最重要的40维(一般而言)数据同时也达到了将...

光英的记忆博客 1237

语音识别MFCC系列(四)——MFCC特征参数提取

最好先看下下面三篇(其中系统的讲述了离散傅里叶变换,能量密度谱为什么是DFT系数的平方除以总点数,为什么512点的离散傅里叶变换只选前257个分量,离散余弦变换,为什么采样频率要大于真实信号最大频率的两倍,频谱混叠,频谱泄露,为什么要用窗函数等等),做知识储备,如果上述问题不懂,一定要去看哦,都可以找到答案。然后MFCC的提取过程就特别好理解。因为我就是这么学过来的!本文是我看了代码以后做的总结,...

manmanxiaowugun的博客 1万+

mfcc学习记录

http://www.douban.com/note/324336892/ 这个地方对

ch977的专栏 3962

mfcc特征提取

代码中的melcepts.m直接可以用来提取MFCC,MFCC是Mel-Frequency Cepstral Coefficients的缩写,顾名思义MFCC特征提取包含两个关键步骤:转化到梅尔频率,然后进行倒谱分析

Fbank特征与MFCC特征解析

详细的fbank特征介绍见Kaldi特征提取之-FBank,可以运行其MATLAB代码,然后结合这篇博客FBank与MFCC 的介绍一起看 其中需要自己注意的是: FBank与MFCC特征提取的区别: fbank只是缺少mfcc特征提取的dct倒谱环节,其他步骤相同。 fbank的不足:FBank特征已经很贴近人耳的响应特性,但是仍有一些不足:FBank特征相邻的特征高度相关(相邻滤波器组有重...

Bonner1的博客 1万+

MFCC特征提取

matlab实现语音波形的MFCC特征提取,还可以保存特征数据到文本文档中

MFCC特征使用方法总结

学习笔记,音乐检索,音频类学习 MFCC特征使用方法总结 joanna2017年11月27日 项目需要用到MFCC特征,关于MFCC的特征如何使用,一开始我很困惑。现在分享一些自己总结的常见的MFCC使用方法。欢迎评论补充。 假设一段语音,分为n帧,提取其12维MFCC特征 1. 每帧MFCC系数独立处理,每帧作为时序性进行处理[1]. 如用于语音识别,不同帧的MFCC构成了一个序列,...

YoungLittleT的博客 5775

手把手教你用单结晶体管搭建简易振荡电路(含电路图和波形分析)

本文详细介绍了如何使用单结晶体管(UJT)搭建简易振荡电路,包括电路设计、波形分析和实战技巧。通过具体的电路图和参数计算,帮助电子爱好者和工程师快速掌握UJT振荡器的设计与调试方法,适用于脉冲信号生成和时钟源制作等应用场景。

weixin_29207533的博客 517

Neo4j Desktop新手必看:3分钟搞定CSV数据导入(附常见报错解决方案)

本文详细介绍了在Neo4j Desktop中高效导入CSV数据的三种主流方法,包括图形化界面操作、命令行批量导入和Python驱动编程导入,并提供了常见报错解决方案和性能优化技巧,帮助新手快速构建知识图谱。

lambda的博客 649

python实现mfcc

1、利用python_speech_features库编写MFCC特征提取,生成40维的mfcc向量 import scipy.io.wavfile as wavfile from python_speech_features import mfcc, delta def read_wave_data(filename): """获取语音文件信息: sample_rate:帧速率 s...

qq_41975844的博客 5945
上一篇: matplotlib 中的subplot的用法
下一篇: MFCC
AI_Rancho
博客等级 码龄10年 63粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
