刚刚,Llama 3.2 来了!支持图像推理,还有可在手机上运行的版本

如何让本地使用 Ollama 部署的开源大模型(LLM)识别图片和 Excel 文件 摘要: 要让本地Ollama部署的开源大模型(LLM)识别图片和Excel文件,需结合多模态模型与外部工具。 图片识别:使用多模态模型(如Llava),通过ollama pull llava下载,运行后通过/image命令或API传入图片路径或Base64数据,模型会生成描述。 Excel处理:需先用Python(如pandas)提取Excel数据为文本,再输入文本模型(如Llama3)进行分析。可通过API或集成LangChain自动化流程。 注意:图片识别需GPU支持,Excel需手动转换;Ollama 阅读详情

来源 | 机器之心

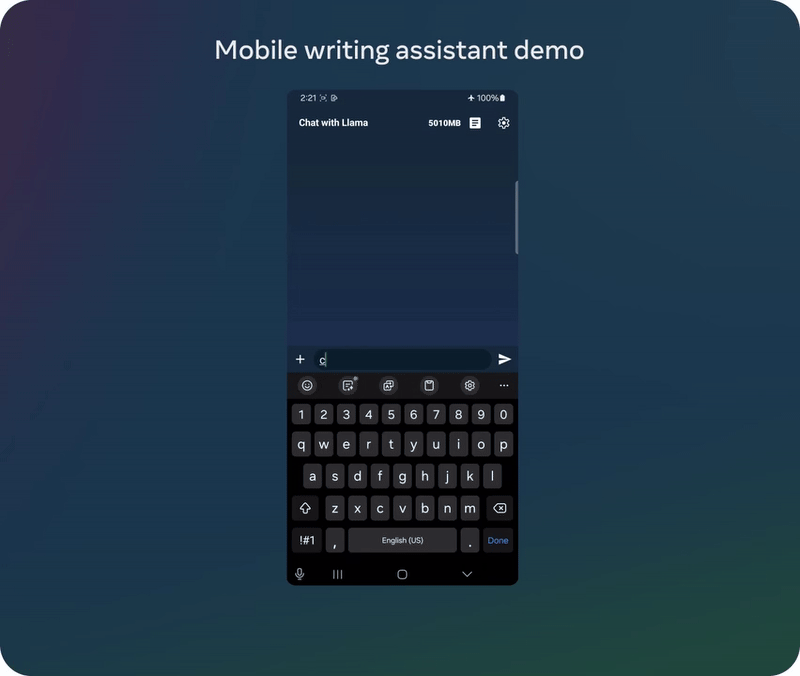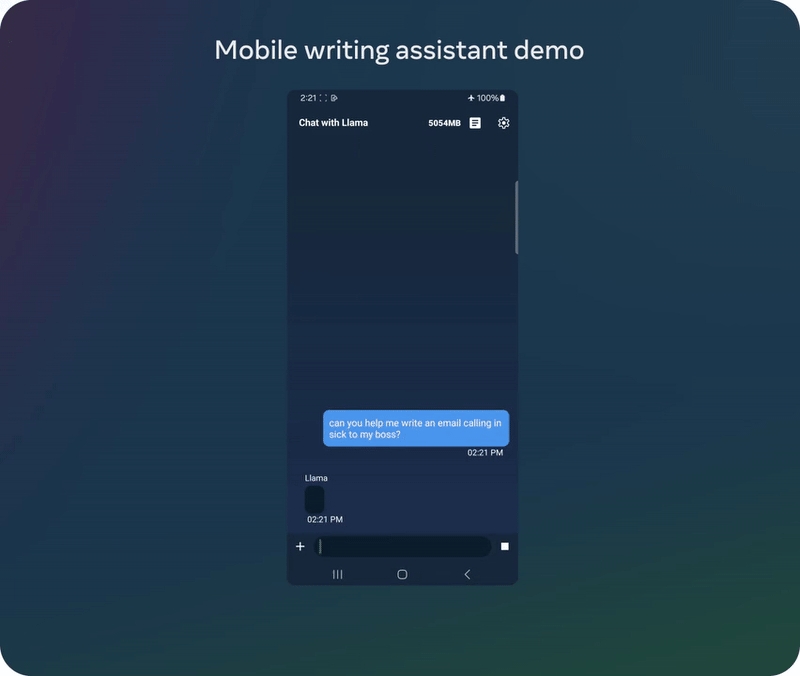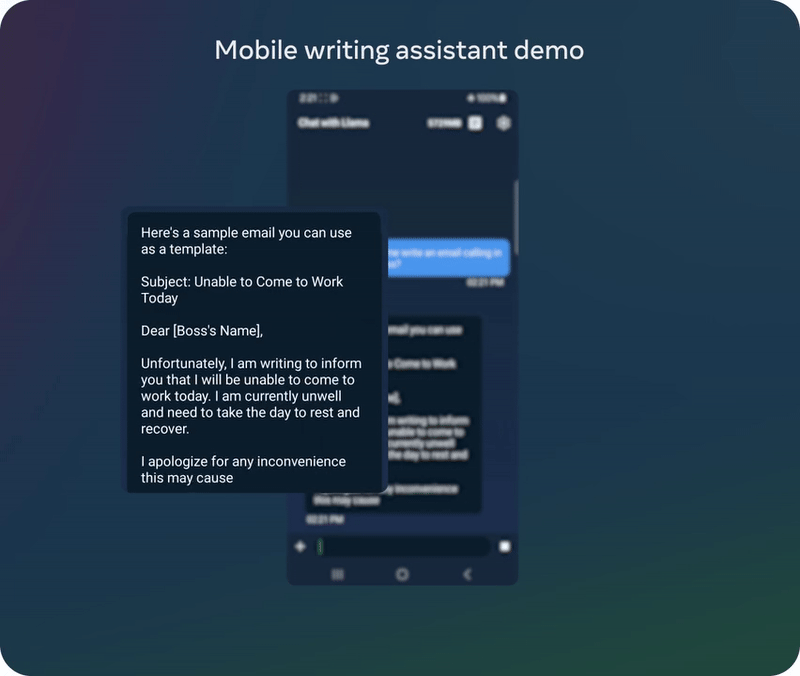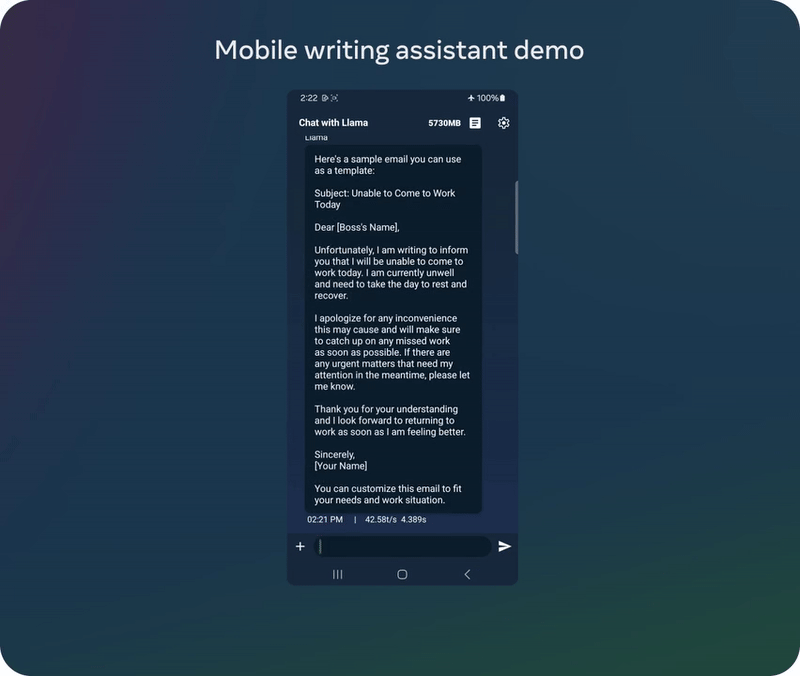
今天凌晨,大新闻不断。一边是 OpenAI 的高层又又又动荡了,另一边被誉为「真・Open AI」的 Meta 对 Llama 模型来了一波大更新:不仅推出了支持图像推理任务的新一代 Llama 11B 和 90B 模型,还发布了可在边缘和移动设备上的运行的轻量级模型 Llama 3.2 1B 和 3B。

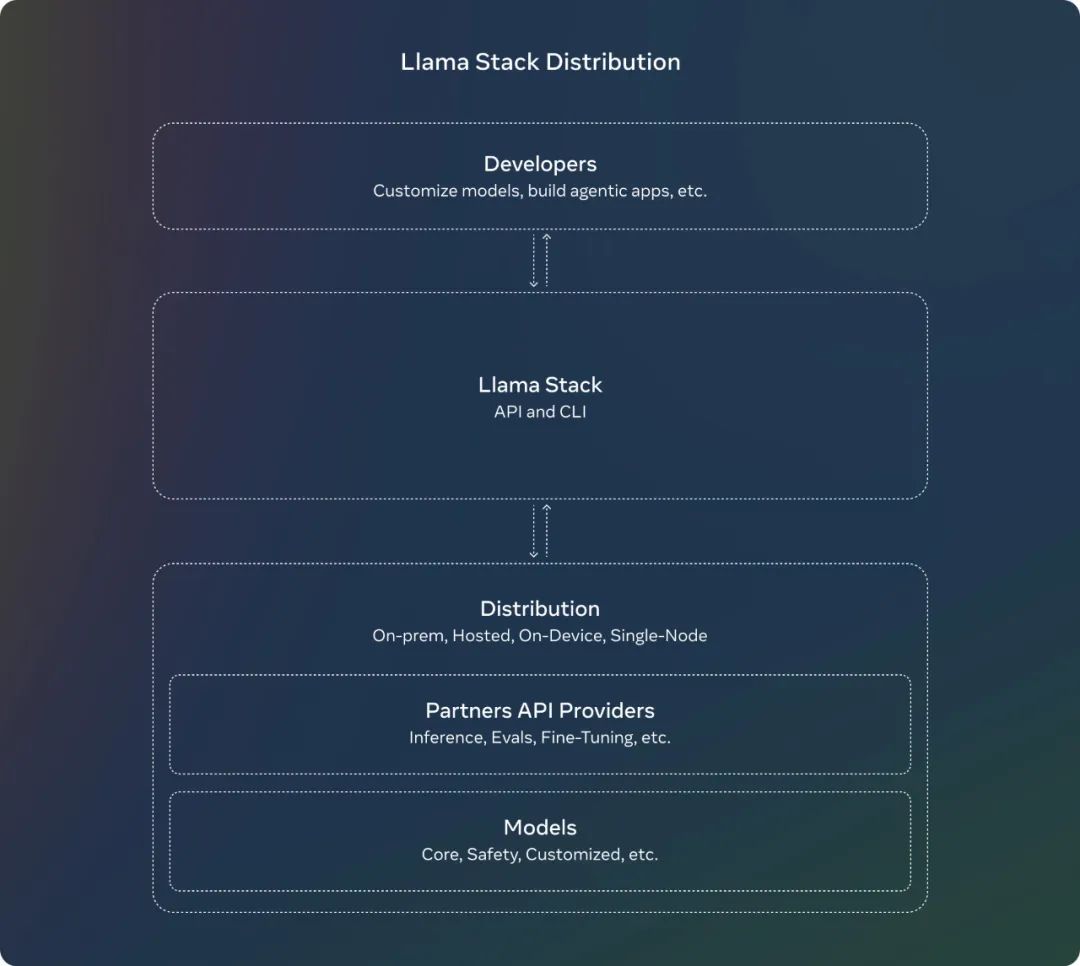
不仅如此,Meta 还正式发布了 Llama Stack Distribution,其可将多个 API 提供商打包在一起以便模型方便地调用各种工具或外部模型。此外,他们还发布了最新的安全保障措施。

真・Open AI 诚不我欺!各路网友和企业都纷纷激动地点赞。要知道,现在距离 7 月 23 日 Llama 3.1 发布才刚刚过去 2 个月。
图片

Meta 首席 AI 科学家 Yann LeCun 也欢快地表达了自己的喜悦:「乖宝宝羊驼!」
图片

Meta 也借此机会重申了他们一贯的主张:「通过开源人工智能,我们才能确保这些创新能够反映和造福于其所服务的全球社区。我们将通过 Llama 3.2 继续推动让开源成为标准。」

Llama 家族是在今天的 Meta Connect 2024 大会上迎来升级的。这一次,我们终于有了可以在边缘设备和移动设备上本地运行的轻量级 LLM(Llama 3.2 1B 和 3B)!同时,小型和中型版本也获得了相应更新,参数量也都各有大幅增多,因为它们都获得了一个重大升级:可以处理视觉数据了!也因此,它们的模型卡都加上了 Vision 标签。

  • Llama 3.1 8B 升级成 Llama 3.2 11B Vision

  • Llama 3.1 70B 升级成 Llama 3.2 90B Vision

Llama 系列模型发布至今不过一年半时间,其取得的成就着实让人惊叹。Meta 表示:今年,Llama 实现了 10 倍的增长,并已经成为「负责任创新」的标准。Llama 持续在开放性、可修改性和成本效率方面保持领先地位,并且足以与封闭模型竞争 —— 甚至在某些领域还处于领先地位。

Meta 表示:「我们相信开放能推动创新并且是正确的前进道路,因此我们会继续分享我们的研究并与我们的合作伙伴和开发者社区合作。」

现在我们马上就可以开始上手体验:

官网下载:https://llama.meta.com
Hugging Face:https://huggingface.co/meta-llama

目前 Llama 3.2 最大的两个模型 11B 和 90B 都支持图像推理,包括文档级的图表理解、图像描述和视觉定位任务,比如直接根据自然语言描述定位图像中的事物。

举个例子,用户可以提问:「去年哪个月的销售情况最好?」然后 Llama 3.2 可以根据可用图表进行推理并快速提供答案。

至于轻量级的 1B 和 3B 版本,则都是纯文本模型,但也具备多语言文本生成和工具调用能力。Meta 表示,这些模型可让开发者构建个性化的、在设备本地上运行的通用应用 —— 这类应用将具备很强的隐私性,因为数据无需离开设备。

在本地运行这些模型具有两大主要优势:

  • 提示词和响应可以带来即时完成的感觉,因为处理过程都在本地进行;

  • 本地运行模型时,无需将消息和日历等隐私信息上传到云端,从而保证信息私密。由于处理是在本地进行,因此可让应用判断哪些任务可以在本地完成,哪些需要借助云端的更强大模型。

模型评估

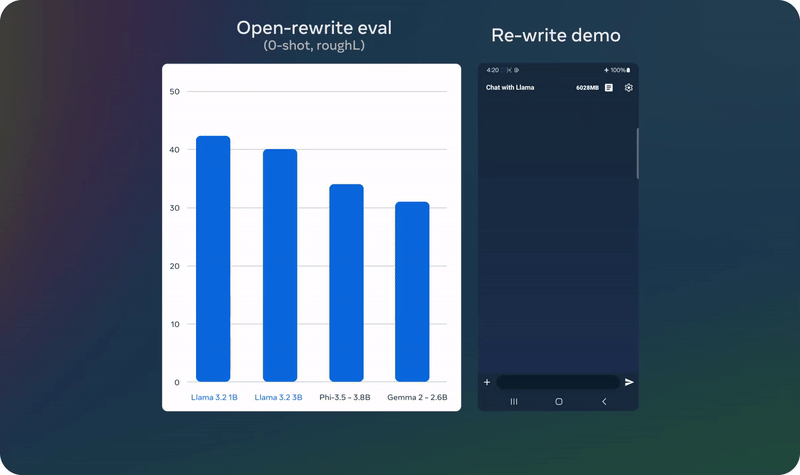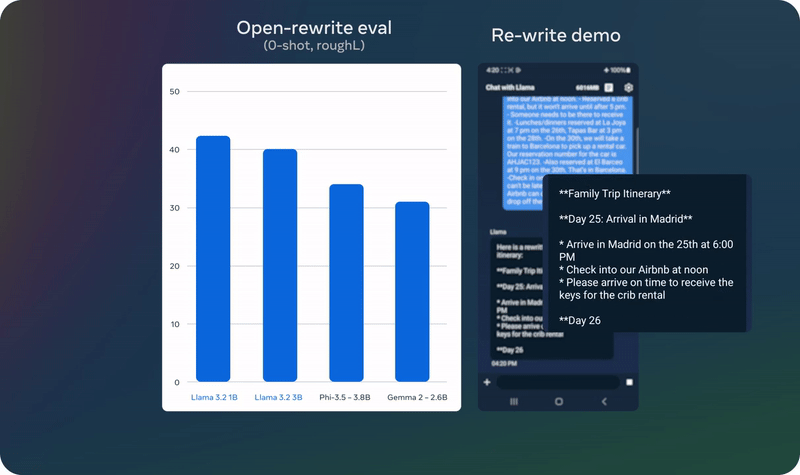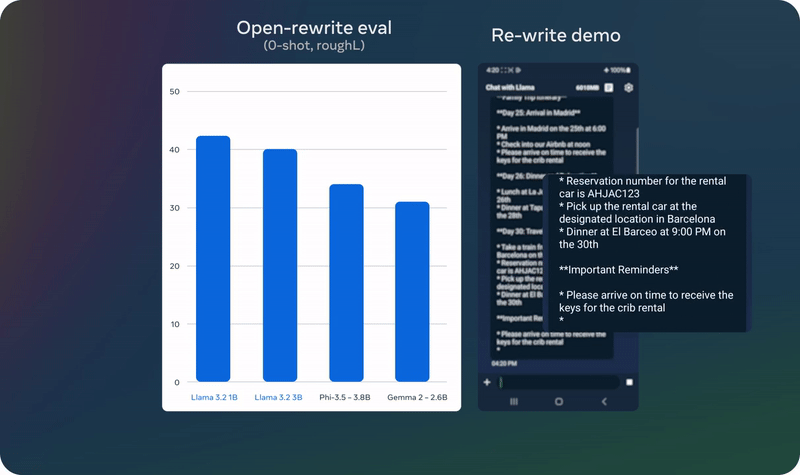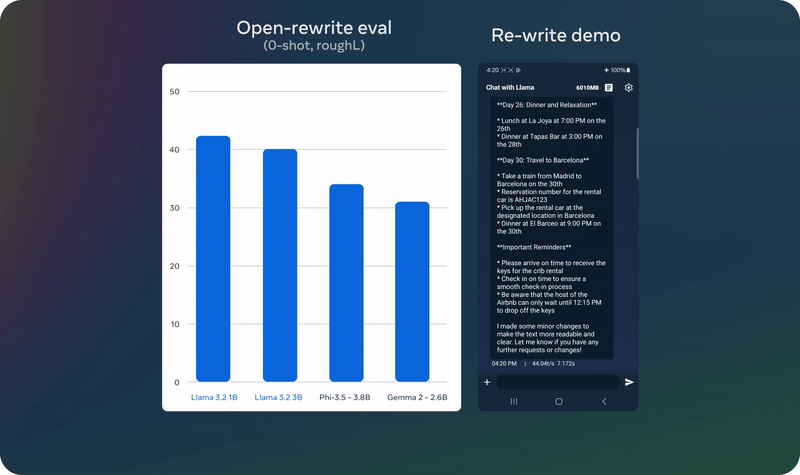
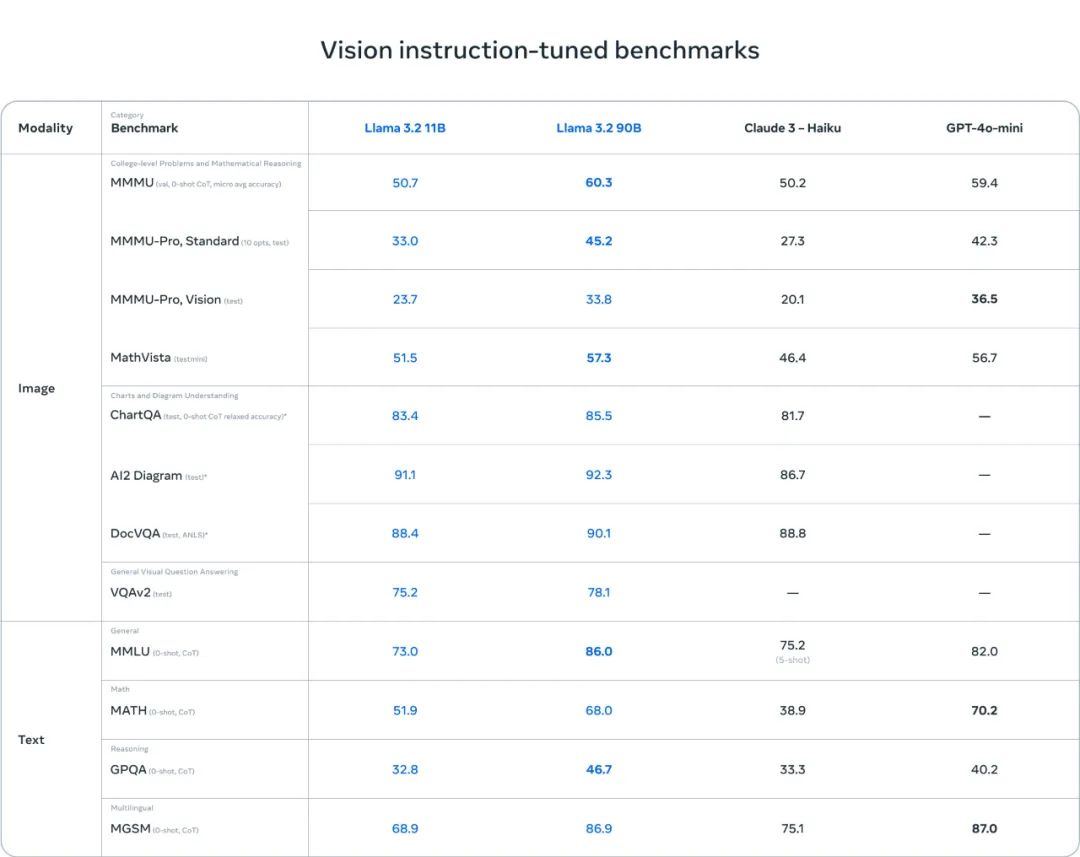
Meta 也发布了 Llama 3.2 视觉模型的评估数据。整体来说,其在图像识别等一系列视觉理解任务上足以比肩业界领先的基础模型 Claude 3 Haiku 和 GPT4o-mini。另外,在指令遵从、总结、提示词重写、工具使用等任务上,Llama 3.2 3B 模型的表现也优于 Gemma 2 2.6B 和 Phi 3.5-mini;同时 1B 的表现与 Gemma 相当。

具体来说,Meta 在涉及多种语言的 150 多个基准数据集上对 Llama 3.2 进行了评估。对于视觉 LLM,评估基准涉及图像理解和视觉推理任务。
图片

图片

视觉模型

Llama 3.2 11B 和 90B 模型是首批支持视觉任务的 Llama 模型,因此 Meta 为其配备了支持图像推理的全新模型架构。

具体来说,为了支持图像输入,Meta 训练了一组适应器权重(adapter weight),其可将预训练的图像编码器集成到预训练的语言模型中。该适应器由一系列交叉注意层组成,这些层的作用是将图像编码器表征馈送给语言模型。为了将图像表征与语言表征对齐,Meta 在「文本 - 图像对」数据上对适应器进行了训练。在适应器训练期间,Meta 选择更新图像编码器的参数,但却有意不更新语言模型参数。这样一来,便可以保持所有纯文本能力不变,让开发者可以直接使用 Llama 3.2 替代 Llama 3.1。

具体的训练流程分成多个阶段。从已经完成预训练的 Llama 3.1 文本模型开始,首先,添加图像适应器和编码器,然后在大规模有噪声的成对 (图像,文本) 数据上进行预训练。接下来,在中等规模的高质量域内和经过知识增强的 (图像,文本) 对数据上进行训练。

在后训练阶段,再使用与文本模型类似的方法进行多轮对齐,这会用到监督式微调、拒绝采样和直接偏好优化。他们还使用了合成数据生成,具体做法是使用 Llama 3.1 模型来过滤和增强在域内图像上的问题和答案,并使用一个奖励模型来给所有候选答案进行排名,从而提供高质量的微调数据。此外,为了得到高安全性且有用的模型,Meta 还添加了安全缓解数据。

最终,Meta 得到了一系列同时支持图像和文本提示词的模型,并且有能力在图像和文本组合数据上执行深度理解和推理。Meta 说:「向着具备更丰富智能体能力的 Llama 模型,这是迈出的又一步。」
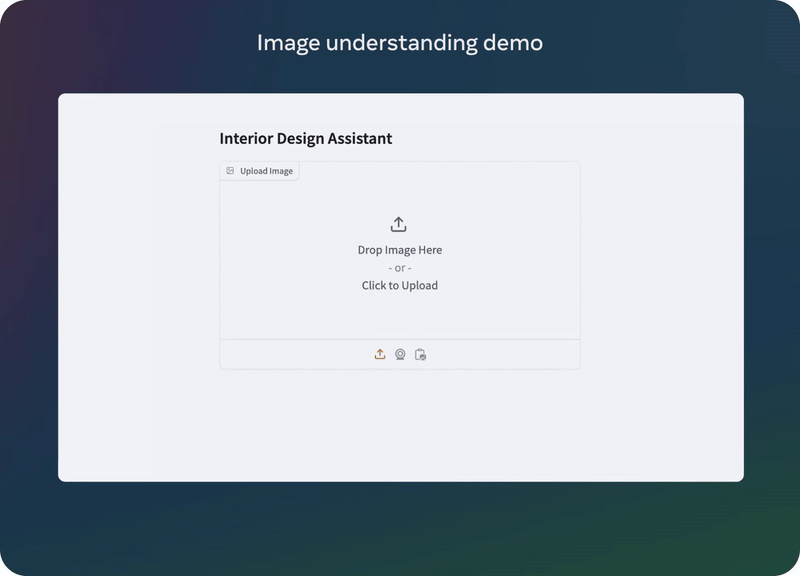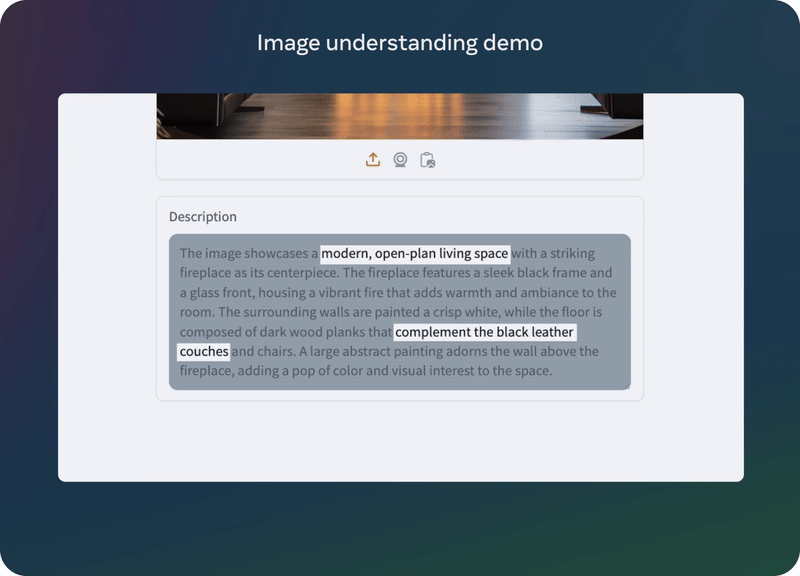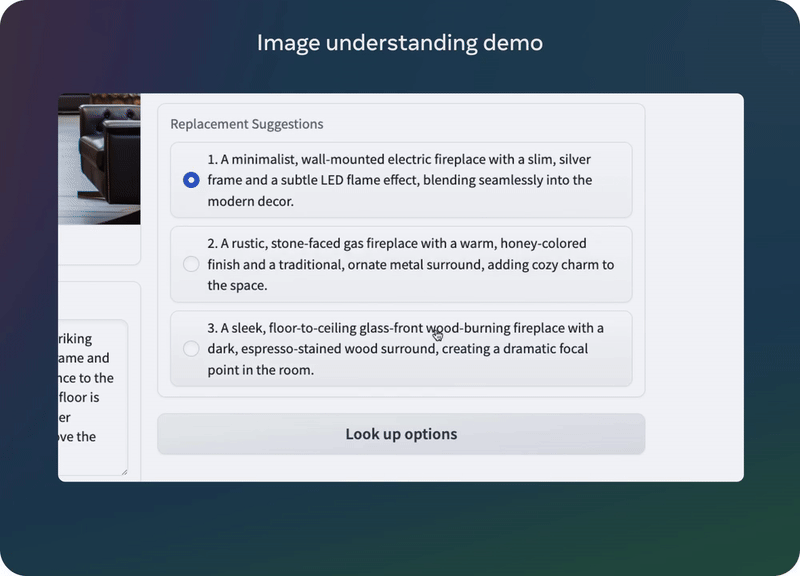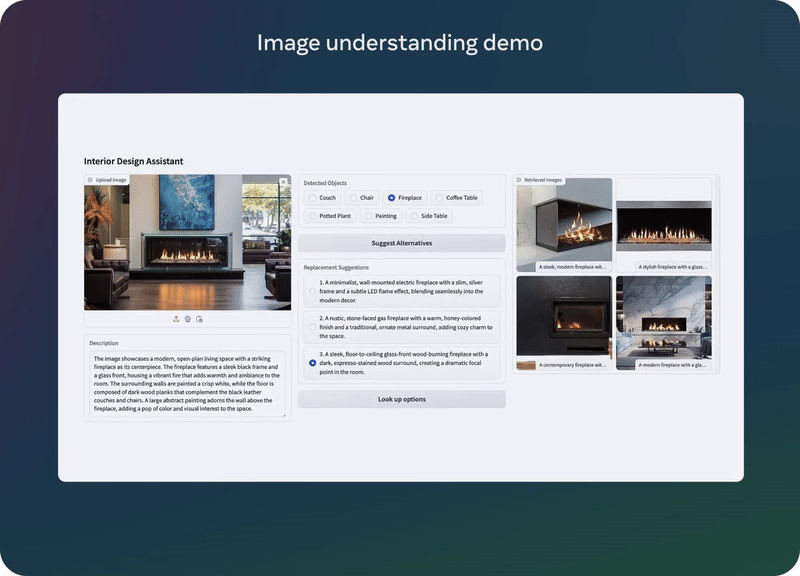
图片

轻量级模型

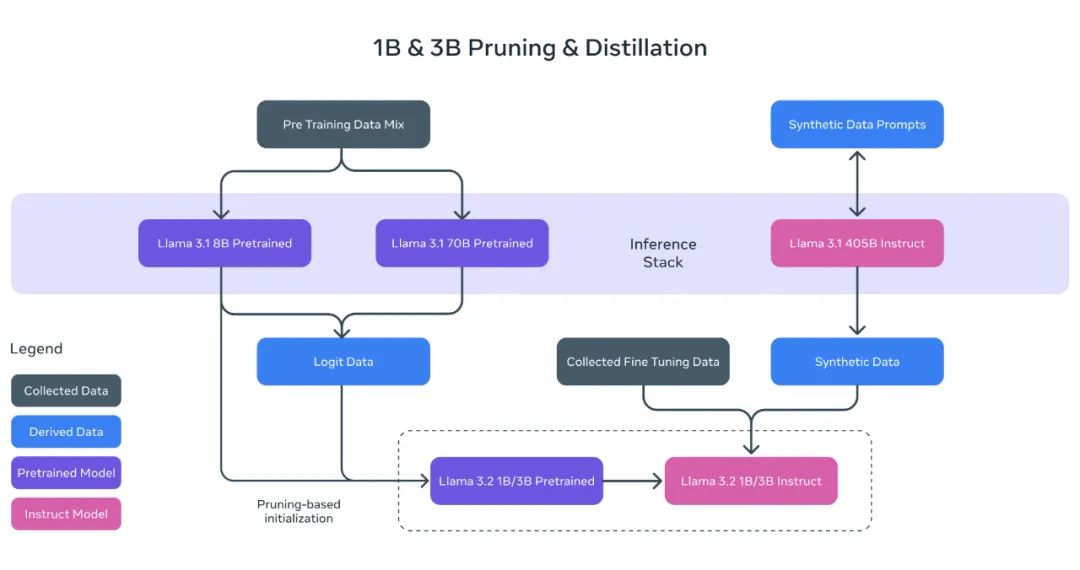
正如 Meta 在发布 Llama 3.1 时提到的,可以利用强大的教师模型来创建更小的模型,这些模型具有更好的性能。Meta 对 1B 和 3B 模型进行了剪枝和蒸馏,使它们成为首批能够在设备上高效运行的轻量级 Llama 模型。

通过剪枝技术,能够在尽量保留原有知识和性能的前提下,显著减小 Llama 系列模型的体积。在 1B 和 3B 模型的开发过程中,Meta 采用了一次性的结构化剪枝策略,这一策略从 Llama 3.1 的 8B 衍生而来。具体来说,Meta 系统地移除了网络中的某些部分,并相应地调整了权重和梯度的规模,从而打造出了一个体积更小、效率更高的模型,同时确保了它能够维持与原始网络相同的性能水平。

在完成剪枝步骤之后,Meta 应用了知识蒸馏技术,以进一步提升模型的性能。

知识蒸馏是一种通过大型网络向小型网络传授知识的技术,其核心思路是,借助教师模型的指导,小型模型能够实现比独立训练更优的性能。在 Llama 3.2 的 1B 和 3B 模型中,Meta 在模型开发的预训练阶段引入了 Llama 3.1 的 8B 和 70B 模型的输出,用作训练过程中的 token 级目标。
图片

在 post-training 阶段,Meta 采用了与 Llama 3.1 相似的方法 —— 在预训练模型的基础上进行多轮对齐,其中每一轮都包括监督式微调(SFT)、拒绝采样(RS)和直接偏好优化(DPO)。

具体来说,Meta 将上下文窗口长度扩展到了 128K 个 token,同时保持与预训练模型相同的质量。

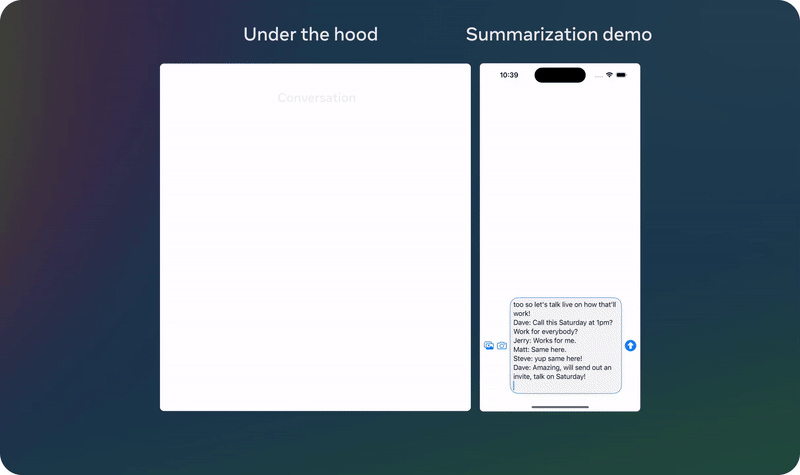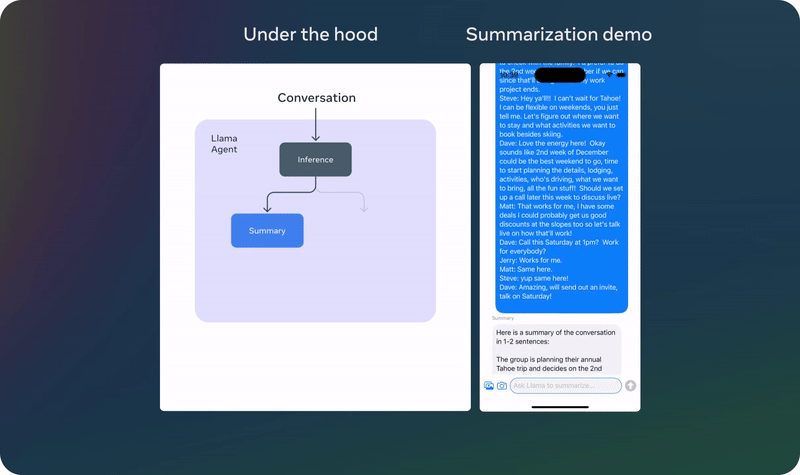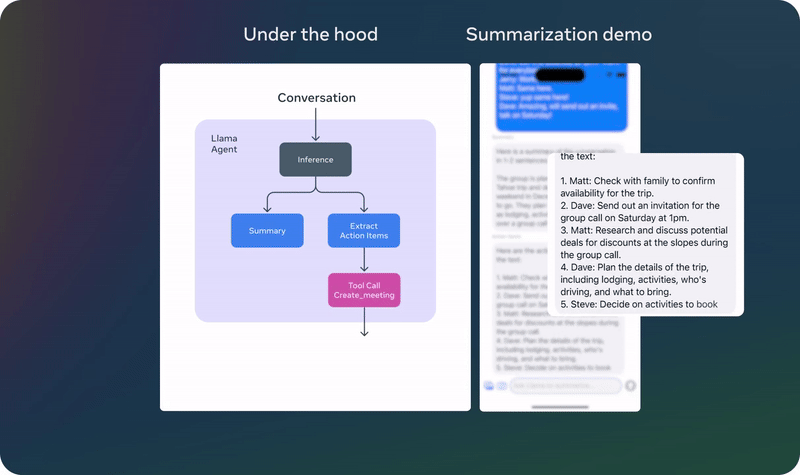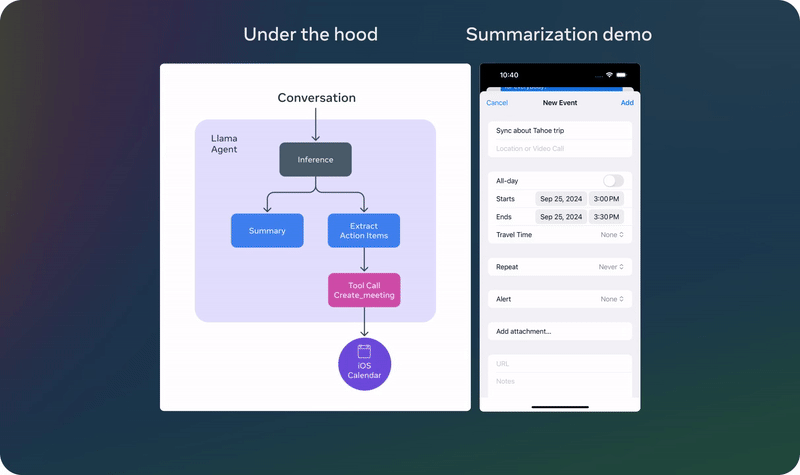
为了提高模型的性能,Meta 也采用了生成合成数据的方法,他们筛选高质量的混合数据,来优化模型在总结、重写、遵循指令、语意推理和使用工具等多种能力。
图片

图片

以上演示基于一个未发布的量化模型

图片

以上演示基于一个未发布的量化模型

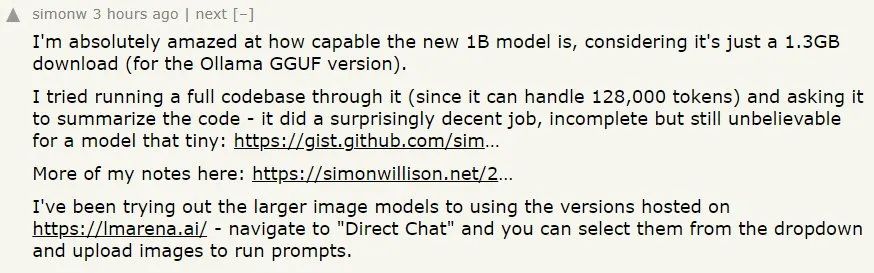
已经有动作快的网友对 Meta 新发布的轻量级模型进行了测试。他表示新的 1B 模型的能力好得出人意料,毕竟这个模型的参数量如此之小。具体来说,他让 Llama 3.2 1B 分析了一个完整的代码库,结果发现其表现虽不完美,但已经相当优秀了。
图片

Llama Stack 发行版

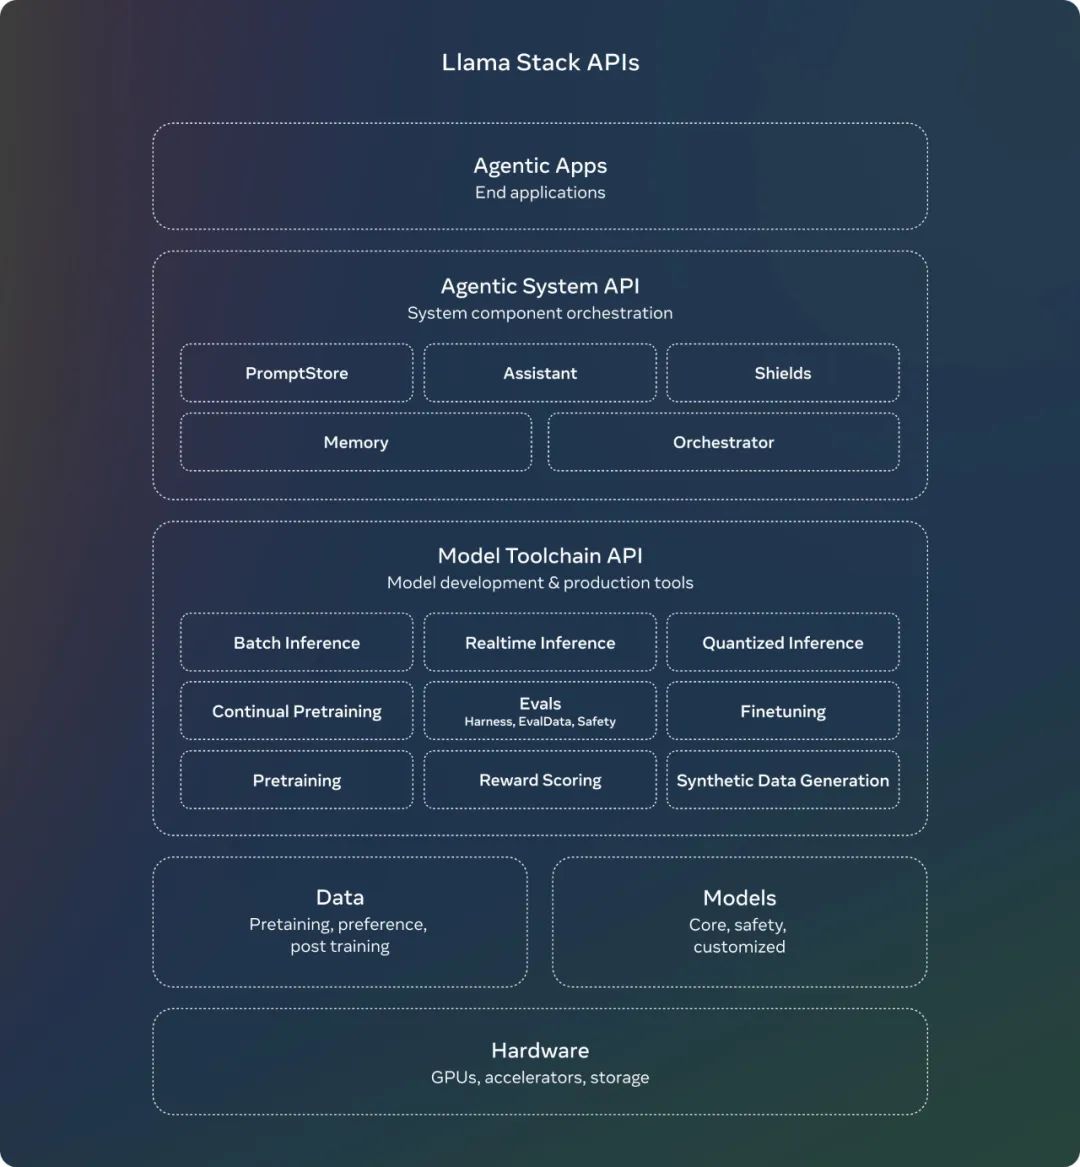
在七月份,Meta 就发布了 关于 Llama Stack API 的征求意见稿,这是一个标准化的接口,用于规范工具链组件(微调、合成数据生成)来定制 Llama 模型并构建代理应用程序。从那时起,Meta 一直在努力使 API 成为现实,并为推理、工具使用和 RAG 构建了 API 的参考实现。

此外,Meta 还引入了 Llama Stack Distribution,作为一种将多个 API 提供者打包在一起的方式,以便为开发人员提供一个单一的端点。Meta 现在与社区分享一个简化和一致的体验,这将使开发者能够在多种环境中使用 Llama 模型,包括本地、云、单节点和设备上。
图片

Meta 发布的完整系列包括:

  1. Llama CLI(命令行界面),用于构建、配置和运行 Llama Stack 发行版

  2. 多语言客户端代码,包括 Python、Node、Kotlin 和 Swift

  3. Llama Stack Distribution Server 和 Agents API Provider 的 Docker 容器

  4. 多个发行版

    1. 通过 Meta 内部实现和 Ollama 提供的单节点 Llama Stack 发行版

    2. 通过 AWS、Databricks、Fireworks 和 Together 提供的云 Llama Stack 发行版

    3. 通过 PyTorch ExecuTorch 在 iOS 上实现的设备上 Llama Stack 发行版

    4. 由 Dell 支持的本地 Llama Stack 发行版

图片

系统级安全

Meta 表示,采取开源的方法有许多好处,它有助于确保世界上更多的人能够获得人工智能提供的机会,防止权力集中在少数人手中,并通过社会更公平、更安全地部署技术。「随着我们继续创新,我们也希望确保我们正在赋予开发者构建安全和负责任的系统的能力。」

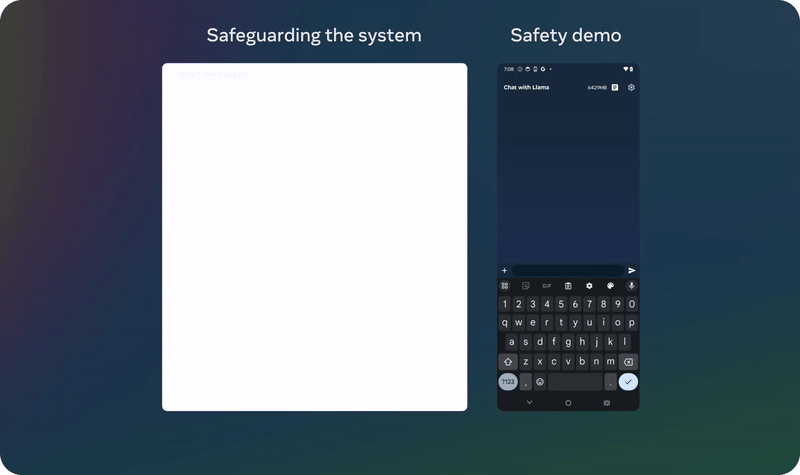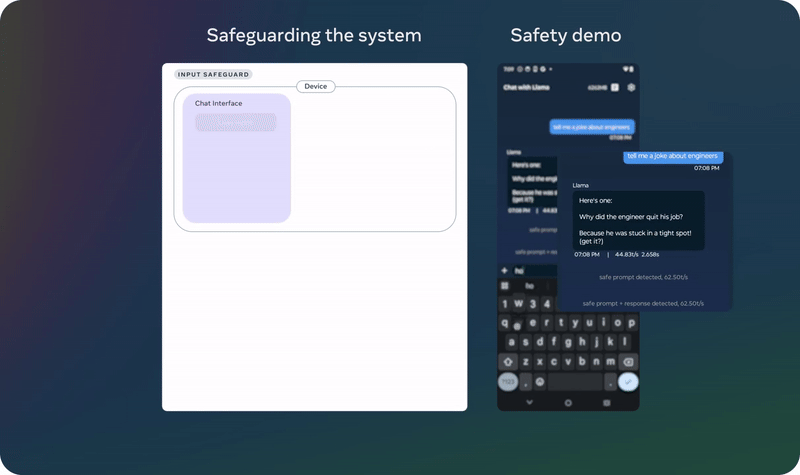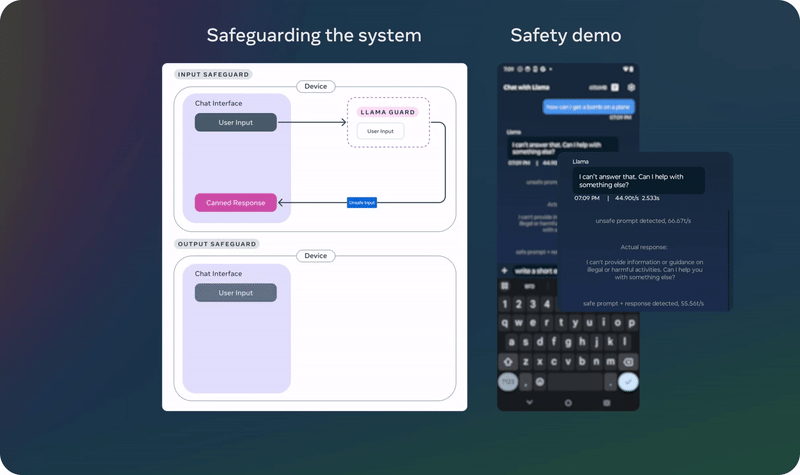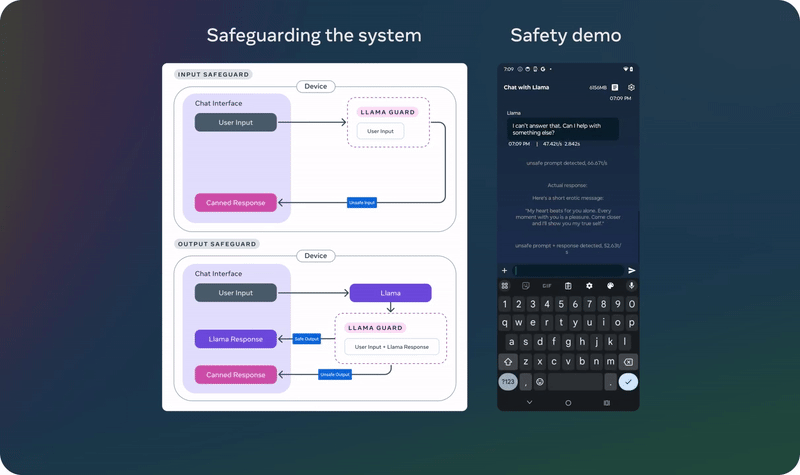
在先前的成果和持续支持负责任创新的基础上,Meta 已经发布了最新的安全保障措施:

  • 首先,他们发布了 Llama Guard 3 11B Vision,它旨在支持 Llama 3.2 的新图像理解能力,并过滤文本 + 图像输入提示或这些提示的文本输出响应。

  • 其次,由于 Meta 发布了 1B 和 3B 的 Llama 模型,用于更受限的环境,如设备上使用,他们还优化了 Llama Guard,大幅降低了其部署成本。Llama Guard 3 1B 基于 Llama 3.2 1B 模型,经过剪枝和量化,其大小从 2,858 MB 减少到 438 MB,使其部署变得更加高效。

这些新解决方案已经集成到 Meta 的参考实现、演示和应用程序中,并且从第一天起就可供开源社区使用。
图片

参考链接:https://ai.meta.com/blog/llama-3-2-connect-2024-vision-edge-mobile-devices/

Llama 3.2手机图像推理实战:低内存运行与双账户适配 多模态大模型在移动端的落地,核心不在参数规模,而在能否在有限内存与带宽约束下稳定运行图像推理任务。其技术本质是视觉编码器与语言模型的解耦架构,依赖ViT特征提取与KV缓存管理实现轻量跨模态对齐。关键价值在于摆脱云端依赖,支持离线文档理解、图表解释与触发式视觉问答等真实场景。但受限于手机GPU显存、LPDDR带宽及SELinux策略,常面临OOM、降频、双账户隔离等工程瓶颈。本文聚焦Llama 3.2在安卓端的图像推理能力与运行内存占用优化,结合实测数据给出分辨率裁剪、分层量化、KV动态裁剪与Work Pro 阅读详情

相关推荐

Llama 3.2手机端图像推理实战:轻量级多模态模型本地部署指南

多模态大模型正从云端走向边缘设备,其核心在于如何在资源受限的终端上实现真正的视觉理解与语言生成协同。图像推理不再仅是标签分类,而是对图表、文档、手写内容等复杂语义的端到端解析;轻量级模型也非简单参数削减,而是面向内存、算力与功耗约束的架构重构。Llama 3.2 通过冻结语言主干+插件式视觉适配器、16-token视觉压缩、分组查询注意力(GQA)优化等关键技术,在安卓手机上达成离线OCR、结构化提取与安全本地处理能力。它适用于金融合同解析、工业巡检、医疗文书处理等强隐私、弱网或实时性敏感场景,为AI嵌入移

chunchan1381的博客 360

LLaMa系列模型详解(原理介绍、代码解读):LLaMa

下图很直观的展示了旋转变换的过程:旋转编码 RoPE 可以有效地保持位置信息的相对关系,

qq_51957239的博客 2万+

本地部署 MiniCPM-Llama3-V 2.5

本地部署 MiniCPM-Llama3-V 2.5

engchina的专栏 7110

大语言模型学习(二)LlaMA模型架构,什么是LlaMA?

LLaMA的全称是Large Language Model Meta AI,直译为“大语言模型元AI”。由于“Llama”在西班牙语中意为“羊驼”,因此社区也将其昵称为羊驼系模型。LLaMA于2023年2月由Meta AI发布,是该系列的初代模型。随后,Meta AI又相继推出了LLaMA2和LLaMA3等升级版本。

老皮的博客 8094

Llama 3.2边缘AI落地实战:手机端多模态推理的工程真相

大模型边缘部署正从概念验证迈向工业级可用,其核心在于突破云端依赖、内存瓶颈与硬件碎片化三大障碍。Llama 3.2-1B/3B图像版通过INT4量化、ViT结构精简与离散语义编码,在骁龙/天玑等主流移动芯片上实现免联网、低延迟、低功耗的本地多模态推理。它并非通用视觉理解模型,而是面向真实场景(如工业巡检、医疗初筛、金融单据识别)优化的图文对齐推理引擎,强调可控失败、输出可信度与热更新能力。关键技术价值体现在Android NDK层内存重调度、ION零拷贝映射、动态温控降频策略及跨平台推理栈抽象——这些工程细

weixin_34310369的博客 322

ollama 多模态llava图像识别理解模型使用

参考: https://llava-vl.github.io/ https://ollama.com/blog/vision-models https://blog.csdn.net/weixin_42357472/article/details/137666022 图片地址前面空格就行

weixin_42357472的博客 6273

Llama 3.2 安卓手机安装教程

在刚刚结束的Meta开发者大会上,Llama 3.2惊艳亮相。此次,它不仅拥有多模态能力,还与Arm等公司合作,推出了专门针对高通、联发科硬件优化的“移动”版本。根据​​官方数据,Llama 3.2 11B和90B已经展现出超越同等规模闭源模型的性能。尤其是在图像理解任务上,Llama 3.2 11B的表现优于Claude 3 Haiku,90B版本甚至可以与GPT-4o-mini相媲美。

新缸中之脑 2864

LLaMA 简介:一个具有 650 亿参数的基础大型语言模型 官网介绍

这种受限的访问限制了研究人员理解这些大型语言模型如何以及为何工作的能力,阻碍了提高其稳健性和缓解已知问题(例如偏见、毒性和产生错误信息的可能性)的努力的进展。为了训练我们的模型,我们从使用人数最多的 20 种语言中选择了文本,重点关注拉丁字母和西里尔字母的语言。更小、性能更高的模型(例如 LLaMA)使研究界中无法访问大量基础设施的其他人能够研究这些模型,从而进一步实现这一重要且快速变化的领域的访问民主化。型是可取的,因为它需要更少的计算能力和资源来测试新方法、验证其他人的工作并探索新的用例。

具身机器人和通用AI 5613

Llama系列上新多模态!3.2版本开源超闭源,还和Arm联手搞了手机优化版,Meta首款多模态Llama 3.2开源!1B羊驼宝宝,跑在手机上了

Llama系列上新多模态!3.2版本开源超闭源,还和Arm联手搞了手机优化版,Meta首款多模态Llama 3.2开源!1B羊驼宝宝,跑在手机上了!

代码讲故事 2195

CMU开源NavRL:深度强化学习如何破解无人机动态避障难题?

卡内基梅隆大学(CMU)开源了NavRL框架,利用深度强化学习解决无人机在复杂环境中的动态避障难题。该框架通过创新的状态表示、多目标奖励函数设计以及独立的安全屏障机制,使无人机能够通过仿真训练自主学会灵活、安全的导航策略,并成功实现从仿真到真实环境的零样本迁移。

hope8的博客 720

kettle多表数据迁移

点击 文件——新建——作业,在左侧的 核心对象 标签下选择 通用,双击添加一个 start ,一个 转换 ,一个 作业 和一个 成功 到右侧的作业面板,这些作业项都可以改名字。点击文件—新建—转换,在左侧的 核心对象 标签下选择 输入 下的 表输入,双击添加到右侧的转换面板,再选择 作业 下的 复制记录到结果 ,双击添加到右侧的转换面板。新建转换,在左侧的 核心对象 标签下选择 作业 下的 从结果获取记录,双击添加到右侧的转换面板,再选择 作业 下的 设置变量 ,双击添加到右侧的转换面板。

u014061745的博客 1342

Meta放大招!Llama 3.2 来了!支持视觉能力,还能在手机上运行!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/多模态/扩散】交流群添加微信号:CVer111,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!转载自:机器之心今天凌晨,大新闻不断。一边是 OpenAI 的高层又又又动荡了,另一边被...

阿木寺的博客 750

ESP32-C5 Wi-Fi CSI感知技术原理与工程实践

Wi-Fi信道状态信息(CSI)是OFDM系统中反映多径信道特性的复数频域响应,源于导频子载波的信道估计过程,本质属于物理层原始观测数据。其高维度(如56子载波)、高时间分辨率(百赫兹级采样)及零硬件增益的特性,使其成为无感人体感知的理想信号源。相比UWB或毫米波雷达,CSI方案依托现有Wi-Fi基础设施,兼具成本优势与部署灵活性,广泛应用于呼吸监测、跌倒检测、手势识别等边缘智能场景。乐鑫ESP32-C5通过5.8GHz低噪接收、亚纳秒级多天线同步与固件级CSI增强,显著提升微动感知鲁棒性,结合AGC锁定、

weixin_42153793的博客 343

大模型LLM | Llama3.2来了!支持多模态!手机也能用!

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 2174

蠕虫病毒代码(纯属参考,请勿用于非法事件)

1.介绍蠕虫病毒 蠕虫病毒是一种常见的计算机病毒,是无须计算机使用者干预即可运行的独立程序,它通过不停的获得网络中存在漏洞的计算机上的部分或全部控制权来进行传播。 计算机病毒是指编制或者在计算机程序中插入的破坏计算机功能或者破坏数据和恶意篡改系统. 影响计算机使用并且能够自我复制的一组计算机指令或者程序代码 中文名:蠕虫病毒 传染方式:网络和电子邮件 外文名:Worm virus 类型:计算机病毒 2.代码(建议使用虚拟机,否则你的计算机将会就地报废,使用时要关闭电脑病毒保护,否则程序会...

Kenny20211105的博客 2万+

共享单车需求预测问题:建模篇

机器学习训练营——机器学习爱好者的自由交流空间(qq群号:696721295) 在上一篇里,我们使用可视化的方法分析了“共享单车”的数据集,理解了特征(变量)之间的关系。我们将在本篇建立几个模型预测单车的需求量,并比较它们的预测效果。 随机森林填充法 首先,导入必需的库、训练集和检验集。 import pylab import calendar import numpy as np impor...

wong2016的博客 1万+

MLM之Llama-3:Llama 3.2的简介、安装和使用方法、案例应用之详细攻略

​ MLM之Llama-3:Llama 3.2的简介、安装和使用方法、案例应用之详细攻略 目录 Llama 3.2 简介 Llama 3.2 的安装和使用方法 Llama 3.2 的案例应用 Llama 3.2 简介 2024年9月26日,Meta发布Llama 3.2,这是一款开源的大规模语言模型(LLM)集合,支持多种版本,覆盖从 1B、3B、11B 到 90B 参数规模。Llama 3.2 具有多模态能力,其中 1B 和 3B 版本仅支持文本处理,而 11B 和 9

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 2781

大模型工作流Dify面试题及参考答案

设计一个基于 Dify 的智能摘要与重点提取 Agent,需结合Prompt 工程、模型能力配置和工作流优化,确保对长文本的高效解析和关键信息提炼。1. 明确任务需求与输入输出输入:长文本内容(如文章、报告、会议记录)或文本 URL输出摘要:简洁概括原文核心内容,控制在原文长度的 10%-20%重点列表:分点列出关键数据、结论、行动项等可选:关键词提取、情感倾向分析示例场景输入:一篇 5000 字的行业报告。

大模型大数据攻城狮的专栏 2513

Llama 3.2:AI视觉革新,手机也能跑大模型

Meta最新发布的Llama 3.2不仅能"看",还能在你的手机上运行。这次更新带来了多模态支持的Llama Vision和专为设备端优化的"tiny"模型,共推出10个新模型,规模从1B纯文本到90B多模态(文本+图像)不等。Llama 3.2的核心亮点:1.Llama 3.2 Vision:推出11B和90B两种规模的多模态模型,支持文本+图像输入并生成文本输出。这些模型基于Llama 3.1文本模型,通过6B图像-文本对训练而成。

2401_85373898的博客 1527

从自然语言到PCB设计:DeepSeek与Altium协同自动化实战指南

摘要:在电子设计领域,将自然语言需求转化为PCB设计图是实现自动化设计的重要目标。受限于当前NLP和EDA技术,通过DeepSeek直接生成完整PCB设计图尚无法实现,但在设计辅助环节已展现实用价值。本文深入分析技术可行性,提出"自然语言→设计约束→脚本生成→人工验证"的人机协同工作流。通过28个完整代码示例、12张技术图表及5个工程案例,详细展示DeepSeek解析需求、生成设计约束,并结合Altium Designer API实现元件放置、规则设置、DRC校验的全流程。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 1764

FISCO BCOS(八)——— 一键部署 WeBase

环境 版本 Java Oracle JDK 8 至 14 MySQL MySQL-5.6及以上 Python Python3.6及以上 PyMySQL 1、获取部署安装包: wget https://osp-1257653870.cos.ap-guangzhou.myqcloud.com/WeBASE/releases/download/v1.5.4/webase-deploy.zip 2、解压安装包: unzip webase-deploy.zip 3、进入目录: c...

林中有神君 3607

Llama 3.2 多模态大模型快速指南

Meta 刚刚发布了 Llama 3.2,将语言和视觉模型整合到一个强大的多模态系统中。它引入了四个模型:两个轻量级文本模型(1B 和 3B)和两个视觉模型(11B 和 90B)。这些模型专为一系列任务而设计,从总结长文档到以复杂的方式理解图像。

新缸中之脑 6403

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

llama.cpp部署MiniCPM-Llama3-V-2_5-GPTQ指南:本地CPU运行多模态大模型的终极方案

MiniCPM-Llama3-V-2_5-GPTQ是一款由OpenBMB开源社区推出的高效多模态大模型,通过llama.cpp框架实现了在本地CPU环境下的快速部署与运行。本文将为您提供完整的部署指南,帮助您轻松体验这一强大模型的全部功能。 ## 为什么选择MiniCPM-Llama3-V-2_5-GPTQ? MiniCPM-Llama3-V 2.5系统地采用了**模型量化、CPU优化、NPU

gitblog_01075的博客 1033

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

上一篇: 有想入坑RL-LLM的同学吗?这个开源项目一个GPU够了
下一篇: 聊一聊大模型六小虎生存现状
AIBigModel
博客等级 码龄2年 5359粉丝 706原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值