Spark core 原理(一)

CANoe LIN一致性测试之干扰测试Test moudle_LIN Disturbance Block 注意:相邻两个显隐性不同的bit不允许干扰,例如我同时选择bit6和bit7,相邻两个同显隐性的bit允许干扰,例如当我选择bit3和bit4,项,这里我选择ID:为0x2F(PID:0x6F)的frame。需按照具体测试规范实施干扰项,帧头和数据段都可以实现干扰。最近发现一个干扰测试模块,下面是一些具体使用方法。选择干扰项:PID的奇偶校验位(一致性测试干扰测试之手动测试。一个待测试frameD。 阅读详情

Spark core 原理

1.弹性分布式数据集(RDD)

1.1概念

数据集:需要运算的数据集合
分布式的:
Spark加载的数据都是以分区的形式存储在各个节点上的,各个节点的分区组合在一起就是一个RDD,所以它是分布式的。
基于内存的(弹性的):
Spark在进行数据的转换或者计算的时候都是在内存中完成的,如果内存资源不够的话 ,那么它就会在磁盘中进行计算。
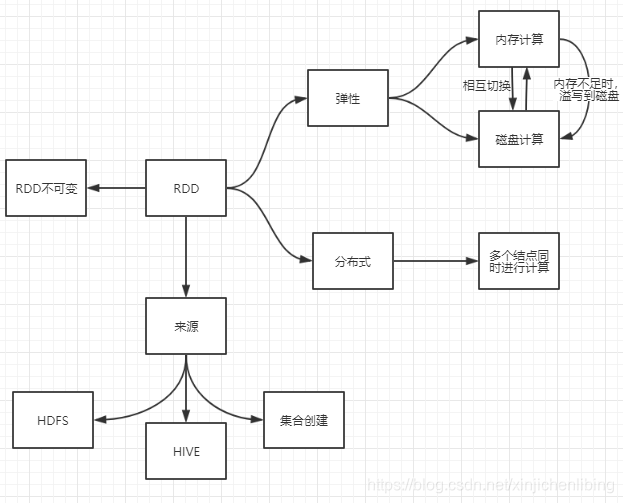
在这里插入图片描述

1.2程序解析

程序代码

package com.terry.sparkcore
import org.apache.spark.{SparkConf, SparkContext}

object WorldCount {
  def main(args: Array[String]): Unit = {
    val conf = new SparkConf()
      .setAppName("WorldCount")
      .setMaster("local[4]")
    val sc = new SparkContext(conf)
    val filePath="C:/Users/wwlh/Desktop/gitTest/window/test.java"
    val fileRdd = sc.textFile(filePath,4)
    val words = fileRdd.flatMap(lines => lines.split(" ")).filter(word => word!=" ")
    val wordcount = words.map(x=>(x,1)).reduceByKey(_+_)
    wordcount.foreach(x=>{println(x)})
    Thread.sleep(9999999)
    sc.stop()
  }

}

代码工作流程
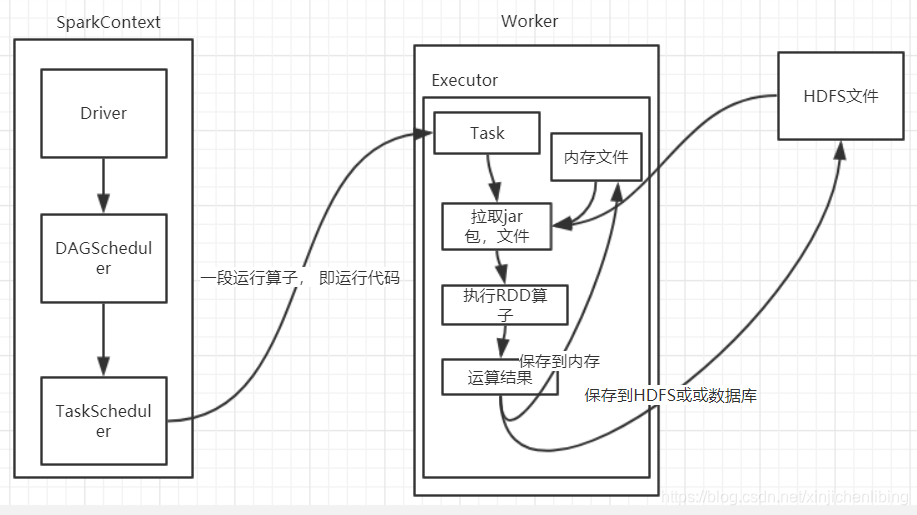
在这里插入图片描述

RDD执行流程
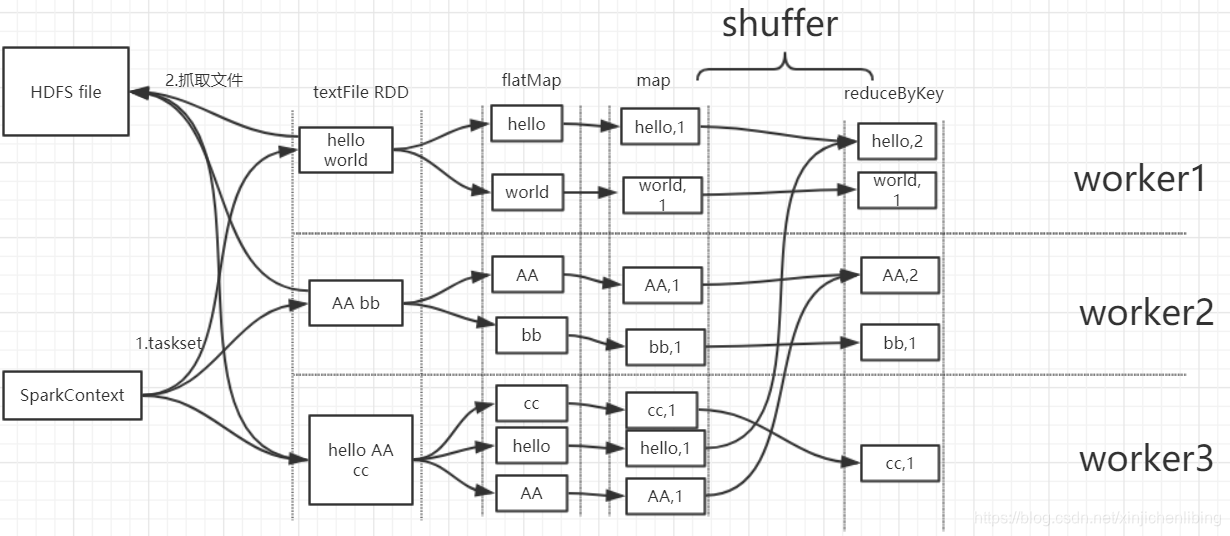
在这里插入图片描述

RDD流程解析

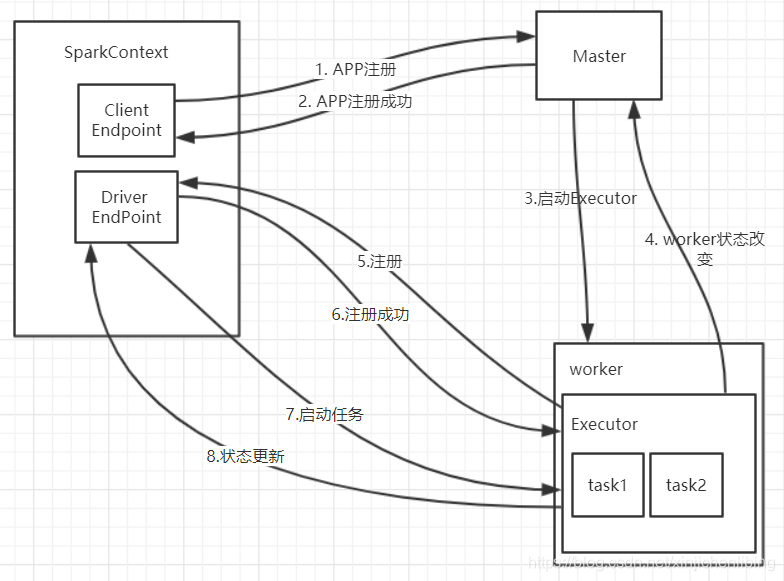
在这里插入图片描述
sparkContext的整个启动过程

sparkContext的整个启动过程

芒果YOLOv12改进108:基于QARep提出多种<独家原创结构>:ReNLANQARep, QARep, CSCQARep, C3QARep, C2fQARep等,即插即用提升小目标检测 阅读详情

相关推荐

用Python实现四叉树(quad tree)

import numpy as np #正方形类 class square: #lx、ly为左上角坐标(x对应行号,y对应列号),rx、ry为右下角坐标 def __init__(self,lx,ly,rx,ry): self.lx=lx self.ly=ly self.rx=rx self.ry=ry #检查该矩阵中是否满足条件 #参数:原矩阵,阈值 #返回值:布尔类型 def check(s

weixin_44164489的博客 5868

Spark-core(内核原理):你知道它是如何运行的吗?

Spark-core内核原理,Spark scheduler,Spark scheduler类型,Spark scheduler运行流程,RDD依赖/容错机制,宽依赖和窄依赖,为什么要区分宽窄依赖,DAG和Stage,Spark DAG的开始和结束,为什么需要划分Stage?Spark中的基本名词,Job调度流程及Web----UI界面查看

Maverick_曲流觞的博客 554

TensorFlow_PyTorch实战:构建AI人工智能回归模型

回归分析是机器学习的核心任务之一,用于预测连续型目标变量(如房价、股票价格、用户留存时间等)。基础线性回归模型的数学原理与代码实现多项式回归模型的过拟合处理与正则化技巧自定义数据集加载与数据预处理流程动态图(PyTorch)与静态图(TensorFlow)的编程范式对比模型评估指标与可视化分析方法核心概念:对比两大框架的架构设计,解析回归模型核心组件数学原理:推导线性回归的假设函数、损失函数及优化算法算法实现:提供TensorFlow和PyTorch的完整代码示例项目实战。

AI天才研究院 1430

Spark-core 运行原理

架构图在此Spark Core部件解析 应用程序(Application): 基于Spark的用户程序,包含了一个Driver Program 和集群中多个的Executor; 驱动程序(Driver Program): 运行Application的main()函数并且创建 SparkContext. 通常用SparkContext代表Driver Program 执行单元 (Executor):

C_FuL的博客 1285

AI 辅助代码审查:开启代码质量管控的智能时代

AI辅助代码审查正在改变传统的代码质量管控方式。通过自动化分析、智能反馈和上下文感知,AI不仅提高了代码审查的效率,还提升了代码质量的一致性和可维护性。随着机器学习和深度学习技术的不断发展,未来AI将成为开发者日常工作中强大的助手,进一步推动软件开发向智能化、自动化方向发展。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 3229

MySQL常见面试题汇总(建议收藏!!!)

目录一、索引相关(1)什么是索引?(2)索引是个什么样的数据结构呢?(3)为什么使用索引?(4)Innodb为什么要用自增id作为主键?(5)Hash 索引和 B+ 树索引有什么区别或者说优劣呢?(6)什么是聚簇索引(6)非聚簇索引一定会回表查询吗?(6)聚簇索引和非聚簇索引的区别(6)MyISAM和InnoDB实现B+树索引方式的区别是什么?(6)MySQL中有四种索引类型,可以简单说说吗?(6)覆盖索引是什么?(6)联合索引是什么?为什么需要注意联合索引中的顺序?(6)创建的索引有没有被使用到?或者说怎

蔡政洁的博客 7万+

Spark core

1.RDD 特性与核心属性:RDD 是 Spark 中基本的数据处理模型,具有弹性(存储、容错、计算、分片方面)、分布式、数据集、数据抽象、不可变、可分区并行计算等特性。其核心属性包括分区列表用于并行计算、分区计算函数对每个分区进行计算、RDD 之间的依赖关系用于组合计算模型、分区器(可选,用于 K - V 类型数据分区)和首选位置(可选,根据节点状态选择计算位置)。2.核心概念:Executor 是工作节点的 JVM 进程,利用 Core 计算,可配置数量、内存和 CPU 核数。

2401_85482551的博客 1028

《科研伦理与学术规范》 全部 习题_答案 2020年秋

科研伦理与学术规范 答案 文章目录科研伦理与学术规范 答案1. 第一章课后习题(必做) 答案1.1 第一章Demo2. 第二章课后习题(必做) 答案3. 第三章课后习题(必做) 答案4. 第四章课后习题(必做) 答案5. 第五章课后习题(必做) 答案6. 第六章课后习题(必做) 答案 # 每行5题 #写于2020.11.17 侵删 1. 第一章课后习题(必做) 答案 ABC, A, B ,D ,ABCD ABC, D, A, BCD, C D, D, 1.1 第一章Demo

羊老羊 25万+

spark原理解析和spark core

spark原理解析解析一:resilient distributed dataset (RDD)resilient distributed dataset (RDD):弹性分布式数据集,有容错机制可并行执行。分布式即体现在每个rdd分多个partition,每个partition在执行时为一个task,会被master分配到某一个worker执行器(Executor)的某一个core中。弹性体现在...

focuson_的博客 5341

数据挖掘实战-基于情感分析+网络语义分析+LDA主题分析对大唐不夜城用户评论进行文本分析

本研究基于去哪儿网和携程网的1888条大唐不夜城游客评论数据,运用Python进行文本分析。通过情感分析发现游客评价以积极为主(占比约70%),中性占20%,消极占10%。采用ROSTCM6软件进行社会网络语义分析,识别不同情绪下的高频词汇。使用LDA主题模型将评论划分为3个主题(夜景、表演、美食),并分析主题强度随时间变化趋势。实验包含数据采集、预处理、情感分析、语义网络分析和LDA建模等完整流程,为景区管理优化提供数据支持。源代码涵盖爬虫、数据处理和可视化分析的全套实现。

m0_64336780的博客 1万+

ONNX Runtime C# YOLO全链路压测:从300ms到22ms的15个底层优化技巧

摘要:本文分享了工业质检场景下C#调用YOLOv8s ONNX模型的性能优化实战经验。原始单帧推理耗时300ms无法满足产线需求,通过全链路分析定位瓶颈(预处理85ms、推理180ms、后处理30ms)。重点优化措施包括:使用OpenCVSharp CUDA加速预处理(85ms→12ms),开启ONNX Runtime ALL级别图优化,选用TensorRT执行提供程序(180ms→22ms),以及优化内存管理和线程调度。最终实现单帧总耗时22ms±2ms,GPU利用率提升至85%,完整满足产线120块板/

2601_94871597的博客 402

Spark Core(四)基本工作原理、RDD以及其特性、WoldCount程序剖析

Spark基本的工作原理里 分布式的:Spark加载的数据都是以分区的形式存储在各个节点上的,各个节点的分区组合在一起就是一个RDD,所以它是分布式的。 基于内存的:Spark在进行数据的转换或者计算的时候都是在内存中完成的,如果内存资源不够的话 ,那么它就会在磁盘中进行计算。 迭代计算 RDD: RDD是Spark提供的一种核心抽象,全称Resilient Distributed Da...

李玉志的博客 986

基于ESP32的智能无线广播系统开发博客

通过本项目的开发,我们成功地实现了基于ESP32的智能无线广播系统。该系统不仅具备传统广播的功能,还实现了通过Wi-Fi无线传输音频、实时广播和智能控制等多种先进功能。未来,随着技术的进一步发展,我们还可以扩展更多功能,如智能推荐广播内容、支持语音识别和控制等。希望本项目能够为嵌入式开发人员提供一些思路和参考,帮助大家在实际开发中更好地应用ESP32平台,开发出更加智能和实用的无线广播系统。

2201_76125393的博客 423

Spark-core原理初步学习小结[一]

Spark-core原理初步学习小结[一]RDD Objects 阶段RDD的概念DAG Scheduler 阶段切分Stage的标准切分Stage的原因切分Stage后输出TaskScheduler 阶段Work 阶段 RDD Objects 阶段 在这个阶段主要对各个RDD进行构建(对各个规则进行定制,实现完整执行流程),生成DAG(有向无环图) DAG是有边界的:开始(通过SparkCon...

qq_41321219的博客 319

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Spark Core(十五)Executor执行Task的原理与源码分析(一)

Executor执行Task的前期准备: 在我们介绍Executor执行Task之前,先看一个重要的类,它就是CoarseGrainedExecutorBackend类 它创建这个进程的时候会调用onStart方法 它是ExecutorBackend粗粒度进程, 它负责向Driver发送Executor的注册请求 它是一个通信的进程,它可以与Driver相互通信 它是Executor所在的一个...

李玉志的博客 1012

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

深入理解Spark 2.1 Core (一):RDD的原理与源码分析

该论文来自Berkeley实验室,英文标题为:Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing。下面的翻译,我是基于博文http://shiyanjun.cn/archives/744.html翻译基础上进行优化、修改、补充注释和源码分析。如果翻译措辞或逻辑有误...

yang灬仔 757

spark入门学习:简介和基本原理

简介Apache spark是一个围绕速度、易用性和复杂分析构建的大数据计算框架。Scala是函数式语言,适合数据处理编程,并且其运行在 JVM 之上,可利用java生态资源。Akka基于Actor模型,提供了一个用于构建可扩展的(Scalable)、弹性的(Resilient)、快速响应的(Responsive)应用程序...

weixin_40876104的博客 368

spark计算引擎-架构和应用

Spark 是一个开源的分布式计算系统,它提供了一个快速且通用的集群计算平台。Spark 被设计用来处理大规模数据集,并且支持多种数据处理任务,包括批处理、交互式查询、机器学习、图形处理和流处理。

oOBubbleX的博客 1252

Spark

Spark 是一个快速的、通用的集群计算系统,主要用于大规模数据处理。它最早由加州大学伯克利分校的AMPLab开发,并于2010年开源,后来由Apache软件基金会管理。

Casual_Lei的博客 1104

spark12.6

什么是spark spark是一种通用的大数据计算框架 spark包含了 spark core用于离线计算 spark sql用于交互式查询 spark streaming用于实时流式计算 spark mllib机器学习 spark graphx用于图计算 Spark基本工作原理 1分布式 2 主要基于内存(少数情况基于磁盘)3迭代时计算 说明:spark on yarn

cxy 519

《图解 Spark:核心技术与案例实战》核心内容详解

图解 Spark:核心技术与案例实战》由郭景瞻撰写,电子工业出版社出版,是一本的 Spark 技术专著。全书基于 Spark 主流 2.x 系列版本(兼容 3.x 核心特性),完整覆盖 Spark 底层架构、核心运行原理、四大主流组件应用流程,配套 4 类互联网大数据核心业务场景的可复现实战案例,将分布式计算抽象逻辑转化为直观的架构图、交互流程图、步骤分解图,平衡理论深度与工程落地能力,是国内大数据领域从 Spark 基础学习到生产落地的代表性技术读物。

hopsky的博客 212

ROBIN图理论配准算法详解:KISS-Matcher如何用最大核心(Max-Core)剔除99%离群点对

**KISS-Matcher** 是 MIT-SPARK 开源的快速、鲁棒、可扩展的**点云配准**库,支持 C++、Python 和 ROS2。它的离群点剔除核心是 **ROBIN 图理论算法**:通过"距离不变量图"和**最大核心(Max-Core)**分解,自动剔除高达 99% 的错配点对,让配准器在低重叠、高噪声场景下依然稳定收敛。本文带你从零读懂这套机制的原理与源码实现。 ## 一、问

gitblog_00771的博客 341

Spark Core

RDD:弹性分布式数据集,是 Spark 中最基本的数据处理模型。代码中是一个抽象类,它代表一个弹性的、不可变、可分区、里面的元素可并行计算的集合1)弹性存储的弹性:内存与磁盘的自动切换;容错的弹性:数据丢失可以自动恢复;计算的弹性:计算出错重试机制;分片的弹性:可根据需要重新分片。2)分布式:数据存储在大数据集群不同节点上3)数据集:RDD 封装了计算逻辑,并不保存数据4)数据抽象:RDD 是一个抽象类,需要子类具体实现。

2302_80567373的博客 1349

六万字!Spark Core、Spark SQL、Spark Streaming一锅端

目录一、什么是Spark?介绍特点与MapReduce相比技术栈二、Spark架构运行架构核心组件三、Spark RDD概念特性DAG分区创建方式操作算子常用的转换算子(Scala版)常用的转换算子(Java版)常用的动作算子(Scala)四、未完待结 一、什么是Spark? 介绍 诞生于加州大学伯克利分校AMP实验室,是一个基于内存的分布式计算框架 特点 速度快 基于内存数据处理,比MR快100个数量级以上(逻辑回归算法测试) 基于硬盘数据处理,比MR快10个数量级以上 易用性 支持Java、Scala

菜鸟也学大数据的博客 2099
上一篇: zookeeper 单机安装
下一篇: Spark window idea 开发环境搭建
未来创世纪
博客等级 码龄18年 960粉丝 209原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值