分库分表

分库分表实现方案 分库分表是解决大数据量和高并发问题的有效手段,通过合理的分库分表设计,可以提升系统的性能和可扩展性。在实际应用中,需要结合具体的业务需求和数据特点,选择合适的分库分表策略和实现方式。 阅读详情
为什么

随着业务的发展,关系型数据库 MySQL、Oracle数据库里的单表数据量越来越大,我们发现查询、修改、更新、修改表的DDL执行、修改列类型、添加字段、修改索引、的速度越来越慢。MySQL上千万、Oracle几千万的时候问题开始明显突出。如果你的表比较复杂,或者执行的查询比较复杂,到不了这个数量级就会突出。

我们开始通过各种方式解决这个问题。

应用层业务拆分
  • 历史表
    按时间拆分历史表出去,降低数据量,这个以前比较常见。其实也是一种特殊的水平拆分,对业务有侵入性

  • 其他拆分方法结合自身业务操作

应用层数据库拆表
  • 垂直拆分

    按列拆分,将列比较多的宽表 拆分成多个~列少的表(也就是每条记录数据量小),这种方法不能降低单表记录数,但是降低了每个子表的数据量和索引量大小,达到提速目的

  • 水平拆分

    按某个或某些列(如数字型id)的值哈希后,均匀的将数据拆分到多个同样表里(这些表可以分摊到不同的库中,这些库可以分配到不同的物理机或者虚拟机上),这样就直接降低了单库单表的数据量。比如原来有1333w的表说拆分成3个子表,就可以将单表的数据量降低为原表的1/3,单表只有不到445w。如果拆分成更多的表,单表操作压力就更小了。

    缺点就是,原来只需要操作一个表,现在操作之前需要先知道要操作那张表,比如一个用户表users,按uid分表为3个表(users_0,users_1,users_2):原来的

    --SQL1: 
    select * from users where uid=4
    

    现在得先知道uid是4,然后id对表数量取膜,4%3==1 知道表名users_1,SQL就变成了

    -- SQL2: 
    select * from users_1 where uid=4
    

看起来也是属于业务侵入型的。不过我们可以把这个过程封装一下,提供一个组件,不需要每个程序员都参与其中的处理…

下图列出了数据库拆分流程
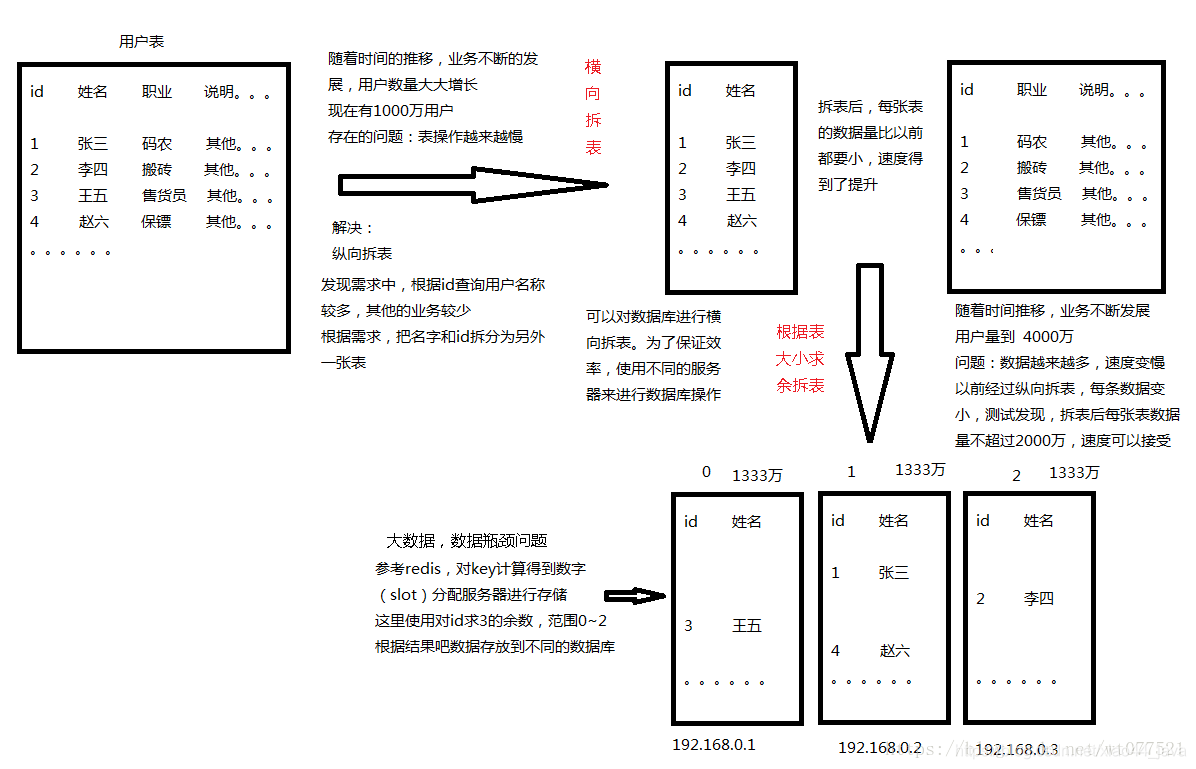
在这里插入图片描述

数据库读写分离

读多写少的情况下 ,分配几个只读库,把读的压力分分配给只读库,就可以降低主库的读压力,让主库关注于写。这时候也需要一个中间件来把数据请求路由到不同的库上。阿里云的RDS数据库就是支持这种方式。

数据库中间件

上面提到的水平拆分的时候,如果有中间件可以帮我们自动的把SQL1变成SQL2,从而使得我们开发的时候不用思考 分不分库、分不分表,分多少个,不用太多修改。岂不是很完美。这就是数据库中间件。

  • 其实很多大公司都有自己的数据库中间件,下面列出了一些开源的:
  1. Cobar:阿里巴巴B2B开发的关系型分布式系统,管理将近3000个MySQL实例。 在阿里经受住了考验,后面由于作者的走开的原因cobar没有人维护 了,阿里也开发了tddl替代cobar。
  2. MyCAT:社区爱好者在阿里cobar基础上进行二次开发,解决了cobar当时存 在的一些问题,并且加入了许多新的功能在其中。目前MyCAT社区活 跃度很高,目前已经有一些公司在使用MyCAT。总体来说支持度比 较高,也会一直维护下去,
  3. OneProxy:数据库界大牛,前支付宝数据库团队领导楼总开发,基于mysql官方 的proxy思想利用c进行开发的,OneProxy是一款商业收费的中间件, 楼总舍去了一些功能点,专注在性能和稳定性上。有朋友测试过说在 高并发下很稳定。
  4. Vitess:这个中间件是Youtube生产在使用的,但是架构很复杂。 与以往中间件不同,使用Vitess应用改动比较大要 使用他提供语言的API接口,我们可以借鉴他其中的一些设计思想。
  5. Kingshard:Kingshard是前360Atlas中间件开发团队的陈菲利用业务时间 用go语言开发的,目前参与开发的人员有3个左右, 目前来看还不是成熟可以使用的产品,需要在不断完善。
  6. Atlas:360团队基于mysql proxy 把lua用C改写。原有版本是支持分表, 目前已经放出了分库分表版本。在网上看到一些朋友经常说在高并 发下会经常挂掉,如果大家要使用需要提前做好测试。
  7. MaxScale与MySQL Route:这两个中间件都算是官方的吧,MaxScale是mariadb (MySQL原作者维护的一个版本)研发的,目前版本不支持分库分表。MySQL Route是现在MySQL 官方Oracle公司发布出来的一个中间件。
  8. ShardingSphere,后起之秀,源于当当网架构部的ShardingJDBC框架。

如果我们的业务发展到了需要降低单库单表的压力的地步,又不想花精力进行研发,引入数据库中间件是比较好的方式。使用免费的开源数据库中间件,真是又省钱又省时间。

云数据库

数据库中间件是很好的方案,如果数据库本来就支持岂不是更好, 对于用户来讲配置数据库中间件的工作都省了。这样云数据库出现了。

数据库中间件研发是需要费用和时间的,开源之后也不能和用户收费。。。如果把这项技术融入到云服务体系中。封装成云数据库,买机器送服务,可以对用户收费。是个好的选择。

对于企业来讲,虽然使用云数据库费用比数据库中间件高一点,不过省去了研发成本, 运维成本。在当今这个机器比人便宜的社会。无疑是个更好的选择。

知乎上的问题

知乎上有人问了一个好问题:

为什么几乎所有的开源数据库中间件都是国内公司开源的?并且几乎都停止了更新?

回帖中有人有问了几个问题

什么时候需要数据中间件,中间件能干什么
数据中间件的实现原理,有哪些开源数据中间件
为什么都是国内开源的,并且大都停止了更新
推荐使用什么数据中间件,有什么优势

我们来捋一下进化流程:

  • 应用层分库分表

    开始时间不详,可以说有狗那年就有这个方案
    现在的java项目中使用spring多数据源的方式,可以实现动态数据源让代码解决这个问题。
    层级关系是这样的:
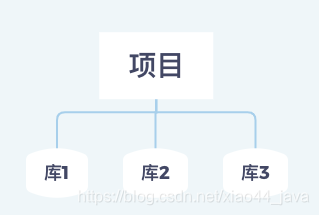
    在这里插入图片描述
    这样做的优点:

    1. 数据库操作由开发人员完成,对使用那种数据库没有关系
    2. 没有中间层,效率高,更容易对业务针对性优化。

    缺点:
    3. 需要开发人员边写代码完成数据库操作, 数据库节点变多,或者发生变化的时候,对整个业务产生影响。

  • mycat
    社区爱好者在阿里cobar基础上进行二次开发的, github上提交的第一个release版本1.3-alpha是在2014年12月
    mycat曾经一度成为很流行的方案。它创建了中间层,有效的降低了对业务的侵入,减少开发人员工作量,增加了数据库节点变化的兼容,对数据无关性更友好,他的层级关系是这样的:
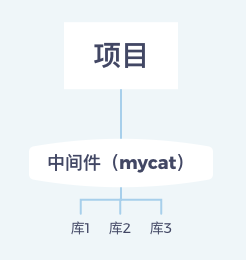
    在这里插入图片描述
    mycat 会先拦截用户发送的sql,然后对sql进行分析(分片分析,路由分析,读写分离分析,缓存分析等)然后将sql发送到数据库执行, 然后将各个数据库返回的数据进行汇总处理, 把结果返回给用户
    mycat 的实现方案有些缺陷,或者说可以提升的地方。主要体现在:

    1. 非分片字段查询时会到所有节点上执行,节点多时消耗Mycat和MySQL数据库资源

    2. 分页排序效率低下,不指定排序字段随机返回,指定排序字段后mycat会改写sql,limit m,n 改为limit 0,m+n 到每个分库查询,然后按照最小堆排序取结果,当偏移量大时效率几十倍的下降

    3. 任意表join,要确保两个表的关联字段具有相同的数据分布,否则查不到数据

    4. Mycat并没有根据二阶段提交协议实现 XA事务,而是只保证 prepare 阶段数据一致性的 弱XA事务

    下面这篇文章总结的很好,介绍了详细过程大家可以看看
    

    分库分表总结,Mycat从入门到放弃

  • ShardingSphere
    开始时间2016左右,github 上提交的第一个release版本1.0.0 是在2016年2月
    这也是一款数据库中间件,相比与mycat更灵活,支持XA强一致事务和柔性事务,mycat上存在的问题,它也存在一些,由无中心轻量化可集成到项目中的Sharding-JDBC(仅Java)、独立部署中心化的Sharding-Proxy(任意语言)和Sharding-Sidecar(计划中)这3款产品组成。现在由Apache孵化,目前有人维护

  • kingshard
    github 上提交的第一个release版本1.0.0 是在2015年7月
    由Go开发高性能MySQL Proxy项目,满足基本的读写分离的功能。
    git地址:https://gitee.com/flikecn/kingshard

  • POLARDB
    阿里云的关系型云数据库2018年3月商用上线
    现在大量的企业在用阿里云的产品, 阿里云的RDS关系型数据库使用者也特别多。 从RDS升级到POLARDB非常顺畅,省去了数据库中间件,分库分表,读写分离这些事情都能在控制台操作,由阿里云进行运维,更省心。显然比招聘更厉害的程序员更实惠。 从商业的角度来讲更合适。

  • 后续
    Apache ShardingSphere负责人张亮在知乎中回帖表示:ShardingSphere会继续维护升级,关系型数据库有存在的意义,数据库中间件并不是个伪需求。

当然结合业务做还是很重要的,没有最好的方式只有最适合的方式。架构师在技术通达的同时结合业务能写出更优的方案。比如一个订单表,订单号和时间戳有关系(比如雪花算法)按照订单创建时间来分表,可以分月表或日表,这样通过订单号能快速算出落在哪个表,在按时间查询或统计的时候能快速计算到相关的表中查询。

参考文章

https://www.zhihu.com/question/352256403/answer/878523206

https://blog.youkuaiyun.com/wt077521/article/details/80469015

【分库分表】基于mysql+shardingSphere的分库分表技术 分库分表是一种场景解决方案,它的出现是为了解决一些场景问题的,哪些场景喃?单表过大的话,读请求进来,查数据需要的时间会过长读请求过多,单节点IO压力太大,IO压力太大会造成什么?可能会造成IO阻塞,造成响应速度变慢。分库分表是指的两种维度,一种维度是分库,另一种维度是分表。分的话有两种分法,一种是水平分,另一种是垂直分。水平分是指将数据分为多段,一个服务器节点上存放一段,读写的时候走自己要的那一段所在服务器上。一段也叫一个分片(sharding) 阅读详情

相关推荐

SoIC、CoWoS、InFO一次讲透:从2D/2.5D/3D看懂先进封装

先进封装是后摩尔时代提升芯片性能的关键路径,但面对SoIC、CoWoS、InFO这些名词,很多人容易混淆。理解它们,需从最基本的2D、2.5D、3D封装概念入手:2D是传统平房,2.5D通过硅中介层实现高密度互连,3D则让芯片直接堆叠。CoWoS作为2.5D中介层封装,已成为AI芯片与HBM高带宽存储集成的行业标准;SoIC通过铜-铜混合键合实现真正的3D堆叠,为逻辑与缓存提供极致带宽;InFO以扇出型封装兼顾成本与集成度,广泛用于移动SoC。在系统级封装(SiP)和CPO共封装光学等前沿趋势中,这些技术往

weixin_42388898的博客 314

2024 数据库设计时针对宽表设计和拆分多表的分析

数据库表名的设计是数据库设计的重要组成部分,合理的表名规范可以提高可读性、可维护性和一致性。通过遵循这些规范,可以使数据库表名更直观、易读和易于维护。同时,表名设计的统一性也能帮助团队更高效地协作。

风吹落叶的博客 1131

深度学习分类任务中,正负样本比例失衡的5种实战解决方案(附代码)

本文深入探讨了深度学习分类任务中正负样本比例失衡的5种实战解决方案,包括智能采样技术、动态数据增强、损失函数工程、模型架构创新和训练策略优化。针对信用卡欺诈检测、医疗诊断等场景,提供了详细的代码实现和评估方法,帮助开发者有效解决样本不平衡问题,提升模型在真实场景中的表现。

h9j8k7l6m5n的博客 426

mysql 垂直分表,水平分表方案Vitess

Vitess是用于部署,扩展和管理MySQL实例的大型群集的数据库解决方案。它在架构上可以像在专用硬件上一样有效地在公共或私有云架构中运行。它结合了NoSQL数据库的可伸缩性,并扩展了许多重要的MySQL功能。Vitess可以帮助您解决以下问题: 通过允许您对MySQL数据库进行分片来扩展规模,同时将应用程序更改降至最低。 从裸机迁移到私有云或公共云。 部署和管理大量MySQL实例。 Vit...

taotaobaobei的博客 845

MatterPort3D 数据集下载

【代码】MatterPort3D 数据集下载。

qq_44106838的博客 6785

Unity中USD场景导入与工业级协作实战指南

USD(Universal Scene Description)是一种面向复杂三维场景的结构化数据模型,其核心在于分层描述、变体管理与非破坏性组合,本质是支持多团队并行协作的场景协议。它不同于传统模型格式,强调运行时可编辑性与版本可控性,技术价值体现在跨软件资产一致性、零拷贝动态叠加及内存中实时合成。典型应用场景包括建筑BIM实时漫游、汽车多配置仿真、影视级灯光材质协同等工业管线。在Unity中,USD已深度集成于URP/HDRP管线,通过原生USD Importer、Runtime与Exporter三组件

weixin_32073537的博客 302

A103_数据库优化_多机优化

数据库优化_多机优化 1.内容介绍 1. 分库分表理论讲解;(掌握) 2. 分库分表方案;(掌握) 3. 技术选择;(掌握) 4. 集群实现;(掌握) 5. 分库分表实现;(掌握) 2. 分库分表 有方向的,垂直(纵向)或者水平(横向) 2.1. 分库分表分析 2.1.1.垂直分表-宽表拆分 2.1.2.垂直分库-按业务分库 一个mysql服务,要安装在一台服务器上面,这台服务器资源(内存,cpu等)是有限的. 微服务架构:天然就是分库. 它要求各自服务都要有自己数据库服务器. 2.1.3.水

窗外有风景,笔下有前途,低头是题海,抬头是未来 314

状态机与RTOS的融合实践:如何避免‘状态爆炸’并提升系统响应

本文探讨了状态机与RTOS的融合实践,重点介绍了如何通过层次化状态机、表驱动设计等策略避免状态爆炸问题,并优化任务调度与事件处理机制,从而显著提升嵌入式系统的响应速度和可靠性。

net55的博客 109

宽表:数据仓库 - “宽表”之争?

昨天在技术交流群里一个问题引发了激烈的讨论,我决定把它记录下来。 问题如下:DWD 中有宽表么? 作为扫盲文章,基础知识我们再普及一下,先介绍下基础相关概念。 数仓分层(来自:个人理解) ODS、DWD、DWS、ADS 等,具体含义不做解释,数仓分层是大家为了抽象业务,简化计算,从设计上遵循高内聚低耦合的思想,经过漫长积累,业界普遍遵从的逻辑分层。初入数仓行业你可能会被这些东西限制住,但当你融会贯通时就会做到活学活用,代码无分层,心中有...

lquarius的博客 4194

3D点云目标检测Complex-YOLO(训练篇)(一)———KITTI数据集预处理与制作

KITTI dataset Download dataset KITTI 3D Object Detection Evaluation 2017 link 下载四个部分,共41.4GB 解压后为四部分内容(相机校准矩阵calib、RGB图像image_2、标签label_2、点云数据velodyne) 对应的testing和training数据。其中,training数据为7481张(图片和点云对应的场景),testing数据 7518张(无label_2数据)。 Data Preprocess

“知识最大的敌人不是无知,而是错觉” 7153

信创环境下,软件测试如何破局?

毕竟,在自主可控的道路上,每一行通过测试的代码,都在为信创产业的未来添砖加瓦。未来,测试工程师不仅要验证软件在信创环境的可用性,更要基于国产软硬件的特性,推动软件进行 “原生设计”—— 例如,针对国产 CPU 的多核架构优化代码,基于国产数据库的索引机制提升查询效率。某政务云平台的测试数据显示,在 “飞腾芯片 + 麒麟操作系统” 环境下,系统的并发处理能力较传统环境下降约 15%,测试团队通过优化软件的线程调度逻辑,最终将性能损失控制在 5% 以内 —— 这正是信创性能测试的价值所在。

weixin_45608163的博客 886

亿级大表分库分表实战总结(万字干货,实战复盘)

分库分表的文章网上非常多,但是大多内容比较零散,以讲解知识点为主,没有完整地说明一个大表的切分、新架构设计、上线的完整过程。 因此,我结合去年做的一个大型分库分表项目,来复盘一下完整的分库分表从架构设计 到 发布上线的实战总结。 1.前言 为什么需要做分库分表。这个相信大家多少都有所了解。 海量数据的存储和访问成为了MySQL数据库的瓶颈问题,日益增长的业务数据,无疑对MySQL数据库造成了相当大的负载,同时对于系统的稳定性和扩展性提出很高的要求。 而且单台服务器的资源(CPU、磁盘、内存等)总是有限的,

阿丸笔记 1277

基于摩尔线程 S80 显卡在 Ubuntu 系统下双卡交火部署 DeepSeek

curl -X POST -H "Content-Type: application/json" -d '{"prompt": "你的问题"}' http://localhost:11434/api/generate。curl -X POST -H "Content-Type: application/json" -d '{"prompt": "你的问题"}' http://localhost:11434/api/generate。- 为避免模型占用系统盘空间,可将模型存储路径修改到其他磁盘。

靡不有初,鲜克有终 1200

什么是分库分表?为什么需要分表?什么时候分库分表

分库分表是在海量数据下,由于单库、表数据量过大,导致数据库性能持续下降的问题,演变出的技术方案。分库分表是由分库和分表这两个独立概念组成的,只不过通常分库与分表的操作会同时进行,以至于我们习惯性的将它们合在一起叫做分库分表。通过一定的规则,将原本数据量大的数据库拆分成多个单独的数据库,将原本数据量大的表拆分成若干个数据表,使得单一的库、表性能达到最优的效果(响应速度快),以此提升整体数据库性能。预定义算法是事先已经明确知道分库和分表的数量,可以直接将某类数据路由到指定库或表中,查询的时候亦是如此。

m0_67544708的博客 4401

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

什么是分库分表?如何分库分表?(附大厂分库分表实例)

数据库调优之分库分表

m0_74315688的博客 7519

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

MySQL分库分表的方式有哪些

分库分表方案是对关系型数据库数据存储和访问机制的一种补充。将一个库的数据拆分到多个相同的库中,访问的时候访问一个库把一个表的数据放到多个表中,操作对应的某个表就行。

Welcome to My blog 2525

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

什么是分库分表

前言 公司最近在搞服务分离,数据切分方面的东西,因为单张包裹表的数据量实在是太大,并且还在增长。 之前了解过数据库的分库分表,读过几篇博文,但就只知道个模糊概念, 而且现在回想起来什么都是模模糊糊的。 今天看了一下午的数据库分库分表,看了很多文章,现在做个总结,“摘抄”下来。(但更期待后期的实操) 会从以下几个方面说起: 第一部分:实际网站发展过程中面临的问题。 第二部分:有哪几种切分...

create 1万+

【MYSQL】分库分表

分库分表就是指在一个数据库在存储数据过大,或者一个表存储数据过多的情况下,为了提高数据存储的可持续性,查询数据的性能而进行的将单一库或者表分成多个库,表使用。

门牙咬脆骨的奋斗日志 2577

什么是分库分表?为什么要分库分表?什么时候需要分库分表?怎么样拆分?(数据库分库分表详解)

分库分表的形式,主要是两种:垂直拆分和水平拆分。而拆分的粒度,一般又分为分库和分表,所以组成的拆分策略最终如下:分库:将一个数据库拆分成多个独立的数据库,每个数据库可以部署在不同的服务器上,从而分散数据存储和访问压力。分表:将一个数据表拆分成多个小表,每个小表可以存储部分数据,从而减少单个表的数据量,提高查询和写入性能。数据库分库分表是一种解决大规模数据和高并发访问的有效技术方案。

tigerhhzz的博客 4095

分库分表你要怎么分

为什么要分库分表 关系型数据库以MySQL为例,单机的存储能力、连接数是有限的,它自身就很容易会成为系统的瓶颈。当单表数据量在百万以内时,我们还可以通过添加从库、优化索引提升性能。 一旦数据量朝着千万以上趋势增长,再怎么优化数据库,很多操作性能仍下降严重。为了减少数据库的负担,提升数据库响应速度,缩短查询时间,这时候就需要进行分库分表。 如何分库分表 分库分表就是要将大量数据分散到多个数据库中,使每个数据库中数据量小响应速度快,以此来提升数据库整体性能。 针对数据切分类型,大致可以分为:垂直(纵向)切分和水

qq_40813329的博客 1万+

都2025年了,还不懂分库分表吗,一文看懂分库分表

利用这一原理,要查询全局100页数据,offset 9900 limit 100改写为offset 4950 limit 50,每个分库偏移4950(一半),获取50条数据(半页),得到的数据集的并集,基本能够认为,是全局数据的offset 9900 limit 100的数据,当然,这一页数据的精度,并不是精准的。方案,比如订单id在0-4000万的区间,划分为订单库1,id在4000万-8000万的数据,划分到订单库2,将来要扩容时,id在8000万~1.2亿的数据,划分到订单库3。

qq_50487743的博客 2428

如何分库分表,怎样分库分表,为什么要分库分表?

如何分库分表,怎样分库分表,为什么要分库分表?◆ 数据库瓶颈◆分库分表1. 水平分库2. 水平分表3. 垂直分库4. 垂直分表◆ 分库分表工具◆ 分库分表带来的问题■ 事务一致性问题■ 跨节点关联查询 Join 问题■ 跨节点分页、排序、函数问题■ 全局主键避重问题■ 数据迁移、扩容问题 当数据库的数据量过大,大到一定的程度,我们就可以进行分库分表。那么基于什么原则,什么方法进行拆分,这就是本篇所要讲的。 ◆ 数据库瓶颈 不管是 IO 瓶颈还是 CPU 瓶颈,最终都会导致数据库的活跃连接数增加,进而逼近甚至

梅川酷紫 5241

Mysql分库分表

1、分库分表有什么用 分库分表就是为了解决由于数据量过大而导致数据库性能降低的问题,将原来独立 的数据库拆分成若干数据库组成,将数据大表拆分成若干数据表组成,使得单一数据库、单一数据表的数据量变 小,从而达到提升数据库性能的目的。 例如:微服务架构中,每个服务都分配一个独立的数据库,这就是分库。而对一些业务日志表,按月拆分成不同的表,这就是分表。 单表数据量大于500W或数据量大于2G就需要考虑分库分表了。 2、分库分表的方式 分库分表包含分库和分表 两个部分,而这两个部分可以统称为数据分片,其目的都是将数

chenxuezhou的博客 5802

分库分表介绍以及shardingjdbc实现分库分表

分库分表是在海量数据下,由于单库、表数据量过大,导致数据库性能持续下降的问题,演变出的技术方案。分库分表是由分库和分表这两个独立概念组成的,只不过通常分库与分表的操作会同时进行,以至于我们习惯性的将它们合在一起叫做分库分表。通过一定的规则,将原本数据量大的数据库拆分成多个单独的数据库,将原本数据量大的表拆分成若干个数据表,使得单一的库、表性能达到最优的效果(响应速度快),以此提升整体数据库性能。

爱学习的软件开发的博客 2364

mysql分库分表

目录 为什么要分库分表 数据切分 垂直(纵向)切分 水平(横向)切分 根据数值范围 根据数值取模 分库分表带来的问题与解决方案 事务一致性问题 跨节点关联查询 join 问题 跨节点分页、排序、函数问题 全局主键避重问题 数据迁移、扩容问题 什么时候考虑切分 能不切分尽量不要切分 数据量过大,正常运维影响业务访问 随着业务发展,需要对某些字段垂直拆分 数据量快速...

今天吃了吗的博客 2711
上一篇: docker ubuntu镜像时间错误-时区修改
下一篇: Docker容器访问宿主机网络
RobertLee~~~~~~~~
博客等级 码龄18年 14粉丝 43原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值