Nginx实战-后端应用健康检查

Nginx 负载均衡实现上游服务健康检查 Nginx 负载均衡实现上游服务健康检查。 阅读详情

公司前一段对业务线上的nginx做了整理,重点就是对nginx上负载均衡器的后端节点做健康检查。目前,nginx对后端节点健康检查的方式主要有3种,这里列出:

1

2

3

4

5

6

1、ngx_http_proxy_module 模块和ngx_http_upstream_module模块(自带)

    官网地址:http://nginx.org/cn/docs/http/ngx_http_proxy_module.html#proxy_next_upstream

2、nginx_upstream_check_module模块

    官网网址:https://github.com/yaoweibin/nginx_upstream_check_module

3、ngx_http_healthcheck_module模块

    官网网址:http://wiki.nginx.org/NginxHttpHealthcheckModule

       公司业务线上对后端节点的健康检查是通过nginx_upstream_check_module模块做的,这里我将分别介绍这三种实现方式以及之间的差异性。 


一、ngx_http_proxy_module 模块和ngx_http_upstream_module模块(自带)

       严格来说,nginx自带是没有针对负载均衡后端节点的健康检查的,但是可以通过默认自带的ngx_http_proxy_module 模块和ngx_http_upstream_module模块中的相关指令来完成当后端节点出现故障时,自动切换到健康节点来提供访问。

       这里列出这两个模块中相关的指令:

ngx_http_proxy_module 模块中的 proxy_connect_timeout 指令、proxy_read_timeout指令和proxy_next_upstream指令

1

2

3

语法: proxy_connect_timeout time;

默认值:    proxy_connect_timeout 60s;

上下文:    http, server, location

设置与后端服务器建立连接的超时时间。应该注意这个超时一般不可能大于75秒。

1

2

3

语法: proxy_read_timeout time;

默认值:    proxy_read_timeout 60s;

上下文:    http, server, location

定义从后端服务器读取响应的超时。此超时是指相邻两次读操作之间的最长时间间隔,而不是整个响应传输完成的最长时间。如果后端服务器在超时时间段内没有传输任何数据,连接将被关闭。

1

2

3

语法: proxy_next_upstream error | timeout | invalid_header | http_500 | http_502 | http_503 | http_504 |http_404 | off ...;

默认值:    proxy_next_upstream error timeout;

上下文:    http, server, location

指定在何种情况下一个失败的请求应该被发送到下一台后端服务器:

1

2

3

4

5

6

7

8

9

error      # 和后端服务器建立连接时,或者向后端服务器发送请求时,或者从后端服务器接收响应头时,出现错误

timeout    # 和后端服务器建立连接时,或者向后端服务器发送请求时,或者从后端服务器接收响应头时,出现超时

invalid_header  # 后端服务器返回空响应或者非法响应头

http_500   # 后端服务器返回的响应状态码为500

http_502   # 后端服务器返回的响应状态码为502

http_503   # 后端服务器返回的响应状态码为503

http_504   # 后端服务器返回的响应状态码为504

http_404   # 后端服务器返回的响应状态码为404

off        # 停止将请求发送给下一台后端服务器


需要理解一点的是,只有在没有向客户端发送任何数据以前,将请求转给下一台后端服务器才是可行的。也就是说,如果在传输响应到客户端时出现错误或者超时,这类错误是不可能恢复的。

范例如下:

1

2

3

http {

proxy_next_upstream http_502 http_504 http_404 error timeout invalid_header;

}


ngx_http_upstream_module模块中的server指令

1

2

3

语法: server address [parameters];

默认值:    —

上下文:    upstream

范例如下:

1

2

3

4

        upstream name {

                server 10.1.1.110:8080 max_fails=1 fail_timeout=10s;

                server 10.1.1.122:8080 max_fails=1 fail_timeout=10s;

        }

下面是每个指令的介绍:

1

2

3

4

5

6

max_fails=number      # 设定Nginx与服务器通信的尝试失败的次数。在fail_timeout参数定义的时间段内,如果失败的次数达到此值,Nginx就认为服务器不可用。在下一个fail_timeout时间段,服务器不会再被尝试。 失败的尝试次数默认是1。设为0就会停止统计尝试次数,认为服务器是一直可用的。 你可以通过指令proxy_next_upstream、fastcgi_next_upstream和 memcached_next_upstream来配置什么是失败的尝试。 默认配置时,http_404状态不被认为是失败的尝试。

fail_timeout=time       # 设定服务器被认为不可用的时间段以及统计失败尝试次数的时间段。在这段时间中,服务器失败次数达到指定的尝试次数,服务器就被认为不可用。默认情况下,该超时时间是10秒。

       在实际应用当中,如果你后端应用是能够快速重启的应用,比如nginx的话,自带的模块是可以满足需求的。但是需要注意。如果后端有不健康节点,负载均衡器依然会先把该请求转发给该不健康节点,然后再转发给别的节点,这样就会浪费一次转发。

       可是,如果当后端应用重启时,重启操作需要很久才能完成的时候就会有可能拖死整个负载均衡器。此时,由于无法准确判断节点健康状态,导致请求handle住,出现假死状态,最终整个负载均衡器上的所有节点都无法正常响应请求。由于公司的业务程序都是java开发的,因此后端主要是nginx集群和tomcat集群。由于tomcat重启应部署上面的业务不同,有些业务启动初始化时间过长,就会导致上述现象的发生,因此不是很建议使用该模式。

       并且ngx_http_upstream_module模块中的server指令中的max_fails参数设置值,也会和ngx_http_proxy_module 模块中的的proxy_next_upstream指令设置起冲突。比如如果将max_fails设置为0,则代表不对后端服务器进行健康检查,这样还会使fail_timeout参数失效(即不起作用)。此时,其实我们可以通过调节ngx_http_proxy_module 模块中的 proxy_connect_timeout 指令、proxy_read_timeout指令,通过将他们的值调低来发现不健康节点,进而将请求往健康节点转移。

       以上就是nginx自带的两个和后端健康检查相关的模块。


二、nginx_upstream_check_module模块

       除了自带的上述模块,还有一个更专业的模块,来专门提供负载均衡器内节点的健康检查的。这个就是淘宝技术团队开发的 nginx 模块 nginx_upstream_check_module,通过它可以用来检测后端 realserver 的健康状态。如果后端 realserver 不可用,则所以的请求就不会转发到该节点上。

       在淘宝自己的 tengine 上是自带了该模块的,大家可以访问淘宝tengine的官网来获取该版本的nginx,官方地址:http://tengine.taobao.org/。

       如果我们没有使用淘宝的 tengine 的话,可以通过补丁的方式来添加该模块到我们自己的 nginx 中。我们业务线上就是采用该方式进行添加的。

       下面是部署流程!

1、下载nginx_upstream_check_module模块

1

2

3

4

5

[root@localhost ~]# cd /usr/local/src

wget https://codeload.github.com/yaoweibin/nginx_upstream_check_module/zip/master

unzip master

[root@localhost /usr/local/src]# ll -d nginx_upstream_check_module-master

drwxr-xr-x. 6 root root 4096 Dec  1 02:28 nginx_upstream_check_module-master


2、为nginx打补丁

1

2

3

4

5

6

7

8

[root@localhost /usr/local/src]# cd nginx-1.6.0 # 进入nginx的源码目录

给nginx打补丁(根据nginx版本号选择补丁包)

[root@localhost nginx-1.6.0]# patch -p1 < ../nginx_upstream_check_module-master/check_1.5.12+.patch

[root@localhost nginx-1.6.0]# ./configure --user=nginx --group=nginx --prefix=/usr/local/nginx-1.6.0 --with-http_ssl_module --with-openssl=/usr/local/src/openssl-0.9.8q --with-pcre=/usr/local/src/pcre-8.32 --add-module=/usr/local/src/nginx_concat_module/ --add-module=../nginx_upstream_check_module-master/

make (注意:此处只make,编译参数需要和之前的一样)

[root@localhost nginx-1.6.0]# mv /usr/local/nginx/sbin/nginx /usr/local/nginx/sbin/nginx-1.6.0.bak

[root@localhost nginx-1.6.0]# cp ./objs/nginx /usr/local/nginx/sbin/

[root@localhost nginx-1.6.0]# /usr/local/nginx/sbin/nginx -t  # 检查下是否有问题

[root@localhost nginx-1.6.0]# kill -USR2 `cat /usr/local/nginx/logs/nginx.pid`


3、在nginx.conf配置文件里面的upstream加入健康检查,如下:

1

2

3

4

5

6

upstream name {

       server 192.168.0.21:80;

       server 192.168.0.22:80;

       check interval=3000 rise=2 fall=5 timeout=1000 type=http;


}

上面配置的意思是,对name这个负载均衡条目中的所有节点,每个3秒检测一次,请求2次正常则标记 realserver状态为up,如果检测 5 次都失败,则标记 realserver的状态为down,超时时间为1秒。

这里列出nginx_upstream_check_module模块所支持的指令意思:

1

2

3

Syntax: check interval=milliseconds [fall=count] [rise=count] [timeout=milliseconds] [default_down=true|false] [type=tcp|http|ssl_hello|mysql|ajp] [port=check_port]

Default: 如果没有配置参数,默认值是:interval=30000 fall=5 rise=2 timeout=1000 default_down=true type=tcp

Context: upstream

该指令可以打开后端服务器的健康检查功能。

指令后面的参数意义是:

1

2

3

4

5

6

7

8

9

10

11

12

    - interval:向后端发送的健康检查包的间隔。

    - fall(fall_count): 如果连续失败次数达到fall_count,服务器就被认为是down。

    - rise(rise_count): 如果连续成功次数达到rise_count,服务器就被认为是up。

    - timeout: 后端健康请求的超时时间。

    - default_down: 设定初始时服务器的状态,如果是true,就说明默认是down的,如果是false,就是up的。默认值是true,也就是一开始服务器认为是不可用,要等健康检查包达到一定成功次数以后才会被认为是健康的。

    - type:健康检查包的类型,现在支持以下多种类型

        - tcp:简单的tcp连接,如果连接成功,就说明后端正常。

        - ssl_hello:发送一个初始的SSL hello包并接受服务器的SSL hello包。

        - http:发送HTTP请求,通过后端的回复包的状态来判断后端是否存活。

        - mysql: 向mysql服务器连接,通过接收服务器的greeting包来判断后端是否存活。

        - ajp:向后端发送AJP协议的Cping包,通过接收Cpong包来判断后端是否存活。

    - port: 指定后端服务器的检查端口。你可以指定不同于真实服务的后端服务器的端口,比如后端提供的是443端口的应用,你可以去检查80端口的状态来判断后端健康状况。默认是0,表示跟后端server提供真实服务的端口一样。该选项出现于Tengine-1.4.0。

1

2

3

Syntax: check_keepalive_requests request_num

Default: 1

Context: upstream

该指令可以配置一个连接发送的请求数,其默认值为1,表示Tengine完成1次请求后即关闭连接。

1

2

3

Syntax: check_http_send http_packet

Default: "GET / HTTP/1.0\r\n\r\n"

Context: upstream

该指令可以配置http健康检查包发送的请求内容。为了减少传输数据量,推荐采用"HEAD"方法。

当采用长连接进行健康检查时,需在该指令中添加keep-alive请求头,如:"HEAD / HTTP/1.1\r\nConnection: keep-alive\r\n\r\n"。 同时,在采用"GET"方法的情况下,请求uri的size不宜过大,确保可以在1个interval内传输完成,否则会被健康检查模块视为后端服务器或网络异常。

1

2

3

Syntax: check_http_expect_alive [ http_2xx | http_3xx | http_4xx | http_5xx ]

Default: http_2xx | http_3xx

Context: upstream

该指令指定HTTP回复的成功状态,默认认为2XX和3XX的状态是健康的。

1

2

3

Syntax: check_shm_size size

Default: 1M

Context: http

所有的后端服务器健康检查状态都存于共享内存中,该指令可以设置共享内存的大小。默认是1M,如果你有1千台以上的服务器并在配置的时候出现了错误,就可能需要扩大该内存的大小。

1

2

3

Syntax: check_status [html|csv|json]

Default: check_status html

Context: location

显示服务器的健康状态页面。该指令需要在http块中配置。

在Tengine-1.4.0以后,你可以配置显示页面的格式。支持的格式有: html、csv、 json。默认类型是html。

你也可以通过请求的参数来指定格式,假设‘/status’是你状态页面的URL, format参数改变页面的格式,比如:

1

2

3

/status?format=html

/status?format=csv

/status?format=json

同时你也可以通过status参数来获取相同服务器状态的列表,比如:

1

2

/status?format=html&status=down

/status?format=csv&status=up

下面是一个状态也配置的范例:

1

2

3

4

5

6

7

8

9

10

http {

      server {

            location /nstatus {

                   check_status;

                   access_log off;

                   #allow IP;

                   #deny all;

            }

      }

}

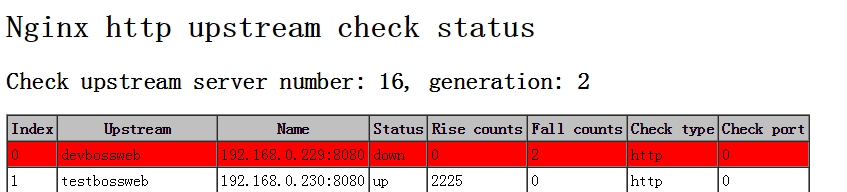
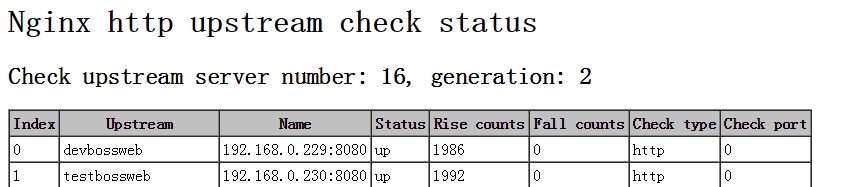
配置完毕后,重启nginx。此时通过访问定义好的路径,就可以看到当前 realserver 实时的健康状态啦。效果如下图:
realserver 都正常的状态:
wKiom1SZZXKQcPJTAAFnMqUEfBo238.jpg

一台 realserver 故障的状态:

wKioL1SZZivDAzdWAAGTyIK9cS8558.jpgOK,以上nginx_upstream_check_module模块的相关信息,更多的信息大家可以去该模块的淘宝tengine页面和github上该项目页面去查看,下面是访问地址:


http://tengine.taobao.org/document_cn/http_upstream_check_cn.html

https://github.com/yaoweibin/nginx_upstream_check_module

在生产环境的实施应用中,需要注意的有 2 点:

1、主要定义好type。由于默认的type是tcp类型,因此假设你服务启动,不管是否初始化完毕,它的端口都会起来,所以此时前段负载均衡器为认为该服务已经可用,其实是不可用状态。


2、注意check_http_send值的设定。由于它的默认值是"GET / HTTP/1.0\r\n\r\n"。假设你的应用是通过http://ip/name访问的,那么这里你的check_http_send值就需要更改为"GET /name HTTP/1.0\r\n\r\n"才可以。针对采用长连接进行检查的,这里增加keep-alive请求头,即"HEAD /name HTTP/1.1\r\nConnection: keep-alive\r\n\r\n"。如果你后端的tomcat是基于域名的多虚拟机,此时你需要通过check_http_send定义host,不然每次访问都是失败,范例:check_http_send "GET /mobileapi HTTP/1.0\r\n HOST www.redhat.sx\r\n\r\n";


三、ngx_http_healthcheck_module模块

       除了上面两个模块,nginx官方在早期的时候还提供了一个 ngx_http_healthcheck_module 模块用来进行nginx后端节点的健康检查。nginx_upstream_check_module模块就是参照该模块的设计理念进行开发的,因此在使用和效果上都大同小异。但是需要注意的是,ngx_http_healthcheck_module 模块仅仅支持nginx的1.0.0版本,1.1.0版本以后都不支持了!因此,对于目前常见的生产环境上都不会去用了,这里仅仅留个纪念,给大家介绍下这个模块!

   具体的使用方法,这里可以贴出几篇靠谱的博文地址以及官方地址:

      http://wiki.nginx.org/HttpHealthcheckModule

      https://github.com/cep21/healthcheck_nginx_upstreams/blob/master/README


四、在nginx_upstream_check_module-master模块安装正常的情况下,通过web界面查看后端节点状态配置方法,有问题请QQ联系我:405110958

1、配置upstream节点,并将健康监测页面添加至该节点池内

upstream dvwa {
        server 192.168.2.41:9000;
        server 192.168.2.42:9000;
        server 192.168.2.43:9000;
        server 192.168.2.44:9000;
        #check interval=5000 rise=1 fall=3 timeout=16000;
        #check interval=3000 rise=2 fall=5 timeout=1000 type=ssl_hello;
        check interval=3000 rise=2 fall=5 timeout=1000 type=http;
        check_keepalive_requests 100;
        check_http_send "GET /dvwa/check.html HTTP/1.1\r\nHost:dvwa.manjd.com\r\nConnection: keep-alive\r\n\r\n";
        check_http_expect_alive http_2xx http_3xx;
        #check_http_send "HEAD / HTTP/1.1\r\nConnection: keep-alive\r\n\r\n";

}

2、新增反向代理健康检查节点

server
{
  listen 80;
  server_name dvwa.manjd.com;
  index index.html index.htm index.php;
location /status {
    check_status;
    access_log on;
    #allow SOME.IP.ADD.RESS;
    allow 10.0.0.0/8;
    allow 127.0.0.1/32;
    allow 192.168.0.0/16;
    #deny all;
}

 location /ngx_status {

    stub_status on;
    allow 10.0.0.0/8;
    allow 127.0.0.1;
    allow 192.168.0.0/16;
    deny all;
}

location / {

    proxy_pass http://dvwa;
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_set_header X-Forwarder-For @proxy_add_x_forwarded_for;

} 

}

3、web界面查看健康状态


Nginx与健康检查:监控后端服务状态 嗨,各位小伙伴!今天我们要聊的是 Nginx 服务器中的一个非常重要的功能——健康检查。如果你的网站或者应用是由多个服务组成的,那么确保这些服务能够正常工作就非常重要了。健康检查就像是给你的后端服务定期做体检,确保它们健康无恙。接下来,我们就一步步来看如何配置 Nginx 来实现健康检查吧!健康检查是一种机制,用来监测后端服务的状态是否正常。通过发送请求到指定的服务端点,可以检查该服务是否能够响应,从而判断其健康状况。这对于维护系统的高可用性和稳定性至关重要。你可以根据需要自定义健康检查的端点,例如使用。 阅读详情

相关推荐

ngx_healthcheck_module:用于上游服务器运行状况检查的nginx模块。 支持流和http上游。该模块可以为Nginx提供主动式嵌入式服务器健康检查的功能(同时支持四层和七层嵌入式服务器的健康检测)

ngx_healthcheck_module:用于上游服务器运行状况检查的nginx模块。 支持流和http上游。该模块可以为Nginx提供主动式嵌入式服务器健康检查的功能(同时支持四层和七层嵌入式服务器的健康检测)

Nginx实战系列之功能篇----后端节点健康检查

       公司前一段对业务线上的nginx做了整理,重点就是对nginx上负载均衡器的后端节点做健康检查。目前,nginx对后端节点健康检查的方式主要有3种,这里列出:1、ngx_http_proxy_module 模块和ngx_http_upstream_module模块(自带)     官网地址:http://nginx.org/cn/docs/http/ngx_http_proxy_mo...

weixin_33858485的博客 889

Java实现双色球&大乐透随机选号算法——原理详解与代码实战

掌握核心语法:集合操作、随机数生成、排序。贴近实际场景:将编程知识应用于生活问题的解决。

wangchl0932的博客 4973

Nginx个人学习笔记:基础配置

参考资料: 0到1学会Nginx分布式框架(视频教程) 写在开头:本文为学习后的总结,可能有不到位的地方,错误的地方,欢迎各位指正。 nginx.conf配置示例如下: #运行用户 #user somebody; #设置工作进程数,通常设置成和cpu的数量相等 worker_processes 1; #全局错误日志,按照级别划分成error、notice、info三个日志 error_log D:/Tools/nginx-1.10.1/logs/error.log; error...

CRUD工程师 3755

从零搭建VGGNet

在 forward 方法中实现了前向传播过程,包括卷积、激活、池化和平铺操作,最后通过全连接层得到分类结果。使用 torch.onnx.export 将模型导出为 ONNX 格式的文件 vgg.onnx。导出 ONNX:将模型导出为 ONNX 格式,便于在其他平台或框架中使用。定义 VGG 网络:构建了一个包含多个卷积层、池化层和全连接层的网络。使用 torch.save 将整个模型保存为 vgg.pth 文件。前向传播:对输入数据进行前向传播,得到输出结果。保存模型:将模型保存为 .pth 文件。

开源驱动,创造价值;坦诚清晰,快速失败;让复杂可计算。 521

英飞凌 AURIX 系列单片机的HSM详解(1)——何为HSM

1. 概述 随着汽车上通信系统越来越复杂,云端远程通信的场景越来越多,信息安全变得越来越重要,在通信领域常用的AES、SHA、RSA等加密算法被越来越多地应用到汽车上。但通常这类加解密算法都需要大量的数学运算,需要消耗很多CPU时间和资源,汽车上的ECU又有比较高的实时性要求,为了节省主CPU的资源,HSM应运而生。 HSM(Hardware Security Module),是MCU上专门用于实现加解密算法的一个外设,它一般会有一个独立的CPU,专门用来进行加解密运算,还有一些针对特定算法的硬件加速器(如

weixin_42967006的博客 4万+

【转】Nginx配置详解

转自:http://www.cnblogs.com/knowledgesea/p/5175711.html Nginx常用功能 1、 Http代理,反向代理:作为web服务器最常用的功能之一,尤其是反向代理。 对正向代理与反响代理做个诠释 Nginx在做反向代理时,提供性能稳定,并且能够提供配置灵活的转发功能。Nginx可以根据不同的正则匹配,采取不同的转发策...

diaoerxiao0394的博客 294

Proteus仿真实战:用STM32F103C8T6输入捕获模式精准测量PWM频率(附完整代码)

本文详细解析了如何在Proteus仿真环境中,利用STM32F103C8T6的输入捕获模式精准测量PWM频率。文章从输入捕获的工作原理、Proteus电路搭建、模块化代码实现到调试优化,提供了完整的实战指南和代码示例,帮助开发者深入理解并掌握这一关键技术。

weixin_29158047的博客 257

nginx高性能WEB服务器系列之六--nginx负载均衡配置+健康检查

nginx系列友情链接:nginx高性能WEB服务器系列之一简介及安装https://www.cnblogs.com/maxtgood/p/9597596.htmlnginx高性能WEB服务器系列之二命令管理https://www.cnblogs.com/maxtgood/p/9597990.htmlnginx高性能WEB服务器系列之三版本升级https://www.cnblogs.com/max...

weixin_30648587的博客 366

OpenClaw 在 Docker 容器中的部署实战——零配置启动

本文介绍了OpenClaw在Docker容器中的快速部署方法,对比了本地部署与容器化部署的优势。通过官方镜像和Docker Compose两种方式,5分钟即可完成部署,并详细讲解了配置管理方案(挂载配置文件和环境变量)。文章还提供了飞书集成配置方法,以及生产环境下的日志管理、资源限制、健康检查等优化建议。最后包含常见问题排查指南,帮助开发者快速实现OpenClaw的容器化部署。

刘一说的IT专栏 904

AgentScope 实战训练营-A2UI的完整实现:从概念到部署全流程

本文详细介绍了如何在AgentScope框架中实现Google的A2UI(Agent-to-Agent UI)协议,构建一个能生成可交互UI的智能体应用。文章涵盖了从环境准备、架构设计、核心代码实现到测试部署的完整流程,包括A2UI协议解析、技能系统、客户端实现、通信机制等核心技术点,适合AI Agent和前端开发人员学习参考。

program哲学 201

Nginx心跳检测

通常我们会使用Nginx的ngx_http_upstream_module模块来配置服务器组,示例如下 upstream springboot { server 10.3.73.223:8080 max_fails=2 fail_timeout=30s; server 10.3.73.223:8090 max_fails=2 fail_timeout=30s; } se...

怀揣梦想,努力前行 2万+

可编程逻辑控制器(PLC)系列:Mitsubishi MELSEC-Q_(8).MELSEC-Q系列PLC故障诊断与维护

MELSEC-Q系列PLC的故障诊断与维护是一个系统性的过程,需要工程师具备扎实的理论基础和丰富的实践经验。通过了解故障类型、使用诊断工具、遵循诊断步骤,可以有效地定位和解决故障问题。同时,定期的检查与保养、备份与恢复、优化程序和配置,以及提供良好的运行环境,可以减少故障的发生,提高系统的可靠性。希望本文能够帮助工程师在故障诊断与维护过程中更加得心应手,确保MELSEC-Q系列PLC的稳定运行。

2401_87715305的博客 1247

nginx后端节点更新不停机

【代码】nginx后端节点更新不停机。

运维工程师 1586

【PINN物理信息网络】基于PINN物理信息网络求解圆柱坐标中的热方程(python)

【PINN物理信息网络】基于PINN物理信息网络求解圆柱坐标中的热方程(python)

k8291121的博客 2273

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Keepalived + Nginx + Tomcat 搭建高可用

Tomcat 层:任意一台 Tomcat 挂掉,Nginx 会自动将流量转发到另一台存活的 Tomcat。Nginx 层:任意一台 Nginx 挂掉,Keepalived 会通过脚本联动或 VRRP 协议,将 VIP 漂移到备用节点。Keepalived 层:主备机制保障了 Nginx 节点本身的容灾。

Aionli的博客 183

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

nginx后端节点的健康检查

本文主要介绍nginx后端节点的健康检查,在此之前我们先来介绍下nignx反向代理主要使用的模块。定义允许将请求传递到另一台服务器。此模块下常用指令如下:proxy_pass用于定义可由proxy_pass,fastcgi_pass等指令引用的服务器组。此模块下常用指令如下:upstreamserverip_hash。

weixin_56665846的博客 654

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Nginx 健康检查

健康检查(Health Check)是指通过一定的机制,周期性地检测服务器或服务的健康状态,确保系统中的各个组件能够正常工作。如果某个组件(如后端服务器)出现故障或不可用,健康检查能够及时发现并将该组件标记为不可用,防止将请求转发到故障节点,从而提高系统的可靠性和稳定性。在负载均衡架构中,健康检查尤为重要。负载均衡器需要确保仅将流量分发到健康且可响应的后端服务器上,这样才能保证服务的高可用性。Nginx 健康检查模块支持通过自定义检查条件,增加更多维度的健康检查。

Flying_Fish_roe的博客 2282

nginx后端节点的健康检查和nginx平滑升级

定义允许将请求传递到另一台服务器。此模块下常用指令如下:proxy_pass用于定义可由proxy_pass,fastcgi_pass等指令引用的服务器组。此模块下常用指令如下:upstreamserverip_hash。

2503_92914039的博客 1034

Nginx负载均衡健康检查:实时监控后端服务

摘要:Nginx负载均衡的健康检查功能通过主动/被动机制监控后端服务器状态,防止请求分发至故障节点。主动检查定期发送请求(如/health接口),依据状态码(200正常/500异常)判断健康度;被动检查基于客户端请求失败记录触发判定。配置时可通过health_check指令设置间隔(interval)、失败阈值(fails)和恢复阈值(passes)。监控手段包括分析Nginx日志、使用Nginx Plus状态页面或集成Prometheus/Grafana等工具可视化指标。该功能显著提升服务可靠性,为后续学

fykam的博客 1347

Nginx健康检查的安装配置过程

Nginx的健康检查是用于确保Nginx后端服务器(upstream servers)保持正常状态的一种机制。在Nginx的配置中,可以定义一组后端服务器,并通过健康检查来确定哪些服务器是可用的,哪些是不可用的。Nginx 支持两种主要的健康检查模式:主动检查和被动检查。以下是这两种检查模式的详细解释:被动检查(Passive Health Checks)在被动检查模式下,Nginx 并不主动向后端服务器发送检查请求。相反,它通过观察代理请求的实际响应来判断后端服务器的健康状况。

weixin_42528678的博客 3849

Nginx后端Web服务器健康检查

Nginx后端Web服务器健康检查 背景: 有一个问题,当Nginx没有后端检测功能,当后端某一服务器无法提供服务时,该链接先被转发到这台机器,然后发现该机故障,而后才转发到其它机器,导致资源浪费。 因此引入 nginx_upstream_check_module 模块,该模块用于提供负载均衡器内节点的健康检查,通过它可以用来检测后端服务的健康状态。如果后端服务不可用,则后面的请求就不会转发到该节点上。 操作 # yum -y install patch # cd /usr/local/src/ngin

进阶的蜗牛 1071

Nginx健康检查

nginx健康检查

xiao-啸 2729

Nginx实战| Nginx健康检查

目录 方案概述 配置参数详解 完整示例 服务治理的一个重要任务是感知服务的变更,完成服务自动注册及异常例程的自动摘除。这就需要服务治理平台能够:及时,准确的感知服务例程的健康状况。 方案概述 Nginx提供了三种HTTP服务健康检查方案供用户选择: TCP层最小检查方案: 定时与初步服务建立一条tcp连接,链接建立成功则认为服务中断是健康的。 HTTP层最小检查方案: TCP层检查有一定的局限性: 很多HTTP服务是带状态的,端口处于listen状态并不能代表服务已经完

Dragon的博客 2959

nginx主动健康检查

本文介绍了基于 Nginx 的第三方模块 nginx_upstream_check_module,该模块可以实现 Nginx 的主动健康检查功能,有效地提高后端服务器的可用性和稳定性。文章详细介绍了该模块的安装和配置方法,并提供了使用该模块进行健康检查的示例代码。最后,本文总结了 nginx_upstream_check_module 的优点,推荐我们在实际应用中使用该模块来提高服务的可靠性和稳定性。

JudithHuang的博客 1915
上一篇: Java集合之一—HashMap
下一篇: TiDB 最佳实践系列(三)乐观锁事务
wrr-cat
博客等级 码龄9年 128粉丝 302原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值