spark stream消费kafka Exactly-once

基于PySpark整合Spark Streaming与Kafka 本文介绍了基于PySpark整合Spark Streaming和Kafka实现实时消息处理的方案。首先搭建了单机Kafka环境(版本2.11-2.4.0),配置了Zookeeper和Kafka服务,并测试了消息生产消费功能。然后详细说明了Spark Streaming连接Kafka所需的两个关键JAR包,给出了PySpark程序示例,演示了如何通过KafkaUtils.createDirectStream接口实时消费Kafka消息并进行单词计数。程序采用Direct API模式,每5秒统计一次单词频率并输出 阅读详情
  • 精确一次消费(Exactly-once)
    是指消息一定会被处理且只会被处理一次。不多不少就一次处理
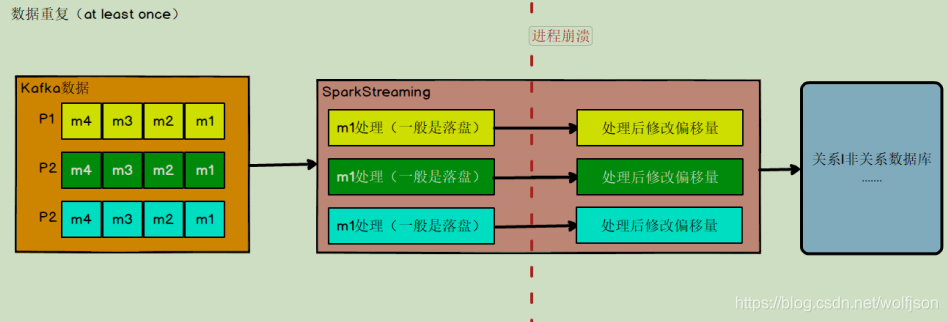
  • 至少一次消费(at least once)
    主要是保证数据不会丢失,但有可能存在数据重复问题
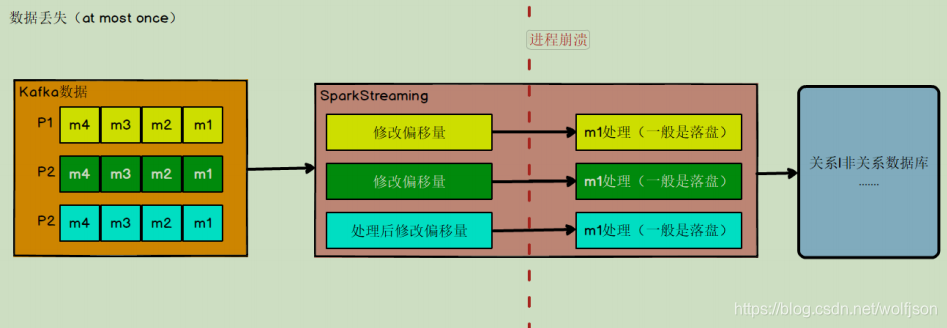
  • 最多一次消费 (at most once)
    主要是保证数据不会重复,但有可能存在数据丢失问题

数据丢失

  • 实时计算任务进行计算,到数据结果存盘之前,进程崩溃,假设在进程崩溃前 kafka
    调整了偏移量,那么 kafka 就会认为数据已经被处理过,即使进程重启,kafka 也会从新的
    偏移量开始,所以之前没有保存的数据就被丢失掉了
    数据丢失

重复消费

  • 如果数据计算结果已经存盘了,在 kafka 调整偏移量之前,进程崩溃,那么 kafka 会
    认为数据没有被消费,进程重启,会重新从旧的偏移量开始,那么数据就会被 2 次消费,
    又会被存盘,数据就被存了 2 遍,造成数据重复。
    kafka重复消费
目前 Kafka 默认每 5 秒钟做一次自动提交偏移量,这样并不能保证精准一次消费
enable.auto.commit 的默认值是 true;就是默认采用自动提交的机制。
auto.commit.interval.ms 的默认值是 5000,单位是毫秒。

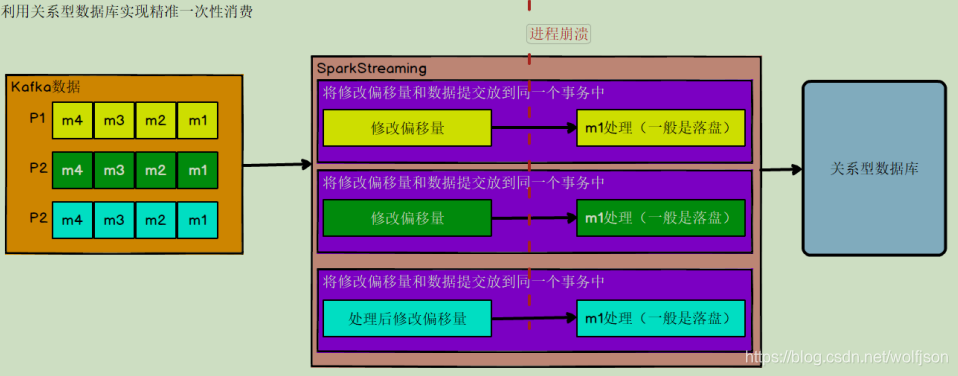
利用关系型数据库的事务进行处理

  • 偏移量的提交与数据的保存,不是原子性的。如果能做成要么数据保存和偏移量都成功,要么两个失败,那么就不会出现丢失或者重复了。
  • 数据必须都要放在某一个关系型数据库中,无法使用其他功能强大的 nosql 数据库
  • 事务本身性能不好
  • 如果保存的数据量较大一个数据库节点不够,多个节点的话,还要考虑分布式事务
    的问题。分布式事务会带来管理的复杂性,一般企业不选择使用,有的企业会把分
    布式事务变成本地事务,例如把 Executor 上的数据通过 rdd.collect 算子提取到
    Driver 端,由 Driver 端统一写入数据库,这样会将分布式事务变成本地事务的单
    线程操作,降低了写入的吞吐量
    关系数据库事务处理

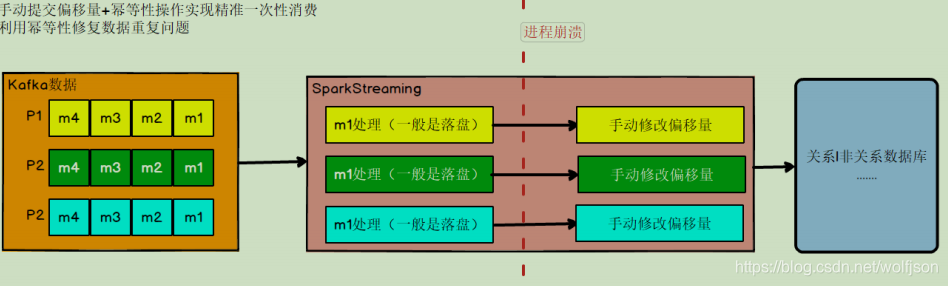
手动提交偏移量+幂等性处理

  • 数据丢失问题,办法就是要等数据保存成功后再提交偏移量,所以就必须手工
    来控制偏移量的提交时机
  • 把数据的保存做成幂等性保存。即同一批数据反复保存多次,数据不会翻倍,保存一次和保
    存一百次的效果是一样的。利用数据存储的唯一约束、索引、主键保证插入、更新操作的幂等性
    手动offset
xxDstream.asInstanceOf[CanCommitOffsets].commitAsync(offsetRanges)
因为 offset 的存储于 HasOffsetRanges,只有 kafkaRDD 继承了他,所以假如我们对
KafkaRDD 进行了转化之后,其它 RDD 没有继承 HasOffsetRanges,所以就无法再获取
offset 了。
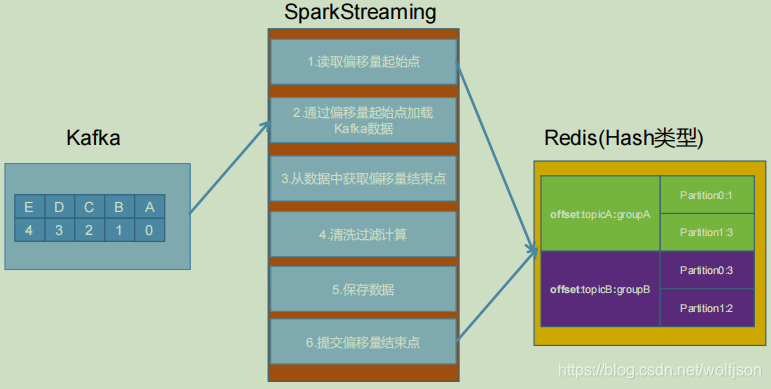
利用 ZooKeeper,Redis,Mysql 等工具手动对偏移量进行保存

kafka offset

  • 从Redis中获取偏移量
// type:hash   key: offset:topic:groupId   field:partition   value: 偏移量
  def getOffset(topic: String, groupId: String): Map[TopicPartition, Long] = {
    //获取客户端连接
    val jedis: Jedis = MyRedisUtil.getJedisClient()
    //拼接操作redis的key     offset:topic:groupId
    var offsetKey = "offset:" + topic + ":" + groupId
    //获取当前消费者组消费的主题  对应的分区以及偏移量
    val offsetMap: util.Map[String, String] = jedis.hgetAll(offsetKey)
    //关闭客户端
    jedis.close()

    //将java的map转换为scala的map
    import scala.collection.JavaConverters._
    val oMap: Map[TopicPartition, Long] = offsetMap.asScala.map {
      case (partition, offset) => {
        println("读取分区偏移量:" + partition + ":" + offset)
        //Map[TopicPartition,Long]
        (new TopicPartition(topic, partition.toInt), offset.toLong)
      }
    }.toMap
    
    oMap
  }
  • 将偏移量信息保存到Redis中
 def saveOffset(topic: String, groupId: String, offsetRanges: Array[OffsetRange]): Unit = {
    //拼接redis中操作偏移量的key
    var offsetKey = "offset:" + topic + ":" + groupId
    //定义java的map集合,用于存放每个分区对应的偏移量
    val offsetMap: util.HashMap[String, String] = new util.HashMap[String, String]()

    //对offsetRanges进行遍历,将数据封装offsetMap
    for (offsetRange <- offsetRanges) {
      val partitionId: Int = offsetRange.partition
      val fromOffset: Long = offsetRange.fromOffset
      val untilOffset: Long = offsetRange.untilOffset
      offsetMap.put(partitionId.toString, untilOffset.toString)
    }

    val jedis: Jedis = MyRedisUtil.getJedisClient()
    jedis.hmset(offsetKey, offsetMap)
    jedis.close()
  }
  • 将数据批量的保存到ES中
 filteredDStream.foreachRDD {
      rdd => {
        //以分区为单位对数据进行处理
        rdd.foreachPartition {
          jsonObjItr => {
            val dauInfoList: List[(String, DauInfo)] = jsonObjItr.map {
              jsonObj => {
                .............
                val moreInfo = MoreInfo()
                (moreInfo.mac, moreInfo)
              }
            }.toList

            //将数据批量的保存到ES中
            val dt: String = new SimpleDateFormat("yyyy-MM-dd").format(new Date())
            MyESUtil.bulkInsert(list, "index_more_info")
          }
        }
        //提交偏移量到Redis中
        OffsetManagerUtil.saveOffset(topic, groupId, offsetRanges)
      }
spark/flink + kafka 是如何做到 exactly once的? 端到端Exactly Once的含义就是:Source的每条数据会被处理有且仅有一次,并且输出到Sink中的结果不重不丢。 Flink和Spark structure streaming能否做到端到端的exactly once?是可以的。由于原理类似,接下来拿spark举例分析一下。 kafka有关详细内容请看: KIP-98 - Exactly Once Delivery and Transactional Messaging - Apache Kafka - Apache Software Fou 阅读详情

相关推荐

Spark Streaming 3.5 消费 Kafka 数据:手动维护 MySQL Offset 实现 Exactly-Once 语义

本文详细介绍了如何使用Spark Streaming 3.5消费Kafka数据,并通过手动维护MySQL Offset实现Exactly-Once语义。文章涵盖了实时数据处理的挑战、架构设计、完整实现方案以及生产环境优化策略,帮助开发者构建高可靠性的实时数据管道。

weixin_33806300的博客 358

Kafka+Spark Streaming如何保证exactly once语义

在Kafka、Storm、Flink、Spark Streaming等分布式流处理系统中(没错,Kafka本质上是流处理系统,不是单纯的“消息队列”),存在三种消息传递语义(message delivery semantics),分别是: at least once:每条消息会被收到1次或多次。例如发送方S在超时时间内没有收到接收方R的通知(如ack),或者收到了R的报错,就会不断重发消息直至R...

qq_28203321的博客 403

【kafka】在 Kafka Streams 中启用 Exactly-Once

1.概述 翻译: Enabling Exactly-Once in Kafka Streams 这篇博文是关于 Apache Kafka ®的恰好一次语义的系列文章中的第三篇,也是最后一篇。参见Exactly-once Semantics are possible:这是本系列第一篇文章的Kafka 是如何做到的,它对 Kafka的消息传递和处理语义进行了高级介绍;和Apache Kafka中的事务是本系列的第二篇文章,它涵盖了 Kafka 中新添加的事务机制,该机制被用作支持语义的主干。 在这篇博文中,我们

九师兄 542

SparkStreaming踩坑之Kafka重复消费

1.问题描述 使用SparkStreaming连接Kafka的demo程序每次重启,都会从Kafka队列里第一条数据开始消费。 修改enable.auto.commit相关参数都无效。 2.原因分析 demo程序使用"KafkaUtils.createDirectStream"创建Kafka输入流,此API内部使用了Kafka客户端低阶API,不支持offset自动提交(提交到zookee...

xianyuxiaoqiang的专栏 3735

全本地AI代理实战:零数据外泄的本地化Agent工作流搭建

全本地AI代理是一种将大语言模型推理、长期记忆与工具调用完全运行于用户本地设备的智能体架构,其核心原理在于通过进程隔离与标准化协议实现模型层、记忆层和工具层的解耦协同。相比依赖云端API的传统方案,它在数据主权、响应确定性与环境复现性上具备不可替代的技术价值。典型应用场景包括法务合规文档处理、离线工业现场辅助决策、以及高敏感度企业知识管理。本文聚焦Qwen2+Ollama+SurrealDB+Agno技术栈,详解如何构建可落地的全本地AI代理系统,覆盖从硬件适配、向量记忆建模到多模态插件协同的完整链路。

weixin_34194964的博客 650

手动以及使用torch.nn实现前馈神经网络实验

手动以及使用torch.nn实现前馈神经网络 手动实现前馈神经网络解决上述回归、二分类、多分类任务 利用torch.nn解决上述回归、二分类、多分类任务 在多分类任务中使用至少三种不同的激活函数 对多分类任务中的模型评估隐藏层层数和隐藏单元个数对实验结果的影响

m0_52910424的博客 9372

Kafka的Exactly Once和事务

Kafka的实现 RocketMQ RocketMQ原声支持事务。

define_us的专栏 3388

【AI智能体】Coze 数据库从使用到实战操作详解

Coze 数据库使用到实战详解

congge 5913

spark的kafka的低阶API createDirectStream

大家都知道在spark1.3版本后,kafkautil里面提供了两个创建dstream的方法,一个是老版本中有的createStream方法,还有一个是后面新加的createDirectStream方法。关于这两个方法的优缺点,官方已经说的很详细(http://spark.apache.org/docs/latest/streaming-kafka-integration.html),总之就是cr...

kw-home 893

【DRAM存储器四十三】LPDDR5介绍--寻址

简要说明LPDDR5 X16、x8 die的寻址

highman110的博客 967

RK平台以太网设置中添加代理设置

以太网中配置Configuration的时候可以IpConfiguration的初始化函数来设置代理类型和代理参数。通过添加一个KEY_ETH_PROXY的选项来设置代理的配置,然后再设置以太网静态或者动态的类型时候下发给系统进行设置。

Android系统开发笔记 656

SparkKafka问题总结

大家都知道在spark1.3版本后,kafkautil里面提供了两个创建dstream的方法,一个是老版本中有的createStream方法,还有一个是后面新加的createDirectStream方法。关于这两个方法的优缺点,官方已经说的很详细(http://spark.apache.org/docs/latest/streaming-kafka-integration.html),总之就是cr...

混沌初开 844

开源数字人、虚拟直播部署教程

对,你无看错,是欧美的。在直播带货案例里,我们把模型导入到ue4,我们给模型在ue4里预设了四个动作(站着、站着说话、坐着、坐着说话),三个表情(平静、开发、愤怒),三个镜头(全局、近矩说话、看显示器播放商品展示)。我们只需要把目标主播的直播给录制下来,提取样本数据,然后训练一个从粉丝的不同刺激的组合,到主播的不同响应方式的多元逻辑回归的数学模型参数即可。

南七小僧的学海无涯 4560

Spark Streaming + Kafka + Redis状态管理 top100场景 Exactly Once

  最近面试蚂蚁金服一面的时候,和面试官聊项目问题的时候,发现我这边业务实现的top100场景好像没有实现exactly once语义,我们项目的offset是存储在zk中,然后业务处理完毕后,最后再提交offset更新到zk,这种时候就会出现一个问题就是如果业务处理完毕,数据已经更新到redis中进行了累加,然后offset更新zk没成功宕机了,再次重启的时候就会读取老的offset导致数据重复...

KLordy的博客 879

【AI智能体】Codex + Obsidian 打造专业知识库实战详解

Codex + Obsidian 搭建并操作知识库实战详解

congge 3090

【嵌入式Linux驱动开发】二十四、Linux I2C 驱动上手尝试

  人的前程关于眼界、关乎格局。   志之所趋,无远弗届,穷山复海不能限也;   志之所向,无坚不入,锐兵精甲不能御也。 一、I2C驱动框架简介   Linux内核将 I2C 驱动分为两部分: ①、 I2C 总线驱动, I2C 总线驱动就是 SOC 的 I2C 控制器驱动,也叫做 I2C 适配器驱动。 ②、 I2C 设备驱动, I2C 设备驱动就是针对具体的 I2C 设备而编写的驱动。 1....

悟已往之不谏 知来者之可追 1068

Spark streaming 跟踪kafka offset的问题研究

spark streaming对kafka offset的默认处理比较极端,本博研究了如何在不大幅牺牲流计算处理能力的前提下,通过spark streaming管理kafka offset,来尽量保证消息处理的可靠性。

qfwyp0714的博客 1483

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

Spark Streaming整合kafka实战

kafka作为一个实时的分布式消息队列,实时的生产和消费消息,这里我们可以利用SparkStreaming实时计算框架实时地读取kafka中的数据然后进行计算。在spark1.3版本后,kafkaUtils里面提供了两个创建dstream的方法,一种为KafkaUtils.createDstream,另一种为KafkaUtils.createDirectStream。1.KafkaUtils.cr...

布里啾啾迪布利多的博客 2万+

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Spark 3.2.0 与 Flink 1.13 流处理对比:Kafka 数据写入的 3 种模式与性能差异

本文深入对比了Spark 3.2.0与Flink 1.13在Kafka流处理中的性能差异与三种数据写入模式(接收器模式、直接连接模式、事务写入模式),通过基准测试数据揭示Flink在低延迟场景的优势(P99延迟85ms)以及Spark在批处理集成上的便利性。针对不同业务场景提供技术选型决策树,帮助开发者根据延迟要求、状态管理和精确一次语义等关键因素选择合适框架。

weixin_30325971的博客 878

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Spark Streaming:从入门到精通(四)[ 整合kafka]

整合kafka Kafka快速回顾 核心概念图解 Broker : 安装Kafka服务的机器就是一个broker Producer :消息的生产者,负责将数据写入到broker中(push) Consumer:消息的消费者,负责从kafka中拉取数据(pull),老版本的消费者需要依赖zk,新版本的不需要 Topic: 主题,相当于是数据的一个分类,不同topic存放不同业务的数据 --主题...

3739

Spark 3.5 + Kafka 3.6 实时数据管道:从性能调优到故障恢复的 5 个关键实践

本文详细介绍了Spark 3.5与Kafka 3.6构建实时数据管道的5个关键实践,包括Direct API参数调优、Executor消费者池化技术、基于MySQL的Offset管理与作业恢复、内存优化与故障排查指南以及端到端监控与性能调优。这些实践帮助中高级工程师提升数据处理系统的性能和可靠性,特别适用于高吞吐量场景下的消费与保存操作。

492

kafka-streaming偏移量管理

文章目录RuozeKafkaProducer.java用checkpoint记录偏移量用mysql记录偏移量MysqlOffsetApp RuozeKafkaProducer.java 先写一个kafka制造数据的东东 package com.ruozedata.bigdata.kafka; import kafka.javaapi.producer.Producer; import kafk...

qq_36459386的博客 912

如何管理Spark Streaming消费Kafka的偏移量(三)

前面的文章已经介绍了在spark streaming集成kafka时,如何处理其偏移量的问题,由于spark streaming自带的checkpoint弊端非常明显,所以一些对数据一致性要求比较高的项目里面,不建议采用其自带的checkpoint来做故障恢复。 在spark streaming1.3之后的版本支持direct kafka stream,这种策略更加完善,放弃了原来使用Kaf

三劫散仙 7538
上一篇: RabbitMQ实现支付订单延迟消息
下一篇: 实时计算-智慧大屏分析
架构师老狼
博客等级 码龄14年 44粉丝 57原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值