Python预测全家桶小白版,重大更新!建议所有人都下载!

bp神经网络预测python代码_纯Python搭建一个深度神经网络并用于房价预测 背景深度神经网络模型是当前火热的人工智能的基石,深度神经网络模型可以应用于房价预测、股票预测、人脸识别、自动驾驶等各种场景。本文将详细讲解如何使用python从零开始搭建一个神经网络模型,并应用于房价预测。摘要房价数据介绍深度神经网络介绍神经网络前后向传播计算详解训练深度神经网络模型并预测房价总结代码话不多说,先上代码。人生苦短,我爱python。https://github.com/h... 阅读详情

截止到本期,一共发了11篇关于机器学习预测全家桶Python代码的文章。参考往期文章如下:

1.终于来了!python机器学习预测全家桶

2.机器学习预测全家桶-Python,一次性搞定多/单特征输入,多/单步预测!最强模板!

3.机器学习预测全家桶-Python,新增CEEMDAN结合代码,大大提升预测精度!

4.机器学习预测全家桶-Python,新增VMD结合代码,大大提升预测精度!

5.Python机器学习预测+回归全家桶,再添数十种回归模型!这次千万别再错过了!

6.Python机器学习预测+回归全家桶,新增TCN,BiTCN,TCN-GRU,BiTCN-BiGRU等组合模型预测

7.调用最新mealpy库,实现215个优化算法优化CNN-BiLSTM-Attention,电力负荷预测

8.Transformer实现风电功率预测,python预测全家桶

9.几个小创新模型,KAN组合网络(LSTM、GRU、Transformer)时间序列预测

10.几个小创新模型,KAN组合网络(LSTM、GRU、Transformer)回归预测

11.接着更!seq2seq、wavenet、bert、informer、RNN时间预测模型

从推出python预测全家桶以来,即便很多案例注释已经写的很清楚了,但是后台经常收到数据替换不友好,小白学起来还是费劲等等的留言,这也怪我,是我写的不够简单明了!本期对python全家桶来一个重大更新, 彻底解决小白替换数据困难,模型切换繁琐,网络参数修改复杂的问题。

本期更新内容如下:

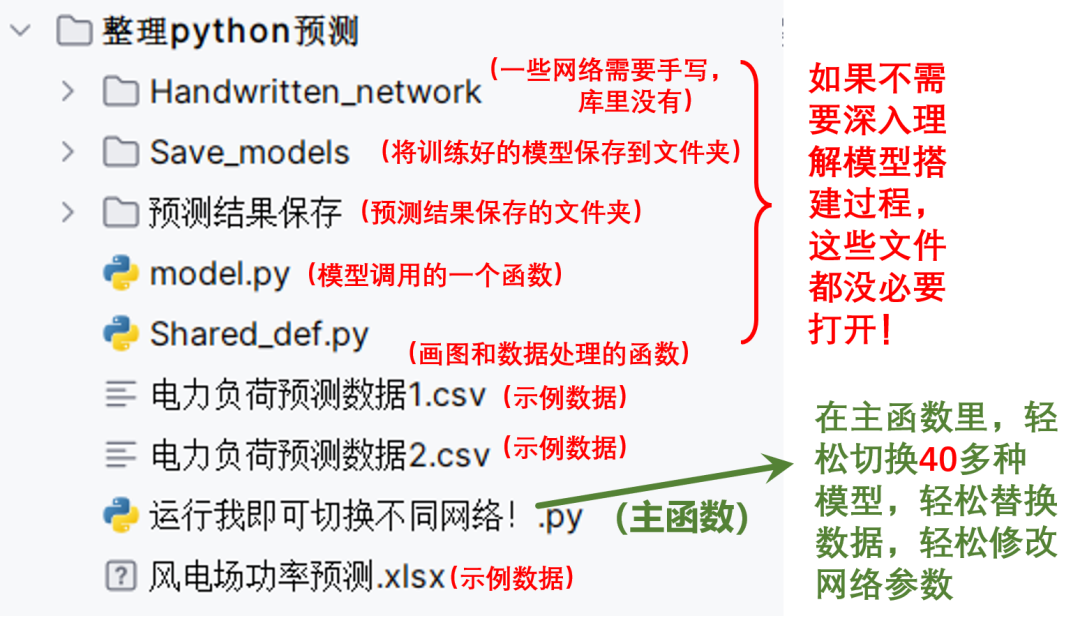
1.模型函数化,文件目录更简单明了,集合了40余种常见或新颖的模型。文件夹如下:
a7baa5063c87d7a878e30b2cb086a15d.png

是不是一目了然了!原先的预测全家桶,打开之后一堆主文件,导致小白拿到手后,不知道哪个能运行哪个不能运行,现在好了,作者将所有的模型写成了函数,这样真的很方便小伙伴对各个模型进行调用,代码也更易理解了!

目前集合的模型大致如下:

CNN_BiLSTM、CNN_BiLSTM_Attention、Bagging、BiGRU、
BiGRU_Attention、BiLSTM、BiLSTM_Attention、BiTCN_BiGRU、
BiTCN_GRU、BiTCN_LSTM、BP、CART、CNN_BiGRU_Attention、
CNN_BiGRU、CNN_GRU_Attention、CNN_GRU、CNN_LSTM_Attention、
CNN_LSTM、ELM、GradientBoost、GRU、GRU_Attention、LSTM、
LSTM_Attention、RandomForest、RBF、SVR、TCN、TCN_RNN、TCN_LSTM、
TCN_GRU、TCN_BiGRU、XGBOOST、Transformer、BiLSTM_KAN、
 GRU_KAN、LSTM_KAN、Transformer_KAN、 seq2seq、RNN、
 wavenet、bert、informer

另外还包括一些双分解预测,智能优化算法结合模型的代码,这里就不再一一列出。

除此之外,在这里透露一下最近要出一期调用智能优化算法meaply库,实现对所有模型一键调用的代码,这样可以一下子采用上百种算法结合这些模型进行优化了,代码初步框架已经写好,就差调试与测试了,可以浅浅期待一下!

2. 主函数十分简单即可切换模型,预留了各模型接口参数,方便小白一键更改。主函数代码如下:

if __name__ == '__main__':
    dataset = pd.read_excel("风电场功率预测.xlsx")  #这里修改你的数据!
    # dataset=pd.read_csv("电力负荷预测数据2.csv",encoding='gb2312')
    # 参数'encoding'设置为'gbk',这通常用于读取中文字符,确保文件中的中文字符能够正确读取。
    # 读取的数据被存储在名为'dataset'的DataFrame变量中。
    # print(dataset)  # 显示dataset数据
    # 单输入单步预测,就让valuess等于某一列数据,n_out = 1,n_in, num_samples, scroll_window 根据自己情况来
    # 单输入多步预测,就让valuess等于某一列数据,n_out > 1,n_in, num_samples, scroll_window 根据自己情况来
    # 多输入单步预测,就让valuess等于多列数据,n_out = 1,n_in, num_samples, scroll_window 根据自己情况来
    # 多输入多步预测,就让valuess等于多列数据,n_out > 1,n_in, num_samples, scroll_window 根据自己情况来
    ## 总结一下案例,需要哪个,就把哪个案例对照着改即可!
 
    ## 开始实验!!只改下面三行即可切换案例!!
    n_in = 8  # 输入前8个时刻的数据
    n_out = 1  # 预测未来一个时刻的负荷
    valuess = dataset.values[:, 1:]  # 只取第2列数据,要写成1:2;只取第3列数据,要写成2:3,取第2列之后(包含第二列)的所有数据,写成 1:,这时候就是多特征输入
    # 确保所有数据是浮动的
    valuess = valuess.astype('float32')
    # 将values数组中的数据类型转换为float32。
    # 这通常用于确保数据类型的一致性,特别是在准备输入到神经网络模型中时。
    or_dim = valuess.shape[1]  # 记录特征数据维度
    scroll_window = 1  # 如果等于1,下一个数据从第二行开始取。如果等于2,下一个数据从第三行开始取
    num_samples = 3000  # 可以设定从数据中取出多少个点用于本次网络的训练与测试。
    # 注意这里num_samples并不是数据的行数,因为数据在整理的时候,需要多步预测1步,或者预测多步,那么最后一个样本将会占据多行,因此一般要设置少于数据的行数
    train_ratio = 0.8  #训练集比例
    #调用数据整理的函数,关于测函数的机理是什么,请跳转Shared_def函数中查看data_collation的注释
    vp_train, vp_test, vt_train, vt_test, m_out,Ytest = data_collation(valuess, n_in, n_out, or_dim, scroll_window, num_samples,train_ratio)


    # 接下来就开始调用模型并开始训练喽!
    '''
        参数设置和模型选择
        可选模型有:把以下模型赋值给  flag变量即可!
       
        CNN_BiLSTM、CNN_BiLSTM_Attention、Bagging、BiGRU、BiGRU_Attention、BiLSTM、BiLSTM_Attention、BiTCN_BiGRU、BiTCN_GRU、BiTCN_LSTM
        BP、CART、CNN_BiGRU_Attention、CNN_BiGRU、CNN_GRU_Attention、CNN_GRU、CNN_LSTM_Attention、CNN_LSTM、ELM、GradientBoost、GRU
        GRU_Attention、LSTM、LSTM_Attention、RandomForest、RBF、SVR、TCN、TCN_RNN、TCN_LSTM、TCN_GRU、TCN_BiGRU、XGBOOST、Transformer、
        BiLSTM_KAN、 GRU_KAN、LSTM_KAN、Transformer_KAN、 seq2seq、RNN、wavenet、bert、informer
        
        提示:经检测,GradientBoost、SVR只适用于单步输出,多步输出时会报错,这是官方的包所致,因此在用这两个方法时,请将n_out改为1
        部分模型无法保存(只是一少部分)
    '''
    # 修改这里的flag即可切换不同的模型
    flag = 'LSTM_KAN'
    epochs = 80  #训练次数
    batch_size = 12  #最小批训练大小
    learning_rate = 1e-4  #学习率
    fit_or_not = 1 #是否重新训练,如果要改为0,请保证至少已经训练过一次了。
    # fit_or_not:,直接加载已保存的模型还是重新训练,本程序具备保存模型的功能,
    # fit_or_not=1时,就重新训练模型(并保存模型到"模型保存"文件夹里),
    # fit_or_not=0时,就直接加载保存好的模型进行训练(当然你得先有保存好的模型哦)


    # 更多关于每个模型的参数设置,请在本页面的many_model定义中找到对应模型自己动手修改,都做好修改接口了,很方便。


    #调用模型,并进行训练,训练之后,直接返回训练集的预测结果,测试集的预测结果,模型的训练过程(方便画训练损失函数曲线)。
    (xunlian_predicted_data, ceshi_predicted_data) = many_model(flag,fit_or_not,epochs,batch_size,learning_rate,
                           vp_train, vp_test, vt_train, vt_test, m_out,n_out,n_in,or_dim)


    #调用已经写好绘图函数
    plot_result(valuess,ceshi_predicted_data, Ytest, n_in,n_out,flag)

只要修改上述代码中的变量——flag,即可任意切换不同的模型。

关于各个模型的参数修改也简单,举例如下:

if flag == 'CNN_BiLSTM':
   #更多参数请在这里设置!
   #四个参数分别为:CNN滤波器个数,滤波器大小,正则化参数,BiLSTM的隐含层神经元个数
    filters, kernel_size, Dropout, Hidden_size = 64,2,0.1,32   
    xunlian_predicted_data, ceshi_predicted_data = model.run_CNN_BiLSTM(filters, kernel_size, Dropout, Hidden_size)
 if flag == 'TCN_RNN':
   #四个参数分别为:TCN滤波器个数,滤波器大小,正则化参数,RNN的隐含层神经元个数
    nb_filters,kernel_size,dro,RNN_units = 64,2,0.2,128
    xunlian_predicted_data, ceshi_predicted_data = model.run_TCN_RNN(nb_filters,kernel_size,dro,RNN_units)

这样,大家只需要找到想要修改的模型,修改相应的参数即可!

3.可对预测后的模型进行保存,在代码主函数中加入了一个变量fit_or_not,选择1,则正常进行模型训练,选择0,则直接调用保存好的模型进行训练。

fit_or_not = 1 #是否重新训练,如果要改为0,请保证至少已经训练过一次了。
 # fit_or_not:,直接加载已保存的模型还是重新训练,本程序具备保存模型的功能,
 # fit_or_not=1时,就重新训练模型(并保存模型到"模型保存"文件夹里),
 # fit_or_not=0时,就直接加载保存好的模型进行训练(当然你得先有保存好的模型哦)

4. 有详细的关于数据替换的示例介绍:准备了四种案例,只要按照注释一一修改这三个参数即可!(就不信小白还不会改数据!)

'''
        #案例1:单特征输入,单步预测
        #请按照以下进行设置:采用前12个时刻的所有负荷数据,预测未来一个小时的负荷值。
        n_in = 12  # 输入前12个时刻的数据
        n_out = 1  # 预测未来一个时刻的负荷
        valuess = dataset.values[:,-1:] #因为是单特征输入,那么就只输入最后一列负荷值就行了。 -1表示倒数第一列,注意看清楚,这里是 -1:
    '''
    '''
        #采用超前多步预测的时候,由于测试样本不止一个,因此绘图的时候,不可能全部都画出来,这里就挑出来一个测试样本进行绘图。
        # 案例2:单特征输入,超前多步预测
        #请按照以下进行设置:采用前96个时刻的所有负荷数据,预测未来24个小时的负荷值。
        n_in = 96  # 输入前96个时刻的数据
        n_out = 24  # 预测未来24个时刻的负荷
        valuess = dataset.values[:,-1:] #因为是单特征输入,那么就只输入最后一列负荷值就行了。 -1表示倒数第一列,注意看清楚,这里是 -1:
    '''

    '''
        # 案例3:多特征输入,单步预测
        # 请按照以下进行设置:采用前8个时刻的所有特征数据(包括已知的负荷值),预测未来一个小时的负荷值。
        n_in = 8  # 输入前8个时刻的数据
        n_out = 1  # 预测未来一个时刻的负荷
        valuess = dataset.values[:,1:] #只取第2列数据,要写成1:2;只取第3列数据,要写成2:3,取第2列之后(包含第二列)的所有数据,写成 1:,这时候就是多特征输入
        因为这里原始数据第一列都是时间,所以才写成了1:,意思是去除了时间列
    '''

    '''
        #采用超前多步预测的时候,由于测试样本不止一个,因此绘图的时候,不可能全部都画出来,这里就挑出来一个测试样本进行绘图。
        # 案例4:多特征输入,超前多步预测(这种预测模型难度较大,因此精度不一定会好!!!)
        # 请按照以下案例:采用前7天数据,预测未来一天(24个小时)的负荷值。
        n_in = 24*7  # 输入前7天数据,每天有24个小时,因此这里是24*7
        n_out = 24*1  # 预测未来一天的负荷值,也就是24个小时。因此这里是24,。
        valuess = dataset.values[:,1:] #只取第2列数据,要写成1:2;只取第3列数据,要写成2:3,取第2列之后(包含第二列)的所有数据,写成 1:,这时候就是多特征输入
        因为这里原始数据第一列都是时间,所以才写成了1:,意思是去除了时间列
    '''

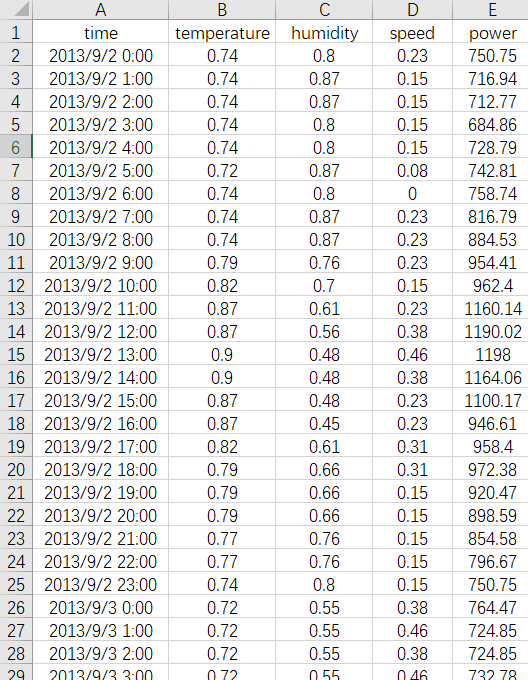
只要你的数据也是这种形式(第一列为时间列,2~n-1列为特征列,最后一列为预测列),完全可以按照上述参数设置,简单进行四种案列的切换。
ffb42328ca14e4018cd6395fbe24be0f.png

5.对预测结果进行保存,

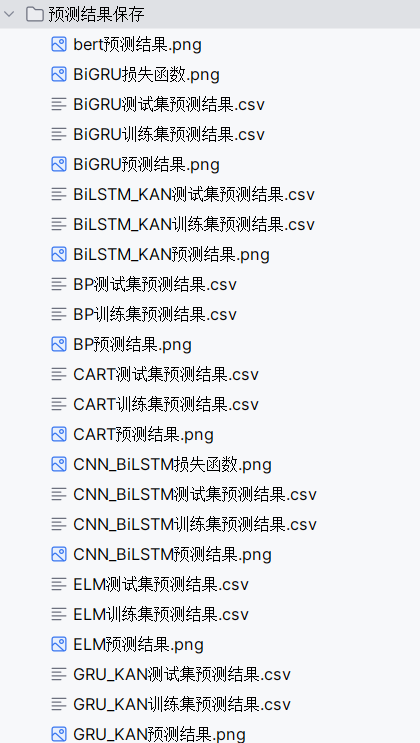
运行模型后,会将训练集的预测结果和测试集的预测结果保存到《预测结果保存》文件夹内,同时还会将预测结果图,损失函数曲线图都保存下来。
51b033b29d7ba8bdfde24a319598781c.png

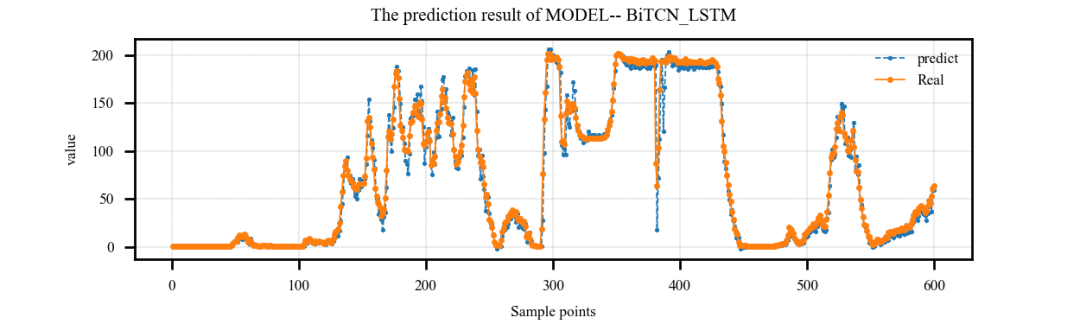
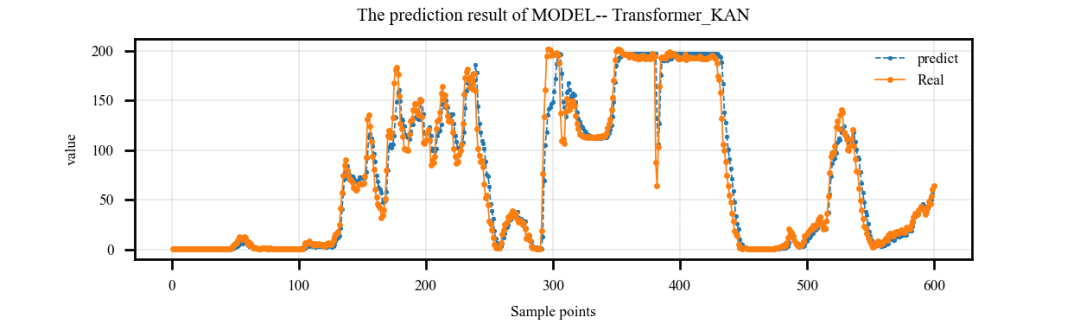
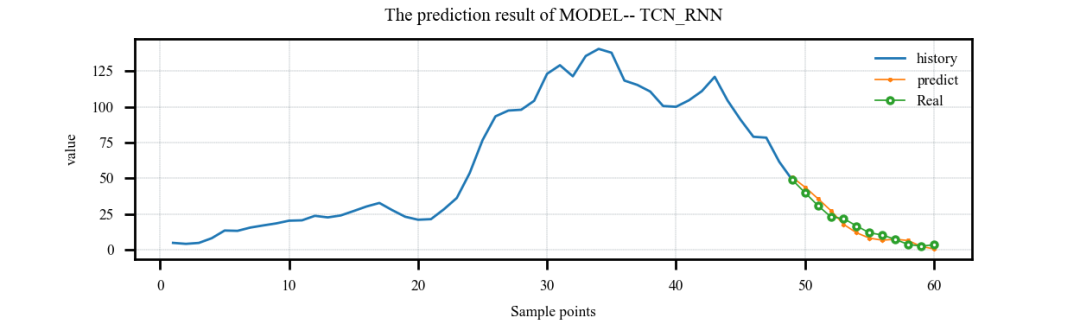
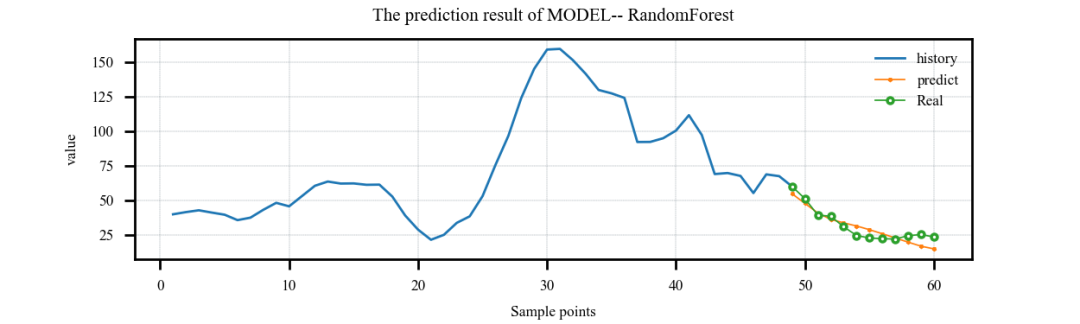
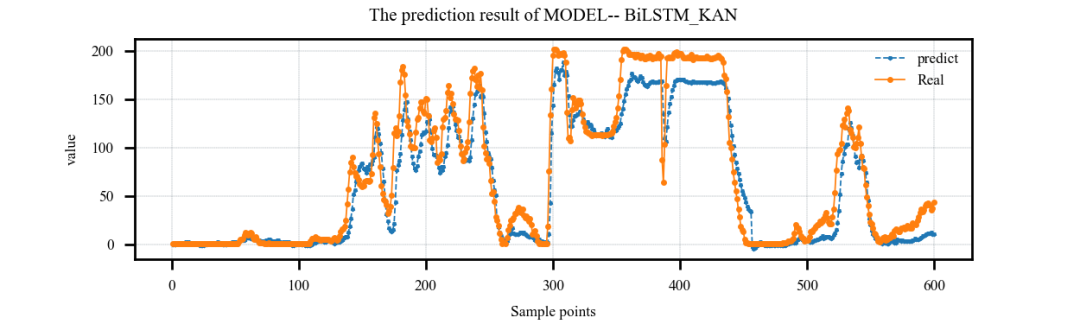
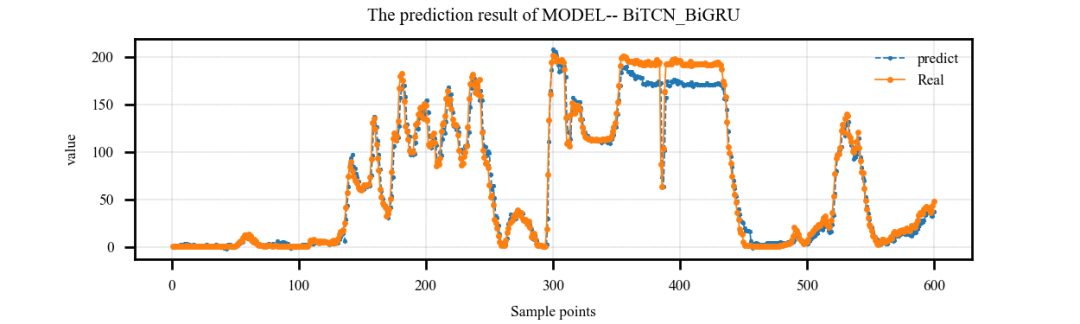
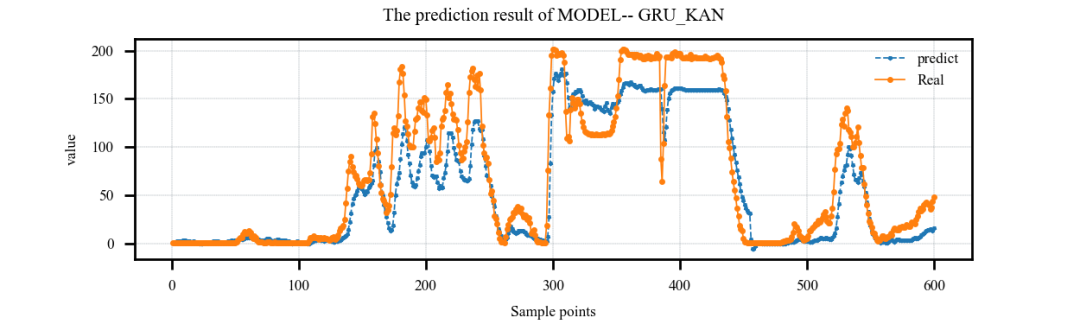
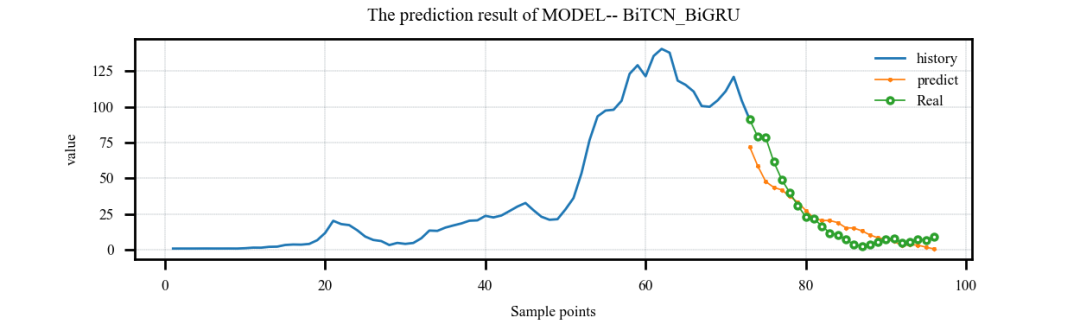
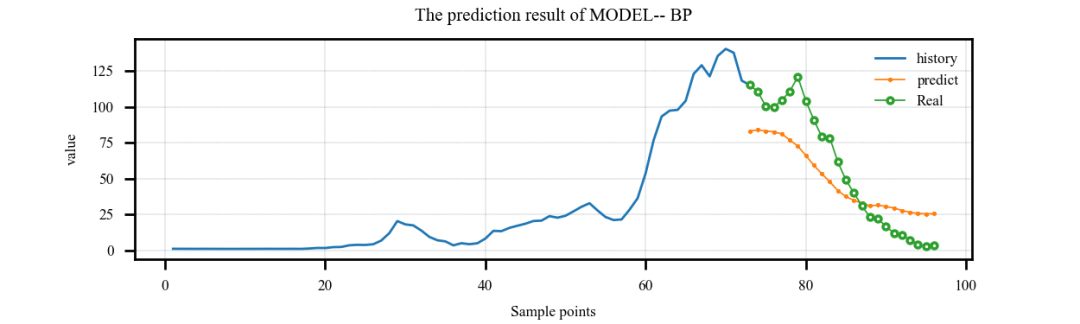
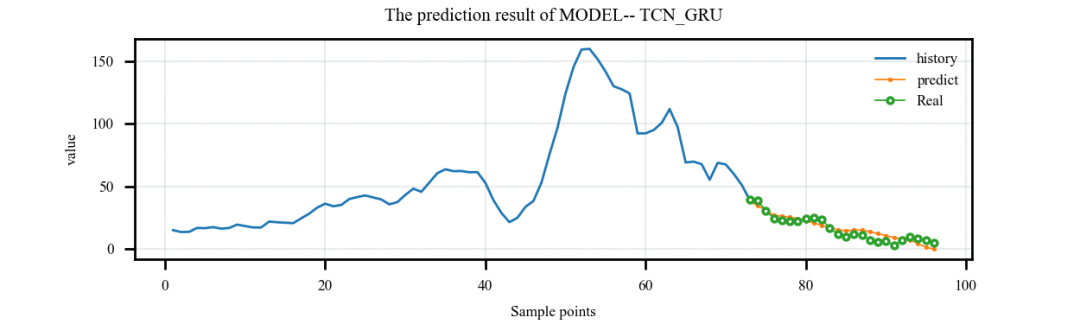
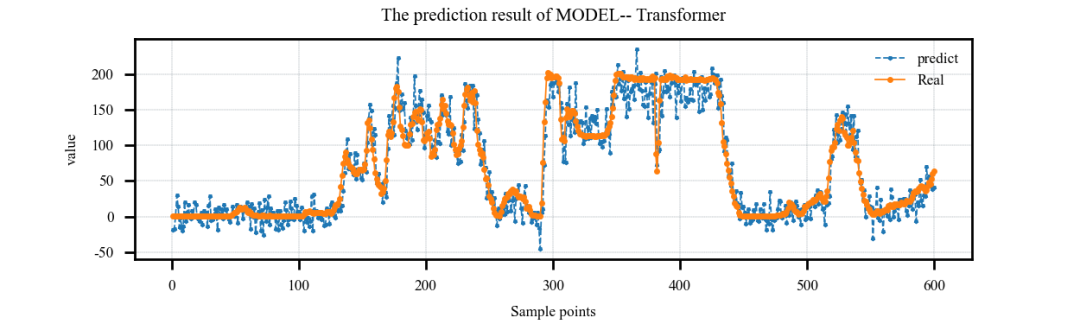
接下来让我们简单挑选几个模型进行结果展示吧!

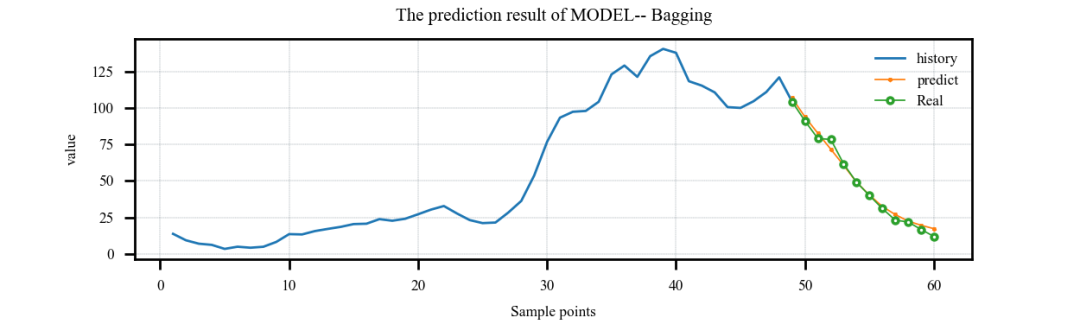
案例1:单特征输入,单步预测案例:
aea80a3fc0dccd5ac4d2ff7beb6c83ad.png

e70cfaaaaea3c3707529b56bb4688c72.png

8ea080fa314897c7ad6f323a936c276a.png

案例2:单特征输入,多步预测案例:

e37f2584ad6f8335d734d6757eab4770.png

dd011fc2d42a3a7db5346638ce84540c.png

0f0e441a92c7e55da3b5182c8df94313.png

案例3:多特征输入,单步预测案例:

9d32d1a2e69e292bee86ffa76f2a5f51.png

e9af85e7b8ad10271227a1cf507359d6.png

8cf1722c68bb91359dd66c8fa71c923d.png

案例4:多特征输入,多步预测案例:

30951ae1ad97e63e5b55ca62d5c63a2f.png

801fcd0322a9cf60aeb39e4204a56e36.png

64d9d8e7c51aa940fe1f3db69888d5ed.png

代码获取

已将本文代码更新至python预测全家桶。

后续会继续更新一些其他模型……敬请期待!

点击下方卡片关注,获取更多代码


python预测全家桶pip包推荐版如下:

tensorflow~=2.15.0
pandas~=2.2.0
openpyxl~=3.1.2
matplotlib~=3.8.2
numpy~=1.26.3
keras~=2.15.0
mplcyberpunk~=0.7.1
scikit-learn~=1.4.0
scipy~=1.12.0
qbstyles~=0.1.4
prettytable~=3.9.0
vmdpy~=0.2
xgboost~=2.0.3
mealpy~=3.0.1
torch~=2.3.1

推荐使用3.9版本的python哦!


Python必学资料全家桶 Python必学资料全家桶,包含单点登录、TCP/Ip、面向对象,《python高效开发实战——Django、tornado、flask、twisted》《轻量级Django》《flask web开发实战:入门、进阶与原理分析》。 立即下载

相关推荐

ceemdan-master_CEEMDAN_python_信号分解_

使用CEEMDAN进行分解,进行调用,直接可用,可以做信号的分析等。

Python环境全家桶(永久使用)

一、安装 本人一直是Java爱好者,第一次接触python,周围做爬虫或者信息AI开发的小伙伴都说Python语言简单,所以多学一点是没有坏处的,接下来是一个完全不懂Python的小白对安装和使用Python等一系列工作的记录,让您体验Python的“Hello World” 1.1下载 官网:https://www.python.org,下载对应环境的版本。 目前,Python有两个版本[2.x和3.x],这两个版本是不兼容的,目前,3.x版本越来越普及。 1.2安装 【报错】:.

毛毛雨的博客 4982

iOS反编译-hook微信之艾特所有人

all。

2501_90243249的博客 759

2023年Python全家桶宝典,学习路线和学习教程开源了(顶配版)

2023年Python全家桶宝典,学习路线和学习教程开源了(顶配版)

隔壁王叔的博客 334

candence layout快捷键

摁住鼠标左键再框选:选中 摁住鼠标右键再框选:放大 选中之后,滚动鼠标滚轮进行放大缩小。 F:回到全局 shift+V:缩小 键盘的箭头:移动视图 F1:显示帮助文档Candence help F2:保存 点击r,画出矩形时不双击鼠标,点击F3,可以设置尺寸。 Creat-Shape-Path Creat-Wiring-Bus:画多根线。F3设置线宽、间距等。 选中金属后,Shift+G画保护环guard ring。F3可以设置距离金属的间距、保护环的形状。 Path和Rectang

weixin_45861827的博客 2655

MAX96717实战:如何选择Host-to-Peripheral和Pass-Through I2C模式?附配置代码

本文深入解析MAX96717芯片的两种关键I2C模式:Host-to-Peripheral与Pass-Through。通过对比其核心差异、硬件连接考量及软件配置代码,为嵌入式开发者提供了清晰的模式选择策略与实战指南,帮助优化系统设计并避免常见通信故障。

weixin_29190573的博客 461

python 列表全家桶(典藏版)

列表?什么是列表,看完我,哦!恍然大悟

三岁学编程的博客 2217

8.2-12.4GHz喇叭天线设计

使用后处理模板的优化算法,对a1、h_horn、b1进行优化,各参数的优化区间即为之前计算得到的参数范围。由于矩形喇叭的辐射特型基本上是E面和H面扇形喇叭的结合,当波导中只是单模传播(只有TE波)时,矩形喇叭的口径可以通过远场公式推理出来。表示矩形喇叭的口径效率,进行最佳增益设计时,一般取值为0.5。从表中可以看出,该结构在8.58GHz的增益误差为2.68%>2.5%,需要对结构进行优化。建模完成,之后就是在矩形波导尾部添加波导端口激励,以及对应频率的远场监视器。,在这里,将频率定为区间的中心频率。

qq_48897427的博客 6658

最全总结 | 聊聊 Python 数据处理全家桶(Memcached篇)

本篇文章继续继续另外一种比较常用的数据存储方式:MemcachedMemcached:一款高性能分布式内存对象缓存系统,通过 内存缓存,以减少数据库的读取,从而分担数据库的压力,进而提高网站的加载速度Memcached,实际上是一套简洁的键值对存储系统,可以存储各种类型的数据,包含:字符串、对象、图像、文件、视频等由于 Memcached 的数据存储在内存中,因此重启服务或系统之后,数据会全部丢失;另外,当 Memcached 使用容量达到指定值时,会基于 LRU 算法,自动删除掉不使用的缓存。

公众号【伤心的辣条】资料领取~ 595

从VoLTE高清通话到5G新通话:手把手带你用Wireshark抓包分析QCI 1, 2, 5, 9的建立与切换过程

本文详细解析了从VoLTE高清通话到5G新通话的QCI(QoS Class Identifier)建立与切换过程,通过Wireshark抓包实战演示如何分析QCI 1、2、5、9的承载机制。内容涵盖QCI基础概念、实验环境搭建、VoLTE通话建立过程分析以及5G新通话中的QoS演进,为网络工程师和通信技术爱好者提供实用的技术指南和优化建议。

weixin_30788619的博客 342

逆变器方案(工频全套)工频正弦波逆变器开发板全套设计资

逆变器方案(工频全套)工频正弦波逆变器开发板,24V-72V通用12只TO-247封装MOS管,额定输出功率6500W以下;配有触摸屏操作界面,运行数据一目了然,带市电互补UPS功能,可选择电池优先或市电有限工作,我们的开发板均从实战角度出发,让您的学习更便捷,包含全套设计资料,PCB.原理图.源代码,程序均有中文注释,MCU选用美国微芯公的PIC-8位单片机,民用数字电源首选单片机,抗干扰能力强,运行稳定。...

m0_73494033的博客 892

搞懂Python工具全家桶!Anaconda、Python、PyCharm、VSCode、Jupyter关系一次说清!

想少折腾,直接装Anaconda(自带Python+Jupyter),再装PyCharm社区版(免费),从基础到项目都够用;喜欢轻量工具,装Python(单独装)+VSCode(装Python和Jupyter插件),灵活又不占内存;做数据分析,优先用(Anaconda里自带,或VSCode装插件),边写边出结果超爽!看完是不是清晰多了?如果还有工具使用疑问,比如“Anaconda怎么创建环境”“VSCode怎么装Python插件”,可以评论区问~原文、姿料 这里!

2501_93508870的博客 1570

Atlas 300I Duo - vllm部署Qwen3-VL-8B-Instruct

本文介绍了在Ascend NPU环境下部署Qwen3-VL-8B大语言模型的步骤。主要包括:1)安装驱动、docker和vllm镜像;2)创建特权容器并挂载设备与目录;3)进入容器安装指定版本的transformers;4)设置环境变量和NPU卡配置;5)启动vllm服务;6)测试API接口。部署过程涉及多块NPU卡的使用,需注意内存碎片化问题,最终通过vllm框架提供模型推理服务。

m0_50105717的博客 1561

215个优化算法优化30余个机器学习回归模型,Python预测全家桶再更新!

截止到本期,一共发了11篇关于机器学习预测全家桶Python代码的文章。参考往期文章如下:1.终于来了!python机器学习预测全家桶2.机器学习预测全家桶-Python,一次性搞定多/单特征输入,多/单步预测!最强模板!3.机器学习预测全家桶-Python,新增CEEMDAN结合代码,大大提升预测精度!4.机器学习预测全家桶-Python,新增VMD结合代码,大大提升预测精度!5.Python机...

淘个代码 1065

Allegro孔和线被做到器件里面如何解锁操作指导

在做PCB设计的时候,会遇到孔和线被做到器件的情况,当需要移动器件的时候,孔和线也会跟着移动。孔和线被做到器件里面如何解锁操作指导。

weixin_54787054的博客 1144

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Python机器学习预测+回归全家桶,再添数十种回归模型!这次千万别再错过了!...

截止到本期,一共发了3篇关于机器学习预测全家桶Python代码的文章。参考往期文章如下:1.机器学习预测全家桶-Python,一次性搞定多/单特征输入,多/单步预测!最强模板!2.机器学习预测全家桶-Python,新增CEEMDAN结合代码,大大提升预测精度!3.机器学习预测全家桶-Python,新增VMD结合代码,大大提升预测精度!机器学习预测全家桶包含了哪些?话不多说,直接看目录!第一级文件夹...

淘个代码 1361

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

基于麻雀优化算法SSA的预测模型——代码全家桶

包括基于麻雀优化算法的多特征变量序列预测、单变量预测模型

1157

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

机器学习预测全家桶-Python,新增CEEMDAN结合代码,大大提升预测精度!

截止目前,机器学习预测全家桶本期继续更新《机器学习预测全家桶-Python》,截止目前,全家桶包含代码目录如下:本期新增CEEMDAN相结合的代码,包含如下:CEEMDAN-CNN-BiGRU、CEEMDAN-CNN-BiLSTM、CEEMDAN-CNN-BiLSTM-Attention、CEEMDAN-CNN-LSTM、CEEMDAN-LSTM所谓CEEMDAN相结合的原理与VMD相结合原理是一...

淘个代码 836

Python预测全家桶小白版重大更新:用TaoToken统一Key跑通机器学习预测全流程

Python预测全家桶更新版用TaoToken统一Key跑通40+机器学习模型,只需改flag一行即可切换LSTM、Transformer等模型,告别401报错。本文提供可复制config.json与.env配置,含官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 接入说明。

weixin_32312889的博客 128

全网最低价 | 全家桶持续更新!

单步预测(八)CEEMDAN-TCN-Attention预测模型 注意:本模型继续加入单步预测模型代码全家桶中,之前购买的同学请及时更新下载!

1009

Python预测全家桶小白版重大更新:TaoToken统一Key接入机器学习预测流程

Python机器学习预测全家桶更新后,用TaoToken统一Key管理外部模型调用凭证,预测脚本只读环境变量。本文给出.env配置、requests调用片段与401、local proxy failed等报错对照表,并附最小连通性验证步骤,帮你把模型训练与鉴权解耦。官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42581846的博客 7

单步预测-风速预测模型代码全家桶

包括 完整的风速数据集, 以及已经生成制作好的数据集、标签,对应代码均可以运行

697

AI科研工具集成化实践:Codex科研Skill全家桶部署与应用指南

在人工智能技术快速发展的背景下,大型语言模型(LLM)和智能体(Agent)已成为提升科研效率的关键技术。其核心原理在于通过预训练模型理解自然语言指令,并执行特定任务。这些技术的价值在于能够将复杂的认知任务自动化,显著降低科研工作中的重复性劳动。在应用场景上,它们尤其适用于学术写作、文献分析、代码生成和图表绘制等环节。然而,工具碎片化问题导致工作流断裂,学习成本高昂。本文聚焦的Codex科研Skill全家桶,正是一个通过模块化Skill设计,将多种AI能力整合进统一工作流的集成化解决方案。它通过预置针对科研

weixin_33859231的博客 574

半天入门!锂电池剩余寿命预测(Python)

本期我们推出基于 Python 的锂电池剩余寿命预测合集:基于LSTM、CNN、BiGRU、TCN、Transformer、CNN-Transformer、Transformer-BiLSTM等系列预测模型全家桶,并提供丰富的实验

3631

Codex科研AI工具全家桶:从部署到实战的全流程指南

在人工智能技术日益普及的今天,大语言模型(LLM)和生成式AI正深刻改变着科研工作范式。其核心原理在于通过海量数据训练,使模型能够理解并生成符合人类需求的文本、代码乃至图表。这一技术价值在于将研究者从繁琐、重复性的工作中解放出来,显著提升科研效率与创造力。在应用场景上,AI辅助工具已广泛渗透到学术研究的全生命周期,从最初的选题构思、文献调研,到中期的论文撰写、数据可视化,再到后期的文本润色与模拟审稿。本文聚焦的“Codex科研Skill全家桶”,正是一个整合了上述多种AI能力的工具集合。它并非单一软件,而是

anvt77205的博客 421

【免费下载】 《利用Python进行数据分析(第二版)》资源下载:数据分析的进阶指南

《利用Python进行数据分析(第二版)》资源下载:数据分析的进阶指南 【下载地址】利用Python进行数据分析第二版1资源下载 本仓库提供《利用Python进行数据分析(第二版)1》的资源文件下载。该书是数据分析领域的经典著作,自2012年第一版出版以来,广受读者好评。第二版在第一版的基础上进行了全面更新和扩展,涵盖了...

gitblog_06641的博客 1468
上一篇: 2024新发表:瞬态三角哈里斯鹰优化器,原理详解,MATLAB代码免费获取
下一篇: 215个优化算法优化30余个机器学习预测模型,一键更改多/单输入,多/单步预测,Python预测全家桶
淘个代码_
博客等级 码龄7年 1万+粉丝 504原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

淘个代码_

不想刀我的可以选择爱我

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值