中科院一区论文复现,改进蜣螂算法,Fuch映射+反向学习+自适应步长+随机差分变异,Python代码...

智能优化算法 — 蜣螂优化算法(Dung beetle optimizer,DBO) 小时候,蜣螂还是比较多见的,还顽皮地将粪球给它弄走,或者给它来点障碍。现在放牛的几乎看不到了,蜣螂没东西可推了,也慢慢从我们的视线中消失了。2022年11月27日,东华大学沈波教授团队,继麻雀搜索算法(Sparrow Search Algorithm,SSA)之后,又提出了一种全新的群体智能优化算法——蜣螂优化(Dung beetle optimizer,DBO),主要模拟了蜣螂的「滚球、跳舞、觅食、偷窃和繁殖行为」。蜣螂,又称屎壳郎,以动物的粪便为食(口味很独特啊)。 阅读详情

有小伙伴后台不断留言,要求将蜣螂算法的MATLAB语言变更为Python语言。话不多说,安排!

本期文章采用Python代码复现一篇发表于2024年来自中科院一区TOP顶刊《Energy》的改进蜣螂算法

论文引用如下:

Li Y, Sun K, Yao Q, et al. A dual-optimization wind speed forecasting model based on deep learning and improved dung beetle optimization algorithm[J]. Energy, 2024, 286: 129604.

改进的蜣螂优化算法原理如下:

改进策略

改进点1: 融合Fuch混沌与逆向学习策略在种群初始化的应用

种群初始化在DBO中随机生成,会导致种群初始化分布不均匀,导致初始化种群的多样性。融合混沌和逆向学习策略进行群体初始化,将混沌初始化方法和逆向学习初始化策略相结合,以提高DBO的收敛速度。

Fuch混沌映射公式如下:
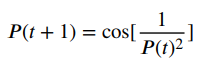
954375bf327ee11c747bb4416e29c0d0.png

在使用Fuch混沌映射生成初始解的同时,引入反向学习策略。扩大了蜣螂的搜索空间,以提高种群初始解决方案的质量。反向学习策略的数学表达式如下式所示:
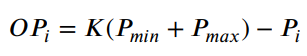
7845c399336ece60d99acb041f31ab4c.png

其中 OPi 是对应于每个初始解 Pi 的逆解。Pmax 和 Pmin 分别表示初始解中的最大值和最小值。K 是 (0, 1) 范围内的随机值。

改进点2: 自适应步长策略与凸透镜成像策略的集成

由于DBO采用随机策略,在蜣螂觅食阶段缺乏自适应能力,全局搜索能力较弱,容易陷入局部最优。为了进一步提高算法的寻道性能,该文采用动态选择策略,在一定概率下交替使用自适应步长策略和凸透镜成像反转策略来更新目标位置。

在初期迭代中,大步长能够扩展觅食搜索,提高算法的全局搜索能力,促进算法更快地找到更优的解,加快收敛速度。在后期迭代中,小步长有利于算法的局部搜索。步长的规律变化在觅食蜣螂的搜索中起着指导作用,这意味着在整体环境中从全局搜索逐渐过渡到局部搜索。该策略主要由线性递减的自适应步进控制因子α0决定,如下所示:

ba592bc52ccb134b7d9195f2d7f4f29f.png

同时,引入一种凸透镜成像学习策略来扰动蜣螂种群,以增强种群多样性,提高算法跳出局部最优的可能性。该等式表示如下:
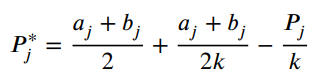
b8a4e5583009e0be0fc624f3d1aa35df.png

该策略在之前提出的改进算法中也有详细介绍,具体请看:三种策略改进的沙猫群优化算法(MSCSO)

目标位置更新采用哪种策略的选择由选择概率 Ps 决定,
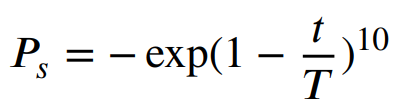
702cafffb17cadbbf5eedecd5bdae238.png

当随机值Ps<0.5时,采用随机步进策略对蜣螂进行位置更新;否则,凸透镜反向学习策略用于位置更新,如下方程所示:
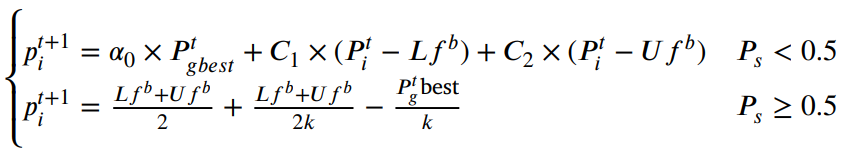
7104088c46cdd86e195f70415b3c1fda.png

改进点3: 随机差异变异策略

蜣螂偷窃行为的位置更新方程根据个体的当前最优值更新其位置,这可能导致种群多样性的减少。导致算法陷入局部最优状态,收敛精度效率低下。因此,本文引入随机差分变异策略来增强偷蜣螂种群多样性。公式如下:
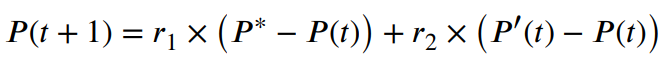
8eabbc4d824ad4496e9a84c1f70cae8d.png

其中 P (t+1)表示通过随机差异突变获得的新个体,r1 和 r2 是 [0,1] 范围内的随机值。P∗ 是当前最佳个人位置。P′(t)是从种群中随机选择的个体的位置。

结果展示

利用python强大的opfunu库,集成了CEC2005/2008/2010/2013等11个CEC函数库。

pip install opfunu  # 参考文档:https://github.com/thieu1995/opfunu

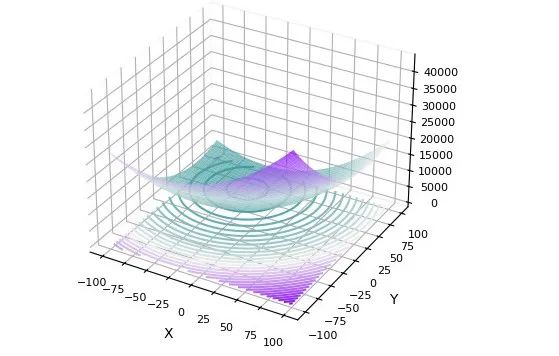
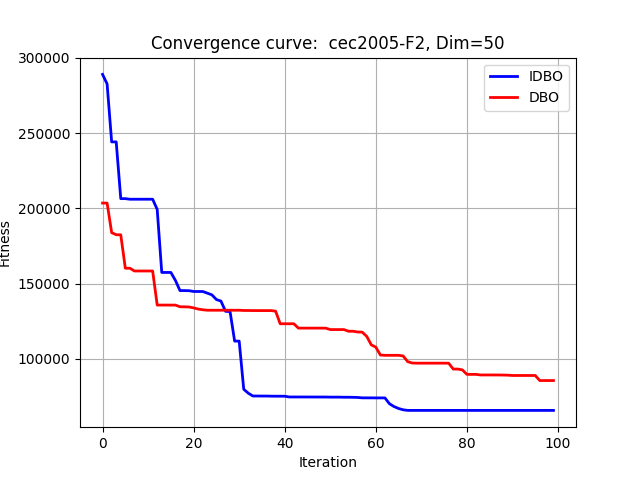
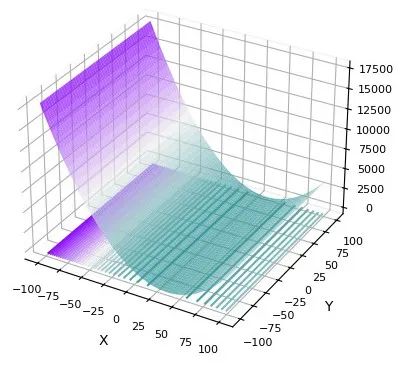
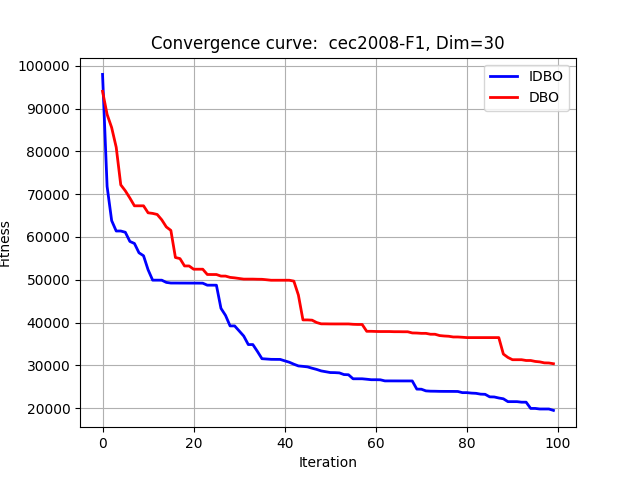
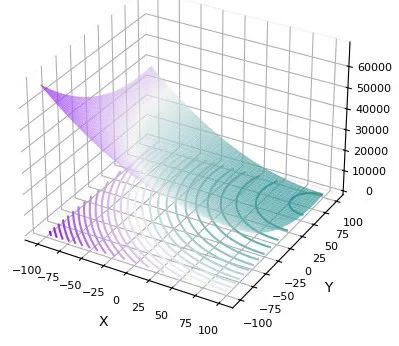
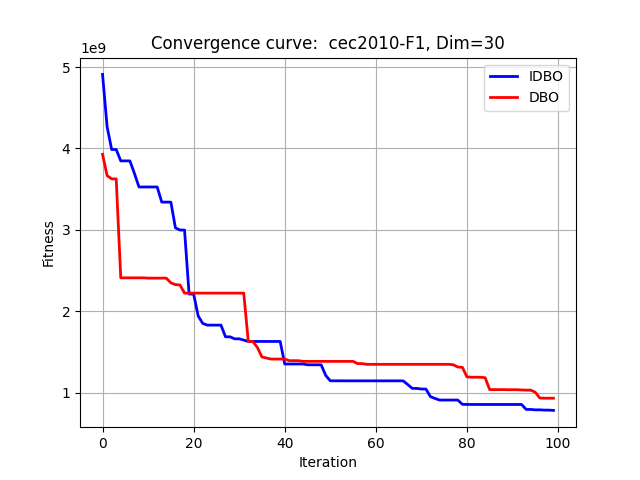
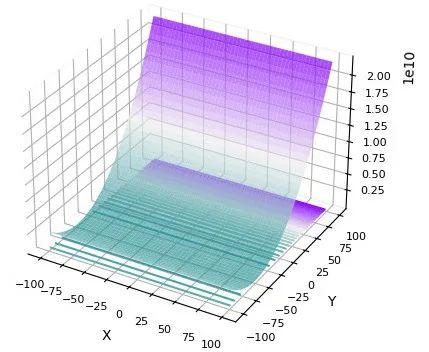
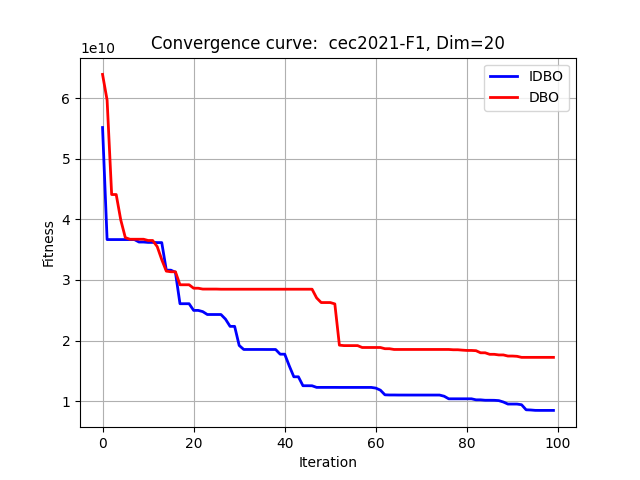
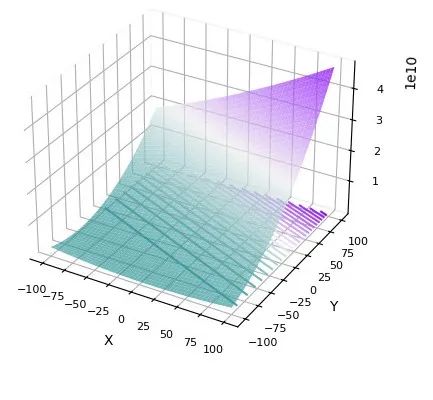
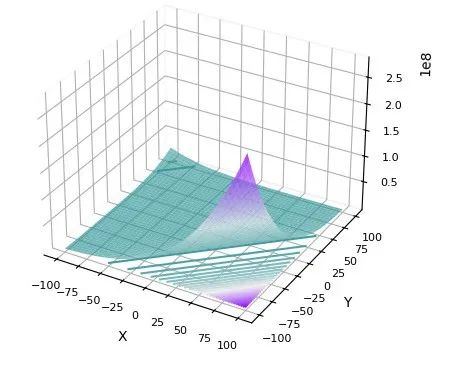
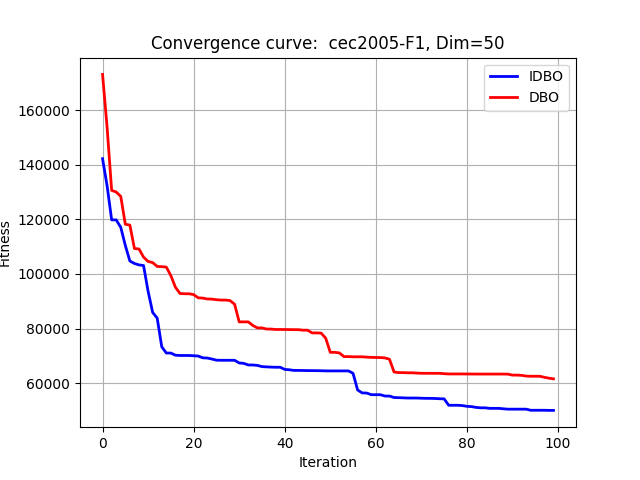
本期文章将改进的蜣螂算法与原始算法在多个CEC函数集上进行对比。并画出函数图像,迭代曲线。

在CEC2005中测试:

F1:
d81b0fd20a609540611ae3c7a3952017.png

8db672aedc1ae81608e8a7815fe8ebdd.jpeg

F2:

ce85ab4fc97b1d60f9d13424d3698f60.png

3c0a4fe8215640992563293374fa5686.jpeg

在CEC2008中测试:

F1:

54c72abac7e097c82a194cb8ec1a0b3b.png

c820413e90c22a12a9f4508039688021.jpeg

在CEC2010中测试:

1cc26570da30f4d7e9c13d2253cc9c48.png

8b565cee2f9db3f168329d045fdd7b5c.jpeg

在CEC2021中测试:

20ae32d1d5cad186ccb4624d0a6c42ed.png

095d0881431a2e0211379c8ff7acb6a4.jpeg

在CEC2022中测试:

bbb4d41786eafb6a84fb6f469eb058c9.png

cafc14656956d11d5c2d1bd628c88555.jpeg

其他函数集就不再一一展示。注意:改进的算法并非对任何函数效果都最佳,所有的改进算法只能保证对大部分函数有较好效果。

需要的包版本如下:

matplotlib~=3.8.2
numpy~=1.26.3
opfunu~=1.0.1

部分代码展示

import numpy as np
from matplotlib import pyplot as plt
# In[]:
import opfunu # 参考:https://github.com/thieu1995/opfunu
import copy  # 导入copy模块,用于对象的复制。
import math
'''
适应度函数及维度dim的选择
cec函数名字格式:函数名+年份,比如要选择2022的F1函数,func_num = 'F1'+'2022'
cec2005:F1-F25, 可选 dim = 10, 30, 50
cec2008:F1-F7,  可选 2 <= dim <= 1000
cec2010:F1-F20, 可选 100 <= dim <= 1000
cec2013:F1-F28, 可选 dim = 2, 5, 10, 20, 30, 40, 50, 60, 70, 80, 90, 100
cec2014:F1-F30, 可选 dim = 10, 20, 30, 50, 100
cec2015:F1-F15, 可选 dim = 10, 30
cec2017:F1-F29, 可选 dim = 2, 10, 20, 30, 50, 100
cec2019:F1-F10, 可选 dim: F1=9,F2=16,F3=18,其他=10
cec2020:F1-F10, 可选 dim = 2, 5, 10, 15, 20, 30, 50, 100
cec2021:F1-F10, 可选 dim = 2, 10, 20
cec2022:F1-F12, 可选 dim = 2, 10, 20


'''


'''边界检查函数'''
def boundary(pop, lb, ub):
    # 定义一个边界检查函数,确保种群中的个体不超出预定义的边界。
    pop = pop.flatten()
    lb = lb.flatten()
    ub = ub.flatten()
    # 将输入参数扁平化,以便进行元素级操作。


    # 防止跳出范围,除学习率之外 其他的都是整数
    pop = [int(pop[i]) if i > 0 else pop[i] for i in range(lb.shape[0])]
    # 将除了学习率以外的参数转换为整数。


    for i in range(len(lb)):
        if pop[i] > ub[i] or pop[i] < lb[i]:
            # 检查个体是否超出边界。
            if i == 0:
                pop[i] = (ub[i] - lb[i]) * np.random.rand() + lb[i]
                # 如果是学习率,则在边界内随机选择一个值。
            else:
                pop[i] = np.random.randint(lb[i], ub[i])
                # 对于整数参数,随机选择一个边界内的整数值。


    return pop
    # 返回修正后的个体。


''' 种群初始化函数 '''
def initial(pop, dim, ub, lb):
    # 定义一个初始化种群的函数。
    X = np.zeros([pop, dim])
    # 创建一个形状为[种群大小, 维度]的零矩阵。


    for i in range(pop):
        for j in range(dim):
            X[i, j] = np.random.rand() * (ub[j] - lb[j]) + lb[j]
            # 在边界内随机初始化每个个体的每个参数。


    return X, lb, ub
    # 返回初始化后的种群及边界。


'''计算适应度函数'''
def CaculateFitness(X):
    # 定义一个计算适应度的函数。
    pop = X.shape[0]
    # 获取种群的大小。
    fitness = np.zeros([pop, 1])
    # 创建一个形状为[种群大小, 1]的零矩阵来存储适应度。


    for i in range(pop):
        fitness[i] = cec_fun(X[i, :])
        # 对每个个体调用适应度函数进行计算。


    return fitness
    # 返回计算得到的适应度。


'''适应度排序'''
def SortFitness(Fit):
    # 定义一个对适应度进行排序的函数。
    fitness = np.sort(Fit, axis=0)
    # 按适应度大小进行排序。
    index = np.argsort(Fit, axis=0)
    # 获取排序后的索引。


    return fitness, index
    # 返回排序后的适应度和索引。


'''根据适应度对位置进行排序'''
def SortPosition(X, index):
    # 定义一个根据适应度排序位置的函数。
    Xnew = np.zeros(X.shape)
    # 创建一个与X形状相同的零矩阵。


    for i in range(X.shape[0]):
        Xnew[i, :] = X[index[i], :]
        # 根据适应度的排序结果重新排列位置。


    return Xnew
    # 返回排序后的位置。

本期代码获取

https://mbd.pub/o/bread/ZZuWkpts

扫面二维码亦可跳转:
d2ed09840a8ffde0316b45f6331861b0.png

或者点击下方阅读原文跳转链接。

混沌反向学习优化算法与Matlab实现 混沌反向学习优化算法是一种基于混沌序列和反向学习的新型优化算法。该算法通过引入混沌序列增加搜索空间,同时使用反向学习技术来改进灰狼优化算法并提高优化性能。本文将介绍混沌反向学习优化算法的基本原理和具体实现,并提供Matlab源代码供读者参考。在混沌反向学习优化算法中,混沌序列产生器主要用于扩大搜索空间,降低搜索过程中陷入局部极值的可能性,提高全局搜索能力。(2)反向学习:根据当前最优解,反向计算适应度函数的梯度,指导搜索方向。(1)混沌序列产生器:利用混沌函数生成混沌序列,扩大搜索空间。 阅读详情

相关推荐

21种混沌映射方法[代码]

本文介绍了21种常见的混沌映射方法及其在优化算法初始化中的应用。这些混沌映射方法包括Chebyshev、Circle、Gauss/mouse、Iterative、Logistic、Piecewise、Sine、Singer、Sinusoidal、Tent、Fuch、SPM、ICMIC、Tent-Logistic-Cosine、Sine-Tent-Cosine、Logistic-Sine-Cosine、Henon、Cubic、Logistic-Tent、Bernoulli和Kent映射。每种映射方法都详细描述了其数学表达式、控制参数取值以及混沌轨道状态值范围。文章还展示了这些混沌映射方法在种群初始化中的应用,并以2024年优化算法为例,对比了21种混沌改进策略在cec2005上的表现。最后,提供了获取Matlab代码的途径。

基于混沌透镜成像学习的哈里斯鹰优化算法

文章目录一、理论基础1、哈里斯鹰优化算法2、基于混沌透镜成像学习的哈里斯鹰优化算法(1)Fuch无限折叠混沌策略(2)黄金正弦策略(3)融合透镜成像学习和柯西变异策略二、仿真实验与结果分析三、参考文献 一、理论基础 1、哈里斯鹰优化算法 请参考这里。 2、基于混沌透镜成像学习的哈里斯鹰优化算法 (1)Fuch无限折叠混沌策略 Fuch为可无限折叠的混沌映射,比起传统的混沌映射,Fuch映射具有更佳的遍历性、动态性和收敛性等优点,因此,选用Fuch映射生成HHO初始种群。在FLHHO算法中,Fuch混沌映射值

心升明月的博客 1939

零成本实现飞牛 OS 内网穿透:CloudFlare 隧道搭建全攻略

一、引言:突破内网限制的最优解当你的内网环境中部署了飞牛 OS 系统(无论是老旧电脑还是 NAS 设备),想要实现公网访问时,传统方案往往面临两大痛点:公网 IP 申请困难且成本高DDNS 动态解析配置复杂专业内网穿透工具存在付费门槛今天为大家带来零成本解决方案:通过免费域名搭配 CloudFlare 隧道技术,无需公网 IP 即可轻松实现飞牛 OS 服务的公网访问。全程操作可视化,新手也能快速上手!二、前期准备:必备工具清单(1)域名准备。

Honmaple的博客 7498

Fuch混沌映射

一、Fuch混沌映射 Fuch混沌映射公式如下: 该映射具有对初值不敏感,遍历均衡和收敛较快等优点,且在初值不为0的情形下均能产生混沌。 二、Fuch混沌映射代码 x(1)=rand; for i=2:2000 x(i)=cos(1./x(i-1).^2);%Fuch end figure plot(x,'.') xlabel('维度') ylabel('混沌值') figure hist(x) xlabel('混沌值') ylabel('频数') 三、Fuch混沌映射图 3.1 Fuch混沌映射分布图

IT猿手 4475

MacBook 本地化部署 Dify 指南

dify 怎么安装部署 有哪些坑 !

weixin_44542598的博客 1529

C#图表开发避坑指南:Chart控件的Series和Points属性详解

本文深入解析C#图表开发中Chart控件的Series和Points核心属性,提供避坑指南。详细阐述了Series的数据序列管理、Points的高效操作与空值处理,以及多Series与ChartArea的协同配置,帮助开发者避免常见错误,实现稳定、高性能的数据可视化应用。

weixin_29313239的博客 365

优化算法改进策略:21种混沌映射方法-混沌初始化(附matlab代码)

将混沌映射方法与优化算法相结合是一种常见的改进方式。本期,并将21种混沌映射方法运用在算法的初始化中。

weixin_44028734的博客 7997

Kile5报错—> ARM-Compiler ‘Default Compiler Version 5‘ which is not available安装使用Compiler Version 5 的办法

Kile5报错—> ARM-Compiler ‘Default Compiler Version 5‘ which is not available安装使用Compiler Version 5 的办法

weixin_72050316的博客 1191

中科院一区论文复现,改进蜣螂算法,Fuch映射+反向学习+自适应步长+随机差分变异,MATLAB代码...

本期文章复现一篇发表于2024年来自中科院一区TOP顶刊《Energy》的改进蜣螂算法。论文引用如下:Li Y, Sun K, Yao Q, et al. A dual-optimization wind speed forecasting model based on deep learning and improved dung beetle optimization algorithm[J]...

淘个代码 4274

高匿反爬实战:Python打造无痕爬虫,规避风控系统追踪

网络层匿踪:核心是使用住宅IP代理池,按真实用户IP画像匹配,控制请求频率;协议层匿踪:动态生成请求头(每次都不同),参数添加随机噪声,避免规律化;行为层匿踪:模拟人类的非规律行为(贝塞尔轨迹、随机停顿、非精准点击);设备层匿踪:伪造Canvas/WebGL指纹,禁用webdriver标识,每次请求更换指纹;核心原则:无痕爬虫的本质是“无限接近真实用户”,所有维度都要消除爬虫特征,而非单一维度伪装。打造真正的无痕爬虫需要全维度的匿踪策略,单一维度的伪装极易被高级风控系统识别。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 2647

MicroChip的SmartFusion2的M2S090芯片的全流程开发环境搭建和Demo设计

MicroChip的SmartFusion2的M2S090芯片的全流程开发环境搭建和Demo设计

qq_45806640的博客 464

【Python代码免费下载】215种优化算法求解11种cec测试函数

是用于前沿数值优化基准函数的。

weixin_44028734的博客 1767

ADS基础教程16 - 存档和导入(workspace、cell、view)

选择workspace_Archive目录作为保存workspace归档的目录,点击打开进行目录选择,点击Finish保存目录。,选择cell_Archive目录作为保存cell归档的目录,点击打开进行目录选择,点击Finish保存目录。,选择view_Archive目录作为保存view归档的目录,点击打开进行目录选择,点击Finish保存目录。(2)在弹框中,可以选择点击Select将参考的条目添加进来,然后点击Next…(2)在弹框中,可以选择点击Select将参考的条目添加进来,然后点击Next…

XZ_ZC的博客 3710

基于混沌优化和自适应反向学习的秃鹰搜索算法

针对秃鹰搜索算法求解精度低、收敛速度较慢、容易陷入局部最优的问题,提出一种基于混沌优化和自适应反向学习的秃鹰搜索算法。首先,在选择搜索空间阶段引入正弦混沌映射更新秃鹰群位置,增加随机性,优化全局搜索能力;其次,在俯冲捕获猎物阶段加入指数自适应,平衡了全局搜索和局部搜索,同时加快收敛速度;最后,对更新后的最优秃鹰位置使用反向学习策略,提高跳出局部最优的可能性。选取12个测试函数对算法的性能进行了测试,结果表明本文改进的秃鹰搜索算法具有更优的求解精度和收敛速度。...

心升明月的博客 2698

MATLAB基础应用精讲-【深度强化学习】SAC(Soft Actor-Critic)算法(附MATLAB和python代码实现)

Actor 网络:用于选择动作。Critic 1 和 Critic 2 网络:用于估计 Q 值。Target Critic 1 和 Target Critic 2:与 Critic 网络架构相同,用于生成更稳定的目标 Q 值。,即在保证探索的情况下选择高价值动作。软更新目标 Q 网络参数,使得目标网络参数缓慢向当前网络靠近,避免振荡。

qq_36130719的博客 456

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

【选择自由,免费下载】215种优化算法求解11种cec测试函数-python代码

是用于前沿数值优化基准函数的。

weixin_44028734的博客 1614

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

一种多策略改进的麻雀搜索算法

针对麻雀搜索算法在求解复杂优化问题时存在收敛速度慢、种群趋同性严重、易于陷入局部最优等不足,提出一种多策略改进的麻雀搜索算法(MISSA)。通过混沌映射和反向学习机制提高算法初始种群的质量;借鉴粒子群算法的学习策略来提升种群的信息交流能力和兼顾全局勘探与局部开发之间的平衡;融合差分进化算法的变异交叉操作提升算法跳出局部最优值的能力。通过对8个基准测试函数的寻优实验,结果表明改进算法具有更好的优化性能和收敛效率。...

心升明月的博客 4368

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

opfunu:优化基准函数的强大Python库

opfunu:优化基准函数的强大Python库 项目介绍 opfunu是一个开源的Python库,专为优化领域的研究者提供了一站式的基准函数解决方案。它包含了所有CEC(Computational Intelligence Optimization Competition)竞赛函数,跨越从2005年至2022年。除此之外,opfunu还实现了超过300个传统函数,适用于不同维度的优化问题。作为一款...

gitblog_00562的博客 608

【智能优化算法】蜣螂优化算法(Dung beetle optimizer, DBO),2023

论文被引:17

青年有志 1万+

基于 opfunu 库和 mealpy 库进行优化算法训练(收敛曲线对比和三维函数绘制)

基于 opfunu 库和 mealpy 库进行优化算法训练(收敛曲线对比和三维函数绘制)

Qxx_____的博客 1086

170+种优化算法求解11种cec测试函数cec2005/2008/2010/2013/2014/2015/2017/2019/2020/2021/2022(Python代码免费下载)

以鲸鱼优化算法(WOA)和灰狼优化算法(GWO)为例。设置了最大迭代次数epoch=100,种群数量pop_size=50。有两种调用方式,import的方式也不一样。当然,

weixin_44028734的博客 1590

智能优化算法:蜣螂优化算法-附代码

蜣螂优化算法( Dung beetle optimizer, DBO), 是由 Jiankai Xue 等于2022 年提出的一种群体智能优化算法。其灵感来源于蜣螂的生物行为过程,具有寻优能力强,收敛速度快的特点。

Jack旭的博客 1万+

融合最优邻域扰动和反向学习策略的蝴蝶优化算法

为解决蝴蝶优化算法易出现收敛精度差、易陷入局部极值的问题,提出了一种融 合最优邻域扰动和反向学习策略的蝴蝶优化算法。首先,在算法初期引入改进Tent混沌映射,均匀蝴蝶初始位置。其次,在全局搜索阶段引入最优邻域扰动和透镜成像反向学习策略,在保持种群多样性的同时提高算法的收敛速度,并通过贪婪机制择选出最优的蝴蝶个体位置;在局部搜索阶段引入随机权重,增强跳出陷入局优的能力;采用6个基准函数来测试5种算法的搜索性能,结果表明ORBOA具有更高的收敛速度、收敛精度和跳出局优的能力。

心升明月的博客 3801

【算法拾光】队列|在每个树⾏中找最⼤值 + 最后⼀块⽯头的重量

本文总结两道经典算法题:一是通过层序遍历(BFS)逐层找最大值,利用队列分层处理,每层维护最大值;二是用大根堆(优先队列)模拟石头碰撞过程,每次取最大两块石头,差值重新入堆,直至剩余一块或无石。前者适用于树的层次遍历,后者适合动态获取最值场景。核心思想:队列用于分层遍历,堆用于高效取极值。

wuqingyigexiaoba的博客 202

把 KV Cache 压到 FP4:BitDecoding-FP4 的算法-系统协同设计复盘

长上下文推理卡在KV Cache的显存与带宽上,而现有FP4方案要么精度崩、要么速度废。这篇文章复盘BitDecoding-FP4如何用三个算法补丁加一个系统重构,在B300上把服务吞吐提升2.4–3.0倍,精度几乎不掉。

helloagent的博客 319

【算法拾光】链表 哈希表|K个一组翻转链表 + 两数之和

K个一组翻转链表需分段反转,借助哑节点与前驱指针维护连接,避免断链;两数之和利用哈希表实现O(1)查找,空间换时间,高效定位目标组合。前者考察链表指针操作,后者聚焦映射关系构建,均为面试高频题。

wuqingyigexiaoba的博客 341
上一篇: 中科院一区论文复现,改进蜣螂算法,Fuch映射+反向学习+自适应步长+随机差分变异,MATLAB代码...
下一篇: 送你N个创新点!双通道并行网络,想用哪个网络用哪个,MATLAB代码
淘个代码_
博客等级 码龄7年 1万+粉丝 504原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值