
【python】【爬虫】无反爬图片爬取

Python之网络爬虫(4) 本博客内容来自韦玮老师网络爬虫课堂笔记,仅用于个人学习和复习,请勿转载用于其他商业用途。 1、爬虫防屏蔽手段之代理服务器 使用代理服务器进行信息爬取,可以很好的解决IP限制的问题。 import urllib.request def use_proxy(url, proxy_addr): # 设置代理服务器:49.71.133.38为代理服务器地址,9999为代理服务器端... 阅读详情

这是一个最简单的、没有任何针对反爬措施的爬虫。走错门的施主可以绕道了~~~

一、问题

受疫情影响,所有学校课程采用网课教学,各种课程群应运而生。想一次性找到所有课程群二维码,以供查询,怎么办呢?

二、原理

1、探明网页图片链接格式在这里插入图片描述
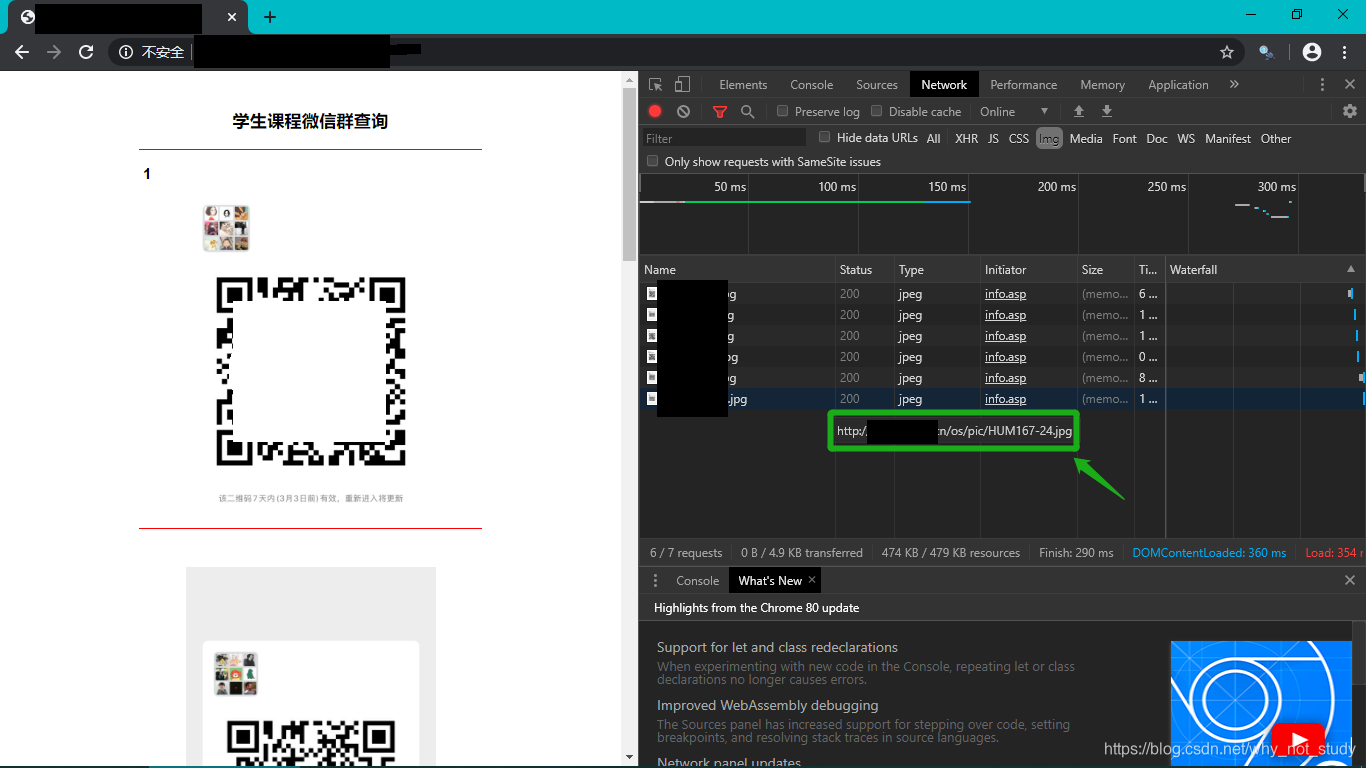
打开学校指定的查询课程二维码的网站,找到图片对应的http请求返回的图片链接,发现所有图片的链接都是http://xxx.cn/os/pic/+课程号-课序号+.jpg的格式。因此,只要将对应的课程号-课序号与之进行拼接即可完成爬取。

2、使用requests包爬取相关网页图片

requests包最简单的爬虫:

import requests
r = requests.get(url)

之后进一步完成存储工作即可。

三、解决

#从csv读取所有课程号-课序号,并拼接成网页链接
import pandas as pd
csv_data = pd.read_csv('D:/.../999 project/5 testing_file/num.csv', encoding = 'ANSI')
urls = []
for i in csv_data['num']:
    urls.append("http://xxx.cn/os/pic/"+i+".jpg")

import requests
import os

root = "C://...//Desktop//lesson_QR_code/"
num = 0

#爬取课程二维码
for url in urls:
    num = num + 1
    path = root + url.split('/')[-1]
    try:
    	#如果不存在该目录,创建目录
        if not os.path.exists(root):
            os.mkdir(root)
        #如果文件不存在,爬取二维码并保存,若存在则打印“文件已存在”
        if not os.path.exists(path):
            r = requests.get(url)#实际上只有这一行是爬虫
            with open(path, 'wb') as f:
                f.write(r.content)#将二进制内容写入文件
                f.close()
                print(num,"文件保存成功")
        else:
            print(num,"文件已存在")
    except:
    	#如果发生异常,打印发生异常的课程号
        print(url.split('/')[-1])
        
print("爬取完毕")

四、反思

实际上,课程号-课序号信息可以从教务系统手动复制粘贴下来的。博主目前还不会爬虫登录教务系统并解决验证码问题,等解决了这个问题就不用手动复制粘贴啦(如果解决了这个问题就可以用代码抢课了…)。

Python爬虫实战:研究icrawler框架,构建图片文件采集系统 icrawler 作为一款基于 Python 的图片爬虫框架,整合了多种主流图片网站和搜索引擎的爬取功能,提供了简洁的 API 接口,降低了图片爬虫的开发难度,受到了开发者的广泛关注。其基本工作原理是模拟人类使用浏览器访问网页的过程,通过 HTTP 协议向 web 服务器发送请求,获取网页的 HTML 文档,然后从文档中提取所需的信息(如链接、图片、文本等),并根据一定的策略对新的链接进行递归爬取,从而实现对网络信息的批量采集。在图片质量方面,谷歌图片的评分最高,图片的清晰度和与关键词的相关性较好; 阅读详情

相关推荐

Python 爬虫实战:分析接口爬取 Instagram 图片(规避反爬策略)

Instagram 作为一个全球知名的图片和视频分享社交平台,拥有庞大的用户群体和海量的图片资源。对于数据分析师、市场研究人员以及内容创作者来说,能够高效地获取 Instagram 上的图片数据具有重要的价值。然而,Instagram 为了保护用户数据和平台内容,实施了一系列的反爬虫策略。本文将深入探讨如何利用 Python 爬虫技术,结合分析 Instagram 的接口,实现对图片数据的稳定爬取,同时规避常见的反爬虫机制。

yansideyucsdn的博客 1885

python爬图一篇过(三)【超·详细】:selenium库:防反爬(含cookies)+翻页下拉+pycharm运行

那么今天,也就是在这个selenium系列的终章,我们就来说说如何在pycharm环境下运行你的爬虫程序,以及在此基础上在加以一点润色,离按下shift+F10就能轻轻松松自动爬到大量图片的目标就不远了!! 现在你就可以把代码复制进入新开页面了! 接下来开始小准备

qq_53021454的博客 4173

激光雷达+相机标定避坑指南:手把手教你用KITTI数据完成坐标转换

本文详细介绍了激光雷达与相机标定的实战指南,利用KITTI数据集完成精准坐标转换。从数据准备、工具链搭建到标定矩阵加载与验证,再到坐标转换流水线的工程实现,提供了全面的避坑技巧和工程实践建议。特别强调了多传感器融合中的常见问题及解决方案,帮助开发者提升自动驾驶和机器人感知系统的环境感知精度。

book8的博客 834

(爬虫一)简单的爬虫

# 1.爬取美女的照片,相信大家都是喜欢的,嘿嘿!接下来咱们就开始操作 首先选取一个没有反爬虫机制的网站试试,没有反爬虫机制的网站爬取比较的简单。这里就选“我主良缘”。 1 .首先登陆网站即可,然后选择想要爬取的图片。右击->检查->Network,然后我们再点一下搜缘分,发现多了下面这条东西: 我们看一下和这个头部文件里面有什么: 然后发现这个api里面的就是我们所要的美女图片 2.然后就是代码部分 # _* coding: utf-8 _*_ # _author_:zeng #2020/

TestingRookie的博客 354

基于ESP32-P4的低成本旋转式激光雷达系统设计

激光雷达(LiDAR)作为机器人环境感知的核心传感器,其本质是融合光学测距、机电控制与实时数据处理的嵌入式系统。理解时间飞行(ToF)原理与机械旋转耦合机制,是实现高精度点云采集的基础;而系统级误差源——如计时抖动、电机惯性、信号串扰和温漂——直接决定实际建图鲁棒性。在资源受限场景下,选用RISC-V双核MCU(如ESP32-P4)可兼顾实时控制与网络服务能力,通过硬件时间戳捕获、S型加减速轨迹规划、旋转变压器供电及双Bank OTA等工程手段,有效平衡分辨率、帧率与稳定性。本文围绕360°旋转式激光雷达的

weixin_36231030的博客 430

AWR射频仿真基本操作(一)

这里只讲述一个基本的操作: 软件是AWR 14版本

钢丝 2万+

网络图片爬虫(几个简单步骤实现网页图片的爬取,详细步骤,超详细,简单易懂)

网络图片爬取 前提准备 安装好开发库:Beautifulsoup4和requests,这两个库主要用于python爬虫,简单安装过程点这里开发库安装 主要分为以下几个部分: 1. 分析网页,查看索要爬取网页的源代码(按F12或者CTRL+SHIFT+C),选中你想要爬取的图片中的任意一个,下面以 爱奇艺的首页为例,注意下图: 可以看到图片标签,标识属性class,图片的url属性src(这三个接下来会用到) 2. 读取网页的内容 代码如下: #导入两个开发库 import urllib.request

张茂洋的博客 3万+

深入解析EtherCAT通讯DS402协议下的伺服电机控制模式选择与配置

本文深入解析了EtherCAT通讯DS402协议下的伺服电机控制模式选择与配置,详细介绍了六种核心控制模式(如PPM、CSP、CSV、CST)的应用场景及实战技巧。通过EtherCAT和DS402协议的高效配合,实现工业自动化中伺服电机的精准控制,提升设备性能与稳定性。

h0i1j2k3l的博客 1173

使用lxml爬取房屋信息(静态网页,无反爬)

使用lxml标签树爬取房屋信息(静态网页)。后面有解释。

crownyouyou的博客 482

Halcon和C#联合编程实现硬币识别(个人入门练习)

本人为机器视觉入门小白,自己突发奇想 1.图片数据来源和分析 2.HALCON实现 3.C#搭建界面框架 4.C#中嵌入HALCON代码,即联合编程 5.导出.exe文件,运行以及Debug 目标是这样的,在图片中识别出每种类型的硬币数量,然后计算出总钱数。先上结果,再细说过程。 C#界面和识别结果: 1.图片数据来源和分析 图片大小及格式均统一,拍摄的时候已经尽可能的去除了背景噪点,所以图像处理的要求并不很高(重点在于思路)。硬币区分原理本人代码采用直径范围来判断(也可以半径或区域面积,HALCON算子

Demobird的博客 3612

YOLOv8自定义训练:车牌识别全流程(从标注到推理,附可视化代码)

车牌检测全流程实践指南 摘要:本文详细介绍了基于YOLOv8的车牌检测完整实现方案。针对车牌检测中的三大难点(小目标、多角度、光照变化),提供了从数据准备到模型部署的全流程解决方案。重点包括:1)数据采集与标注规范;2)针对小目标的YOLOv8模型优化配置;3)K-means锚框聚类方法;4)训练参数调优策略。通过实际验证,该方法可获得95%以上的检测准确率,并附有完整的代码实现和可视化工具,便于开发者快速复现应用。 (字数:149字)

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 849

【爬虫系列】Python 爬虫入门(2)

这篇重点说明,如何识别网站反爬虫机制及应对策略,使用 Selenium 模拟浏览器操作等内容

小确幸的博客 8095

Pyhon在振动信号处理中的高级应用(一):振动信号特征(时域、频域)提取

文章目录一、概述二、算法原理2.1 时域统计特征三、python代码实现 一、概述 二、算法原理   这里我们借鉴西安交通大学机械学院雷教授的论文《Fault diagnosis of rotating machinery based on multiple ANFIS combination with GAs》相关研究成果。雷教授在论文中共列举了4类共24种振动信号的时域和频域特征。 2.1 时域统计特征 p1=∑n=1Nx(n)NP2=∑n=1N(x(n)−p1)2N−1p3=(∑n=1N∣x(n)∣N

白银时代的博客 1万+

python爬虫

python爬虫

gzh_086719的博客 4813

Mac 下 OpenClaw 安装全记录:从零到一的保姆级图文教程

本文主要介绍了Mac 下 OpenClaw 安装全记录:从零到一的保姆级图文教程,希望能对学习使用OpenClaw 的同学们有所帮助。 文章目录 1. 背景 2. 安装教程 2.1 安装OpenClaw 2.2 配置模型 2.3 对话 3. 后续使用步骤 4. 关闭程序

weixin_43178406的博客 11万+

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

Python实训day06am【网络爬虫(爬取接口)】

Python实训

upward 3530

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

python网络爬虫有那些实例_python爬虫经典例子有哪些

python爬虫例子:首先导入爬虫的库,生成一个response对象;然后设置编码格式,并打印状态码;最后输出爬取的信息,代码为【print(response.text)】。python爬虫例子:1.爬取强大的BD页面,打印页面信息# 第一个爬虫示例,爬取百度页面import requests #导入爬虫的库,不然调用不了爬虫的函数response = requests.get("http://w...

weixin_33019705的博客 1213

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Python实现爬取贴吧图片

导读: 最近周边朋友学python的越来越多,毫无意外的是,大家都选择了爬虫入门。这不难理解。Python有丰富的库使用,使得爬虫的实现容易很多,学习之后,回报明显,容易获得成就感。总结起来就是:让人有继续学下去的欲望。我偏巧例外,先走了Python web。虽然起了个大早,赶了个晚集,但不妨趁清明假期,计划之外,时间有余,做一回“愿闻其详”...

andiejian2685的博客 683

如何用python爬取网站数据,python爬取网页数据步骤

爬虫就是自动获取网页内容的程序,例如搜索引擎,Google,Baidu 等,每天都运行着庞大的爬虫系统,从全世界的网站中爬虫数据,供用户检索时使用。

chatgpt001的博客 1947

嵩天《Python网络爬虫与信息提取》实例1:Requests库网络爬虫实战5个实例

这部分涉及五个简单的网页获取实例:京东商品页面的爬取/亚马逊商品页面的提取/百度搜索关键词提交/网络图片的爬取与存储/手机号码归属地自动查询。

weixin_43095088的博客 2984

超简单的图片爬虫,搜集图片分分钟

先看看当当网的图片查看一下页面源码找到我们要爬的图片数据格式和位置图片数据存放的很容易取,用正则表达式来匹配:r"<img data-original='(.*?)...

Python技术博文 1180

python爬取csdn专栏并储存为md文件

今天闲着无聊,突然想要爬一下csdn里的内容。又因为我是用hexo建的blog,就想保存为md文件慢慢观看。 先打开一个专栏,就选“Jack-Cui”的Python3网络爬虫入门吧。 首先我们分析一下它的目录的元素: 看到了吗,这些a标签就是目录的元素。 现在,编写代码: from bs4 import BeautifulSoup import requests headers={ "User-Agent":"Mozilla/5.0 (Windows NT 6.1; WOW64) A..

leyuxuan的博客 1784

爬虫实战爬取有道翻译

【1701H1】【穆晨】【180127】第109天总结 图片也是文件,也是用二进制数据组成的,用wb写入 写了一个爬取placekitten网站的一张猫图的代码 urlopen后面可以是字符串也可以是地址,详情docs里面搜索 这是后面加地址的 这是后面加字符串的 geturl获取的是具体的地址 info获得是HTTPMessage的一个对象,

qin_shang_的博客 1695

Python爬虫入门教程!手把手教会你爬取网页数据

其实在当今社会,网络上充斥着大量有用的数据,我们只需要耐心的观察,再加上一些技术手段,就可以获取到大量的有价值数据。这里的“技术手段”就是网络爬虫。今天就给大家分享一篇爬虫基础知识和入门教程: 很多人学习python,不知道从何学起。 很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手。 很多已经做案例的人,却不知道如何去学习更加高深的知识。 那么针对这三类人,我给大家提供一个好的学习平台,免费领取视频教程,电子书籍,以及课程的源代码!??¤QQ群:623406465 什么是爬虫?

Python_sn的博客 3905

Python网络爬虫入门版笔记 四、一些简单爬虫的基本演示与实战

实例一、爬取京东商品信息 这里我们用到如下的爬取框架: 即可爬取京东商品页面的网页文本,url中的链接即为京东的某个商品信息。 实例二、爬取亚马逊商品信息 都是爬取商品信息,为什么要将二者分开,因为亚马逊对爬虫进行了一定的限制,前面说到,网站限制爬虫有两种方式,最常见的是发布robots协议,可还有一种方式是根据HTTP请求的头部信息对爬虫进行筛选,这里亚马逊就采用了此种方...

tomatoarmys的博客 291

python爬虫的总结

总结:明确了爬虫的基本概念,实现了爬虫的一些基本功能,能够高效的完成自己的工作,通过这几篇爬虫的练习,基本明确html页面中如何获取相关数据,学会看懂获取的代码,明确自己想要爬取的内容,但是爬虫的道路还需要长时间的学习,不断来巩固自己的学习成果,还需要我们不断学习新的爬虫机制,防止反爬取等一系列模块的学习。实现了对各种网站的爬取,包含小说、图片、以及文本文件的写入,实现了各种网站的尝试,其中包含乔布斯排行榜、豆瓣评分排名的爬取,小说网某本的爬取,其中受益良多,明确知道url 请求资源等各种概念。

2301_77161708的博客 728
上一篇: 【python】【matplotlib】绘图无法正常显示中文与负号
下一篇: 【python】【转调】用python程序实现简谱转调
why_not_study
博客等级 码龄7年 34粉丝 26原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值