The Max Trick when Computing Softmax

MoE混合专家架构原理与GPU部署实战指南 混合专家(MoE)是一种通过稀疏激活实现大模型高效推理的核心架构,其本质是在Transformer基础上引入条件计算范式:每token仅路由至K个专家(如2个),大幅降低显存占用与计算开销。该技术突破了稠密模型的显存墙、训练不稳和推理成本高等工程瓶颈,已成为GPT-4、DeepSeek-R1等千亿级模型落地的关键路径。其价值不仅在于参数规模的‘理论膨胀’,更体现在硬件友好性——真实激活参数可压缩至总量的1%~3%,使A100/H100单卡运行成为可能。典型应用场景包括低延迟API服务、长文本法律/财报解析及 阅读详情

The softmax function appears in many machine learning algorithms. The idea is, if you have a set of values, to scale them so they sum to 1.0 and therefore can be interpreted as probabilities.

For example, suppose you have three values, (x0, x1, x2) = (3.0, 5.0, 2.0). The softmax function for any value xj expressed mathematically is:

SoftmaxEquation
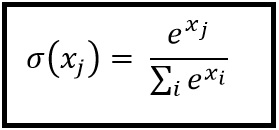
这里写图片描述
In words, find the sum of e raised to each x value. The softmax for a particular x is e raised to x divided by the sum. So:

exp(3.0) = 20.0855
exp(5.0) = 148.4132
exp(2.0) = 7.3891
sum      = 175.8878

And the softmax values are:

s(3.0) = 20.0855 / 175.8878  = 0.12
s(5.0) = 148.4132 / 175.8878 = 0.84
s(2.0) = 7.3891 / 175.8878   = 0.04

Notice the softmax values sum to 1.0. In practice, calculating softmax values can go wrong if an x value is very large — the exp() of a large number can be huge, which makes the sum huge, and dividing by a huge number can cause arithmetic computation problems.

A trick to avoid this computation problem is subtract the largest x value from each x value. It turns out that the properties of the exp() function give you the same resuilt but you avoid large numbers.

For (3.0, 5.0, 2.0), the largest value is 5.0. Subtracting 5.0 from each gives (-2.0 0.0, -3.0), and so:

exp(-2.0) = 0.1353
exp(0.0)  = 1.0000
exp(-3.0) = 0.0498
sum       = 1.1852

And then:

s(3.0) = 0.1353 / 1.1852 = 0.12
s(5.0) = 1.0000 / 1.1852 = 0.84
s(2.0) = 0.0498 / 1.1852 = 0.04

which are the same softmax values as when computed directly.

视觉特征-自监督-同源不同crop视图一致性【2023-04】:DINOv2(无监督学习鲁棒视觉特征)【12 亿张互不重复的图像】【判别式自监督方法】【交叉熵损失+iBOT损失】 近期,自然语言处理领域在大量数据上进行模型 Pretraining 取得的突破,为计算机视觉中类似Foundation Model 的发展开辟了道路。这些模型能够生成通用视觉特征,即无需微调即可跨图像分布和任务发挥作用的特征,从而大幅简化图像在任何系统中的使用。本研究表明,现有的 Pretraining 方法,尤其是自监督方法,如果在来自多样化来源的充足精选数据上进行训练,便能够产生此类特征。我们重新审视了现有方法,并结合不同技术,从数据规模和模型规模两方面扩展我们的 Pretraining。 阅读详情

相关推荐

MoE逐token路由与活跃参数率实战解析

Mixture of Experts(MoE)是一种通过计算稀疏化提升大模型推理效率的核心架构,其本质是将密集型前向计算解耦为专家子网络与动态路由机制。token-level routing(逐token路由)决定每个输入单元由哪些专家处理,直接影响活跃参数率(active parameter ratio)这一关键工程指标。该设计在保障模型表达能力的同时,显著降低显存占用、通信开销与FLOPs消耗,广泛应用于GPT-4、DeepSeek-R1等千亿级模型的生产部署。理解Router门控逻辑、负载均衡损失及专

Ferrerooo 成长 474

机器学习中的一些常用函数

总结各种Loss Function以及其优良性质。

yanhe156的博客 1346

Mamba-2与LatentMoE协同架构解析:超长上下文与高效推理新范式

状态空间模型(SSM)和混合专家(MoE)是当前大模型架构演进的两大关键技术路径。SSM通过线性状态更新突破Transformer的二次复杂度瓶颈,而MoE则以稀疏激活提升参数扩展效率;但传统组合常受限于KV缓存膨胀、路由通信开销与数值不稳定等问题。Nemotron 3提出的Mamba-2层通过动态A矩阵实现稳定长程建模,结合LatentMoE将路由压缩至低维计算空间,在显存带宽与GPU间通信层面显著提效。该架构天然支撑1M token上下文与Multi-Token Prediction等高级推理能力,已在

duiker 449

Gumbel-Softmax trick

Gumbel-Softmax 是一种可导采样技巧,它可以用来对离散分布进行重参数采样。与softmax区别是,gumbel-softmax得到得是样本(即采样,对于神经网络,离散输入常转化为one-hot形式,采样出来的样本是经soft后one-hot向量[x1,x2,...,xn][x_1,x_2,...,x_n][x1​,x2​,...,xn​]),而softmax得到是样本得均值(即各分类概率,[p1,p2,...,pn][p_1,p_2,...,p_n][p1​,p2​,...,pn​])。 假设每

UglyDuckling_16的博客 2279

损失函数与优化器:从「梯度是怎么被造出来的」到「梯度是怎么被用掉的」

本文揭示损失函数与优化器本质一体:优化器仅依赖损失产生的梯度,而损失决定梯度的方向、尺度与噪声特性。错误的损失选择(如分类用MSE)会导致梯度失衡,使优化器失效;不同损失(如Huber、Focal)通过调控梯度分布影响优化过程。实测表明,归约方式、标签结构与损失配对直接决定梯度行为,进而影响收敛性与泛化。核心观点:选对损失,才是让优化器“看得懂”的前提。

reset2021的博客 318

【信息科学与工程学】计算机科学与自动化——第三百零五篇 数据中心 Scale-Up、Scale-Out、Scale-Across 20

GPU 训练中的各种算子融合技巧、梯度压缩与稀疏通信的高级变体、混合专家模型的负载均衡与通信优化、长序列模型的注意力机制优化、模型量化与蒸馏的联合优化、分布式训练中的容错与恢复、以及一些新兴硬件特性的建模(如 HBM3、GDDR7、CXL 3.0 内存语义、PCIe Gen6 PAM4 信令等)。每条仍然包含四个方程式子节。

weixin_49199313的博客 348

gumbel-softmax trick

VAE和GAN里面训练的时候常用的技巧,主要是为了解决那种预测是"hard",即输出是一个one-hot的决策时,没有办法直接计算后续损失的情况。而使用softmax强制其输出为概率分布的话,虽然可以计算后续损失,但是其本质上还是argmax的含义。为了能够在模型决策训练的过程中引入一定的随机性(个人理解为决策的soft程度,而不是单纯的hard),尤其是在Reinforce Learning里面,常用一个trick就是gumbel-softmax。其核心思想是利用gumbel分布进行采样,增加模型决策的随

weixin_43301333的博客 1131

告别命令行!用这个开源的Web版Kettle工具,5分钟搞定数据集成任务编排

本文介绍了一款开源的Web版Kettle工具,通过直观的拖拽界面大幅提升数据集成效率,告别复杂的命令行操作。该工具基于Kettle核心引擎,支持跨平台协作、轻量化访问和降低学习曲线,特别适合业务分析师快速上手。实测显示,使用该工具后任务配置错误率下降62%,协作效率提升40%。

weixin_30267785的博客 435

Softmax函数与交叉熵

Softmax函数与交叉熵

behamcheung的博客 4万+

Golang面试(一)莉莉丝游戏-Golang后端开发-中台部门

莉莉丝游戏-Golang后端开发-中台部门 开场白,双方自我介绍,对方介绍这个岗位情况,erlang语言,全部转向go。 聊项目,介绍IM架构以及使用Go写的服务简介 动态扩容相关问题:平常30万,现在100万,你们现在是如何应对的? 如果让你调整架构实现动态扩容,你会怎么做?回答了kafka,是一种,应该还要使用docker和k8s以及微服务框架等 如果使用kafka,你是如何确保消息有序?回答了redis,好像没回答到那个点 消息发送失败的问题,如何做到消息不丢?回答持久化存储、拉消息和ACK 发送失

xmcy001122的专栏 3899

批量导入经纬度点到奥维地图中

随便说说 最近出来出差,天天东奔西跑的,跑完了回到酒店还得整理一天的成果,基本上晚上9点才能整理完,累的基本上倒头就睡,没时间鼓捣自己喜欢的东西了。但想着也得写点啥吧,想来想去就那最近工作中用到的东西吧。因为我们现在的工作内容呢,基本上就是按照着上面给的地理位置找到地方开始检查。所以呢,就需要批量的把手上的经纬点信息导入到地图中,安排好路线,利用导航高效的找到地方。给的坐标就是gps点,wgs-84的,使用奥维地图最方便了,不用做坐标转换直接能用。所以作为组里的gis担(苦)当(力),这个导坐标的活就由我来

lionhenryzxxy的博客 3万+

MoE架构真相:稀疏激活不是固定比例,而是动态路由

混合专家(MoE)是大语言模型实现规模与效率平衡的核心架构,其本质并非简单减少参数量,而是通过专家路由器(Router)将计算任务按语义动态分发至Top-k专家子网络,从而解耦计算负载。该机制依赖Softmax路由、负载均衡损失(Auxiliary Loss)和容量因子(Capacity Factor)等关键技术,在训练中保障专家调用均匀性,在推理中实现上下文敏感的稀疏激活。MoE的技术价值在于显著降低FLOPs(如GPT-4级模型可达10倍计算压缩),但真实落地受制于显存带宽、跨卡通信与KV Cache膨

csxc65837的博客 280

YOLOv8剪枝实战:基于torch_pruning的模型优化与性能提升指南

本文详细介绍了如何使用torch_pruning工具对YOLOv8模型进行结构化剪枝,以实现模型轻量化与性能提升。通过实战步骤解析,包括环境搭建、依赖图分析、迭代剪枝与微调策略,帮助开发者有效减少模型参数量和计算量,提升在边缘设备上的推理速度,同时保持检测(detect)与分割(segment)任务的精度。

water的专栏 1122

GPT-4的1.8万亿参数与2%稀疏激活真相解析

大语言模型中的MoE(Mixture of Experts)架构,是突破稠密模型显存墙与延迟墙的关键范式。其核心原理在于通过轻量级路由器动态选择少量专家子网络,实现‘总参数规模庞大’与‘单次计算量可控’的精妙平衡。这种稀疏激活机制不仅显著提升单位显存的计算密度,更支撑了长上下文、低延迟、高吞吐的工业级推理服务。典型应用场景包括金融客服、法律文书分析、多领域知识问答等需兼顾专业性与响应时效的AI系统。本文深入拆解GPT-4所采用的1.8万亿参数规模与每Token约2%稀疏激活背后的设计逻辑、工程权衡与落地陷阱

weixin_34319111的博客 441

基于LORA的双机通信的智能农业系统

通过LoRa模块与主机进行通信,监测环境中的温度、湿度、土壤湿度和光照强度等参数,并根据预设的自动控制逻辑或者手动指令控制继电器开关,从而调节风扇、加热器、水泵、喷雾器和灯光等设备,为植物提供适宜的生长环境。使用的Lora是大夏龙雀的感觉这个是我使用过的Lora里面最好用的,因为不用设置频道就可以直接透明传输,使用起来得心应手。就像两个单片机直接串口通信一样,缺点是异步串行,不能同时进行接收和发送。继电器灯亮模拟打开对应的风扇、水泵、灯、喷雾、加热。1.使用温度传感器测当前环境的温湿度。

ssjsjss的博客 1739

【电弧故障检测算法全解析,电弧串扰问题分析和解决算法】

本文系统分析了电弧故障检测算法及串扰问题解决方案。电弧检测主要采用时频域分析和机器学习方法,通过提取高频噪声、波形畸变等特征实现故障识别。针对电弧串扰问题,提出了自适应滤波、盲源分离和时频联合分析等算法。研究给出了Python和C语言的算法实现示例,包括高频能量检测、过零率计算和陷波滤波器设计。最后指出算法优化方向:实时性提升可采用滑动窗口FFT和硬件加速;抗干扰增强需结合硬件滤波;机器学习扩展可引入随机森林等分类器。该研究为电弧故障检测系统开发提供了完整的技术路线。

syttt的专栏 891

GPT-4稀疏激活真相:万亿参数模型如何靠MoE实现高效推理

大语言模型的‘稀疏激活’并非简单减少计算,而是通过Mixture of Experts(MoE)架构,在保持模型容量的同时,动态选择部分专家处理每个token,从而突破显存与通信带宽的物理瓶颈。其核心原理在于路由头驱动的token级专家选择、专家容量约束下的负载均衡,以及FP8权重分片加载等工程优化。这种稀疏性带来显著技术价值:1.8万亿参数模型实际显存占用仅约74GB,远低于同等规模密集模型;首token延迟稳定在毫秒级,支撑高并发在线服务。典型应用场景包括超大规模推理部署、成本敏感型AI服务中台及边缘协

weixin_33736832的博客 401

arcgis select by attributes一次选多个_视频:如何基于ArcGIS与GeoDa求莫兰指数和绘制莫兰散点图?...

莫兰指数是全域莫兰指数(Global Moran's I)的简称,是澳大利亚统计学家帕特里克·阿尔弗雷德·皮尔斯·莫兰(Patrick Alfred Pierce Moran),在1950年提出的。详细介绍,如下:莫兰指数取值范围在-1.0至1.0之间。当Moran's I >0时,表示空间正相关性,其值越大,空间相关性越明显;当Moran's I <0时,表示空间负相关性...

weixin_39948247的博客 1760

【机器学习300问】139、Post-LN 和 Pre-LN 的区别?

Post-LN与Pre-LN的核心区别在于LayerNorm的位置:Post-LN在残差连接后,导致梯度需经LayerNorm变换,深层易出现梯度衰减或震荡;Pre-LN先做归一化,使输入稳定,残差路径梯度可无损回传,显著提升深层训练稳定性。尽管Pre-LN支持更深层次模型(如LLaMA、Qwen),但存在“深度诅咒”——深层贡献不足。相比之下,Post-LN浅层表现尚可,深层数易发散。因此,现代大模型普遍采用Pre-LN以保障训练可靠性。

qq_39780701的博客 398

Open3D (C++)球旋转算法(BPA)三维建模

球旋转算法用于点云三维建模的C++代码实现。

点云侠的博客 1771

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

机器学习基础|监督学习、标签、回归

网约车预估等待时长依赖监督学习中的回归任务。平台利用历史订单数据,以司机实际到达耗时为标签,通过上车点、时间、运力、路况等特征训练模型。模型不断优化预测值与真实耗时的误差,最终对新订单输出连续的预估等待时间,实现精准预测。

weixin_43971465的博客 247

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Hugging Face:成为机器学习界的“Github”

以下文章来源于OneFlow,作者OneFlow社区五年前,AI领域的知名研究者Andrej Karpathy发文称,传统人工编程属于“软件1.0”,“软件2

2601_96798011的博客 131

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

机器学习——混淆矩阵(待更新)

二元: true表示真实==预测,positive表示预测值=1.

m0_61175448的博客 151

【机器学习300问】138、LayerNorm和BatchNorm的区别?

本文阐述了归一化与标准化在深度学习中的核心作用。输入层标准化可统一初始输入,但深层网络仍面临激活分布漂移。为此,提出BatchNorm与LayerNorm两种主流方法。

qq_39780701的博客 183

为什么生成对抗网络训练常不稳定,模式崩溃与判别器过强之间是什么关系?

当支持集不重叠时(即 $D$ 能完美区分真假),JS 散度为常数 $\log 2$,其梯度为 0。这意味着一旦 $D$ 训练得稍好,$G$ 就失去了学习方向,导致训练停滞。生成对抗网络(GAN)的训练本质上是生成器($G$)与判别器($D$)之间的非合作零和博弈。以下代码展示了如何通过梯度惩罚(Gradient Penalty)来约束判别器,避免其过强导致生成器梯度失效。判别器过强是导致模式崩溃的直接诱因之一,二者之间存在明确的**“梯度误导”**因果关系。

2402_84593233的博客 205
上一篇: 大端序与小端序
下一篇: RNN computation
watkins
博客等级 码龄18年 1277粉丝 246原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值