Python学习笔记22:进阶篇(十一)常见标准库使用之访问互联网功能urllib模块的学习使用,requests库和aiohttp库了解

Python3 爬虫教程 - aiohttp 的基本使用 前面介绍的 asyncio 模块内部实现了对 TCP、UDP、SSL 协议的异步操作,但是对于 HTTP 请求来说,我们就需要用到 aiohttp 来实现了。aiohttp 是一个基于 asyncio 的异步 HTTP 网络模块,它既提供了服务端,又提供了客户端。其中我们用服务端可以搭建一个支持异步处理的服务器,就是用来处理请求并返回响应的,类似于 Django、Flask、Tornado 等一些 Web 服务器。而客户端可以用来发起请求,类似于使用 requests 发起一个 HTTP 请求然后获得响应, 阅读详情

前言

本文是根据python官方教程中标准库模块的介绍,自己查询资料并整理,编写代码示例做出的学习笔记。

根据模块知识,一次讲解单个或者多个模块的内容。

教程链接:https://docs.python.org/zh-cn/3/tutorial/index.html

互联网访问

Python在互联网访问方面提供了强大的支持,无论是通过标准库还是第三方库,都能轻松实现网页抓取、API调用、数据下载等多种任务。
这里讲一下常用的互联网访问模块。

  1. urllib(包括urllib.request, urllib.parse, urllib.error): Python的标准库,可以用来打开URLs、解析URLs、读取网页内容等。虽然不如requests直观,但在不需额外安装的情况下也能完成基本的网络请求。
  2. requests: 这是最常用的第三方库,用于发送HTTP/1.1请求。它提供了简单的API来执行GET、POST等HTTP方法,同时处理JSON数据、二进制文件和响应内容也非常方便。.
  3. aiohttp: 面向异步编程的HTTP客户端/服务器库,适用于需要高效并发处理大量网络请求的场景。它基于Python的asyncio框架。

urllib

urllib 是Python标准库的一部分,提供了丰富的功能来处理URLs,包括请求的发送、解析等。

它包含四个子模块:urllib.request、urllib.parse、urllib.error 和 urllib.robotparser。

这四个模块我们一个个讲。

urllib.request

用于打开URLs,发送HTTP、FTP请求等。

常用的函数:
  1. urlopen(url, data=None, [timeout,]*, cafile=None, capath=None, cadefault=False, context=None):打开URL,返回一个文件类对象,可以用此对象的方法读取URL的内容。之前文件流不是学过open函数吗?open前面加个url,那么这个函数大概啥作用应该能猜出来,要有这种根据函数名联想函数功能的能力,同样也要有根据函数功能命名函数的能力。
  2. Request(url, data=None, headers={}, origin_req_host=None, unverifiable=False, method=None)
from urllib import parse
from urllib.request import urlopen, Request

# GET请求示例
with urlopen('http://www.example.com/') as response:
    content = response.read()
    print(content.decode('utf-8'))

print("================分隔符===============")

# POST请求示例
url = 'http://httpbin.org/post'
headers = {'User-Agent': 'Mozilla/5.0'}
data = bytes(parse.urlencode({'key': 'value'}), encoding='utf8')
req = Request(url, data=data, headers=headers, method='POST')
with urlopen(req) as res:
    print(res.read().decode('utf-8'))

代码中出现的两个链接是开源的测试学习用的地址。大家学习访问互联网信息的时候也可以去访问这两个网址。

在这里插入图片描述
分析我们打印的信息。
我们使用urlopen函数打开了http://www.example.com/这个链接返回的是一个文件类型对象,我们使用read函数读取了内容并打印。你可以把打印信息复制到一个.txt的文件里面,把文件改成.html格式,打开以后样式和你直接访问是一样的。
在这里插入图片描述
第二个输出则是打印了我们模拟的一个http请求的信息。这里我就不详细解释这些字段一个个是啥了。

urllib.parse

提供URL解析和操作功能,如分解URL、构建查询字符串等。其实在urllib.request中,解析请求信息使用了一下。

常用函数
  1. urlencode(query):将字典转换成URL编码的字符串。
  2. parse_qs(qs, keep_blank_values=0, strict_parsing=0, encoding=‘utf-8’, errors=‘replace’):将URL查询字符串解析成字典。
  3. urlsplit(url, scheme=‘’, allow_fragments=True):分割URL为组成部分。
from urllib.parse import urlencode, parse_qs, urlsplit

# 构建查询字符串
query_params = {'name': '明月望秋思', 'age': 28}
encoded_query = urlencode(query_params)
print(encoded_query)
print("================分隔符===============")
# 解析查询字符串
query_string = 'name=%E6%98%8E%E6%9C%88%E6%9C%9B%E7%A7%8B%E6%80%9D&age=28'
parsed_query = parse_qs(query_string)
print(parsed_query)
print("================分隔符===============")
# 分割URL
url = 'https://www.example.com/path?query=value#fragment'
components = urlsplit(url)
print(components)

在这里插入图片描述
可以看到中文被转换成了一堆看不懂的符号加字母,然后用一串东西又能解析回中文。实际上我们有时候在复制一些网站链接的时候也会复制出这样的一串,但是链接仍然能访问,原理是一样的。
最后一串输出就没啥特殊的了,把url分割了。这个函数可以用在什么地方呢?需要获取url中的信息的时候,就可以用这个函数分割获取想要的信息。

urllib.error

定义了由urllib.request抛出的异常,如URLError和HTTPError。这些异常在使用urllib.request进行网络请求时可能被抛出。了解这些异常有助于进行错误处理和调试。
这里没有函数需要学习的,涉及到的知识点就是我们之前学习的异常处理,我们可以通过捕获上面两种error来进行针对性的处理或者打印日志信息等。

urllib.robotparser

解析robots.txt文件,帮助遵守网站的爬虫协议。robots.txt文件定义了网站上哪些页面可以被爬虫访问,哪些不可以。

常用函数
  1. RobotFileParser(url=‘’): 创建一个RobotFileParser对象,用于解析给定URL的robots.txt文件。
  2. read(): 从已设置的URL读取并解析robots.txt文件。
  3. can_fetch(useragent, url): 判断指定的user-agent是否可以抓取指定的URL。
  4. parse(lines): 从一个文件或列表中解析robots.txt的规则。
from urllib.robotparser import RobotFileParser


# 初始化一个RobotFileParser对象,指定网站的robots.txt文件URL
rp = RobotFileParser('http://www.example.com/robots.txt')

# 读取并解析robots.txt文件
rp.read()

# 检查user-agent "my-bot" 是否可以抓取 "http://www.example.com/path"
print(rp.can_fetch('my-bot', 'http://www.example.com/path'))

在这里插入图片描述
通过控制台打印的输出,我们知道了这个网站是可以被抓取的。

这里也贴一些关于robots.txt文件的知识,包括怎么检查网站有没有这个文件,这个文件的意义作用。

检查网站是否存在robots.txt文件很简单,可以直接在浏览器中输入网站域名后加上/robots.txt来尝试访问,或者使用编程方式发送HTTP请求到该地址。例如,对于www.example.com,你可以在地址栏输入http://www.example.com/robots.txt来查看。
存在robots.txt文件的意义:
指导爬虫行为:robots.txt文件是网站所有者与网络爬虫之间的协议,用于告知爬虫哪些页面可以被抓取,哪些不可以。这有助于爬虫更高效地工作,避免访问被禁止的区域,减少服务器负担。
保护隐私和安全:通过限制敏感或非公开页面的访问,网站可以有效保护用户数据和内部系统的安全。
优化资源分配:网站管理员可以利用robots.txt来引导搜索引擎爬虫关注更重要的内容,忽略如登录页、搜索结果页等动态生成或对SEO无益的页面。
缺失robots.txt文件的意义:
默认允许抓取:如果一个网站没有robots.txt文件,大多数搜索引擎和爬虫会默认认为所有页面都是允许抓取的。这意味着网站上的所有公开可访问的内容都有可能被搜索引擎索引。
缺乏明确指引:没有该文件,爬虫开发者或SEO专家无法获得关于网站爬取的具体指导,可能需要更多时间来确定哪些内容是应该或不应该被爬取的。
潜在的隐私或安全风险:在某些情况下,缺少robots.txt可能导致一些本应受保护的页面被意外抓取,尤其是在网站结构复杂或配置不当的情况下。

urllib模块暂时就讲到这里。

由于我们目前主要学习一些标准库,所以另外两个模块只简单记录,项目中用到在单独学习记录。

requests

这个库是Python中最受欢迎的HTTP库之一,它允许你以非常简单的方式发送HTTP请求,并处理响应。这个库的设计理念是“让HTTP服务人类”,因此它具有简洁的API和高度可读性,使得网络请求变得直观易懂。

get和post

import requests

response = requests.get('http://example.com')
# 打印HTTP响应状态码
print(response.status_code) 
print("================分隔符===============")
# 打印响应内容的文本形式
print(response.text)         
print("================分隔符===============")
data = {'key': 'value'}
response = requests.post('http://httpbin.org/post', data=data)
# 如果响应内容是JSON格式,可以直接解析为字典
print(response.json())      

可以看到,仅仅是两三行代码,并且很简单明了的代码,我们就成功通过两个不同方式请求了一个网址,并成功获得返回信息。
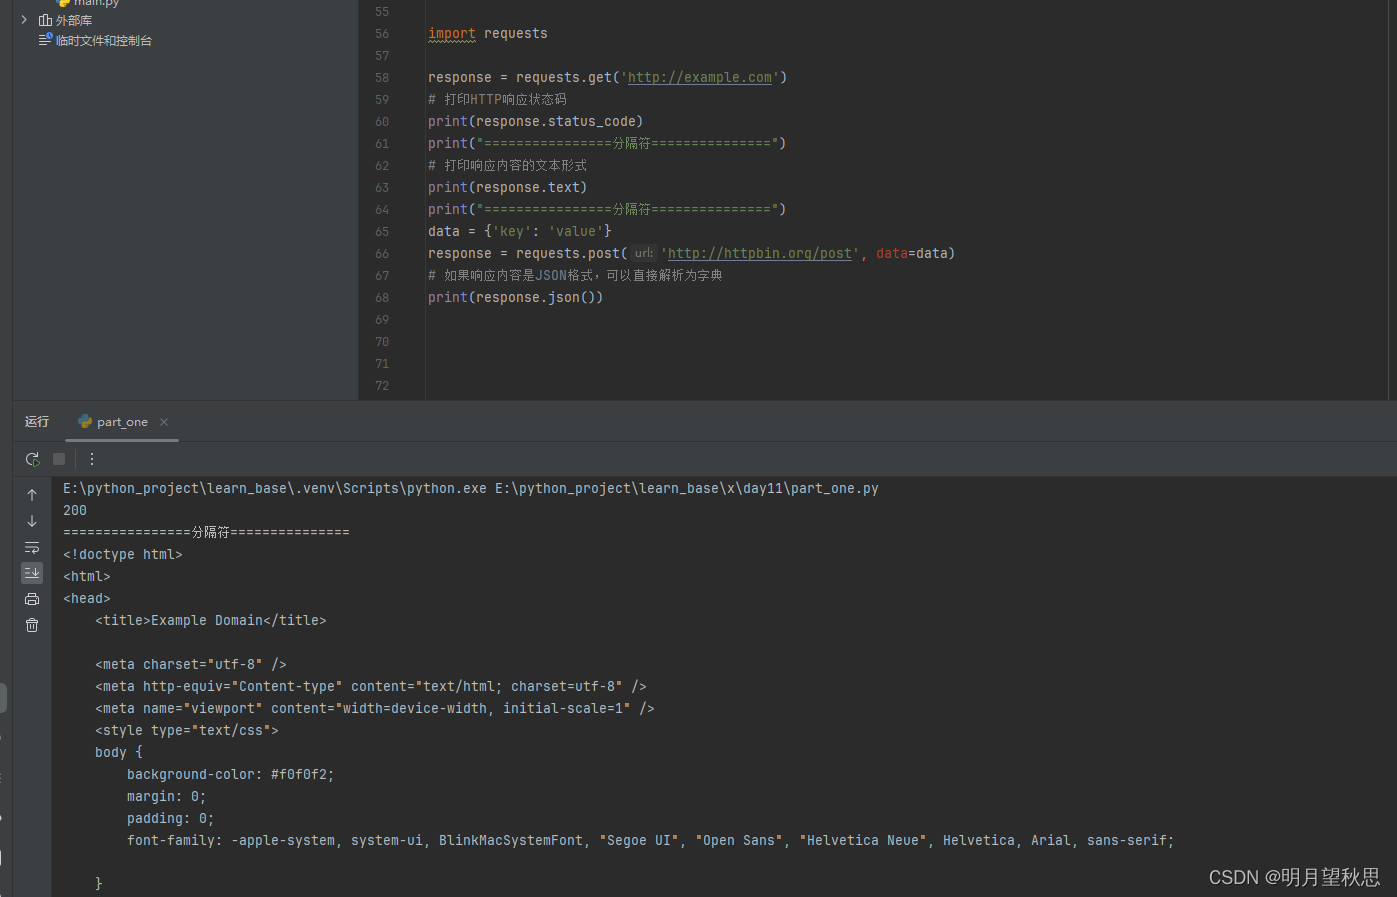
在这里插入图片描述

Session

requests.Session()可以创建一个会话对象,它可以在多个请求之间保持某些参数,比如Cookies,这对于登录认证等场景非常有用。

s = requests.Session()
s.get('http://httpbin.org/cookies/set/sessioncookie/123456789')
response = s.get('http://httpbin.org/cookies')
print(response.text)

在这里插入图片描述

file

通过files参数上传文件

files = {'file': open('report.xls', 'rb')}
response = requests.post('http://httpbin.org/post', files=files)

在代码中,我们定义了一个files的参数,这个files的参数值则是文件report.txt文件。注意rb这个参数,表示我们读取二进制模式,通常文件上传也是读取文件二进制流的形式。然后将files参数使用post函数请求。

aiohttp

aiohttp库是为Python异步编程设计的,提供了异步HTTP客户端和服务器功能,基于Python的asyncio框架,非常适合构建高性能的异步网络应用程序。目前用不上,简单贴个示例看看就行。

import aiohttp
import asyncio

async def post_request(session, url, data):
    async with session.post(url, data=data) as response:
        return await response.text()

async def main():
    async with aiohttp.ClientSession() as session:
        data = {'key': 'value'}
        response_text = await post_request(session, 'http://httpbin.org/post', data)
        print(response_text)

# 同样,使用 asyncio.run 或者 loop.run_until_complete 来启动异步事件循环
asyncio.run(main())
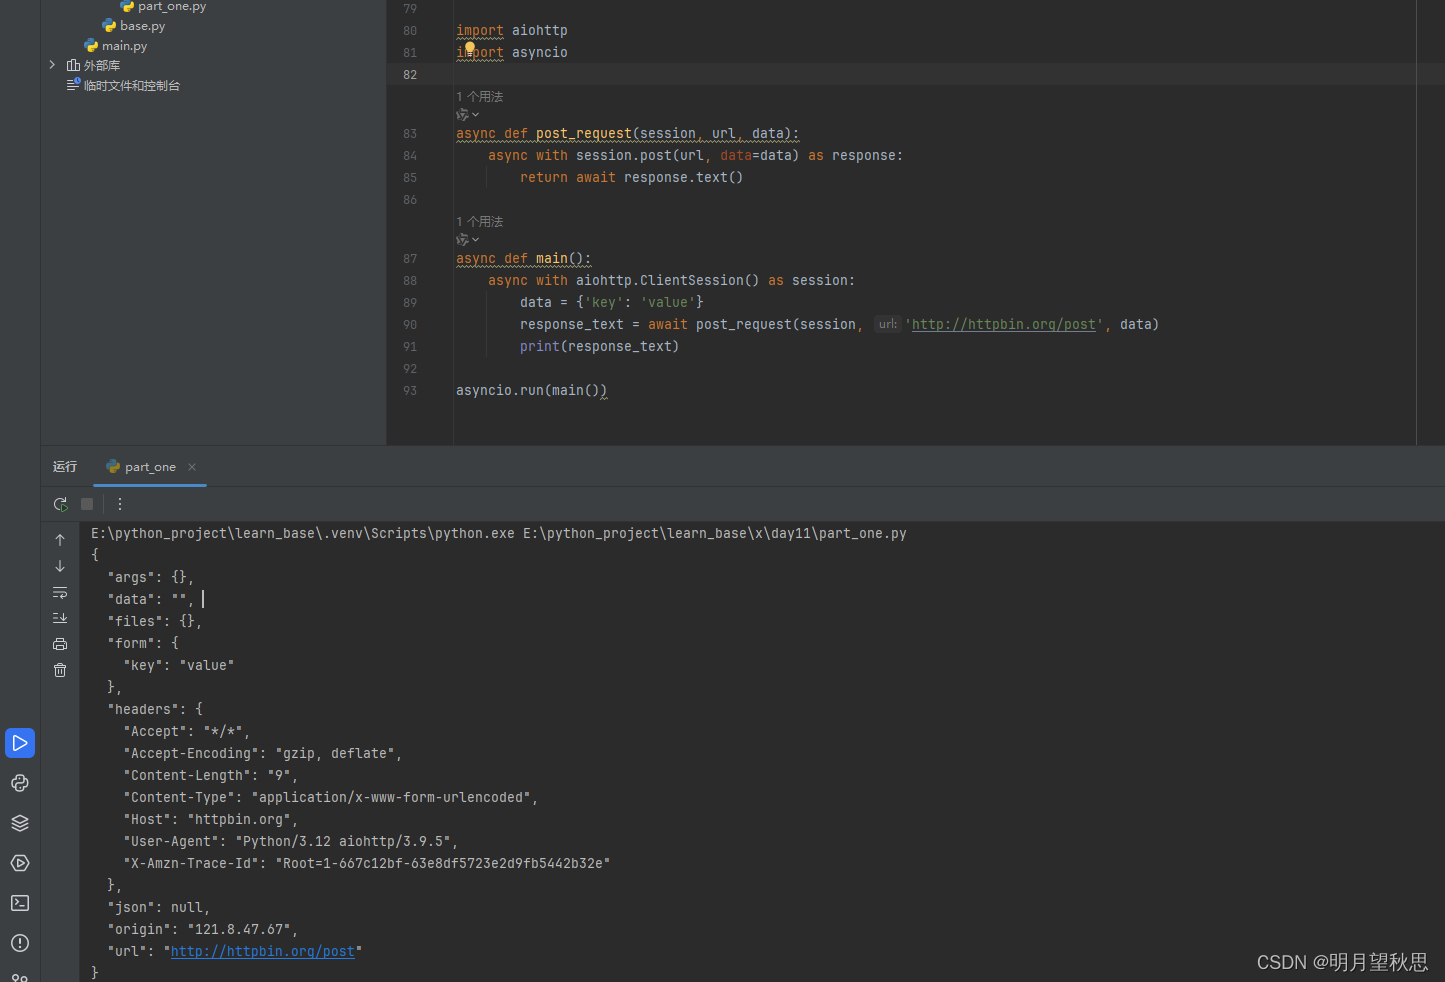
在这里插入图片描述

结尾

关于Python访问互联网的知识就讲这些。主要了解标准库urlliib的知识,另外两个库的知识后面接触到会再深入学习。

作业

  1. urllib的函数使用。
Python爬虫实战:从requests到Scrapy的抓取、解析与存储全解析 网络数据抓取是数据采集与处理的基础技术,其核心原理是通过程序模拟浏览器行为,自动从互联网获取结构化信息。这项技术的价值在于为数据分析、市场研究、机器学习等应用场景提供高质量、大规模的数据源。在工程实践中,Python因其丰富的库生态成为爬虫开发的首选语言。其中,requests库简化了HTTP请求过程,而BeautifulSoup和lxml则分别提供了灵活与高性能的HTML解析方案。面对反爬机制,开发者需要掌握请求头伪装、IP代理池和异步并发等关键技术。对于复杂项目,Scrapy框架通过其模块化架构提供了完 阅读详情

相关推荐

Python网页链接批量抓取实战:从requests到并发处理的完整解决方案

网络爬虫是数据采集与信息提取的基础技术,其核心原理是通过模拟HTTP请求获取网页内容,再解析HTML文档结构提取目标数据。在Python生态中,requests库因其简洁API成为HTTP请求的首选工具,而parsel或BeautifulSoup则提供了强大的HTML解析能力。通过结合urllib.parse进行URL标准化处理,开发者可以构建稳定高效的链接提取流程。这项技术的价值在于能够自动化完成大量重复性数据收集工作,广泛应用于市场调研、竞品分析、SEO优化和内容聚合等场景。本文聚焦于从给定URL列表中

weixin_30416871的博客 349

爬虫 -- aiohttp跟requests的效率对比

aiohttp跟requests

MarkAdc的博客 6970

Python 3 Web API开发实战:超时重试认证与健壮性设计

Web API 是现代软件系统间通信的核心机制,其本质是基于 HTTP 协议的标准化数据交互。理解请求-响应模型、状态码语义、头部协商及连接生命周期,是构建可靠网络客户端的基础。在 Python 生态中,requests 库通过封装底层 urllib 复杂性,显著降低了 Web API 调用门槛;而 Python 3 提供的 Unicode 统一处理、asyncio 异步支持和 typing 类型提示,则为高可用、可维护的 API 集成提供了语言级保障。关键技术价值体现在对超时控制、自动重试、安全认证(如

weixin_34032621的博客 367

Python知识点——网络访问详解

简单 HTTP 请求:用requests。高性能 API 服务:用FastAPI。复杂 Web 应用:用Django。底层通信:用socket。大规模爬虫:用Scrapy。根据实际需求选择工具,并注意网络安全和性能优化。

跟佟格湾一起学习计算机知识吧~ 671

Python 同、异步HTTP客户端封装:性能与简洁性的较量

引入异步编程趋势:Python的异步编程正变得越来越流行。在过去,同步的HTTP请求已经不足以满足对性能的要求。 异步HTTP客户端库的流行:目前,有许多第三方库已经实现了异步HTTP客户端,如aiohttp和httpx等。然而,异步语法使得代码变得更加冗长,导致缩进增多,降低了代码的可读性和简洁性。 封装异步HTTP客户端:为了简化异步HTTP请求的代码,我们需要封装一个常用的HTTP客户端,以实现业务中常见的功能,并提供更简洁的接口。在这篇博客中,我将使用aiohttp库来进行封装异步客户端。

qq_43629857的博客 1041

Python requests及aiohttp速度对比代码实例

主要介绍了Python requests及aiohttp速度对比代码实例,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下

python做客户端适合吗_为了选出最合适的 HTTP 客户端,我做了个测评

在 Python 众多的 HTTP 客户端中,最有名的莫过于requests、aiohttp和httpx。在不借助其他第三方库的情况下,requests只能发送同步请求;aiohttp只能发送异步请求;httpx既能发送同步请求,又能发送异步请求。所谓的同步请求,是指在单进程单线程的代码中,发起一次请求后,在收到返回结果之前,不能发起下一次请求。所谓异步请求,是指在单进程单线程的代码中,发起一次请...

weixin_39725154的博客 279

MAX96712解串器MIPI CSI-2输出配置全解析:从Video Pipe映射到DPLL速率设置(以4路YUV422摄像头为例)

本文详细解析了MAX96712解串器在MIPI CSI-2输出配置中的关键步骤,包括Video Pipe映射、寄存器配置和DPLL速率设置。通过具体示例和代码片段,帮助开发者优化4路YUV422摄像头系统的图像传输稳定性和画质表现,适用于汽车电子和工业视觉应用。

weixin_30776273的博客 433

urllib.request库,深度详解

Python标准库中的urllib.request模块是一个内置的HTTP请求工具,用于发送GET/POST请求、处理响应和管理网络通信。它支持设置请求头、处理重定向和Cookies,适合数据抓取和API调用等基础场景。使用时需构建请求对象并解析响应,建议配合异常处理和超时设置确保稳定性。相比第三方requests库,urllib.request更底层但无需额外安装,适合轻量级项目;而requests提供更简洁的API。开发者应根据项目复杂度选择,简单任务使用标准库即可,复杂交互推荐requests或aio

leohu0723的博客 128

逆向实战:Soul聊天协议加密与Frida绕过检测

本文详细解析了Soul聊天协议逆向分析的全过程,重点介绍了如何利用Frida绕过应用的反调试检测机制。通过静态分析定位关键SO库,并编写Frida脚本动态Hook线程创建函数,成功实现对抗。文章还进一步追踪了基于DES算法的加密流程,并探讨了协议数据结构的解析方法,为移动应用安全研究提供了实战参考。

2w3e4r5t6y的博客 1132

避坑指南:RFSoC数据转换器多片同步配置的7个致命错误

本文深入剖析了在配置RFSoC多片同步功能时,工程师最常遇到的七个致命错误。从Tile 0的强制启用、时钟域与SYSREF时序,到跨代器件兼容性、电源序列以及动态重配置的陷阱,文章结合实战经验,提供了从原理到调试的完整RF数据转换器配置指南,旨在帮助开发者高效构建相位一致的大规模射频采样系统。

weixin_28452161的博客 533

yyds!Python爬虫的完整学习框架

爬虫是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。这个定义看起来很生硬,我们换一种更好理解的解释:我们作为用户获取网络数据的方式是浏览器提交请求->下载网页代码->解析/渲染成页面;而爬虫的方式是模拟浏览器发送请求->下载网页代码->只提取有用的数据->存放于数据库或文件中。爬虫与我们的区别是,爬虫程序只提取网页代码中对我们有用的数据,并且爬虫抓取速度快,量级大。随着数据的规模化,爬虫获取数据的高效性能越来越突出,能够做的事情越来越多:

优快云_430422的博客 1759

GNSS差分码偏差(DCB)从原理到实战:如何避免数据处理中的常见错误

本文深入解析GNSS差分码偏差(DCB)的原理及其对高精度定位的关键影响。针对数据处理中因忽略DCB校正导致的常见错误,如单系统PPP高程偏差、多系统融合精度下降及电离层研究失真等,提供了实战解决方案与主流DCB产品获取、集成方法,帮助用户有效规避陷阱,提升数据处理精度。

k5l6m的博客 224

python爬虫,学习路径拆解及资源推荐

爬虫是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。这个定义看起来很生硬,我们换一种更好理解的解释:我们作为用户获取网络数据的方式是浏览器提交请求->下载网页代码->解析/渲染成页面;而爬虫的方式是模拟浏览器发送请求->下载网页代码->只提取有用的数据->存放于数据库或文件中。爬虫与我们的区别是,爬虫程序只提取网页代码中对我们有用的数据,并且爬虫抓取速度快,量级大。随着数据的规模化,爬虫获取数据的高效性能越来越突出,能够做的事情越来越多:·市场分析:电商分析、商圈分析、一二级市场分析等。

m0_59236127的博客 1548

《Cesium 基础知识点》- 申请 Cesium Ion 密钥

一、访问 https://cesium.com/ion/signin/tokens 二、登录/注册 三、申请 四、使用 // 密钥 let defaultAccessToken = 'your token string'; // 设置 Cesium.Ion.defaultAccessToken = defaultAccessToken; // 初始化 let viewer = new Cesium.Viewer('cesiumContainer', {}); ...

前端技术 2571

Matlab R2024a硬件支持包安装避坑指南:以Arduino为例(附离线包下载)

本文详细介绍了Matlab R2024a硬件支持包(Support Package)的安装流程,特别是针对Arduino平台的避坑指南和高效部署方法。从环境准备、离线安装方案到Arduino支持包的专项优化,提供了全面的技术细节和解决方案,帮助开发者避免常见错误,实现快速部署。

weixin_33737134的博客 447

Python爬虫入门:核心组件与实战技巧

网络爬虫作为数据采集的关键技术,通过模拟浏览器行为实现自动化信息抓取。其核心原理基于HTTP协议与HTML解析,主要包含请求发送、数据提取和存储三个环节。Python生态提供了requests、BeautifulSoup、lxml等高效工具链,支持从静态页面到动态渲染内容的全面处理。在工程实践中,爬虫技术广泛应用于电商价格监控、舆情分析和搜索引擎索引等场景,能显著提升数据获取效率。针对反爬机制,开发者需要掌握User-Agent伪装、IP代理池和请求频率控制等关键技术,同时遵守Robots协议确保合规性。S

cunfuxiao7305的博客 433

大数据知识面试题-通用(2026版)

序列号 内容 链接 1 大数据知识面试题-通用(2022版) 待续… 2 大数据知识面试题-Hadoop(2022版) 待续… 3 大数据知识面试题-MapReduce和yarn(2022版) 待续… 4 大数据知识面试题-Zookeepr (2022版) 待续… 5 大数据知识面试题-Hive (2022版) 待续… 6 大数据知识面试题-Flume(2022版) 待续… 7 大数据知识面试题-Hbase(2022版) 待续… 8 大数据知识面试题-sqoop(....

拉格朗日的学习笔记 2万+

Python爬虫技术:从基础到实战的完整指南

网络爬虫作为数据采集的核心技术,通过模拟浏览器行为实现自动化数据抓取。其工作原理主要涉及HTTP请求发送、HTML解析和数据存储三个关键环节。在Python生态中,Requests和BeautifulSoup等库提供了便捷的开发工具,而aiohttp和lxml则能满足高性能需求。爬虫技术在大数据分析、价格监控和舆情分析等场景具有重要价值,但需注意反爬机制突破和合规性问题。本文通过对比解析工具和存储方案,结合分布式架构实践,帮助开发者构建高效的爬虫系统。

weixin_30902251的博客 361

Pointnet++改进90:2025最新改进模块-EVA模块

本教程提出了一种改进PointNet++特征提取模块的方法,通过在PointNetSetAbstraction模块中加入NAMAttention注意力机制,显著提升了模型性能。具体改进包括:1)新建eva.py文件,实现了包含SDLSKA、CKS等关键组件的EVA模块;2)在pointnet2_utils.py中添加Conv和PointNetSetAbstractionAttention类,整合注意力机制;3)修改pointnet2_sem_seg.py模型结构。这种改进方法降低了实现难度,同时保持了33F

AIcurator的博客 361

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

从API调用到可视化:使用Python深度挖掘你的Spotify数据

网络爬虫技术指南:核心工具与实战代码 本文概述了Python网络爬虫的核心技术栈,包括: 基础工具:Requests、BeautifulSoup 动态处理:Selenium、Playwright 框架方案:Scrapy完整项目结构 高级技巧:反爬应对策略(随机UA、代理IP、延时控制) 提供3个典型代码示例: 静态页面抓取(Requests+BS4) 动态内容处理(Selenium无头模式) 企业级爬虫(Scrapy框架实现) 附赠数据存储方案(JSON/CSV/SQLite)和反爬最佳实践,包含请求头管理

2503_93163736的博客 1945

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

太炸裂了!Python爬虫的完整学习框架都整理出来了

爬虫是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。这个定义看起来很生硬,我们换一种更好理解的解释:我们作为用户获取网络数据的方式是浏览器提交请求->下载网页代码->解析/渲染成页面;而爬虫的方式是模拟浏览器发送请求->下载网页代码->只提取有用的数据->存放于数据库或文件中。爬虫与我们的区别是,爬虫程序只提取网页代码中对我们有用的数据,并且爬虫抓取速度快,量级大。随着数据的规模化,爬虫获取数据的高效性能越来越突出,能够做的事情越来越多:

2401_84204207的博客 1737

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

*requests工具

Python requests库是一个高效便捷的HTTP请求工具,能模拟浏览器操作完成网页访问、数据提交、文件传输等网络交互。测试人员可用它检查页面状态、测试接口功能、维护会话状态,并通过设置请求头、超时等参数精确模拟各种场景。其使用遵循"准备-发送-检查"模式,支持状态码验证、JSON解析等关键功能。相比urllib更简洁,但不同于Selenium的浏览器控制,requests专注于后端接口测试。最佳实践包括设置超时、使用会话对象、结构化解析响应等,是Web服务测试中不可或缺的工具。

leohu0723的博客 169

超牛逼!Python爬虫学习的完整路线推荐

爬虫是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。这个定义看起来很生硬,我们换一种更好理解的解释:我们作为用户获取网络数据的方式是浏览器提交请求->下载网页代码->解析/渲染成页面;而爬虫的方式是模拟浏览器发送请求->下载网页代码->只提取有用的数据->存放于数据库或文件中。爬虫与我们的区别是,爬虫程序只提取网页代码中对我们有用的数据,并且爬虫抓取速度快,量级大。

m0_59162248的博客 538

YYDS!这份爬虫入门+进阶学习路线图快收好!

作为关系型数据库的代表,拥有较为成熟的体系,成熟度很高,可以很好地去存储一些数据,但在在海量数据处理的时候效率会显著变慢,已然满足不了某些大数据的处理要求。你可以根据自己的需求选择合适的请求库,但建议先从python自带的urllib开始,当然,你可以在学习时尝试所有的方式,以便更了解这些库的使用。是借助网页的结构和属性等特性来解析网页的工具,能自动转换编码。,基于python,你不需要了解从数据的实现,HTTP、TCP、IP的网络传输结构,一直到服务器响应和应达的原理,因为。

Saki_Python的博客 2858

Python爬虫技术入门:从数据抓取到工程实践

网络爬虫作为数据采集的核心技术,通过模拟浏览器行为实现自动化数据抓取。其工作原理主要基于HTTP协议通信,涉及请求发送、响应解析和数据存储三个关键环节。在Python生态中,requests库因其简洁API成为发送HTTP请求的首选工具,配合BeautifulSoup或lxml可实现高效HTML解析。爬虫技术的核心价值在于将非结构化网页数据转化为结构化数据,广泛应用于电商价格监控、舆情分析和搜索引擎索引构建等场景。面对反爬机制,开发者需要掌握User-Agent轮换、代理IP池等突破技巧,同时遵守robot

weixin_34375251的博客 374
上一篇: Python学习笔记21:进阶篇(十)常见标准库使用之math模块,random模块和statistics模块
下一篇: Python学习笔记23:进阶篇(十二)常见标准库使用之日期时间功能datetime模块的学习使用
明月望秋思
博客等级 码龄6年 1931粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

