Hive SQL 编译过程详解

低功耗和UPF介绍 参考[UPF]低功耗(Low Power Design)and UPF介紹 阅读详情

Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用。美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析。Hive的稳定性和性能对我们的数据分析非常关键。

在几次升级Hive的过程中,我们遇到了一些大大小小的问题。通过向社区的咨询和自己的努力,在解决这些问题的同时我们对Hive将SQL编译为MapReduce的过程有了比较深入的理解。对这一过程的理解不仅帮助我们解决了一些Hive的bug,也有利于我们优化Hive SQL,提升我们对Hive的掌控力,同时有能力去定制一些需要的功能。

1、MapReduce实现基本SQL操作的原理
详细讲解SQL编译为MapReduce之前,我们先来看看MapReduce框架实现SQL基本操作的原理

1.1 Join的实现原理

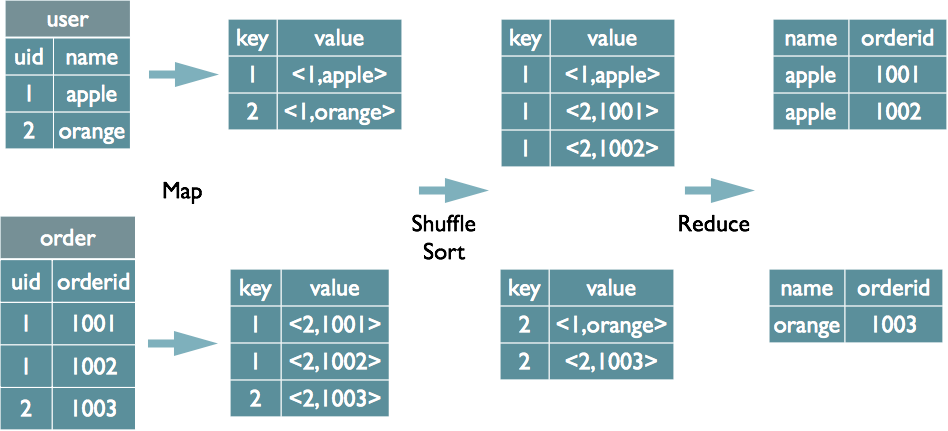
select u.name, o.orderid from order o join user u on o.uid = u.uid;

在map的输出value中为不同表的数据打上tag标记,在reduce阶段根据tag判断数据来源。MapReduce的过程如下(这里只是说明最基本的Join的实现,还有其他的实现方式)
在这里插入图片描述
1.2 Group By的实现原理

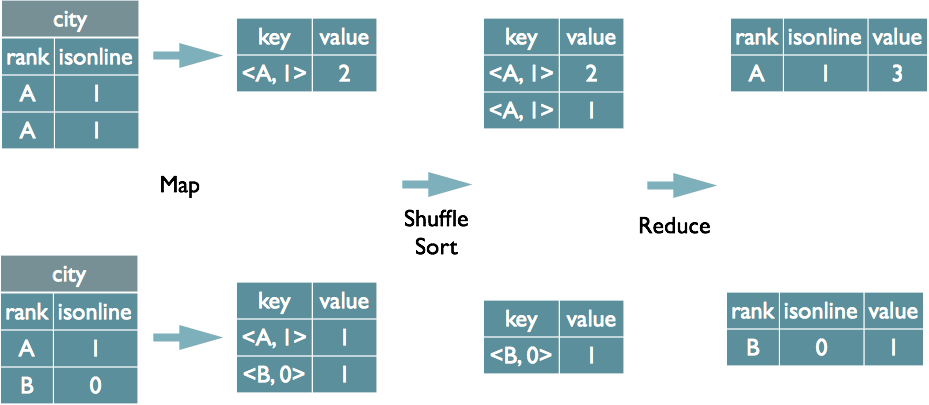
select rank, isonline, count(*) from city group by rank, isonline;

将GroupBy的字段组合为map的输出key值,利用MapReduce的排序,在reduce阶段保存LastKey区分不同的key。MapReduce的过程如下(当然这里只是说明Reduce端的非Hash聚合过程)
在这里插入图片描述
1.3 Distinct的实现原理

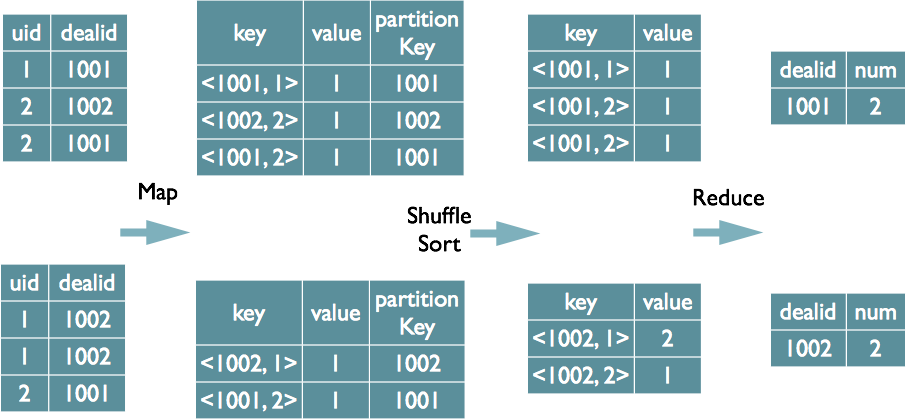
select dealid, count(distinct uid) num from order group by dealid;

当只有一个distinct字段时,如果不考虑Map阶段的Hash GroupBy,只需要将GroupBy字段和Distinct字段组合为map输出key,利用mapreduce的排序,同时将GroupBy字段作为reduce的key,在reduce阶段保存LastKey即可完成去重
在这里插入图片描述
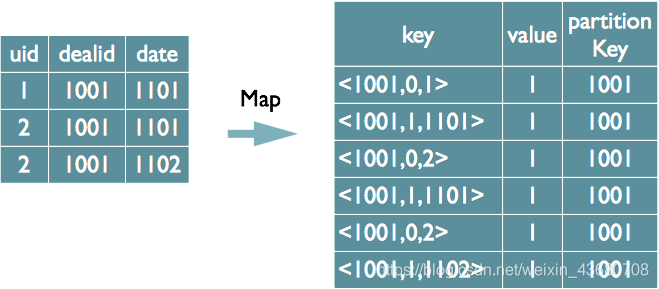
如果有多个distinct字段呢,如下面的SQL

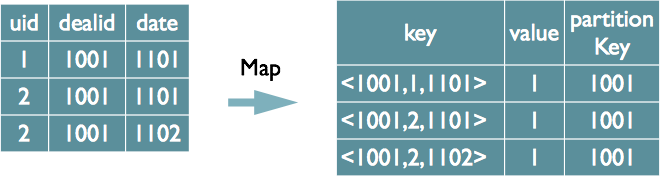
select dealid, count(distinct uid), count(distinct date) from order group by dealid;

实现方式有两种:

(1)如果仍然按照上面一个distinct字段的方法,即下图这种实现方式,无法跟据uid和date分别排序,也就无法通过LastKey去重,仍然需要在reduce阶段在内存中通过Hash去重
在这里插入图片描述
2)第二种实现方式,可以对所有的distinct字段编号,每行数据生成n行数据,那么相同字段就会分别排序,这时只需要在reduce阶段记录LastKey即可去重。

这种实现方式很好的利用了MapReduce的排序,节省了reduce阶段去重的内存消耗,但是缺点是增加了shuffle的数据量。

需要注意的是,在生成reduce value时,除第一个distinct字段所在行需要保留value值,其余distinct数据行value字段均可为空。
在这里插入图片描述
2、SQL转化为MapReduce的过程
了解了MapReduce实现SQL基本操作之后,我们来看看Hive是如何将SQL转化为MapReduce任务的,整个编译过程分为六个阶段:

Antlr定义SQL的语法规则,完成SQL词法,语法解析,将SQL转化为抽象语法树AST Tree
遍历AST Tree,抽象出查询的基本组成单元QueryBlock
遍历QueryBlock,翻译为执行操作树OperatorTree
逻辑层优化器进行OperatorTree变换,合并不必要的ReduceSinkOperator,减少shuffle数据量
遍历OperatorTree,翻译为MapReduce任务
物理层优化器进行MapReduce任务的变换,生成最终的执行计划
下面分别对这六个阶段进行介绍

2.1 Phase1 SQL词法,语法解析
2.1.1 Antlr
Hive使用Antlr实现SQL的词法和语法解析。Antlr是一种语言识别的工具,可以用来构造领域语言。
这里不详细介绍Antlr,只需要了解使用Antlr构造特定的语言只需要编写一个语法文件,定义词法和语法替换规则即可,Antlr完成了词法分析、语法分析、语义分析、中间代码生成的过程。

Hive中语法规则的定义文件在0.10版本以前是Hive.g一个文件,随着语法规则越来越复杂,由语法规则生成的Java解析类可能超过Java类文件的最大上限,0.11版本将Hive.g拆成了5个文件,词法规则HiveLexer.g和语法规则的4个文件SelectClauseParser.g,FromClauseParser.g,IdentifiersParser.g,HiveParser.g。

2.1.2 抽象语法树AST Tree
经过词法和语法解析后,如果需要对表达式做进一步的处理,使用 Antlr 的抽象语法树语法Abstract Syntax Tree,在语法分析的同时将输入语句转换成抽象语法树,后续在遍历语法树时完成进一步的处理。

下面的一段语法是Hive SQL中SelectStatement的语法规则,从中可以看出,SelectStatement包含select, from, where, groupby, having, orderby等子句。
(在下面的语法规则中,箭头表示对于原语句的改写,改写后会加入一些特殊词标示特定语法,比如TOK_QUERY标示一个查询块)

selectStatement
   :
   selectClause
   fromClause
   whereClause?
   groupByClause?
   havingClause?
   orderByClause?
   clusterByClause?
   distributeByClause?
   sortByClause?
   limitClause? -> ^(TOK_QUERY fromClause ^(TOK_INSERT ^(TOK_DESTINATION ^(TOK_DIR TOK_TMP_FILE))
                     selectClause whereClause? groupByClause? havingClause? orderByClause? clusterByClause?
                     distributeByClause? sortByClause? limitClause?))
   ;

2.1.3 样例SQL
为了详细说明SQL翻译为MapReduce的过程,这里以一条简单的SQL为例,SQL中包含一个子查询,最终将数据写入到一张表中

FROM
( 
  SELECT
    p.datekey datekey,
    p.userid userid,
    c.clienttype
  FROM
    detail.usersequence_client c
    JOIN fact.orderpayment p ON p.orderid = c.orderid
    JOIN default.user du ON du.userid = p.userid
  WHERE p.datekey = 20131118 
) base
INSERT OVERWRITE TABLE `test`.`customer_kpi`
SELECT
  base.datekey,
  base.clienttype,
  count(distinct base.userid) buyer_count
GROUP BY base.datekey, base.clienttype

2.1.3 SQL生成AST Tree
Antlr对Hive SQL解析的代码如下,HiveLexerX,HiveParser分别是Antlr对语法文件Hive.g编译后自动生成的词法解析和语法解析类,在这两个类中进行复杂的解析。

HiveLexerX lexer = new HiveLexerX(new ANTLRNoCaseStringStream(command));    //词法解析,忽略关键词的大小写
TokenRewriteStream tokens = new TokenRewriteStream(lexer);
if (ctx != null) {
  ctx.setTokenRewriteStream(tokens);
}
HiveParser parser = new HiveParser(tokens);                                 //语法解析
parser.setTreeAdaptor(adaptor);
HiveParser.statement_return r = null;
try {
  r = parser.statement();                                                   //转化为AST Tree
} catch (RecognitionException e) {
  e.printStackTrace();
  throw new ParseException(parser.errors);
}

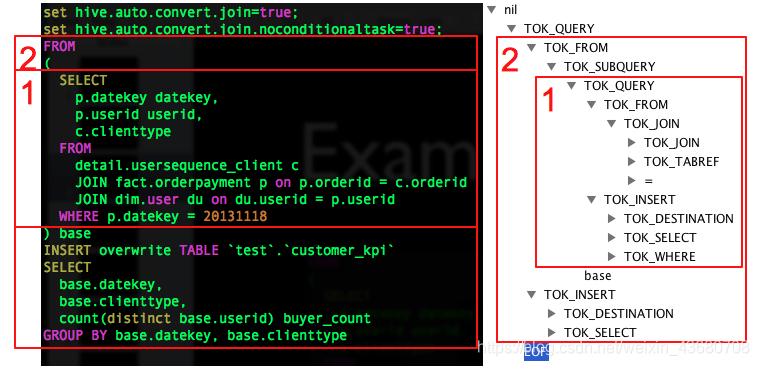
最终生成的AST Tree如下图右侧(使用Antlr Works生成,Antlr Works是Antlr提供的编写语法文件的编辑器),图中只是展开了骨架的几个节点,没有完全展开。
子查询1/2,分别对应右侧第1/2两个部分。
在这里插入图片描述
这里注意一下内层子查询也会生成一个TOK_DESTINATION节点。请看上面SelectStatement的语法规则,这个节点是在语法改写中特意增加了的一个节点。原因是Hive中所有查询的数据均会保存在HDFS临时的文件中,无论是中间的子查询还是查询最终的结果,Insert语句最终会将数据写入表所在的HDFS目录下。

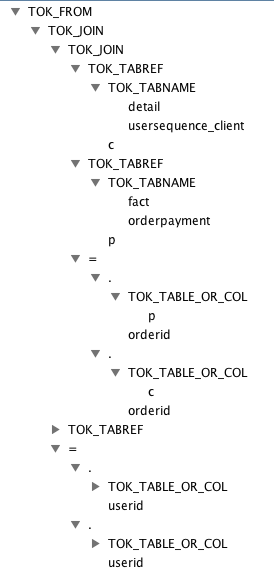
详细来看,将内存子查询的from子句展开后,得到如下AST Tree,每个表生成一个TOK_TABREF节点,Join条件生成一个“=”节点。其他SQL部分类似,不一一详述。
在这里插入图片描述
转载自 https://my.oschina.net/leejun2005/blog/267219

java爬虫(爬取银行理财数据) import java.io.IOException; import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.ArrayList; import java.util.Calendar; import java.util.Date; import java.util.List; imp 阅读详情

相关推荐

大模型时代必备技能:3种向量量化技术对比(PQ/AQ/RVQ)与选型指南

本文深入解析了大模型时代处理海量向量数据的关键技术——向量量化。通过对比Product Quantization (PQ)、Additive Quantization (AQ)和Residual Vector Quantization (RVQ)三种主流技术的核心原理、性能表现与适用场景,为工程师提供了从理论到实践的选型指南,旨在解决向量存储与检索的效率瓶颈,助力RAG等大模型应用高效落地。

silver的专栏 798

Hive SQL的编译过程

Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用。美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析。Hive的稳定性和性能对我们的数据分析非常关键。 在几次升级Hive的过程中,我们遇到了一些大大小小的问题。通过向社区的咨询和自己的努力,在解决这些问题的同时我们对Hive将SQL编译为MapReduc...

美团技术团队 2928

win10 运行lisflood_8踩过的坑

1、安装cuda及VS2019 https://www.bilibili.com/read/cv7335974/ 2、netcdf.h头文件找不到问题 https://www.cnblogs.com/lyggqm/p/12926974.html https://blog.youkuaiyun.com/u011954296/article/details/54617048 3、编码问题 https://blog.youkuaiyun.com/qq_33485434/article/details/81196843 4、

我的笔记 4115

HiveSQL源码之语法词法编译文件解析一文详解

工欲善其事必先利其器,首先要了解HiveSQL的编译语法的流程,还是需要懂得HiveSQL的执行流程以及编译规则。Hive详解以及CentOS下部署Hive和Mysql我们现在主要研究SQL Parser语法解析这块内容。语法解析可以说是研究一门编程语言的基础了,我们编程语言本身就是告诉计算机要帮助我们做什么事。antlr是编译原理领域比较著名的工具了,这次借助研究hivesql的机会,安装使用一下antlr。

master_hunter的博客 3597

ubuntu18.04安装gtsam过程及报错error: invalid initialization of reference of type ‘const std::vector<bool>&’

这里建议从这个链接下,不要从官网下,可能会有版本冲突 2.安装依赖 3.编译 报错: 1. error: invalid initialization of reference of type ‘const std::vector&’ from expression of type ‘const std::vector’ 124 | const std::vector& mask() const { retur...

qq_35102059的博客 2912

Unity游戏Mono注入实战:从反编译到功能扩展

本文详细介绍了Unity游戏Mono注入的完整实战流程,从使用dnSpy反编译游戏核心逻辑,到编写自定义C#功能DLL,再到利用SharpMonoInjector进行动态注入。文章深入讲解了如何通过Harmony库拦截修改游戏方法,并介绍了使用MelonLoader框架和UnityExplorer进行高级模组开发与调试,最终通过一个游戏对象透视(ESP)案例演示了功能扩展的实现。

weixin_29018335的博客 458

Hive3.1.2源码阅读--SQL的解析、编译、优化(二)

从前文中可以看到runInternal调用了compile方法,在compile方法我们可以看到执行了以下步骤: 1.1 首先通过ParseUtils.parse将sql解析为抽象的语法树ASTNode 1.2 然后通过sem.analyze(tree, ctx);对解析出来的抽象语法树进行编译和优化 我们先进入ParseUtils.parse中进行查看 /** Parses the Hive query. */ public static ASTNode parse(String command.

Cxf2018的博客 2758

Gartner DSG数据安全治理 架构及解读

目录背景:架构图: 解释:英文解释:(自上而下)平衡业务与风险、威胁、合规之间的关系(5个维度之间的平衡)优先处理数据集制定安全策略实施安全工具策略配置同步从上到下,从需求调研开始实施数据安全治理。千万不要跨过数据摸底、治理优先级分析、制定治理整体策略,而直接从技术工具开始对数据安全进行治理。 先明确选择需要治理的对象,优先选择重要数据进行数据安全治理工作。可以通过数据梳理、分类分级等手段,完成数据资产盘点和筛选,在纷杂的数据中理清头绪。

锦慈的技术博客 7216

Hive源码阅读–词法、语法解析–HiveLexerX/HiveParser

public HiveParser(TokenStream input, RecognizerSharedState state) { super(input, state); this.adaptor = new CommonTreeAdaptor(); this.errors = new ArrayList(); this.msgs = new Stack(); this.excludedCharForColumnName.

寒暄的博客 2154

【硬件相关】IB网与以太网核心技术解析及高性能网络部署指南

本文深入解析了IB网与以太网的核心技术差异,包括协议栈、流量控制机制及硬件架构,并提供了高性能网络部署的实战指南。通过对比测试和调优案例,展示了IB网在低延迟和高负载下的优势,以及混合组网中的创新应用,助力超算集群和高效网络部署。

weixin_29311017的博客 99

跟着团子学SAP CO:基于成本的完工百分比结算:Cost-based POC(以项目为例)

本文以英国及北美会计准则下的基于成本的POC的销售型项目结算对PS模块中的完工百分比进行介绍

Lucas1211的博客 2万+

hive sql的执行及编译过程

一、hive在执行sql时会以mapreduce的方式对数据进行接入和处理,其主要包含以下几个阶段:1.hive首先根据sql语句中的表从hdfs文件中获取数据,对数据文件进行split操作,使其可以一行一行将所需数据读入内存;2.map函数将内存中的数据按照key值进行映射,形成一行一行的key-value值,比如用户表中的性别字段,内存中map处理后的记录如下:3.在实际应用中会有多台机器参与...

weixin_34187822的博客 1847

Electron - Electron failed to install correctly, please delete node_modules/electron and try install

Electron安装失败:Electron failed to install correctly, please delete node_modules/electron and try installing again,electron安装报错:Electron failed to install correctly...解决方案,Electron 未能正确安装,请删除 node_modules/electron,然后再次尝试安装,如何解决这个问题,手把手教你解决,在yarn dev时报错,electr

🏆 前端领域优质创作者 4368

hive底层原理 sql执行过程_hive sql编译过程

sql查询语句处理步骤流程图 准备实例,创建表,插入数据,写要分析的实例查询语句1.首先创建两个表 2.创建两个表,并插入表数据,脚本略3.编写咱们要解析的查询语句,即本篇要查询的实例语句。select top(4) status , max(m.id) as maxMemberIDfrom [dbo].[Member] as m right outer join [dbo].[Order] a...

weixin_30371285的博客 364

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

详细剖析Hive SQL的编译过程

Hive SQL的编译过程

曹利荣的博客 571

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Hive SQL编译过程

Hive SQL的编译过程Hive是基于Hadoop的一个数据仓库系统,在各大公司都有广泛的应用。美团数据仓库也是基于Hive搭建,每天执行近万次的Hive ETL计算流程,负责每天数百GB的数据存储和分析。Hive的稳定性和性能对我们的数据分析非常关键。在几次升级Hive的过程中,我们遇到了一些大大小小的问题。通过向社区的咨询和自己的努力,在解决这些问题的同时我们对Hive将SQL编译为MapReduce的过程有了比较深入的理解。对这一过程的理解不仅帮助我们解决了一些Hive的bug,也有利于我们优化Hi

qq_40468327的博客 633

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

hive的sql编译过程详解

1、MapReduce实现基本SQL操作的原理 详细讲解SQL编译为MapReduce之前,我们先来看看MapReduce框架实现SQL基本操作的原理 1.1 Join的实现原理 select u.name, o.orderid from order o join user u on o.uid = u.uid; 在map的输出value中为不同表的数据打上tag标记,在reduce阶段...

weixin_38340874的博客 619

hive sql 的编译过程

点击打开链接

小真子的博客 379

Hive SQL的底层编译过程详解

本文结构采用宏观着眼,微观入手,从整体到细节的方式剖析 Hive SQL 底层原理。第一节先介绍 Hive 底层的整体执行流程,然后第二节介绍执行流程中的 SQL 编译成 MapReduce 的过程,第三节剖析 SQL 编译成 MapReduce 的具体实现原理。 Hive 本文首发于公众号【五分钟学大数据】,公众号内可免费查看! Hive是什么?Hive 是数据仓库工具,再具体点就是一个 SQL 解析引擎,因为它即不负责存储数据,也不负责计算数据,只负责解析 SQL,记录元数据。 Hive.

yuan_more的博客 5447
上一篇: hive抽样总结
下一篇: 一个标准hive任务常用的配置项
Alwaysdazz
博客等级 码龄8年 24粉丝 140原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值