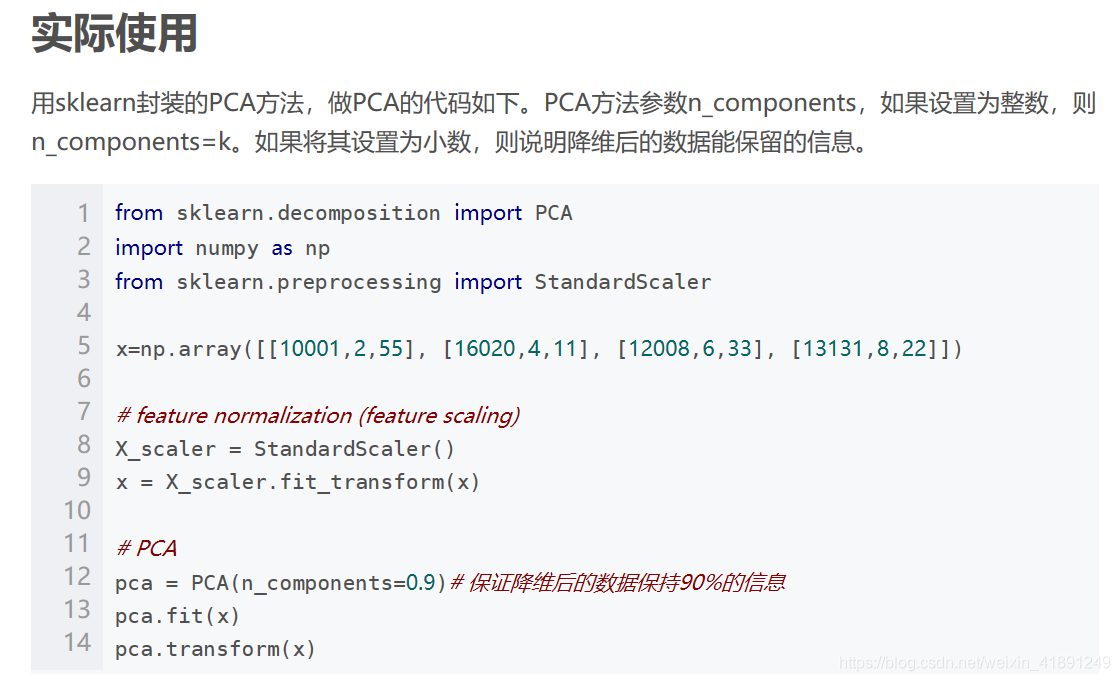
PCA(主成分分析)

数据降维之PCA方法与python实现 在数据分析的应用场景下,收集大量的数据能够更好地去寻找规律,并且更多的特征可以增加研究准确性。但是在大多数情况下,许多特征之间存在关系,从而增加了模型的复杂性,对数据分析带来不便。如果对每个特征进行分析,信息会被孤立。而且减少特征信息, 也很容易产生错误的结论。 为了能够减少分析特征的同时,对收集的数据进行全面的分析,因此用较少的综合指标分析存在于各变量中的各类信息,主要方法有PCA、LDA等 阅读详情

1.相关背景
在许多领域的研究与应用中,通常需要对含有多个变量的数据进行观测,收集大量数据后进行分析寻找规律。多变量大数据集无疑会为研究和应用提供丰富的信息,但是也在一定程度上增加了数据采集的工作量。更重要的是在很多情形下,许多变量之间可能存在相关性,从而增加了问题分析的复杂性。如果分别对每个指标进行分析,分析往往是孤立的,不能完全利用数据中的信息,因此盲目减少指标会损失很多有用的信息,从而产生错误的结论。

因此需要找到一种合理的方法,在减少需要分析的指标同时,尽量减少原指标包含信息的损失,以达到对所收集数据进行全面分析的目的。由于各变量之间存在一定的相关关系,因此可以考虑将关系紧密的变量变成尽可能少的新变量,使这些新变量是两两不相关的,那么就可以用较少的综合指标分别代表存在于各个变量中的各类信息。主成分分析与因子分析就属于这类降维算法。

2. 数据降维
降维就是一种对高维度特征数据预处理方法。降维是将高维度的数据保留下最重要的一些特征,去除噪声和不重要的特征,从而实现提升数据处理速度的目的。在实际的生产和应用中,降维在一定的信息损失范围内,可以为我们节省大量的时间和成本。降维也成为应用非常广泛的数据预处理方法。

降维具有如下一些优点:

1) 使得数据集更易使用。
2) 降低算法的计算开销。
3) 去除噪声。
4) 使得结果容易理解。
降维的算法有很多,比如奇异值分解(SVD)、主成分分析(PCA)、因子分析(FA)、独立成分分析(ICA)。

3. PCA原理详解
3.1 PCA的概念
PCA(Principal Component Analysis),即主成分分析方法,是一种使用最广泛的数据降维算法。PCA的主要思想是将n维特征映射到k维上,这k维是全新的正交特征也被称为主成分,是在原有n维特征的基础上重新构造出来的k维特征。PCA的工作就是从原始的空间中顺序地找一组相互正交的坐标轴,新的坐标轴的选择与数据本身是密切相关的。其中,第一个新坐标轴选择是原始数据中方差最大的方向,第二个新坐标轴选取是与第一个坐标轴正交的平面中使得方差最大的,第三个轴是与第1,2个轴正交的平面中方差最大的。依次类推,可以得到n个这样的坐标轴。通过这种方式获得的新的坐标轴,我们发现,大部分方差都包含在前面k个坐标轴中,后面的坐标轴所含的方差几乎为0。于是,我们可以忽略余下的坐标轴,只保留前面k个含有绝大部分方差的坐标轴。事实上,这相当于只保留包含绝大部分方差的维度特征,而忽略包含方差几乎为0的特征维度,实现对数据特征的降维处理。

思考:我们如何得到这些包含最大差异性的主成分方向呢?

答案:事实上,通过计算数据矩阵的协方差矩阵,然后得到协方差矩阵的特征值特征向量,选择特征值最大(即方差最大)的k个特征所对应的特征向量组成的矩阵。这样就可以将数据矩阵转换到新的空间当中,实现数据特征的降维。

由于得到协方差矩阵的特征值特征向量有两种方法:特征值分解协方差矩阵、奇异值分解协方差矩阵,所以PCA算法有两种实现方法:基于特征值分解协方差矩阵实现PCA算法、基于SVD分解协方差矩阵实现PCA算法。

既然提到协方差矩阵,那么就简单介绍一下方差和协方差的关系。然后概括介绍一下特征值分解矩阵原理、奇异值分解矩阵的原理。概括介绍是因为在我之前的机器学习中SVD总结文章中已经详细介绍了特征值分解原理和奇异值分解原理,这里就不再重复讲解了。可以看我的机器学习中SVD总结

3.2 协方差和散度矩阵

样本均值:

样本方差:

样本X和样本Y的协方差:
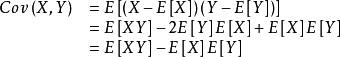
由上面的公式,我们可以得到以下结论:

(1) 方差的计算公式是针对一维特征,即针对同一特征不同样本的取值来进行计算得到;而协方差则必须要求至少满足二维特征;方差是协方差的特殊情况。

(2) 方差和协方差的除数是n-1,这是为了得到方差和协方差的无偏估计。

协方差为正时,说明X和Y是正相关关系;协方差为负时,说明X和Y是负相关关系;协方差为0时,说明X和Y是相互独立。Cov(X,X)就是X的方差。当样本是n维数据时,它们的协方差实际上是协方差矩阵(对称方阵)。例如,对于3维数据(x,y,z),计算它的协方差就是:

从直观上来看,协方差表示的是两个变量总体误差的期望。

如果两个变量的变化趋势一致,也就是说如果其中一个大于自身的期望值时另外一个也大于自身的期望值,那么两个变量之间的协方差就是正值;如果两个变量的变化趋势相反,即其中一个变量大于自身的期望值时另外一个却小于自身的期望值,那么两个变量之间的协方差就是负值。

如果X与Y是统计独立的,那么二者之间的协方差就是0,因为两个独立的随机变量满足E[XY]=E[X]E[Y]。

但是,反过来并不成立。即如果X与Y的协方差为0,二者并不一定是统计独立的。

协方差Cov(X,Y)的度量单位是X的协方差乘以Y的协方差。而取决于协方差的相关性,是一个衡量线性独立的无量纲的数。

协方差为0的两个随机变量称为是不相关的。

本段来源于百度百科:https://baike.baidu.com/item/%E5%8D%8F%E6%96%B9%E5%B7%AE/2185936?fr=aladdin

协方差矩阵(散布矩阵)在模式识别中应用广泛,最典型的应用是PCA主成分分析了,PCA主要用于降维,其意义就是将样本数据从高维空间投影到低维空间中,并尽可能的在低维空间中表示原始数据。这就需要找到一组最合适的投影方向,使得样本数据往低维投影后,能尽可能表征原始的数据。此时就需要样本的协方差矩阵。PCA算法就是求出这堆样本数据的协方差矩阵的特征值和特征向量,而协方差矩阵的特征向量的方向就是PCA需要投影的方向。
 

 在机器学习模式识别中,经常需要应用到协方差矩阵C和散布矩阵S。如在PCA主成分分析中,需要计算样本的散度矩阵,有的论文是计算协方差矩阵。实质上二者意义差不多,散布矩阵(散度矩阵)前乘以系数1/(n-1)就可以得到协方差矩阵了。

散布矩阵:

在模式识别的教程中,散布矩阵也称为散度矩阵,有的也称为类内离散度矩阵或者类内离差阵,用一个等式关系可表示为:

关系:散度矩阵=类内离散度矩阵=类内离差阵=协方差矩阵×(n-1)       

样本的协方差矩阵乘以n-1倍即为散布矩阵,n表示样本的个数,散布矩阵的大小由特征维数d决定,是一个为d×d 的半正定矩阵。

3.3 特征值分解矩阵原理
(1) 特征值与特征向量

如果一个向量v是矩阵A的特征向量,将一定可以表示成下面的形式:


其中,λ是特征向量v对应的特征值,一个矩阵的一组特征向量是一组正交向量。
(2) 特征值分解矩阵

对于矩阵A,有一组特征向量v,将这组向量进行正交化单位化,就能得到一组正交单位向量。特征值分解,就是将矩阵A分解为如下式:

其中,Q是矩阵A的特征向量组成的矩阵, \Sigma则是一个对角阵,对角线上的元素就是特征值。

3.4 SVD分解矩阵原理
奇异值分解是一个能适用于任意矩阵的一种分解的方法,对于任意矩阵A总是存在一个奇异值分解:

假设A是一个m*n的矩阵,那么得到的U是一个m*m的方阵,U里面的正交向量被称为左奇异向量。Σ是一个m*n的矩阵,Σ除了对角线其它元素都为0,对角线上的元素称为奇异值。是v的转置矩阵,是一个n*n的矩阵,它里面的正交向量被称为右奇异值向量。而且一般来讲,我们会将Σ上的值按从大到小的顺序排列。

SVD分解矩阵A的步骤:

(1) 求的特征值和特征向量,用单位化的特征向量构成 U。

(2) 求的特征值和特征向量,用单位化的特征向量构成 V。

(3) 将或者的特征值求平方根,然后构成 Σ。

3.5 PCA算法两种实现方法
(1) 基于特征值分解协方差矩阵实现PCA算法
输入:数据集,需要降到k维。
1) 去平均值(即去中心化),即每一位特征减去各自的平均值。

2) 计算协方差矩阵,注:这里除或不除样本数量n或n-1,其实对求出的特征向量没有影响。

3) 用特征值分解方法求协方差矩阵的特征值与特征向量。

4) 对特征值从大到小排序,选择其中最大的k个。然后将其对应的k个特征向量分别作为行向量组成特征向量矩阵P。

5) 将数据转换到k个特征向量构建的新空间中,即Y=PX。

总结:

1)关于这一部分为什么用,这里面含有很复杂的线性代数理论推导,想了解具体细节的可以看下面这篇文章。
CodingLabs - PCA的数学原理

2)关于为什么用特征值分解矩阵,是因为 是方阵,能很轻松的求出特征值与特征向量。当然,用奇异值分解也可以,是求特征值与特征向量的另一种方法。

举个例子:


以X为例,我们用PCA方法将这两行数据降到一行。

1)因为X矩阵的每行已经是零均值,所以不需要去平均值。

2)求协方差矩阵:

3)求协方差矩阵的特征值与特征向量。

求解后的特征值为:

对应的特征向量为:

其中对应的特征向量分别是一个通解,和可以取任意实数。那么标准化后的特征向量为:

4)矩阵P为:

5)最后我们用P的第一行乘以数据矩阵X,就得到了降维后的表示:

结果如图1所示:

                            图1:数据矩阵X降维投影结果

注意:如果我们通过特征值分解协方差矩阵,那么我们只能得到一个方向的PCA降维。这个方向就是对数据矩阵X从行(或列)方向上压缩降维。

(2) 基于SVD分解协方差矩阵实现PCA算法
输入:数据集,需要降到k维。

1) 去平均值,即每一位特征减去各自的平均值。

2) 计算协方差矩阵。

3) 通过SVD计算协方差矩阵的特征值与特征向量。

4) 对特征值从大到小排序,选择其中最大的k个。然后将其对应的k个特征向量分别作为列向量组成特征向量矩阵。

5) 将数据转换到k个特征向量构建的新空间中。

在PCA降维中,我们需要找到样本协方差矩阵的最大k个特征向量,然后用这最大的k个特征向量组成的矩阵来做低维投影降维。可以看出,在这个过程中需要先求出协方差矩阵,当样本数多、样本特征数也多的时候,这个计算还是很大的。当我们用到SVD分解协方差矩阵的时候,SVD有两个好处:

1) 有一些SVD的实现算法可以先不求出协方差矩阵也能求出我们的右奇异矩阵V。也就是说,我们的PCA算法可以不用做特征分解而是通过SVD来完成,这个方法在样本量很大的时候很有效。实际上,scikit-learn的PCA算法的背后真正的实现就是用的SVD,而不是特征值分解。

2)注意到PCA仅仅使用了我们SVD的左奇异矩阵,没有使用到右奇异值矩阵,那么右奇异值矩阵有什么用呢?

假设我们的样本是m*n的矩阵X,如果我们通过SVD找到了矩阵最大的k个特征向量组成的k*n的矩阵 ,则我们可以做如下处理:

可以得到一个m*k的矩阵X',这个矩阵和我们原来m*n的矩阵X相比,列数从n减到了k,可见对列数进行了压缩。也就是说,左奇异矩阵可以用于对行数的压缩;右奇异矩阵可以用于对列(即特征维度)的压缩。这就是我们用SVD分解协方差矩阵实现PCA可以得到两个方向的PCA降维(即行和列两个方向)。

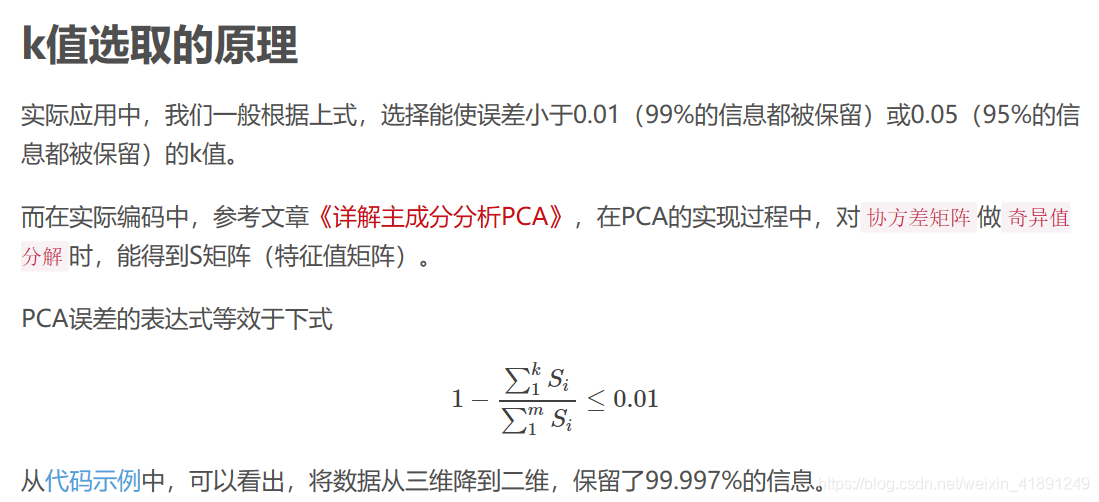
4. 关于k值的选取

PCA的原理是,为了将数据从n维降低到k维,需要找到k个向量,用于投影原始数据,是投影误差(投影距离)最小。
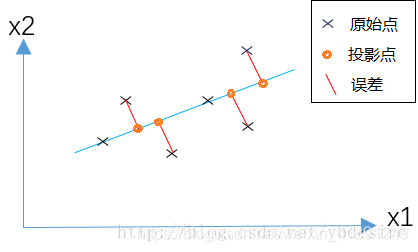
公式表达为:
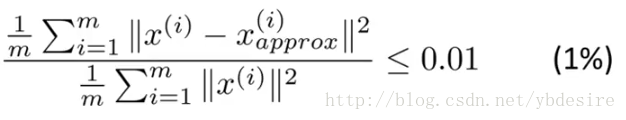
其中m表示特征个数

分子表示原始点与投影点之间的距离之和,而误差越小,说明降维后的数据越能完整表示降维前的数据。如果这个误差小于0.01,说明降维后的数据能保留99%的信息。


部分转载于:https://blog.youkuaiyun.com/program_developer/article/details/80632779

部分转载于:https://blog.youkuaiyun.com/weixin_41891249/article/details/88051479

关于pca的更多理解可以参考:https://www.cnblogs.com/pinard/p/6239403.html

Maths | 主成分分析法(离散K-L变换) 目录 1. 概述 2. K-L变换方法和原理推导 2.1. 向量分解 2.2. 向量估计及其误差 2.3. 寻找最小误差对应的正交向量系 3. K-L变换高效率的本质 4. PCA在编、解码应用上的进一步推导 ... 阅读详情

相关推荐

主成分分析(PCA)原理详解

机器学习中有关特征选择的问题,其实就是要剔除和类标签无关的特征,去除噪声或者冗余。在这种情况下,需要一种特征降维的方法来减少特征数,减少噪音和冗余,减少过度拟合的可能性。PCA的思想是将n维特征映射到k维上(k<n),这k维是全新的正交特征。这k维特征称为主成分,是重新构造出来的k维特征,而不是简单地从n维特征中去除其余n-k维特征。现在的问题是,对于很高维数据,你能想象其分布吗?就算能描述分布,如何精确地找到这些主成分的轴?如何衡量你提取的主成分到底占了整个数据的多少信息?所以,我们就要用到主成分分析的处

李春春的专栏 47万+

理解PCA

0.精简 <1>数据投影越分散的方向,代表数据差异越大,即特征越明显。 <2>方差可以用来代表分散程度,协方差用于保证不同方向的正交性。 <3>协方差矩阵的对角化可以达到在变换方向方差最大,且协方差为0,即保证正交。 1.PCA用途 PCA全称Principal Component Analysis,即主成分分析。其通过 线性变换,将原始数据变换为一组 线性无关...

tianming1992的专栏 355

PCA:详细解释主成分分析

1 PCA目的/作用 主成分分析算法(PCA)是最常用的线性降维方法,它的目标是通过某种线性投影,将高维的数据映射到低维的空间中,并期望在所投影的维度上数据的信息量最大(方差最大),以此使用较少的数据维度,同时保留住较多的原数据点的特性。 PCA降维的目的,就是为了在尽量保证“信息量不丢失”的情况下,对原始特征进行降维,也就是尽可能将原始特征往具有最大投影信息量的维度上进行投影。将原特征投影到...

lanyuelvyun的博客 22万+

主成分分析(PCA)详解

主成分分析(PCA)原理与应用

weixin_60737527的博客 9万+

PCA主成分分析

PCA主成分分析 PCA(principal components analysis)主成分分析是一种较老的一种应用于降维的方法,其目的是在于找到一种线性映射,将原始输入向量映射至较低维向量空间,同时使得向量间的方差最大(为了使得各向量能区分的更好)。并且,该线性映射不是普通的线性映射,而是正交的,使得映射后各维度正交以更好地解释。 下面来具体解释一下PCA的内部推导过程 原理篇 根据我们...

大熊的博客 6738

主成分分析(PCA)

基本概念 主成分分析(Principal Component Analysis, PCA)是研究如何将多指标问题转化为较少的综合指标的一种重要的统计方法,它能将高维空间的问题转化到低维空间去处理,使问题变得比较简单、直观,而且这些较少的综合指标之间互不相关,又能提供原有指标的绝大部分信息。 PCA是一个无监督问题,不是基于标签,而是基于方差。我们可以认为原始的数据在某一个维度上是非常密集的,P...

愿万事胜意 2272

pca主成分分析_干货 | 如何通俗易懂地理解PCA主成分分析

看点01主成分分析(PCA)主成分分析(Principal Component Analysis,PCA)是一种无监督学习的多元统计分析方法。PCA分析的主要原理是将高维数据投影到较低维空间,提取多元事物的主要因素,揭示其本质特征。它可以高效地找出数据中的主要部分,将原有的复杂数据降维处理。PCA分析被广泛应用于很多领域,比如理论物理学、气象学、心理学、生物学、化学、工程学等。看点02P...

weixin_39614874的博客 4万+

主成分分析PCA

PCA原理及MATLAB实现

沉心修炼 3295

PCA:详解主成分分析

主成分分析算法(PCA)是最常用的线性降维方法,它的目标是通过某种线性投影,将高维的数据映射到低维的空间中,并期望在所投影的维度上数据的信息量最大(方差最大),以此使用较少的数据维度,同时保留住较多的原数据点的特性。

wfengzi5的博客 1万+

保姆级教程:在Zynq UltraScale+ EV系列FPGA上,用VCU IP核搞定4K60帧H265视频解码与HDMI2.0输出

本文提供在Zynq UltraScale+ EV系列FPGA上使用VCU IP核实现4K60帧H265视频解码与HDMI2.0输出的全流程指南。从开发环境准备、Vivado工程配置到PetaLinux系统定制,详细解析硬件选型、IP核参数设置及性能优化技巧,帮助开发者快速构建高效视频处理系统。

weixin_30800987的博客 432

Mplus实战:随机截距交叉滞后模型(RI-CLPM)在心理学纵向研究中的进阶应用

本文深入探讨了随机截距交叉滞后模型(RI-CLPM)在心理学纵向研究中的进阶应用,通过Mplus实战演示了模型设定、结果解读及进阶建模策略。RI-CLPM能有效区分个体间差异和个体内变化,适用于追踪青少年手机使用与抑郁症状等研究。文章还提供了样本量规划、模型比较和结果可视化等实用技巧,助力研究者避免常见陷阱。

weixin_29220405的博客 371

pca 主成分分析_超越普通PCA:非线性主成分分析

主成分分析pcaTL;DR: PCA cannot handle categorical variables because it makes linear assumptions about them. Nonlinear PCA addresses this issue by warping the feature space to optimize explained variance. (...

weixin_26752765的博客 2741

AWD线下攻防赛总结

在本地组策略编辑器里面,依次展开计算机配置—>管理模板—>Windows组件—>远程桌面服务—>远程桌面会话主机—>连接—>限制连接的数量。8.Web目录环境查找相关可疑文件:jpg/png/rar,属性、解压。进程线程:netstat / ps -aux/netstat -apt。4.查看/etc/init.d/rc.local中启动服务有无异常。1.不使用默认口令,修改成复杂的,并确保和web环境连接。5.使用脚本开启进程监控、目录监控、流量监控。文件操作监控.exe/御剑文件监控.exe。

XuJL89的博客 630

基于SPSS的主成分分析(PCA)

主成分分析(Principal Component Analysis,PCA)是一种统计方法。PCA以降维方式,在损失很少信息的前提下通过正交变换将一组可能存在相关性的变量(多个指标)转换为一组线性不相关的变量(少数几个综合指标)。转换生成的综合指标称之为主成分,其中每个主成分都是原始变量的线性组合,且各个主成分之间互不相关,这就使得主成分比原始变量具有某些更优越的代表性。在环境学领域,PCA分析能够从总体上反映各组样本之间的总体差异和组内样本之间的变异度大小。通常我们可以使用SPSS、SIMCA-P、PA

HUANWEIFENXI的博客 1万+

双脉冲测试中IGBT驱动电阻和驱动电容的研究

  在LTspice中没有双脉冲波形发生器,要做一个双脉冲的波形只能用电压源来进行特殊设置,不是很方便,为此我写了一个双脉冲波形发生器,有需要的可以下载。双脉冲波形发生器。   如下,该元器件可以自定义延迟时间Td,第一个脉冲宽度T1,第二个脉冲宽度T3,两个脉冲间隔T2,脉冲循环个数Ncycle以及高低电平Vhigh,Vlow。       IGBT开通时Rg的影响: 如果增大Rg: ①开通延...

gaoyong_wang的博客 8354

Hugging Face快速入门(重点讲解模型(Transformers)和数据集部分(Datasets))

1. Hugging Face是什么,提供了哪些内容 2. Hugging Face模型的使用(Transformer类库) 3. Hugging Face数据集的使用(Datasets类库)

iioSnail的博客 8万+

python主成分分析PCA

主成分PCA分析的基本步骤: · 对数据进行归一化处理(代码中并非这么做的,而是直接减去均值) · 计算归一化后的数据集的协方差矩阵 · 计算协方差矩阵的特征值和特征向量 · 保留最重要的k个特征(通常k要小于n),也可以自己制定,也可以选择一个阈值,然后通过前k个特征值之 和减去后面n-k个特征值之和大于这个阈值,则选择这个k · 找出k个特征值对应的特征向量 · 将m...

fanc的博客 3707

以 Cloud 为核心的设备 mTLS 证书体系:从产品需求到 OP-TEE 安全落地

本文探讨了以云端为核心的物联网设备mTLS证书体系构建方案。文章从产品需求出发,分析了云端必须采用mTLS+证书体系管理设备身份的原因,指出静态Token方案的三大缺陷:身份不可控、运营不可控和审计不可控。重点阐述了mTLS在产品中的核心功能是加密传输和双向认证,并详细列出了云端PKI、设备注册中心等必备组件。在设备侧,强调必须通过OP-TEE技术保护私钥安全,提出了一个包含密钥生成、CSR导出等功能的TA设计方案。最后,文章给出了云端端到端流程示例,说明如何将证书生命周期管理转化为可运营的产品能力,包括自

Interview_TC的博客 642

pca主成分分析结果解释_主成分分析(PCA)原理及SPSS实操

主成分分析(principal components analysis,简称PCA)是一种降维分析,将多个指标转换为少数几个综合指标,由霍特林于1933年首先提出。主成分分析方法之所以能够降维,本质是因为原始变量之间存在着较强的相关性,如果原始变量之间的相关性较弱,则主成分分析不能起到很好的降维效果,所以进行主成分分析前最好先进行相关性分析。一个例子中心城市的综合发展是带动周边地区经济发展的重要动...

weixin_39759155的博客 1万+

【100%通过率】华为OD机试真题 Java&Go 实现【水库蓄水问题】【2022.11 Q4 新题】

给定一个长度为 n 的整数数组height。数组的元素表示山的高度,选择两个元素作为水库的边界,求蓄水量的最大值并输出蓄水量最大时的边界下标(蓄水量相同时输出下标较近的)。

MISAYAONE的博客 1万+

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

主成分分析-PCA

PCA(主成分分析,Principal Component Analysis)是一种常用的数据降维技术。它的主要目的是通过线性变换将原始数据转换到新的坐标系统中,这个新坐标系统的各个坐标轴(即主成分)是原始数据的主要特征方向,这些方向上的数据方差最大,且各坐标轴之间相互正交。通过这种方式,PCA可以在保留数据重要特征的同时,减少数据的维度,简化数据,便于后续的数据处理和分析。

2301_77698138的博客 1681

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

PCA——主成分分析

PCA(主成分分析,Principal Component Analysis)是一种用于降维和特征提取的统计方法。其基本思想是将原始数据投影到一个新的坐标系上,使得数据在新坐标系中的前几个坐标轴上具有最大的方差。广泛用于信号处理、图像识别、机器学习和数据分析等领域。其主要目标是通过减少数据的维度来简化问题,同时尽可能保留原始数据中的重要信息。

qq_56683019的博客 2603

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: 奇异值分解(SVD)
下一篇: LDA(线性判别分析 )
NongfuSpring-wu
博客等级 码龄9年 19粉丝 77原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值