解密prompt系列43. LLM Self Critics

AI 编程时代来临!程序员不得不掌握的核心技能:AI Agent! AI Agent 正在悄悄取代人类工作?深度解析它如何执行任务并超越人类! AI工具如ChatGPT、Copilot正在崛起,单纯依靠代码能力的程序员正面临边缘化风险。在AI编程时代,会写代码只是基本门槛,能够理解用户需求、设计解决方案才是核心竞争力。如果程序员无法培养产品思维、创新能力和跨界协作能力,将很难满足企业对技术价值的需求。 未来的程序员需要从“工具型码农”转变为“产品技术专家”。这要求程序员学会思考产品,懂得用户需求,成为技术与需求的桥梁。协作能力和善用AI工具也是关键,能够通过AI提升效率,将更多精力放在创造性任务上。同时,跨界学习产品经理的逻辑和思维方式,将技术与 阅读详情

前一章我们介绍了基于模型自我合成数据迭代,来提升LLM生成更合理的自我推理思考链路。但在模型持续提升的道路上,只提升Generator能力是不够的,需要同步提升Supervisor、Verifier的能力,才能提供有效的监督优化信号。

人类提供的监督信号有几类,包括人工直接生成最优回答(Demonstration), 人工提供偏好对比(Preference),人工给出优化建议(Critique)等几种,论文中曾提及以上几类信号的难易程度

The Evaluation of AI output is typically faster and easier for humans than the demonstration of ideal output

所以RLHF阶段的引入,除了降低模型模仿,提升泛化,增加更高水平的对齐,其实也有一部分原因是人类生成golden answer的上限是比较低的,毕竟不能雇佣一堆各领域专家来给你生成最优回答,所以训练也就从人类标注转移到了人类评估。

而现在当大模型能力提升到一定水平后,不仅是Demonstration,连Prefernce和Critique也会遇到瓶颈。当前阻碍模型智能进一步提升的一个核心问题就是评估水平的上限,而这时就需要模型评估的辅助,尤其是生成式评估能力的加持,下面我们看两篇OpenAI在生成式评估上的论文。

22年:Self-critiquing models for assisting human evaluators

比较早的这篇论文我们主要看下结论,毕竟模型更大更强了,训练范式也在这两年发生了转变。论文的核心就是机器辅助人类进行标注。可能早在22年之前,OpenAI就已经到了大模型在复杂问题上输出结果接近人类标注员的水平,所以才早早开始研究这个方向。

这里标注的任务已经脱离了早期descriminative的NLP任务,例如多项选择,分类等判断模型,而是已经聚焦在了对生成式模型的输出进行广泛评估。并且机器辅助也并非简单的对/错的分类判别,而是分类判别(critiqueable)、生成式评估(critique)、基于评估的条件优化(refinement)的结合体,如下
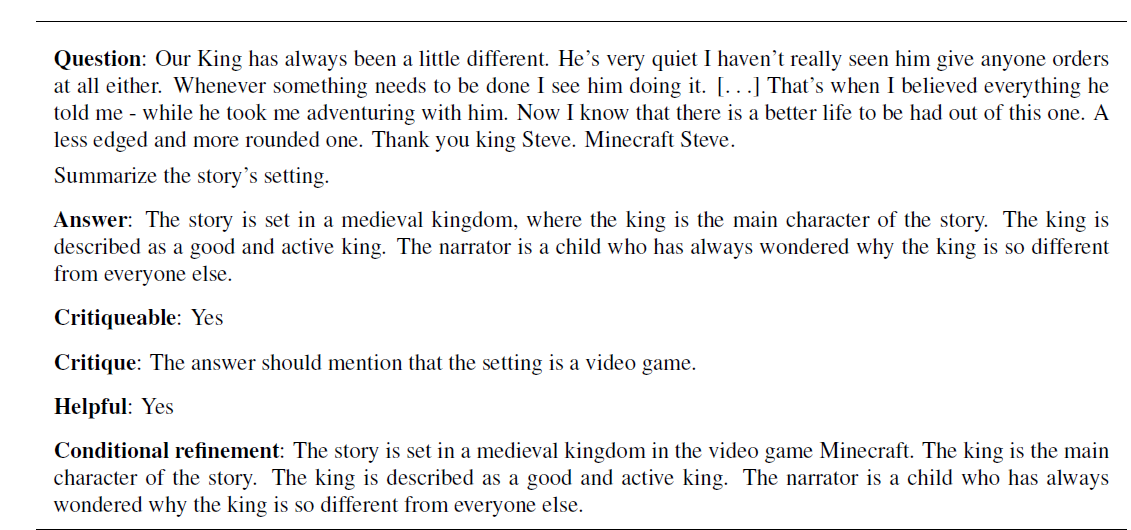
image

论文评估用模型辅助人类标注,得到了以下结论

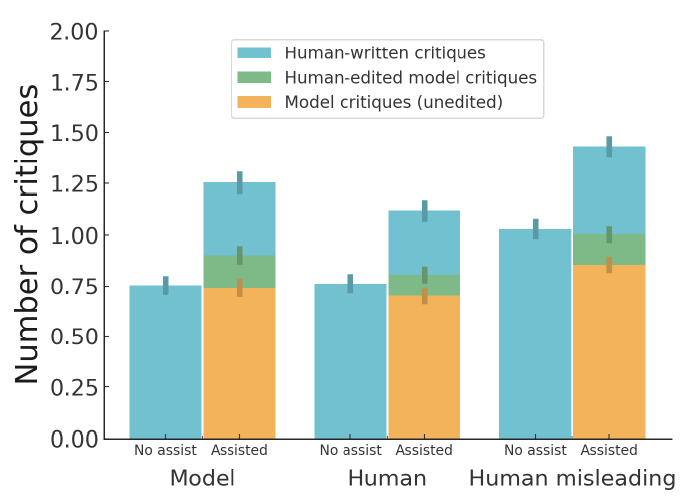
  • 生成式评估可以帮助标注员发现更多模型回答问题(人机协同,相比各自单打独斗能发现更多模型回答的问题)
image

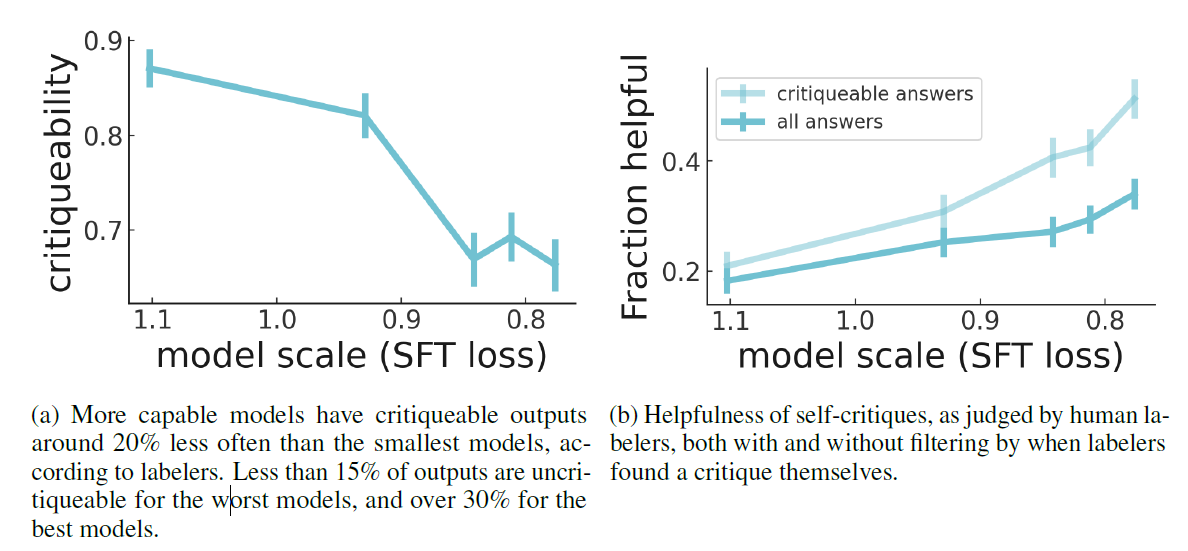
  • 随着模型规模提升,模型的回答会更难被发现问题(critiqueability),但同时模型自我评估的能力也会随之提升(fraction helpful)
image

  • 足够大的模型可以通过自己评估自己的回答,来优化答案生成,通过拒绝采样得到更准确的critique,可以进一步提升效果
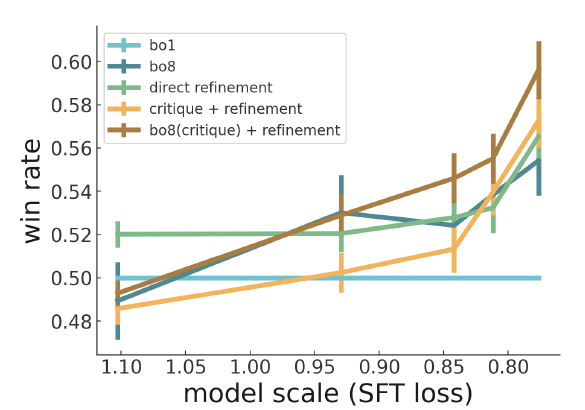
image

24年: LLM Critics Help Catch LLM Bugs

如果说22年初的论文还只是针对在部分人类难以评估的领域,例如生成式摘要上,使用人机协同评估带来的增益。24年的这篇论文就更广泛地讨论Scalable Oversight问题。这是Anthropic也在22年提出的概念,就是当模型能力在多数任务上超越人类时,人类该如何继续为模型提供有效的对齐信号,如下图
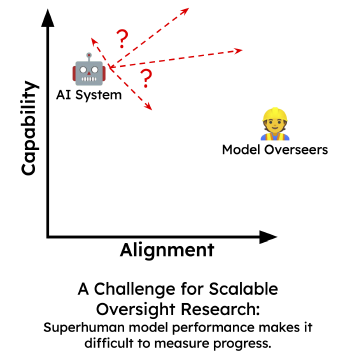
image

论文给出方案就是训练CriticGPT,使用模型生成式评估来辅助人类标注员。并同时给出了在推理时可以平衡问题发现的准召比例的推理方案Force Sampling Beam Search。论文评估在CriticGPT模型的帮助下,人工标注的效果会有显著的提升。下面我们分别讲下训练和推理部分。
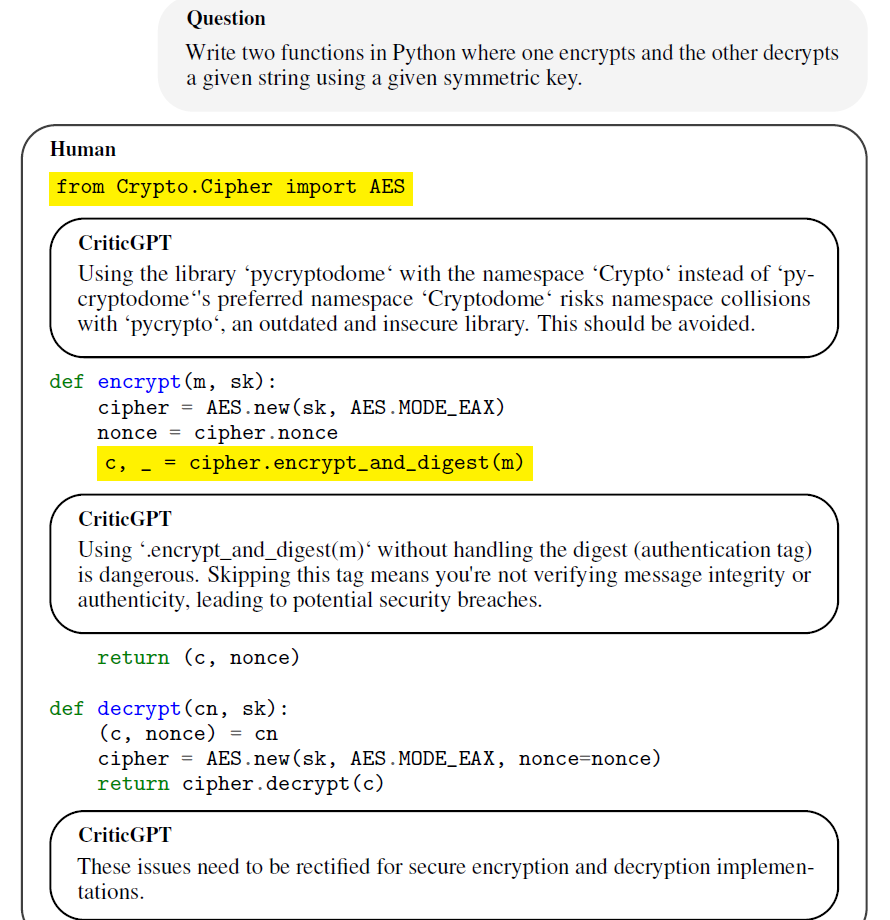
image

数据和训练

论文选择了Coding,这个任务复杂度上限很高,相对容易验证且客观的任务场景。训练的核心在于代码标注RLHF数据集的构建,包括偏好标注标准和数据集组成。什么样的模型标注是好标注?什么样的模型代码样本能让偏好标注的一致性更高,同时数据集足够全面?

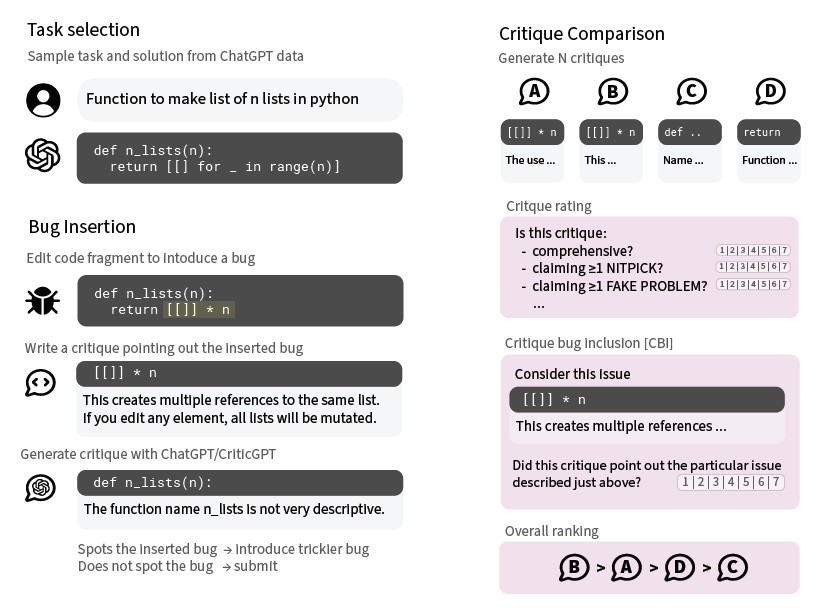
先说数据标注标准,论文综合召回和准确给出了4条衡量模型标注优劣的标准

  • 召回率:模型的标注评论是否发现了回答中的所有Bug
  • 核心召回率(CBI):模型的标注评论是否发现了回答中的核心Bug
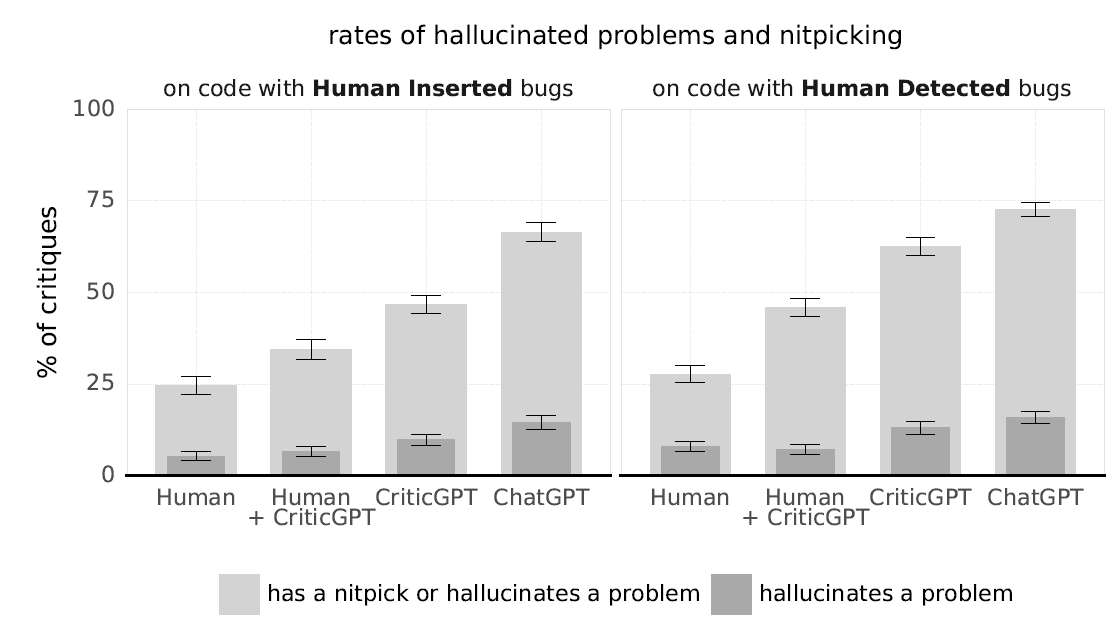
  • 准确率:模型的标注评论是无中生有,或者鸡蛋里挑骨头
  • 综合召回+准确:模型标注评论整体的有用性

人工标注员除了需要对每条模型评论针对以上标准进行打分外,还需要对4条模型标注的整体效果进行对比,最终是使用对比结果来作为RLHF的训练标签,考虑在标注时绝对打分的一致性要远远低于相对打分的一致性。

再说数据构成,整个RLHF的数据集包含两个部分

  • 人工在模型回答中注入Bug,再让模型进行评论
  • 模型回答自带Bug
    image

人工数据部分就是论文的一个亮点,上图就是人工数据构建的过程,既人工在模型回答中加入Bug(Tampering),给出注入Bug的相关解释。之后模型需要在人工修改过的答案上进行标注评论,同时标注员也会依赖Bug说明,来衡量模型生成的多条标注的效果。

这类构造数据在RLHF数据集中占比更高,原因在于相比自带Bug的天然数据,这类加工数据,不仅Bug更加复杂,同时因为自带golden answer,所以在人工标注阶段能得到更一致,准确率更高的标注结果,在偏好数据的标注过程中,审核一致性是非常重要的。同时在收集数据过程中,论文还使用了多个版本,多个大小的模型,来丰富整个RLHF数据集的分布覆盖度。两类数据的占比分布如下
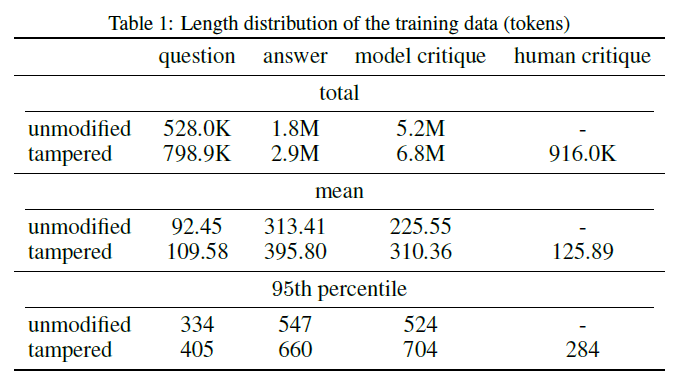
image

偏好数据收集完,后面就是比较常规的训练Reward模型,再基于reward模型,使用PPO训练CriticGPT。

推理和效果

推理时,论文采用了Reward模型和推理搜索结合的方式,目标是提高模型标注的长度,并降低回答幻觉。其实也很简单就是在单纯reward 打分的基础上,加了一个模型引用源代码段落数的得分。

模型标注的推理格式是引用一段源代码,再分析一下这段代码的问题,所以在打分中加入代码数可以鼓励模型推理对更多的源代码片段进行分析,从而发现更多的Bug,而reward打分则用于控制幻觉,这样既保质也保量。

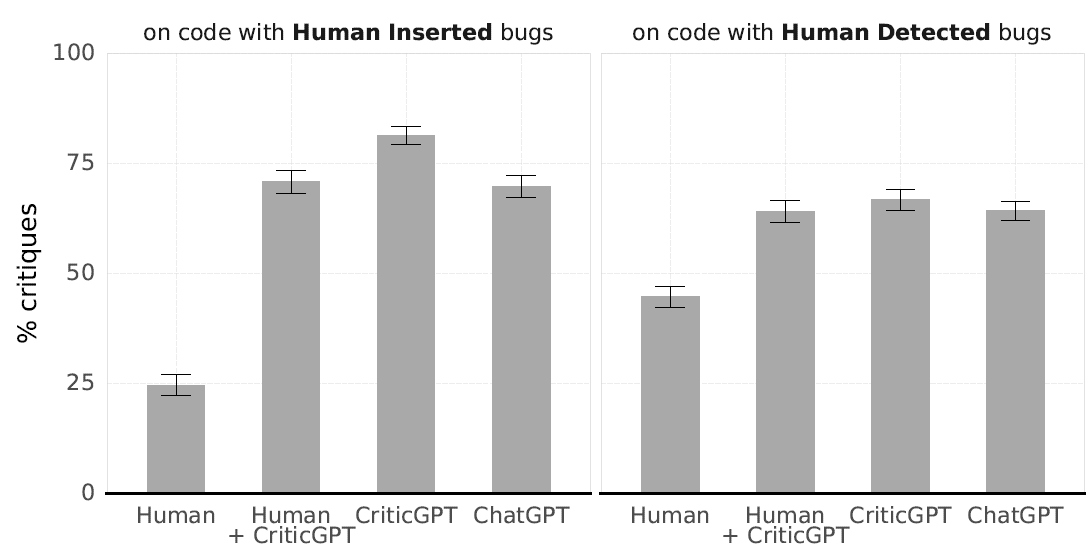
效果上,有模型标注协同,人工标注可以显著发现更多的bug,并且相比单纯使用criticGPT进行机器标注,会有显著更低的幻觉比例。整体上criticGPT配合人工标注是更加balance的模型标注方案。
image

image

想看更全的大模型论文·微调预训练数据·开源框架·AIGC应用 >> DecryPrompt

原创作者: gogoSandy 转载于: https://www.cnblogs.com/gogoSandy/p/18566753
从规则到模型:Rerank 精排与 LLM 的结构化 Prompt 设计 本文介绍如何通过Rerank模型与精心设计的Prompt,提升代码知识图谱中候选方案的精准度。采用BAAI/bge-reranker-v2-m3进行语义重排,结合Cross-Encoder实现细粒度排序;并通过结构化Prompt约束LLM输出可落地的JSON格式修改方案,避免幻觉与冗余。同时提出应对Token溢出、函数越界、历史经验忽略等三大坑点的解决方案。最终输出仅包含Top 4高相关代码片段,为下阶段“人在回路”的安全代码修改奠定基础。 阅读详情

相关推荐

红外:非均匀性校正01_基本原理与基本方法

非均匀校正(nonuniformity correction,NUC) 基本原理 这里要表达的意思就是:图中每一条直线对应一个像素点的,亮度/辐照度的情况。由于硬件的关系,每一个像素点的线性响应很不一样,所以需要通过矩阵来校正。 校正原理: 一点校正 两点校正 其他原理介绍: 参考链接: 基于多项式拟合的红外焦平面非均匀校正 课件:光电成像——非均匀性校正 红外图像非均匀性校正相关汇总 红外非均匀性校正算法总结 红外图像非均匀矫正——一点矫正 ...

dlvector的博客 2万+

智能体核心架构解析:记忆、规划与行动的协同之道

在人工智能快速演进的今天,**智能体(Agent)** 已成为连接大语言模型(LLM)与现实应用的重要桥梁。从自动化代码生成到复杂任务规划,从信息检索到自主决策,智能体的能力正不断突破。支撑这一切的,是其背后的核心机制:**记忆(Memory)**、**规划决策(Planning)** 与 **行动(Action)**。本文将以架构图为基础,深入解析智能体的内部逻辑体系,探讨其核心组件如何协同运作,进而实现类人智能的思考与行动。

cooldream2009的博客 1164

Appstore开发者必读:3.2(f)违规预警与高效申诉指南

本文为AppStore开发者提供了应对3.2(f)违规通知的完整指南。文章深度解析了3.2(f)条款下的隐瞒性、关联性与真实性违规类型,并提供了黄金48小时内的自查、申诉信撰写与提交全流程策略。同时,文章强调遵循App Review Guidelines,建立内部合规清单与保持账号独立,是预防违规、维护开发者账号安全的关键。

weixin_29214559的博客 272

AI Agent - 7大认知框架全解析与代码实现

出品丨咖哥 AI作者|黄佳AI Agent,最近火得一塌糊涂。Sam Altman 曾这样描述未来的AI Agent:“今天的AI模型是它们将会是的最‘笨’状态,未来只会越来越聪明!” 吴恩达在AI Ascent 2024会议上也不吝赞美:“这是AI发展的黄金时代,生成式AI和AI Agent将彻底改变我们工作的方式!”。这些业界领袖的话让人感受到未来AI与人类生活、工作的深度融合正在加速到来...

AI科技大本营 7257

Ai数字人直播系统搭建,本地源码部署,源码交付--支持OEM系统贴牌

AI 数字人直播系统是利用人工智能技术创建虚拟主播,并通过数字化技术实现直播互动的系统1。以下是其相关介绍:Ai数字人直播系统搭建,本地源码部署,源码交付--支持OEM系统贴牌。

weixin_ggwwsscc的博客 620

9篇3章3节:FAERS数据库公共仪表板搜索功能操作与解析

FAERS(FDA不良事件报告系统)公共仪表板是一个强大的工具,用于查询和分析药物及生物制品的不良事件数据。通过该仪表板,用户可以按药品或不良反应进行搜索,查看报告数量、事件类型及时间分布,从而辅助药物安全性分析和科研研究。本文重点介绍仪表板的搜索功能,包括按产品和按不良反应查询的操作步骤、筛选与多维数据分析方法,以及关键概念的解释,帮助用户科学、理性地使用FAERS数据,提升用药决策的准确性和安全性。

MD Code 1585

探索语言模型的安全边界:PromptInject

探索语言模型的安全边界:PromptInject PromptInjectPromptInject is a framework that assembles prompts in a modular fashion to provide a quantitative analysis of the robustness of LLMs to adversarial prompt attacks...

gitblog_00070的博客 596

基于 Simulink 的固态变压器(SST)多级协同控制实战教程

《固态变压器多级协同控制仿真指南》摘要: 本教程详细讲解了基于Simulink的固态变压器(SST)三级架构建模与控制方法。核心内容包含:1)搭建级联H桥整流(CHB)、双有源桥(DAB)和逆变器(VSI)的三级主电路;2)提出创新的多级协同控制策略,通过功率前馈实现输入输出级动态匹配;3)给出系统级功率平衡、单元级均压控制的具体实现方案。教程特别强调解决实际工程中的关键问题:代数环处理、软启动设计和刚性系统求解器选择,并提供了硬件在环(HIL)仿真建议。附带的MATLAB代码示例可直接用于实现电容电压均衡

xiaoheshang_123的博客 117

评测驱动优化:失败样本回流 Prompt 的闭环

AgentScope 2.0 提出评测驱动的闭环优化:通过规则化评测、失败样本定位、Prompt 修正与回归验证,实现零成本迭代。核心在于“定位”环节——基于失败模式判断根因层级(Prompt/词表/代码),避免无效修改。结合自动诊断函数与达标率基线对比,确保改进可度量、可复现,显著提升 Prompt 优化效率与准确性。

sangev5的博客 494

AgentScope Java 入门:Spring AI Alibaba 与 AgentScope 的定位与区别

摘要:Spring AI Alibaba是阿里基于Spring AI开发的本地化AI应用框架,旨在服务Java开发者。它提供模型接入、函数调用、RAG等功能,并与阿里云基础设施深度集成。同时,阿里开源了多智能体框架AgentScope,其Java版(AgentScope-Java)专注于Agentic设计理念。两者将协同发展:Spring AI Alibaba侧重Spring生态集成,AgentScope-Java强化智能体能力。未来计划包括支持AgentScope、升级Admin平台,以及推进Server

SmartSi 1532

即插即用系列(代码实践) | WACV 2024 CSAM:面向各向异性医学图像分割的 2.5D 跨切片注意力模块

文章摘要: 论文《CSAM: A 2.5D Cross-Slice Attention Module for Anisotropic Volumetric Medical Image Segmentation》提出了一种解决医学图像各向异性问题的创新模块CSAM。针对MRI/CT数据中切片间分辨率差异大的挑战,该模块通过2.5D跨切片注意力机制,结合2D卷积的轻量性和3D上下文感知能力。核心包括语义注意力(通道级)、位置注意力(空间级)和跨切片注意力(支持不确定性建模),能在几乎不增加参数量的情况下有效捕捉

分享顶会顶刊论文即插即用模块 104

【vibe coding】可复用的开发任务 Prompt 模板

下面是可复用的开发任务 Prompt 模板,替换。

qq_27408783的博客 201

2024 大型集团人力资源数字化转型业务蓝图规划及实施路径规划方案【附全文阅读】

摘要:本方案针对大型企业人力资源数字化转型需求,重点解决组织协同弱、薪酬绩效管控难等痛点。通过构建"6项能力+8大流程+4大系统"框架,分三阶段(2024-2026年)实施7大项目,包括e-HR系统更换、员工服务平台搭建等核心场景。方案优先推进基础系统改造(2024年),再完善绩效管理和数据分析(2025年),最后落地人才发展等进阶模块(2026年),实现与OA、ERP系统的数据集成,全面提升HR运营效率和员工体验。文末提供的优先级清单明确了10个数字化场景的实施顺序及预期价值。

cdfunlove的博客 1345

大模型PromptCache对齐实战:从缓存穿透到成本打一折

长文本大模型调用成本高昂、响应迟缓,根源常在于Prompt结构不当导致前缀缓存失效。文中揭示:动态时间戳等变量置于System Prompt首部会破坏前缀树哈希匹配,致缓存命中率归零。通过重构为“静态内容置顶、动态变量沉底”的结构对齐范式,实现97.9%缓存命中率,首字延迟从2秒降至195毫秒,成本降低90%,性能提升十倍。掌握底层缓存机理,以极小改动撬动巨大效益,是大模型工程化的关键护城河。

艺杯羹的博客 493

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Agent演化史(九):多智能体的暗面,当一次 prompt 注入可以横向移动

横向劫持的最终目的几乎总是。

lfs124596的博客 664

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

第 10 篇|AI 特有风险:prompt injection、工具投毒与「AI 说的≠用户同意的」

本文聚焦银行MCP Connector身份认证与授权设计,基于MCP 2026规范与OWASP LLM 2025,提出“确定性防线优先”原则。针对提示注入、工具投毒、数据外泄等风险,强调通过工具不可用、权限最小化、设备签核等确定性控制阻断攻击路径,杜绝依赖模型判断。重点防范“AI说的即用户同意”的反模式,确保敏感操作必须由用户主动确认,实现安全可控的AI银行业务闭环。

PhilZhou的专栏 507

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

【LLM推理与Serving⑥】Prefill/Decode解耦架构:让长prompt不再卡住短请求

Prefill是计算密集型的"批量任务",Decode是带宽密集型的"流式任务"。它们的资源瓶颈完全不同,调度目标也完全不同。把它们硬塞在一起,结果就是两边都做不好。在讲PD解耦之前,先提一下另一个缓解Prefill/Decode干扰的技术——Chunked Prefill(分块预填充)。把长prompt分成小块,一块一块地做prefill,中间穿插decode步骤。没有 Chunked Prefill:↑ 等了很久才开始 decode。

Dawson Zhu的博客 389

【Agent】从Prompt工程、Context工程到 Harness工程,让 AI 能真正完成工作

【Agent】从Prompt工程、Context工程到 Harness工程,让 AI 真正完成工作 文章目录 【Agent】从Prompt工程、Context工程到 Harness工程,让 AI 真正完成工作 一、三种工程视角:解决不同问题 1. Prompt 工程:明确任务目标与执行要求 2. Context 工程:组织可检索、可复用的任务信息 3. Harness 工程:连接知识、行动与验证反馈 4. 三种工程视角的适用范围 二、Harness Engineering 的职责边界及其与 FDE 的关系

小哈里的博客 447

LangChain 从0入门:模型、消息、Prompt、Tools、记忆、Agent与LangSmith实战

大模型原生能力只支持单次问答、没有记忆、无法联网、不能调用外部接口。LangChain 是一套LLM应用编排开源框架,它把模型调用、提示词、会话记忆、工具调用、Agent智能体、链路观测能力封装成标准化组件,让开发者可以快速搭建对话机器人、知识库RAG、联网搜索Agent、自动化工作流等应用,而不用从零处理消息拼接、工具解析、上下文管理等重复逻辑。

2302_80192044的博客 274

MCP实战02:核心原语:Tools / Resources / Prompts / Sampling

你写的 MCP Server 到底该把能力暴露成 Tool 还是 Resource?这课给你三种原语的决策表:Tools 模型自动调用、Resources 应用侧挂载、Prompts 人选触发,外加 2026-07-28 已弃用的 Sampling/Roots 该用什么替代。每个原语配最小 JSON 报文,你能照着设计自己的 Server 接口而不再混淆三者边界。

Blockbuster-drug 418

构建翻译软件实例(ChatPromptTemplate)

ChatPromptTemplate 专为聊天模型设计,将 prompt 拆分为 system、human、ai 三类角色消息,支持模板变量,输出为消息列表,可直接传给 chat 模型。与仅输出字符串的 PromptTemplate 相比,更契合现代 chat 模型输入格式。示例展示了一个命令行翻译工具,通过动态注入目标语言和文本,实现多语种精准翻译,执行效果良好,输出自然流畅。

weixin_44875787的博客 92

大模型 Prompt 工程在电商订单系统中的踩坑记录

引言作为一名在电商订单系统开发中摸爬滚打的程序员,我在尝试引入大模型进行智能客服、订单状态预判等自动化任务时,对大模型 Prompt 工程的不熟悉造成了许多不必要的麻烦。我所使用的系统涉及订单处理、用户咨询、物流追踪等多个模块,初期希望通过 Prompt 工程来提升客服效率并减少人工成本。但事与愿违,在使用大模型的过程中,我多次因为 Prompt 设计不当导致生成结果偏差,甚至影响了系统的稳定性和准确性。

wuchangjian的专栏 105

前端转 AI 100 天 Day 36:Prompt 工程入门——从“感觉对了就行”到方法论

Prompt 四要素:角色 + 任务 + 约束 + 示例,不是随便问一句System Prompt 是大杀器:放"准则"而不是"具体问题",一次写好处处用Prompt 是可测试的工程产物:给测试用例、A/B 对比、版本管理Prompt 工程最反直觉的一点:写得越详细,效果反而越好。新手总觉得"AI 应该能懂我的意思",结果给一个模糊的 prompt,得到一个模糊的答案。“AI 不会读心术,你必须把要求说清楚。这和带新人一模一样。带新人:写清楚的文档、给示例、说明边界写 Prompt。

盗梦喆丶 321

AI 应用的安全红线:Spring AI 下的 Prompt 注入防护、PII 脱敏、输出审计与密钥管理

本文基于 Spring AI 2.0.1,通过 Advisor 机制构建AI应用安全防护体系,覆盖四层威胁面:输入(Prompt注入防护)、数据(PII双向脱敏)、工具(越权调用鉴权)与输出(审计留痕)。结合系统提示加固、输入拦截、脱敏链路、权限校验及密钥生命周期管理,实现统一安全网关。强调关键实践:拒绝硬编码密钥、输出前脱敏、工具执行前鉴权,防范注入、泄露与越权风险,保障生产级AI应用安全合规。

weixin_43128865的博客 830
上一篇: javafx使用gpu加速
下一篇: 重写IE的showModalDialog模态框以兼容现代浏览器
焚海炖鱼
博客等级 码龄8年 29粉丝 64原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值