


百度OCR申请:
先申请一个百度账号,然后搜索百度智能云,登录进入
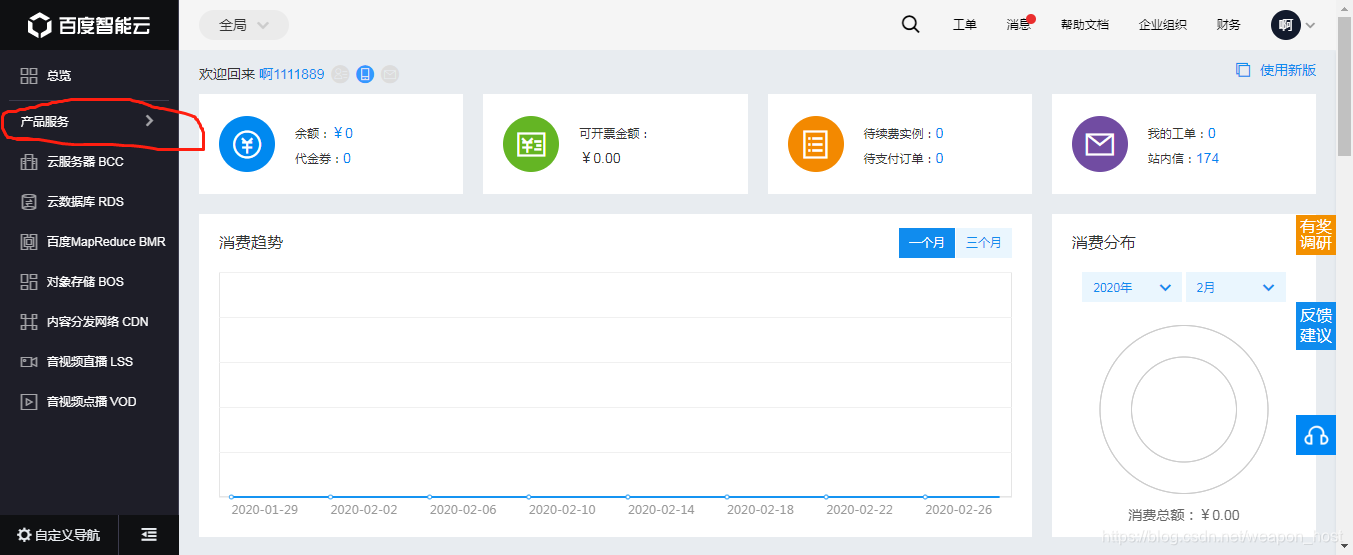
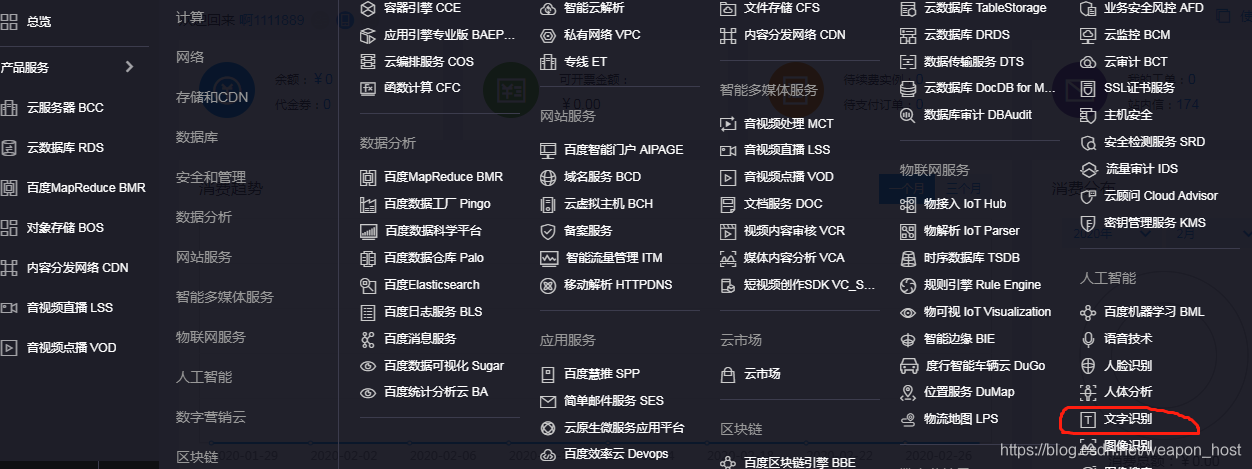
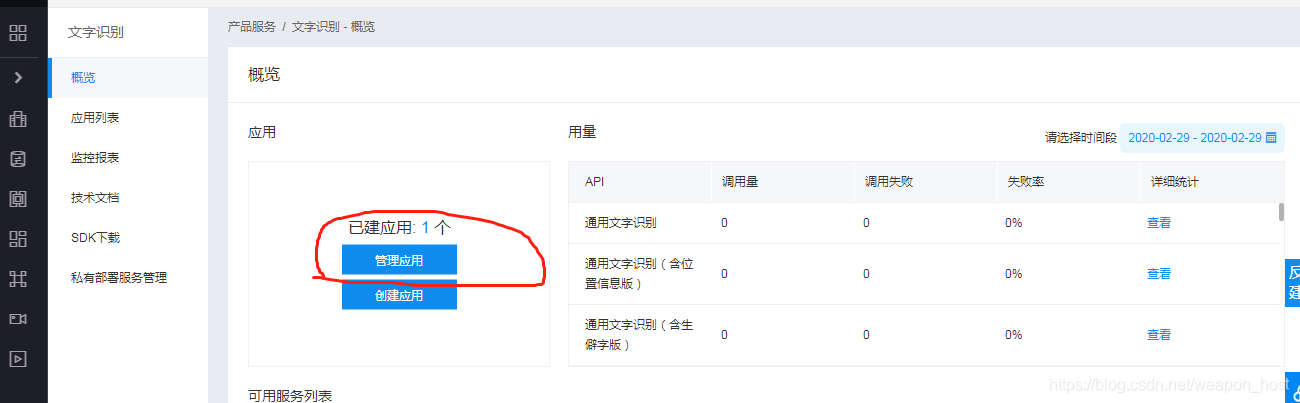
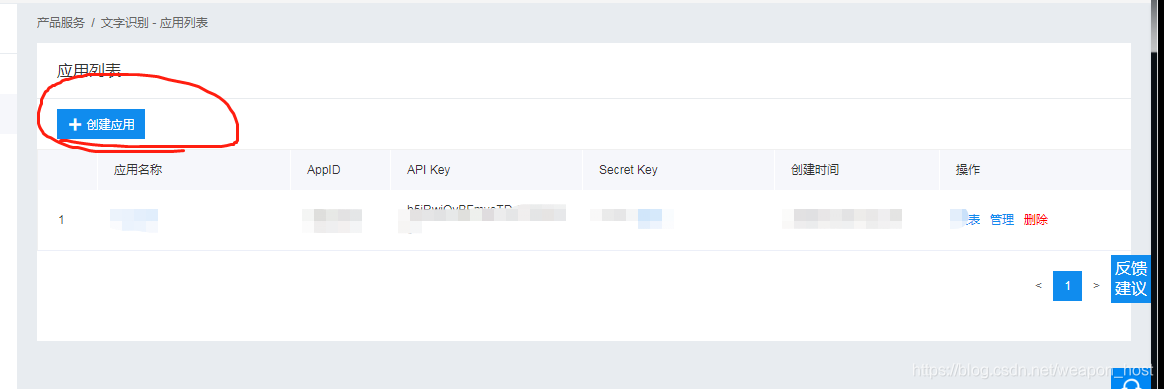
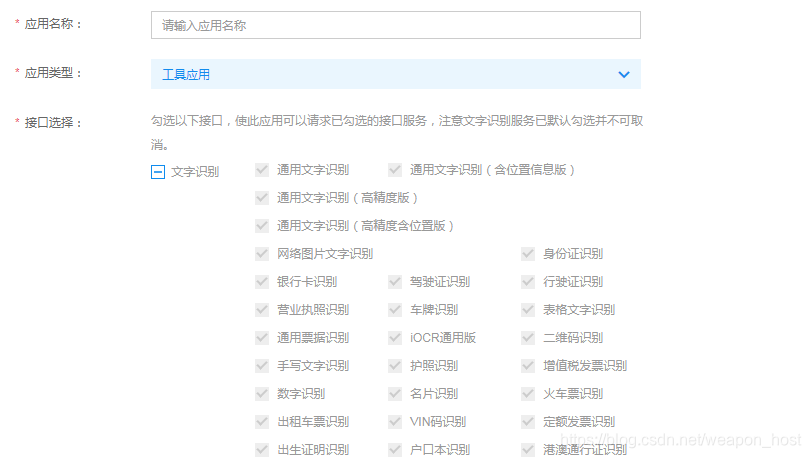
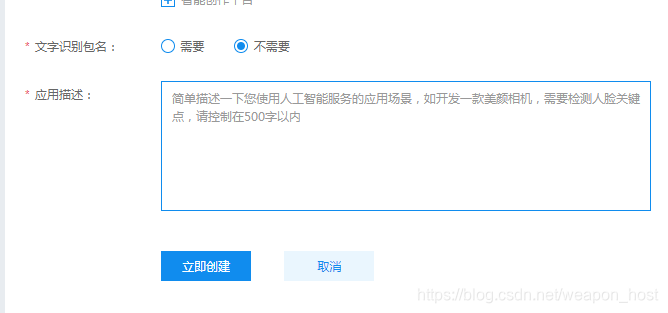
创建完成后会获得一个AppID,APIKey,Secret Key,等下会用到。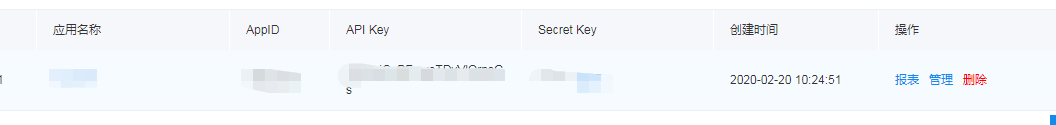
接下来开始编写代码,在这之前,要安装好python3,selenium,baidu-aip(安装自行百度)
我们首先写一个百度OCR的类,第一步,导入我们需要的安装包
from os import path
from aip import AipOcr
类代码:
class BaiduOCR:
    def __init__(self, picfile):
        self.picfile = picfile

    def baiduOCR(self):
        """利用百度api识别文本,并保存提取的文字
        picfile:    图片文件名
        """
        filename = path.basename(self.picfile)
        # 你的AppID,APIKey,Secret Key
        APP_ID = '1852****'
        API_KEY = 'b5jRwiOvBFmyeTD******'
        SECRECT_KEY = '0UYTZDzFCcd2WExctrbHMxM***********'
        client = AipOcr(APP_ID, API_KEY, SECRECT_KEY)

        i = open(self.picfile, 'rb')
        img = i.read()
        print("正在识别图片:\t" + filename)
      	# basicGeneral : 通用文字识别
		# basicAccurate : 通用文字识别(高精度版)
		# general : 通用文字识别(含位置信息版)
		# accurate : 通用文字识别(含位置高精度版)
		# enhancedGeneral : 通用文字识别(含生僻字版)
		# webImage : 网络图片文字识别
		# 还有更多参数可选,具体详情可自查Api文档
        message = client.webImage(img)  # 网络文字识别,每天 50 000 次免费
        # message = client.basicAccurate(img)   # 通用文字高精度识别,每天 800 次免费
        # 打印信息可注释掉,此处是为了调试
        print("识别成功!")
        i.close()
        print(message)
        return message['words_result'][0]['words']
接下来就是登陆网站了
from PIL import Image, ImageEnhance
from selenium import webdriver
from selenium.webdriver.support.wait import WebDriverWait
from lib.baiduOcr import BaiduOCR
import time


def OpenChorme(url):
    chorm_drive = r'E:\python\chromedriver.exe' # 此处是我chormedriver放的位置
    driver = webdriver.Chrome(executable_path=chorm_drive)
    driver.get(url) # url你选择要打开的网址
    return driver


# 显示等待,相关可以百度
# 通过给定的locator定位到相应的标签
def find_element(locator, driver, timeout=10):
    element = WebDriverWait(driver, timeout, 1).until(lambda x: x.find_element(*locator))
    return element


# 打开网址后,通过selenium可截取当前浏览器屏幕,然后通过ps等工具找到
# 验证码所在图中的坐标位置,location参数为验证的坐标位置(x1,y1,x2,y2)
# x1,y1为坐上角的坐标点,x2,y2为右下角的坐标点
def get_code(driver, location):
    path1 = '../Resource/Image/before.png'
    path2 = '../Resource/Image/after.png'
    # 截取当前浏览器屏幕的图片保存在path1中
    driver.save_screenshot(path1)
    # 通过一系列图片处理
    image = Image.open(path1)
    image = image.crop(location)
    image = image.convert('L')
    image = ImageEnhance.Contrast(image)
    image = image.enhance(2.0)
    width = image.size[0]  # 获取宽度
    height = image.size[1]  # 获取高度
    image = image.resize((int(width * 0.5), int(height * 0.5)), Image.ANTIALIAS)
    # 将处理的图片保存在path2中
    image.save(path2)
    # 通过调用OCR的类识别图片中的验证码,并返回该验证码
    verifycode = BaiduOCR(path2).baiduOCR()
    return verifycode


# 登录步骤程序
def Login(driver, uid, pwd, verifycode):
	# 用户名输入框标签的id为username
    locator = ('id', 'username')
    # 调用方法定位用户名输入标签,并输入用户名:uid
    find_element(locator, driver).send_keys(uid)
    # 密码输入框标签的id为pwd
    locator = ('id', 'pwd')
    # 调用方法定位密码输入标签,并输入密码:pwd
    find_element(locator, driver).send_keys(pwd)
    # 验证码输入框标签的id为verifyCode
    locator = ('id', 'verifyCode')
    # 调用方法定位验证码输入标签,并输入验证码:verifyCode
    find_element(locator, driver).send_keys(verifycode)
    # 提交按钮的id为subBtn
    locator = ('id', 'subBtn')
    # 调用方法定位提交按钮标签,并模拟鼠标点击动作
    find_element(locator, driver).click()


# 验证码OCR识别错误重新识别并输入验证码
# OCR有一定概率识别出来错误的验证码,这里没有做别的处理,
# 只是将错误的验证码清除,然后重新输入,在点击提交按钮
def verifycode_fail(driver, location):
	# 调用get_code方法得到验证码
    verifycode = get_code(driver, location)
    driver.implicitly_wait(10)
    locator = ('id', 'verifyCode')
    getcode = find_element(locator, driver)
    getcode.clear()
    getcode.send_keys(verifycode)
    time.sleep(1)
    locator = ('id', 'subBtn')
    find_element(locator, driver).click()


# 登录方法
def Login_succ(driver, uid, pwd, location):
	# 获取验证码
    verifycode = get_code(driver, location)
    # 登录:输入账户,密码,验证码
    Login(driver, uid, pwd, verifycode)
    time.sleep(2)
    # 等待俩秒后,我们获取当前页面的Url,根据当前页面的Url来判断是否登录成功
    url = driver.current_url
    # 在此处,我们登录页面的Url和登录成功的Url是不相同的,因此被我用来作为判断依据
    # 我们还可以用其他的条件来做判断依据,只要登录之前与登录成功的差异点应该都能作为一条依据
    while url != 'http://***.***.***/?r=information':
        # driver.find_element_by_xpath("//*[@id='yw0']").click()
        # 如果点击登录后没有跳转到之后的页面,在账号和密码输入正确的
        # 条件下,那么应该很有可能验证码输入错误,因此调用验证码登录
        # 失败的方法,知道验证码输入正确,此处不一定适用于所有使用者
        # 只提供一种思路
        verifycode_fail(driver, location)
        time.sleep(2)
        url = driver.current_url
        print(url)
    # 当跳转到登录成功的页面后,判断是否存在指定的元素
    # 我们此处是有“欢迎”在页面显示
    if "欢迎:" in driver.find_element_by_xpath("//*[@id='header']/td/span[2]").text:
        return True
    else:
        print(driver.current_url)
        return False


if __name__ == '__main__':
    driver = OpenChorme('http://***.***.***/index.php?r=matche')
    # 此处是用ps算得的验证码在截图中的位置
    local = (656, 346, 765, 385)
    Login_succ(driver,'admin','admin',local)
    time.sleep(5)
    driver.close()

运行程序:


如果验证码比较复杂,可以更改识别算法。
 454


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


