kafka学习总结(处理多个consumer只消费topic数据一次)

Kafka多个消费者监听消费同一个Topic主题 多个消费者监听消费同一个Topic主题一、需求介绍1.图解2.关键注解@kafkaListener二、代码实现1)第一个消费者2)第二个消费者3)生产者三、测试 一、需求介绍 有一个Topic:hw_data 有3个分区 3个副本 组:hw-data-group 将这个主题的消息分发给两个(或者多个)消费者消费,(不能消费相同的消息) 1.图解 2.关键注解@kafkaListener @Target({ ElementType.TYPE, ElementType.METHOD, ElementTyp 阅读详情
kafka学习总结(处理多个consumer只消费topic数据一次)

最近遇到一个问题,由于kafka接收数据进行处理所花费的时间较长,导致kafka队列中有堆积,然后就想开启很多个consumer但是不怎么会用,报了一些错误,通过一天的学习了解,终于可以让多个consumer共同消费topic中的数据了。

写入数据和读取数据

使用3个producer同时对一个topic写入数据,其中使用2个group组来对数据进行读取,其中topic中的partitions定为2。在每个group下又创建2个consumer进行消费数据。

在项目刚开始,我只在topic中设置了一个partitions就是只有一个消费者来消费我传入的数据,但是由于项目的变化,消费的太慢写入的太快,给kafka带来了数据堆积,于是我又加了一个consumer来进行数据的消费,由于刚开始没有给group创建ID使用默认ID,但是发现我每个consumer消费的数据是相同的,并没有达到我的需求。kafka的一条数据会被我的2个consumer同时消费,消费2次,并没有增加效率,而且还给系统带来负担,后台查询官网API发现group中是有ID的,如果没有创建就自动使用默认ID这个一定要注意。其次是一个partition对应一个consumer,如果consumer的数量大于Topic中partition的数量就会有的consumer接不到数据(设置ID不使用默认ID的情况下)。 
为了满足的我业务需求我做了一下调整: 
增加topic中partition中的数量。 
相应增加consumer的数量 consumer的数量<=partition的数量 
这里需要强调的是不同的group组之间不做任何影响,就如同我一个group做python机器学习。另一个做Spark计算,这2个group的数据都是相互不影响的,这也是kafka很好用的东西。 
下面java的代码如下需要对给group添加一个name:

consumer1

public static Properties props;
    static {
        props = new Properties();
        props.put("zookeeper.connect", "node1:2181/kafka");
        props.put("serializer.class", StringEncoder.class.getName());
        props.put("metadata.broker.list", "node1:9092");
        props.put("group.id", "group"); // group组的名字 (做group组区分)
        props.put("group.name", "1"); // 当前group组中的名字
                                        // (在相同的group组中做consumer的qufe)
    }

    public static void main(String[] args) throws InterruptedException {
        String topic = "zhu1";
        ConsumerConnector consumer = Consumer
                .createJavaConsumerConnector(new ConsumerConfig(props));
        Map<String, Integer> topicCountMap = new HashMap<String, Integer>();
        topicCountMap.put(topic, 1); // 取哪一个topic 取几条数据
        Map<String, List<KafkaStream<byte[], byte[]>>> messageStreams = consumer
                .createMessageStreams(topicCountMap);
        final KafkaStream<byte[], byte[]> kafkaStream = messageStreams.get(
                topic).get(0);
        ConsumerIterator<byte[], byte[]> iterator = kafkaStream.iterator();
        while (iterator.hasNext()) {
            String item = new String(iterator.next().message());
            // String msg;
            // try {
            // msg = new String(item.getBytes("gbk"),"utf-8");
            System.out.println("收到消息:" + item);
            Thread.sleep(2000);
            // } catch (UnsupportedEncodingException e) {
            // // TODO Auto-generated catch block
            // e.printStackTrace();
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 16
  • 17
  • 18
  • 19
  • 20
  • 21
  • 22
  • 23
  • 24
  • 25
  • 26
  • 27
  • 28
  • 29
  • 30
  • 31
  • 32

consumer2:

public static Properties props;
    static {
        props = new Properties();
        props.put("zookeeper.connect", "node1:2181/kafka");
        props.put("serializer.class", StringEncoder.class.getName());
        props.put("metadata.broker.list", "node1:9092");
        props.put("group.id", "group"); // group组的名字 (做group组区分)
        props.put("group.name", "2"); // 当前group组中的名字
                                        // (在相同的group组中做consumer的qufe)
    }

    public static void main(String[] args) throws InterruptedException {
        String topic = "zhu1";
        ConsumerConnector consumer = Consumer
                .createJavaConsumerConnector(new ConsumerConfig(props));
        Map<String, Integer> topicCountMap = new HashMap<String, Integer>();
        topicCountMap.put(topic, 1); // 取哪一个topic 取几条数据
        Map<String, List<KafkaStream<byte[], byte[]>>> messageStreams = consumer
                .createMessageStreams(topicCountMap);
        final KafkaStream<byte[], byte[]> kafkaStream = messageStreams.get(
                topic).get(0);
        ConsumerIterator<byte[], byte[]> iterator = kafkaStream.iterator();
        while (iterator.hasNext()) {
            String item = new String(iterator.next().message());
            // String msg;
            // try {
            // msg = new String(item.getBytes("gbk"),"utf-8");
            System.out.println("收到消息:" + item);
            Thread.sleep(2000);
            // } catch (UnsupportedEncodingException e) {
            // // TODO Auto-generated catch block
            // e.printStackTrace();
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 16
  • 17
  • 18
  • 19
  • 20
  • 21
  • 22
  • 23
  • 24
  • 25
  • 26
  • 27
  • 28
  • 29
  • 30
  • 31
  • 32

这里我的producer写入是使用python写的:

    topic = client.topics["zhu1"]
    producer = topic.get_sync_producer()
    count = 0
    print "2"
    while(1):
        producer.produce("test test"+str(count))
        time.sleep(2)
        count+=1
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8

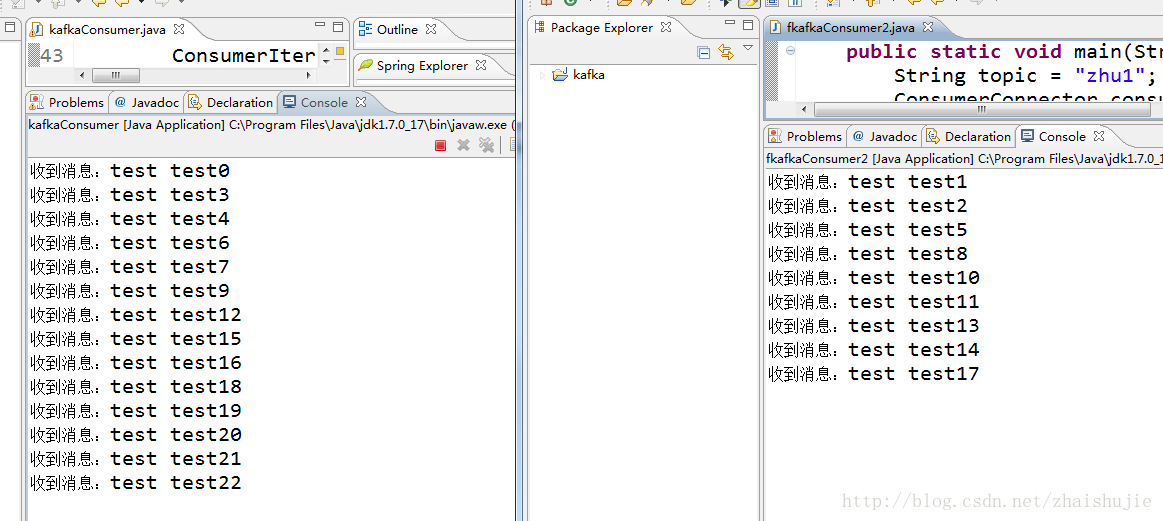
结果如下图所示: 
2个consumer的结果

到了这里已经实现读入kafka多对多的消费了 ,第一次写博客希望对大家有帮助! 
但是在python中出现了一些问题,希望有大神可以解决。 
在python中我是使用pykafka进行kafka调用的我设置好group的id后貌似并没有起作用,2个consumer读到的内容都是相同的内容,但是2个consumer在同一个group中,所以很是纠结。希望后续可以进行解决。

【大数据学习 | kafka】简述kafka的消费者consumer 首先我们要知道kafka这个消息队列主要的功能就是起到缓冲的作用,比如flume采集数据然后交给spark或者flink进行计算分析,但是flume采用的就是消息的push方式,这个方式不能够保证推送的数据消费者端一定会消费完毕,会出现数据的反压问题,这个问题很难解决,所以才出现了消息队列kafka,它可以起到一个缓冲的作用,一个消费者组中的消费者和分区是一一对应的关系,一个分区应该对应一个消费者,但是如果消费者多了,那么有的消费者就没有分区消费,如果消费者少了那么会出现一个消费者消费多个分区的情况。 阅读详情

相关推荐

【Kafka】Kafka Consumer消费模型

一. Kafka简介 上面是Kafka的一个架构图,包括几个部分 Producer: 消息生产者,向Broker发送消息。 Consumer: 消息消费者,从Broker读取消息。 Broker: 处理节点,一个Kafka节点就是一个Broker,多个Broker可以组成一个Kafka集群。 Topic: 主题,Kafka根据Topic对消息进行归类,发布到Kafka集群的每条消息都需要指定一...

藏经阁 | 玄苦 2592

多个消费者订阅一个Kafka的Topic(使用KafkaConsumer和KafkaProducer)

记录:466 场景:一个KafkaProducer在一个Topic发布消息,多个消费者KafkaConsumer订阅Kafka的Topic。每个KafkaConsumer指定一个特定的ConsumerGroup,达到一条消息被多个不同的ConsumerGroup消费。

zhangbeizhen18的博客 1万+

CDH中安装Kafka基本指令总结——topic使用与测试producer产生数据、consumer消费数据

这里主要总结一些我在CDH中安装的kafka测试的一些比较基础的指令。 一、相关基础内容 Kafka群集中的每个主机都运行一个称为代理的服务器,该服务器存储发送到主题的消息并服务于消费者请求。 首先先看服务器安装kafka的实例信息: 注意: 然后正常kafka的指令是 :./bin/kafka-topics.sh --zookeeper cluster2-4:2181 .......

JJBOOM425的博客 3427

KAFKA学习

kafka学习

wanghuahu123的博客 5525

【kafka】Kafka消费者分区分配策略详解

Kafka Consumer用来从Kafka集群拉取数据,通过允许多个进程共同分担消费/处理数据的工作,这些进程可以运行在一台机器或者多台机器。默认常见的消费原理如下Consumer Group (CG):消费者组,由多个consumer组成。形成一个消费者组的条件,是所有消费者的 groupid 相同。消费者组内每个消费者负责消费不同分区的数据,一个分区只能由一个组内消费者消费。消费者组之间互不影响。所有的消费者都属于某个消费者组,即消费者组是逻辑上的一个订阅者。

九师兄 4538

【kafka】Kafka consumer处理大消息数据过大导致消费停止问题

1.概述 转载:https://www.cnblogs.com/wynjauu/articles/9409686.html 昨天线上发现一个现象:kafka一个topic有数据生产,但是没有消费了,各种排查es集群、内存使用情况等都正常,但是就是消费线程死了一样,重启jboss也没有用,最后发现是因为消费该topic的kafka八的partition因为遇到了大数据超过1M而都被堵塞(我们是四台机器每个机器两个partation消费)。 下面是网上看到到一个解释博客: 2.案例分析 处理kafka con.

九师兄 4262

kafka多个consumer只消费topic数据一次

最近遇到一个问题,由于kafka接收数据进行处理所花费的时间较长,导致kafka队列中有堆积,然后就想开启很多个consumer但是不怎么会用,报了一些错误,通过一天的学习了解,终于可以让多个consumer共同消费topic中的数据了 使用3个producer同时对一个topic写入数据,其中使用2个group组来对数据进行读取,其中topic中的partitions定为2。在每个group下又创建2个consumer进行消费数据。 在项目刚开始,我只在topic中设置了一个partitio.

liuyuinsdu的专栏 2507

PX4/ArduPilot源码克隆提速秘籍:国内镜像与子模块优化全攻略

本文详细介绍了PX4/ArduPilot源码克隆的提速秘籍,包括使用国内镜像源和子模块优化技巧。通过阿木实验室、华为云等国内镜像,克隆速度可提升20倍,同时提供子模块替换和并行编译等实用方法,大幅提升开发效率。

weixin_29251567的博客 526

Kafka查看topic、consumer group状态命令

最近工作中遇到需要使用kafka的场景,测试消费程序启动后,要莫名的过几十秒乃至几分钟才能成功获取到到topic的partition和offset,而后开始消费数据,于是学习了一下查看kafka broker里topic和consumer group状态的相关命令,这里记录一下。 命令参考自《Kafka: The Definitive Guide》 Chapter 9 Administratin...

m0_38016951的博客 5万+

Innovus中_clock_gen skew group的隐藏陷阱:如何避免自动分组导致的时序问题

本文深入剖析了在Innovus工具进行时钟树综合(CTS)时,`_clock_gen` skew group自动分组机制可能引发的隐蔽时序问题。文章通过实际案例,解释了该机制如何错误地将分频寄存器与配置寄存器归为一组,从而破坏时钟域边界并导致post-CTS时序违例,并提供了关闭自动提取、手动精确定义skew group等有效解决方案。

gpu4optimizer的博客 269

振动能量采集技术:从原理到实战,破解物联网供电难题

能量采集技术旨在捕获环境中的废弃能量(如机械振动、热能、光能)并将其转化为电能,其核心原理在于通过压电、电磁、静电或摩擦电等物理效应实现能量形式的转换。这项技术的核心价值在于为物联网(IoT)中难以布线或更换电池的分布式传感器节点、植入式医疗设备等提供近乎永续的电力解决方案,从而解决物联网部署的“最后一米供电”瓶颈。其应用场景广泛覆盖工业预测性维护、结构健康监测、可穿戴设备及消费电子等领域。本文聚焦于振动能量采集这一细分方向,深入剖析了压电式、电磁式、电容式及摩擦纳米发电机(TENG)等主流技术路线的实战考

weixin_42660494的博客 569

kafka 分组消费topic_Kafka查看topic、consumer group状态命令

最近工作中遇到需要使用kafka的场景,测试消费程序启动后,要莫名的过几十秒乃至几分钟才能成功获取到到topic的partition和offset,而后开始消费数据,于是学习了一下查看kafka broker里topic和consumer group状态的相关命令,这里记录一下。命令参考自《Kafka: The Definitive Guide》 Chapter 9 Administrating ...

weixin_28366353的博客 3463

一步步指导:在Chrome中安装Vue插件vue-devtools

Vue.js是现代Web开发中最流行的前端框架之一,它以其轻量级、高性能和易于理解的设计理念受到开发者的喜爱。为了更高效地开发和调试Vue应用,Vue.js官方提供了一个强大的开发工具——vue-devtools。

小透明的博客 5621

kafka查看Topic列表及消费状态等常用命令

  本文中的操作均基于kafka_1.3.3.0,且所有命令经过实际验证。 2|0常用工具 新建Topic ./kafka-topics --zookeeper 166.188.xx.xx --create --topic flink_source --partitions 1 --replication-factor 1 replication-factor: 指定副本数量 partitions:指定分区 删除Topic ./kafka-topics --zoo

manong20210713的博客 1万+

【前端】【面试】【业务场景】前端如何获取并生成设备唯一标识

问题:前端如何获取并生成设备唯一标识?核心要点:浏览器原生信息有限,但通过组合多个维度可生成设备指纹(Device Fingerprint),用于唯一标识设备。常见方式浏览器信息(User-Agent)屏幕与系统参数本地存储标识(localStorage / cookie)第三方指纹库(如 FingerprintJS)方式优点缺点手动组合指纹实现简单不稳定,识别率低持久化强容易被用户清除识别率高、稳定性好依赖第三方库IP 地址识别网络识别粗略共享网络环境下重复可能大。

qq_59344127的博客 1797

【OpenClaw企业级智能体实战】第09篇:OpenClaw金融投研实战:17个场景+完整代码,打造专属数字研究员

金融投研面临信息过载、流程重复、数据安全合规三大核心痛点,OpenClaw作为本地部署的新一代AI智能体,凭借“长期记忆+主动执行+数据不出域”的优势,成为券商分析师集体追捧的效率工具。本文基于8家头部券商公开研报,拆解OpenClaw在金融投研的17个核心应用场景(信息处理、研报撰写、量化策略、流程自动化),详解原理、技术选型、实操流程,并提供可直接运行的完整代码与执行结果。文章兼顾新手入门与进阶提升,强调安全隔离部署与幻觉防范,读者可按步骤搭建专属投研智能体,将信息处理、数据整理等重复工作效率提升80%

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 679

kafka只让Producer自动创建Topic同时禁止consumer自动创建Topic

kafka只让Producer自动创建Topic背景操作后记 背景     最近我们要做从mysql 到大数据平台的数据流转,定下的方案是maxwell同步binlog到kafka中,再由flink消费kafka的数据写往kudu里,最后利用kudu和hive利用impala提供的视图作统一查询,其中kudu保留近七天的数据,七天前数据滚动下沉到hive表。     maxwell实例和kafka topic的对应关系是一个ma

CarbonDioxide12138的博客 9520

Vue3 - 实现用户上传本地视频文件到服务器+上传进度条+暂停续传+中断取消上传等,视频上传后可在线播放预览已上传的视频,视频文件上传视频回显示例代码(支持Element、Antd等upload组件

实现视频上传和视频预览,vue3实现视频上传功能,上传视频回显,视频流上传播放功能,vue与axios上传视频并显示上传进度,upload组件实现视频文件上传视频回显,upload组件实现视频上传及进度条展示,视频上传及实时进度条显示,视频上传过程中如何中断上传,VUE3+element 上传视频,大文件分片上传+断点续传,axios大文件切片上传,Vue3上传视频后如何播放预览,上传本地视频到后端服务器及在线预览播放视频+移除视频+进度条上传,将已选视频上传服务端并可预览视频,详细实现选择视频并上传到服务

🏆 前端领域优质创作者 3117

kafka查看topic数据消费情况

1:查询消费数据,必须要指定组。查看kafka组使用以下命令 [root@hadoop01 kafka_2.11-2.1.0]# bin/kafka-consumer-groups.sh --bootstrap-server 127.0.0.1:9092 --list 2:查看消费情况 [root@hadoop01 kafka_2.11-2.1.0]# bin/kafka-consumer-groups.sh --describe --bootstrap-server 127.0.0.1:909..

qq_36730964的博客 1万+

C#串口通信从入门到精通(11)——串口接收的数据存储到本地文件(txt、csv)

本文详细介绍如何将串口通信将数据进行本次存储,主要介绍常用的csv、txt格式文件,由多年实战经验总结,绝对干货!

qq_34059233的博客 7240

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

kafka多个消费者消费一个topic_详细解析kafka之 kafka消费者组与重平衡机制

消费组组(Consumer group)可以说是kafka很有亮点的一个设计。传统的消息引擎处理模型主要有两种,队列模型,和发布-订阅模型。队列模型:早期消息处理引擎就是按照队列模型设计的,所谓队列模型,跟队列数据结构类似,生产者产生消息,就是入队,消费者接收消息就是出队,并删除队列中数据,消息只能被消费一次。但这种模型有一个问题,那就是只能由一个消费者消费,无法直接让多个消费者消费数据。基于这个...

weixin_39737224的博客 1万+

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

多个消费者订阅一个Kafka的Topic(使用@KafkaListener和KafkaTemplate)

记录:465 场景:一个Producer在一个Topic发布消息,多个消费者Consumer订阅Kafka的Topic。每个Consumer指定一个特定的ConsumerGroup,达到一条消息被多个不同的ConsumerGroup消费。

zhangbeizhen18的博客 1万+

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

kafka查看topic中的数据_kafka之消费监控

笔者经常遇到一些无法优化的慢查询,面对这样的慢查询,笔者会将其进行预先计算存储到mongodb或者elasticsearch中。这个业务场景需要将mysql的binlog数据发送到kafka,然后订阅kafka并消费其中的binlog数据以实现实时加速查询。但是消费binlog就可能会有很多意外发生,比如mysql数据库发生死锁,或者消费发生并发问题,网络长时间阻塞,这些状况都会导致kafka消费...

weixin_39939918的博客 1836
上一篇: 记一次kafka消费能力优化
下一篇: Kafka使用进阶——消费者
王树民
博客等级 码龄10年 912粉丝 560原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值