机器学习的概率与统计知识复习总结

计算机保研408与数学复习:构建知识网络与提升问题解决能力 计算机学科专业基础综合(408)涵盖数据结构、计算机组成原理、操作系统和计算机网络四大核心课程,它们是计算机科学的基石,共同构成了理解计算机系统如何工作的知识框架。数据结构研究数据的组织、存储与操作方式,是算法设计的根基;计算机组成原理揭示硬件层的信息表示与处理逻辑;操作系统作为资源管理者,通过进程调度、内存管理等技术实现系统虚拟化;计算机网络则基于分层模型,定义了端到端通信的协议与服务。这些课程并非孤立存在,而是相互关联,例如操作系统的页面置换算法与组成原理的地址转换机制紧密协作,网络层的路由选择依赖于数 阅读详情

机器学习中,很多算法的推导,需要概率和统计的很多知识。学校里学的时候,基本是囫囵吞枣,也忘得差不离了。

现在复习一下,找一些概率与统计这门课的感觉。主要理解下什么是随机变量,与概率的关系,要样本干什么,等等。


1. 什么是古典概率?

有限个可能事件,且每个事件都是等可能概率事件。这个与抽样问题,经常联系起来


2. 什么是几何分布、超几何分布 ?

都是离散概率分布。是抽取问题的一种。

几何分布,是描述的n重伯努利实验成功的概率。前n-1次失败,第n次成功,才叫几何分布。或者说,首次成功的实验 的概率分布。


超几何分布,其实是二项分布的变体,二项分布是同一事件,重复n次的概率分布;而超几何分布,是一个事情只在每个维度上,都做一次。


3. 放回抽样与不放回抽样的概率有什么不同?

其实是相同的。为什么?

放回抽样,很好理解,每次情景相同,概率都相同。

而不放回抽样,每次抽样,都是与前些次的抽样相关的。这其实是一个排列组合问题。有的书采用对称性进行分析,每次事件相互独立,且具有对称性,其基本事件:抽样的序列,仍是排列。

从相关性上,前面的人抽中,与抽不中,对后面都有影响,但是这种影响又相互抵消。除非,前面有人知道如何抽中指定的。这个采用全概率公式,推导比较合理。

如当抽过i-1次后,仍剩下m个红球,n个白球。第i次抽取白球的概率为

n/(m+n).

则第i+1次抽取白球的概率为: 全概率公式:  n/(m+n)  *  (n-1)/(m+n-1)  +  m/(m+n) * n/(m+n-1) = n/(m+n) 递推下去,每次抽取的概率都是相同的。


更进一步,这个问题,可变体为:蒙提霍尔问题,出自美国的电视游戏节目Let's Make a Deal。汽车与山羊,三扇门,选中汽车的概率,在开启一扇门后,有没有变化。

若主持人不知情,则概率无变化。剩余两门:1/2,1/2,无放回抽样类似。

若主持人知情,概率就会发生变化。剩余两门:未开门的概率为2/3,1/3,非概率事件。


4. 什么是随机变量?与概率什么关系?

一个单值实值函数,是一个函数X。而每个具体的实值x,会有一个出现的概率,这个概率能用这个函数(随机变量)能体现。随机变量的概念在机器学习的贝叶斯学习中、模式识别的贝叶斯分类中,是分析的基础。


5. 离散随机变量,常见的有哪些

三种分布

利用排列组合的知识,0-1分布,二项分布/n重伯努利分布 都比较好理解。

而泊松分布 是一种指数分布的形式。基本上是泰勒展开式的形式。为什么会有泊松分布的形式?

它也是一个单峰值函数,n无穷大时,可以近似二项分布。 因为二项分布的计算不如泊松分布方便。

以平均值,就能表征一个群体的特征的分布。n*lambda。围绕中心分布,两边衰减极快。

其主要描述一种稀有事件发生的概率。n很大,p很小。 而且其 期望与方差 都是lambda。 适合描述 单位时间、空间内 随机发生的事情。


-->> 随机变量,从离散型至连续型。离散型的随机变量,比较好理解,而连续型的随机变量,某一点的概率是为0.所以,连续型的随机变量,利用区间来表示。

而连续型的随机变量,即是一个连续型的函数。其用某区间内的概率表示,就比较合适。用区间概率表示的函数,就是随机变量的分布函数F(x)。而区间的概率表示:

P(x1 <x<=x2) = F(x2) - F(x1).

推导出随机变量的概率密度函数 f(x)。


6. 连续型随机变量,如何定义,如何表示?

分布函数:

1)均匀分布、平均分布

2)指数分布

这个分布的形式很重要,它是一般线性回归的分布的主要形式。

对于可靠性分析,排队论中有广泛应用。

3)高斯分布、正态分布

也可以说是指数分布的一种特殊表现形式。拥有对称性,极大值等特性。 噪声的分布经常都是正态分布,在应用中,基本上都假设是这种分布,在大部分的统计中,也确实符合这种分布。

其方差与置信区间的关系,3sigma法则 99.74%

正态分布的线性变换,仍然是正态分布,且性质保持不变。所以,任何随机变量正态分布,都可以转换为标准正态分布,进行求值,查询。分位点的概念,就是随便变量转换为标准正态后的对应的值。


 已知随机变量X的分布,Y与X的关系,推导Y的分布。很重要。

F(Y) = P(Y<y) = P(X < g(y)).即可 


7. 二维随机变量,是推广到高维随机变量的基础。

问题:X,Y相互独立情况下,其概率分布情况?

相互独立的随机变量:性质 F(X, Y) = F(X) * F(Y)

X,Y非独立情况下,X在Y限制下的条件分布?

边缘分布 fy = 积分f(x,y)dx

条件分布 f(x,y) / fy


求证X+Y <=Z 的概率密度函数, 备用系统

将x+y<z的积分, 转换为x =u-y,将积分转换为dy与dx次序无关的积分。


Z=XY, 或Z=X/Y的分布

积分,变换,次序无关,求导


Z=min(x, y)  Z=max(x, y)的分布, 串联、并联系统

max(x,y ) <=z  等同于 x<=z, y<=z

min(x, y) <=z 等同于 1-( max(x, y) > z) = 1-( x>z, y>z)


以上都是随机变量、概率的联系和推导。


8. 随机变量的数字特征,有哪些

转换到随机变量自身的性质。而且随机变量真正的分布是不知道的,只能通过其统计特征来估计其分布。

期望:又称均值。对于连续型随机变量,就是积分了。一阶矩。这个可以用来衡量偏差。E(|X-EX|)

方差:衡量离散的程度。与二阶矩相关。EX^2 - (EX)^2


与期望、方差及概率相关的一个定理:

切比雪夫不等式 P(|x -u| > m) < D(x)/m


协方差,这个概念在机器学习,统计学中跟方差的概念同样重要。因为两个随机变量不可能任何时候都是相互独立的。

不相关是针对线性关系而言,而相互独立是对一般关系而言,包括非线性关系。


矩:随机变量的各阶的数字特征

协方差矩阵:多维随机变量的联合数字特征。一个对称阵。半正定矩阵,对角元素为各随机变量的方差。在PCA中,协方差矩阵是求特征值的首要构成。


9. 大数(高频重复试验)定理与概率的关系。

独立同分布随机变量序列的算术平均值是如何收敛到、接近其期望的。

辛钦定理的描述的概率事件。 小概率事件,一件事重复发生n次。

试验次数很大时,可以用频率代替事件的概率。频率与概率的偏差非常小。


中心极限定理,随机序列足够大时,拟合正态分布,求具体事件发生的概率

1)同分布,同方差,期望。 所有随机变量序列的和(期望、方差和),服从正态分布

2)已知方差,期望。分布不知,所有随机变量的和(期望、方差和),服从正态分布

3)二项分布,n重复大时,重复次数足够大时,二项分布与正态分布相似。可以用正态分布来计算二项分布。

这类问题,先知道基本事件发生的概率,然后求期望,方差,拟合正态分布,再求具体事件发生的概率。


概率论都是研究 概率、随机变量分布,及其关系。但这些都是理论,未与实际应用结合。而且实际的随机变量是不可完全精确测的。

----------------

所以,统计,就是如何估计,拟合这些随机变量的。或者,判断某随机变量与某分布的拟合程度,或关系。

观测,获取样本,由样本进行统计、推断。

而样本除了自身的值,还可以扩展出各种统计量,就由样本值计算的高阶数据:均值、方差、高阶矩。


10. 经验分布函数、真实分布函数 关系

当样本个数足够大时,两者相等。

什么是样本?与总体的关系?

实际应用中总体的随机分布是未知的,一个总体对应一个随机变量,而从总体中抽取一个个体,就是样本,样本就是与总体有相同分布的随机变量。即样本与总体,都是随机变量,而且服从相同分布。样本间是相互独立的。

当测量或观察完成, 样本随机变量就会得到一个实数值,这就是样本值。

反过来,服从同一分布函数,且相互独立的随机变量序列,就是同一总体中的样本。


通过样本值来估计样本和总体的分布,就是统计的事。


抽样分布,又叫统计量分布。当总体的精确的分布函数确定时,其统计量分布(抽样分布)就确定了,然后,统计量的精确分布的求解是很困难的。所以,只能从样本中计算。


常用抽样分布:

1)卡方分布

统计量:来自N(0, 1)的样本的平方和

服从自由度为n的卡方分布。 EX = n, DX = 2n


2)t分布、student分布

卡方分布,自由度为n


3)F分布

与卡方分布相关,自由度n1,n2


当总体分布N(u,DX)已知,则抽样的统计量分布是:

服从正态总体的、样本均值的 分布

N(u, DX/n)

抽样(样本均值、样本方差)与卡方分布的关系


抽样(抽样期望与抽样方差)与t分布的关系


两个正态分布的抽样统计量与 F分布,t分布的关系。


由假设的正态分布的样本,到样本的函数分布,正态样本的统计量的分布函数形式。应该说是重点关注的正态样本的统计量。

一个总体,是一个随机变量

而每个样本,也是一个随机变量,是对总体的一次观察,每个样本的值,是一个实数。

区别:样本、样本值


11. 参数估计:

机器学习中,最基本的推理基础。

估计量的定义: 以样本为自变量的函数/统计量。

因此,常用的估计量有:

1)矩估计量

比较好理解,均值,方差,n阶矩

2)最大似然估计量

概率密度函数f(x; theta), theta是估计量

那么所有样本的联合概率密度函数就是:

f(xi, theta)的连乘。

为什么要构造这个形式?有什么理论依据?

首先,要假设,或已知带参数的分布函数

然后,构造联合概率分布函数,因为每个样本也都是随机变量

最后,求极值。计算出估计量。

极大似然函数,或者对数极大似然函数构造 是关键。 理解样本X是随机变量。

机器学习中,常用的解法是梯度下降法,或牛顿法。


估计量的性质:

1)无偏性、针对期望

无偏估计量:估计量的期望 等于 真实值

如样本方差S^2是总体方差的估计量,而不是二阶中心矩;

除以n-1,而不是n,是因为 样本均值的影响,样本均值也是一个随机变量。

所有样本平方和 减去 样本均值的平方,就是样本方差。而样本均值的方差是总体方差的1/n。


2)有效性:针对方差

比较两个估计量,相同无偏性的性质下,哪个散度小,即D(theta),就选哪个。

3)相合性

样本无穷大,估计量等于真实值。极大似然估计法,满足这个特性。


12. 置信区间

条件:已知总体分布、样本数据

求满足某个概率的区间。 即可以理解为,在这个范围内,达到某种可信度,可信概率。

计算出样本均值,样本方差。然后,由统计量的分布,进行计算置信区间。

常见问题

正态分布:

1)求期望的置信区间

总体方差已知:正态分布

总体方差未知:应用样本方差,t分布 

2)求方差的置信区间

利用样本方差,和卡方分布,进行计算

3)两个总体是正态分布的情况

求期望差的置信区间:

    总体方差已知:正态分布

    总体方差未知:t分布

求方差比的置信区间

    F分布,样本方差


单侧置信区间:

上限或下限,与双侧置信区间相比,需要查不同的表,但是计算方法相同。


13. 假设检验:

线性回归,逻辑回归,一般回归的分析的基础。

解决的问题:

在整个总体分布未知或仅知道形式,但各种参数未知,仅有一些测试的样本数据的场景下,提出某种假设。利用样本,验证假设的合理性。

一个判断的标准,需要一个接受假设的概率。

利用这个概率,去查询对应的分布的区间。

计算样本的统计量,看是否在其分布的接受区间内。


因此,由接收概率,提出接收域,拒绝域。双边检验,单边检验。

相当于,求出置信区间,然后判断统计量,是否在置信区间内。

置信水平 + 显著性检验水平 = 1


再接下来,就能过度到方差分析与回归分析了。

只不过,统计学中的回归分析,在拟合出模型后,还要做假设检验等等。

-----------------------------

1. 什么是先验概率?

事情未发生,只根据以往数据统计,分析事情发生的可能性,即先验概率。


2. 什么是后验概率?与先验概率关系?

事情已发生,已有结果,但求引起这事发生的因素的可能性,有果求因,即后验概率。 后验概率,引起的原因,是测量可能错误。

后验概率的计算,是以先验概率为前提条件的。如果只知道事情结果,而不知道先验概率(没有以往数据统计),是无法计算后验概率的。

后验概率的计算需要应用到贝叶斯公式


3. 贝叶斯公式与先验、后验概率的关系?

全概率公式,总结几种因素,事情发生的概率的并集。由因求果。

贝叶斯公式,事情已经发生,计算引起结果的各因素的概率,由果寻因。同后验概率。


4. 什么是条件概率?

后验概率是一种条件概率。

但条件概率不一定就是后验概率。

如 P(y|x),P(x|y)都是条件概率,二者表示的含义却不同。这里x表示因,y表示果。或者说x是特征,y是模型结果。

则P(y)是先验概率,而P(x|y)是后验概率。

而P(y|x)是一个条件概率,而不是后验概率。
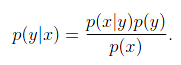
clip_image011[8]

P(xy) = P(x|y)*P(y)

而一般分析问题时,已知的是特征x,需要判别结果y。

这里由推出一个判别模型。

5. 什么是判别模型?

计算判别模型P(y|x)时,需要 先验概率,后验概率作为基础。又称为条件概率模型。


常见的判别模型:线性回归、对数回归/逻辑回归、SVM、boosting、条件随机场、神经网络、最近邻算法Nearest neighbor等。 这些 模型都是通过计算 条件概率的 最大似然估计推导出来。

它是在有限样本的条件下,寻找最优的分类面,关注判别模型的边缘分布。目标函数大部分直接对应 分类准确率。


6. 什么是生成模型?

主要是估计 联合概率分布。如P(x,y) = P(x|y)*P(y)

生成模型 有无限的样本,可以得到其 概率密度模型, 然后可以进行预测了。


常见生成模型: 隐式马尔科夫模型、朴素贝叶斯模型、高斯混合模型、有限波兹曼机等。

因其有无限的样本,可以采用增量的方式学习模型,对于单类问题比判别模型强,信息量比判别模型丰富。主要是对后验概率建模,关注自身,而不关注边界。


由判别模型得不到生成模型,而从生成模型可以得到判别模型。


7. 高斯判别分析 与 逻辑回归的 关系


8. 贝叶斯决策理论的前提

1)各类别的概率分布是已知的,每个类别都有一类相同的特征数据,只不过相同条件下,每个类别概率不同。概率分布,概率密度分布

2)类别的个数是一定的


已知先验概率、和 采集的数据特征(这个因素在每个分类上的后验概率)

就可以对该数据进行分类。原理就是条件概率,贝叶斯决策。

最小错误率的贝叶斯决策与最小风险的贝叶斯决策  的区别和联系?

最小错误率的贝叶斯决策: 结果为 maxP(yi | x)


最小风险的贝叶斯决策:是考虑了各种错误造成不同的损失而提出的一种决策。


http://blog.sciencenet.cn/home.php?mod=space&uid=248173&do=blog&id=227964

http://www.cnblogs.com/jerrylead/archive/2011/03/05/1971903.html

Python学习并考取数据科学相关认证资料! 🏆本文收录于「编程与技术实战」专栏,此专栏涵盖了C/C++编程、人工智能、数据结构、机器学习等技术领域的内容,助你早日登顶实现财富自由🚀;同时,欢迎大家关注&&收藏&&订阅!持续更新中,up!up!up!! 阅读详情

相关推荐

有放回随机抽样

MATLAB程序,有放回随机抽样,实现随机抽样而且是有放回的,每次抽取样本一样。

不放回抽样和放回抽样(抽相同数目的样本)每一个样本被抽中的概率是相等的

比如50个人抽样,第一轮每个概率1/50,第二轮抽时每个没在第一轮被抽到的概率是49/50,然后还有现在被抽到的概率1/49,两个相乘=1/50.因为你并不知道第一轮哪个被抽到,算第二轮是还要考虑第一轮,第三轮(同理) 都是十分之一,有放回和无放回,如果不考虑具体内容,也就是没有任何前提的话,每一个用户被抽中的概率是相等的。 ...

坚持的力量 1万+

应用处理器(AP)、系统级芯片(SoC)与微控制器(MCU)的区别与联系

应用处理器(AP)、系统级芯片(SoC)与微控制器(MCU)的区别与联系

a_zxswer的博客 1687

机器学习 day38(有放回抽样、随机森林算法、XGBoost)

有放回抽样 有放回抽样和无放回抽样的区别:有放回可以确保每轮抽取的结果不一定相同,无放回则每轮抽取的结果都相同 在猫狗的例子中,我们使用”有放回抽样“来抽取10个样本,并组合为一个与原始数据集不同的新数据集,虽然新数据集中可能有重复的样本,也不一定包含原始数据集的所有样本。 随机森林算法 装袋决策树算法(Bagged decision tree)是适用于决策树集合的一种算法,生成决策树集合的过程如下: 对于一个大小为M的原始数据集,进行以下操作: 使用“有放回抽样”,生成一个大小为M的新数据集

丿罗小黑的博客 1656

TypeScript版LangChain环境配置全攻略:从零搭建AI应用开发环境

大语言模型(LLM)作为当前AI应用开发的核心技术,通过API接口为开发者提供了强大的自然语言处理能力。其工作原理基于Transformer架构,通过预训练和微调实现对人类语言的深度理解与生成。在工程实践中,开发者需要将LLM与外部工具、数据源和业务逻辑有效集成,这正是LangChain框架的技术价值所在——它提供了标准化的组件和接口,简化了复杂AI应用的构建流程。应用场景涵盖智能客服、内容生成、数据分析助手等多个领域。本文聚焦于TypeScript/JavaScript生态下的LangChain开发,详细

weixin_29055699的博客 251

XTDrone平台FAST-LIO2与ego-planner结合路径规划部署

之前做了XTDrone平台FAST-LIO2的部署现在将其结合ego-planner进行导航规划,之前查看教程是使用视觉进行定位导航的,现在重新学习。修改advanced_param_xtdrone.xml,这里有视觉信息,不修改会报错显示为输入视觉话题信息。怎么描述 ,感觉当时觉得很难的问题突然就给解决了,一顿复杂,最近勤更新吧,继续开始学习。还有一个想法就是两个rviz结合在一起启动,写了一个demo,融合的不太好感觉额。改为只使用雷达点云,这里仿真的话题是/scan。

m0_56093217的博客 1079

放回抽样与不放回抽样带来的抽样平均误差的差别

不放回抽样的抽样平均误差总是小于放回抽样的抽样平均误差

lwmhtt的博客 3079

工业质检新利器:手把手教你用AD-DINOv3实现零样本缺陷检测(附MVTec AD实战)

本文详细介绍了AD-DINOv3框架在工业质检中的应用,通过零样本异常检测技术解决传统方法的标注成本高和泛化能力弱问题。文章包含技术原理解析、MVTec AD数据集实战部署、模型训练流程及工业部署优化技巧,帮助读者快速掌握这一创新技术。

seed的博客 763

统计学中的Bootstrap方法(有放回的抽样)

Bootstrap又称自展法、自举法、自助法、靴带法 , 是统计学习中一种重采样(Resampling)技术,用来估计标准误差、置信区间和偏差Bootstrap是现代统计学较为流行的一种统计方法,在小样本时效果很好。机器学习中的Bagging,AdaBoost等方法其实都蕴含了Bootstrap的思想,在集成学习的范畴里 Bootstrap直接派生出了Bagging模型.用子样本来类比总体我要统计鱼塘里面的鱼的条数,怎么统计呢?假设鱼塘总共有鱼1000条,我是开了上帝视角的,但是你是不知道里面有多少。

青年有志 1万+

WPF窗口定位技巧:从基础到高级的三种实现方法

本文详细解析WPF窗口定位的三种核心方法:屏幕居中(CenterScreen)、父窗口居中(CenterOwner)和手动定位(Manual)。通过对比其适用场景、实现代码与注意事项,帮助开发者根据实际需求选择最佳方案,从而提升WPF应用程序的用户体验与专业度。

weixin_29224309的博客 272

Cursor赋能Qt C++:从环境配置到项目构建的AI开发新范式

本文详细介绍了如何利用Cursor工具链提升Qt C++开发效率,从智能环境配置到CMake项目构建的全流程实践。通过AI辅助编程、Qt生态优化及高级调试技巧,开发者可快速完成从传统开发到AI驱动的新范式转换,显著缩短项目搭建时间并提升代码质量。

weixin_30329623的博客 546

理解有放回和无放回抽样 (Python)

概率的模型很重要,比如有放回抽样和无放回抽样,这两个模型都拥有很强实用型,绝不能说说就算了,而是用程序如何实现的问题。 本教程将深入探讨有放回和无放回抽样,并涉及这些概念在数据科学中的一些常见应用。与往常一样,本教程中使用的代码可在我的GitHub上找到。让我们开始吧!

gongdiwudu的专栏 2333

FAST-LIVO2 源码精读(十六):接入自定义传感器——多雷达适配与内外参标定

本文是「FAST-LIVO2 激光-惯性-视觉里程计源码精读」专栏第十六篇。上一篇拆解了中每个关键参数的物理含义与调参路径,并反复强调外参RclPcl与时间偏移配错即全局失效;本篇承接这一悬念,回答更前置的工程问题——如何把 FAST-LIVO2 接到一套全新硬件上:新雷达如何通过的类型分支适配、相机内参与畸变模型如何配置、两组外参与时间偏移如何标定出来并填入 YAML,最后给出一份落地检查清单。

PX4-SLAM-PNC 198

mootdx 安装指南:三种 pip 安装方式、依赖分组选择与升级源码安装全解析

本指南以 [docs/setup.md](https://link.gitcode.com/i/3482ede23687e1cc43ab2f17eae27b7f) 为骨架,系统讲解 mootdx 通达信数据读取库的标准安装、`[cli]` 命令行依赖安装、`[all]` 全量扩展安装、版本升级以及源码安装四种方式,并结合作品仓库的 `pyproject.toml`、`requirements.tx

gitblog_00081的博客 630

DeepSeek+Cline:开启自动化编程新纪元

随着 AI 技术不断进步,编程领域迎来效率变革。DeepSeek 与 Cline 的结合,成为自动化编程的强大工具。DeepSeek 凭借先进的自然语言处理能力,能精准理解编程需求;Cline 作为 VSCode 插件,可实现代码生成、调试、注释等功能的无缝衔接。本文详细阐述二者安装配置、实战操作流程,涵盖从基础代码生成到复杂项目开发的应用技巧,同时解答常见问题,帮助开发者快速掌握这对 “智能搭档”,提升编程效率,解锁自动化编程的无限可能。

邓邓子的博客 6254

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

斯坦福CS 229机器学习速查手册:告别公式混乱,一套免费速查手册打通知识体系

很多自学机器学习的同学都有过这样的经历:收藏夹里躺着十几个教程,笔记记了厚厚一沓,可真到用的时候,却连最基本的损失函数都要翻半天。今天要介绍的这份开源资源——斯坦福CS 229机器学习速查手册(stanford-cs-229-machine-learning),正是为解决这类痛点而生:它把整门课程的核心知识浓缩进几页纸,免费开源、多语言支持,帮助每个学习者快速搭建起完整的知识框架。 ## 自学机

gitblog_00009的博客 416

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

机器学习速查表终极攻略:用斯坦福CS 229全套手册快速搭建知识体系

斯坦福CS 229机器学习速查表项目(stanford-cs-229-machine-learning)把整门课程的核心概念浓缩为7份PDF手册,覆盖监督学习、无监督学习、深度学习与数学基础,让你告别笔记散乱,快速完成系统性复习。 --- ## 学了就忘?先治"信息过载"这个病 学过机器学习的你,多半经历过这样的崩溃时刻:课上的公式当时都懂,隔两周再翻开笔记,符号认不全、推导接不上,翻遍十几

gitblog_00928的博客 1252

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

读书笔记:程序员的数学 概率统计

读书笔记:程序员的数学 概率统计特点内容第一、二章 概率定义 多随机变量第三、四章 离散、连续分布第五章 协方差矩阵与多元正态分布第六、七章 估计与检验 伪随机数第八章 各类应用体会 之前读过程序员的数学、程序员的数学线性代数,这次就把程序员的数学:概率统计也看了。配上普林斯顿微积分读本,算是把高数三件套都过了一遍。虽然说也上过一遍概率论,但又只剩下一些零碎的记忆了。这次看一遍这本概率统计,看看能不能捞回来一点。 特点 跟本科上课的教材相比,它的特点和之前写过的这种数学入门书都非常像,就是干货少讲解多。

qq_42340373的博客 827

机器学习概率基础小抄

一篇简单的概率机器学习小抄,机器学习人员手边的小抄。 本场 Chat 首先复习概率和统计的基础知识,然后重点围绕机器学习中常用的重点知识进行详细讲解。内容如下: 概率基础 统计基础 最大似然估计 马尔科夫过程 ...

GitChat 427

学习ML、RL前最好的数学基础回顾

建议按照上述顺序进行复习。引入了概率空间 (Probability spaces) 的概念,包括样本空间 (Sample space) Ω、事件集合 (Set of events) F (必须是 σ-algebra) 和概率测度 (Probability measure) P。最关键的是,理解特征值符号与矩阵定性的关系(这直接关联到凸性),以及 特征值和特征向量与二次型优化 (在单位球上) 的联系。∇x(bTx) = b,∇x(xTAx) = 2Ax (A对称),∇²x(xTAx) = 2A (A对称)。

GCBelly的博客 536

[转]数据挖掘中所需的概率论与数理统计知识、上

原文: http://blog.youkuaiyun.com/v_july_v/article/details/8308762 数据挖掘中所需的概率论与数理统计知识、上 数据挖掘中所需的概率论与数理统计知识、上 (关键词:微积分、概率分布、期望、方差、协方差、数理统计简史、大数定律、中心极限定理、正态分布) 前言 一个月余前,在微博上感慨道,不知日后是否有无机会搞DM,微博...

weixin_30779691的博客 670

从熬夜啃教材到从容翻手册:我把斯坦福CS 229机器学习课程装进了一叠PDF

如果你在自学机器学习,多半绕不开斯坦福 CS 229 这门公开课。而 stanford-cs-229-machine-learning 这个开源项目,把课程里几乎所有核心知识点压缩成十几页一份的 PDF 手册,从监督学习到深度学习,从概率统计到代数微积分,全都在同一个仓库里等着你。这篇文章想聊聊我拿着它复习、查漏、甚至考前突击的真实体验。 ## 那个凌晨还在反复抄公式的自己 我最初接触机器学习

gitblog_00587的博客 594

AI & SLAM 学习过程中的数学基础

最近看《机器人学中的状态估计》和《概率机器人》过程中遇到点公式推导的困难,所以还是把基础打好吧,花1~2个月的时间复习一下数学知识,用博客记录下学习的过程。 数学知识补充: 1、线性代数、矩阵论 教材+哈工大严质彬课程:https://www.bilibili.com/video/BV18s411W758/ 2、概率论与数理统计 教材 3、最优化 4、现代控制工程 算法知识补充: 1、大话数据结构、LeetCode 2、机器学习 西瓜书 南瓜书 李航的统计学习方法 3、花书《深度学习》 李沐《动手学深度学习

Ray Home 335

斯坦福CS 229机器学习速查手册:3步把PDF速查表变成你的随身复习助手

深夜准备机器学习面试,对着厚厚一摞课件翻来覆去,却发现脑子一片空白——这种痛苦我太熟悉了。直到我发现了 **斯坦福CS 229机器学习速查手册**(stanford-cs-229-machine-learning)这个开源项目,它把整门课最核心的知识点压缩成了几张"一页纸"的 PDF 速查表,复习效率直接翻倍。如果你也在为机器学习知识点太多、太散而发愁,这篇文章就是为你准备的。🎯 ## 这份开

gitblog_00057的博客 417

ChatTTS 提示 “Package nemo_text_processing not found!“ 警告怎么办?

在 ChatTTS 中运行推理入口(例如 `python examples/cmd/run.py "Your text 1."` 或 WebUI)时,日志里可能出现这样一条警告: ```text Package nemo_text_processing not found! Run: conda install -c conda-forge pynini=2.1.5 && pip install

gitblog_00097的博客 1171
上一篇: 对线性回归、逻辑回归、各种回归的概念学习
下一篇: hadoop0.23.7伪分布式 安装回顾
viewcode
博客等级 码龄16年 993粉丝 108原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值