Kimi K3 官方价都是 2/20/100 元,为什么有的平台更低?选官方、大云平台还是低价渠道?

AI编程工具计费模式变革:从Token到请求次数的底层逻辑 AI编程工具(如Coding Plan)正经历从按Token计费向按请求次数结算的关键转型。这一变化并非简单的价格调整,而是源于模型推理成本与GPU硬件开销之间长期错配的技术必然——Token无法反映显存占用、KV Cache刷新、模型权重差异等真实算力消耗。随着Qwen3-Coder-Next、GLM-5.1等专用代码模型普及,厂商需更精准映射GPU小时成本,推动计费粒度下沉至任务级。该演进提升了算力利用率,也倒逼开发者优化prompt结构、合并请求、选择适配模型。当前市场已分化为原厂、大云厂商与第三方服 阅读详情

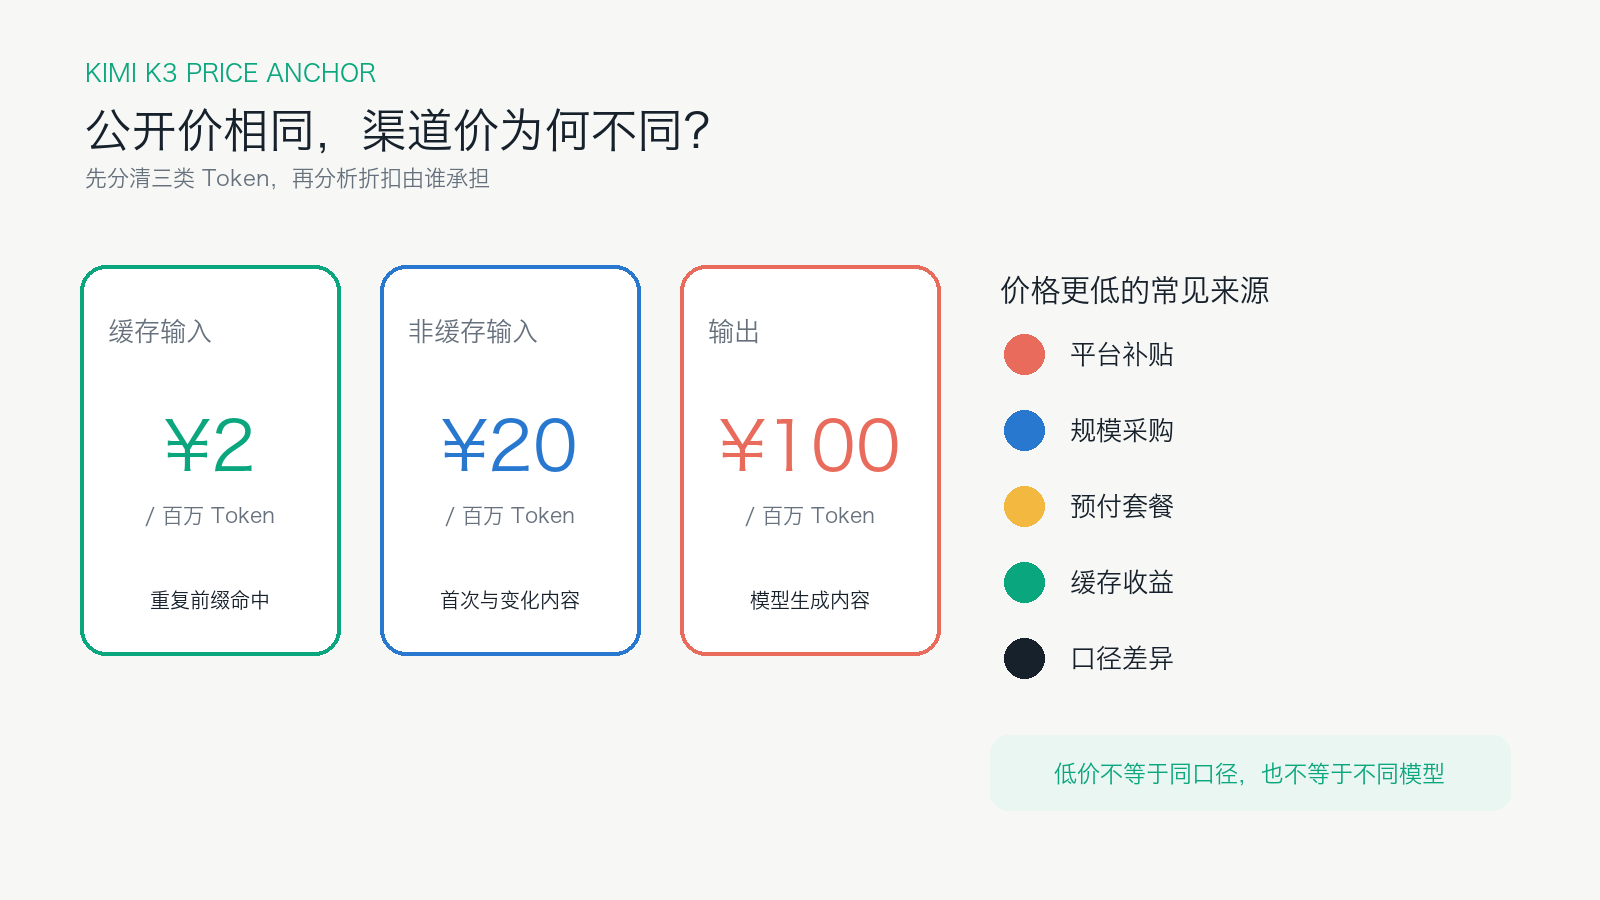
Kimi K3 的公开按量价在 Kimi 官方、阿里云百炼与七牛云模型页采用相同口径:缓存输入 2 元、非缓存输入 20 元、输出 100 元/百万 Token。其他平台报价更低,不一定意味着模型不同,常见原因包括平台补贴、批量采购折扣、套餐预付、资源利用率定价及计费口径不同;但只有模型 ID、上下文、缓存、输出质量、限流、SLA 和账单单位都一致时,两个价格才可直接比较。

在这里插入图片描述

Kimi K3 低价平台,是以低于模型公开按量价的价格提供调用额度的平台。低价可以来自真实商业折扣,也可能来自产品规格或计费单位不同;判断关键不是看单个数字,而是确认“买到的是否为同一项服务”。

先说结论:为什么同一个模型会有两种价格

同一个模型出现不同报价,最常见的原因是渠道承担的成本、促销策略和计费单位不同,而不是模型推理本身突然变便宜。

低价来源价格为什么能下降用户承担的条件
新客或限时补贴平台用营销预算补贴调用成本活动结束后可能恢复原价
批量采购或资源承诺上游按较大用量给予商务折扣需要稳定消耗或预付
套餐折扣先付费购买固定额度未用额度可能到期清零
混合资源调度平台通过多资源池提高利用率峰值延迟与可用性需实测
缓存收益共享重复上下文命中缓存后成本下降只有命中的输入 Token 享受低价
计费口径变化把输入、输出或请求数重新包装名义单价不能直接横比

因此,“比官方便宜”本身既不是风险证明,也不是性价比证明。真正需要解释的是:折扣由谁承担、持续多久,以及服务边界是否改变。

三个平台的 Kimi K3 公开价格为什么一样

三处页面采用相同的按量计费锚点,说明它们在展示层沿用了 Kimi K3 的公开刊例价。

截至 2026 年 8 月 12 日,本文核对到的展示口径为:

计费项Kimi 官方阿里云百炼七牛云
缓存命中输入2 元/百万 Token2 元/百万 Token2 元/百万 Token
缓存未命中输入20 元/百万 Token20 元/百万 Token20 元/百万 Token
输出100 元/百万 Token100 元/百万 Token100 元/百万 Token

Kimi 官方定价页明确说明,1M 等于 1,000,000 Token;缓存命中和未命中输入分别计价。用户提供的截图也显示模型为 moonshotai/kimi-k3,三项人民币价格与官方一致。阿里云百炼价格采用本次选题提供的信息,公开模型目录未展开该模型详情页,发布前宜再保存控制台价格快照。

这里的“价格一样”只表示公开按量单价一致,不代表三家的 Base URL、鉴权、可用区、并发、缓存判定、账单周期和服务支持完全相同。

为什么有的平台能长期低于公开价

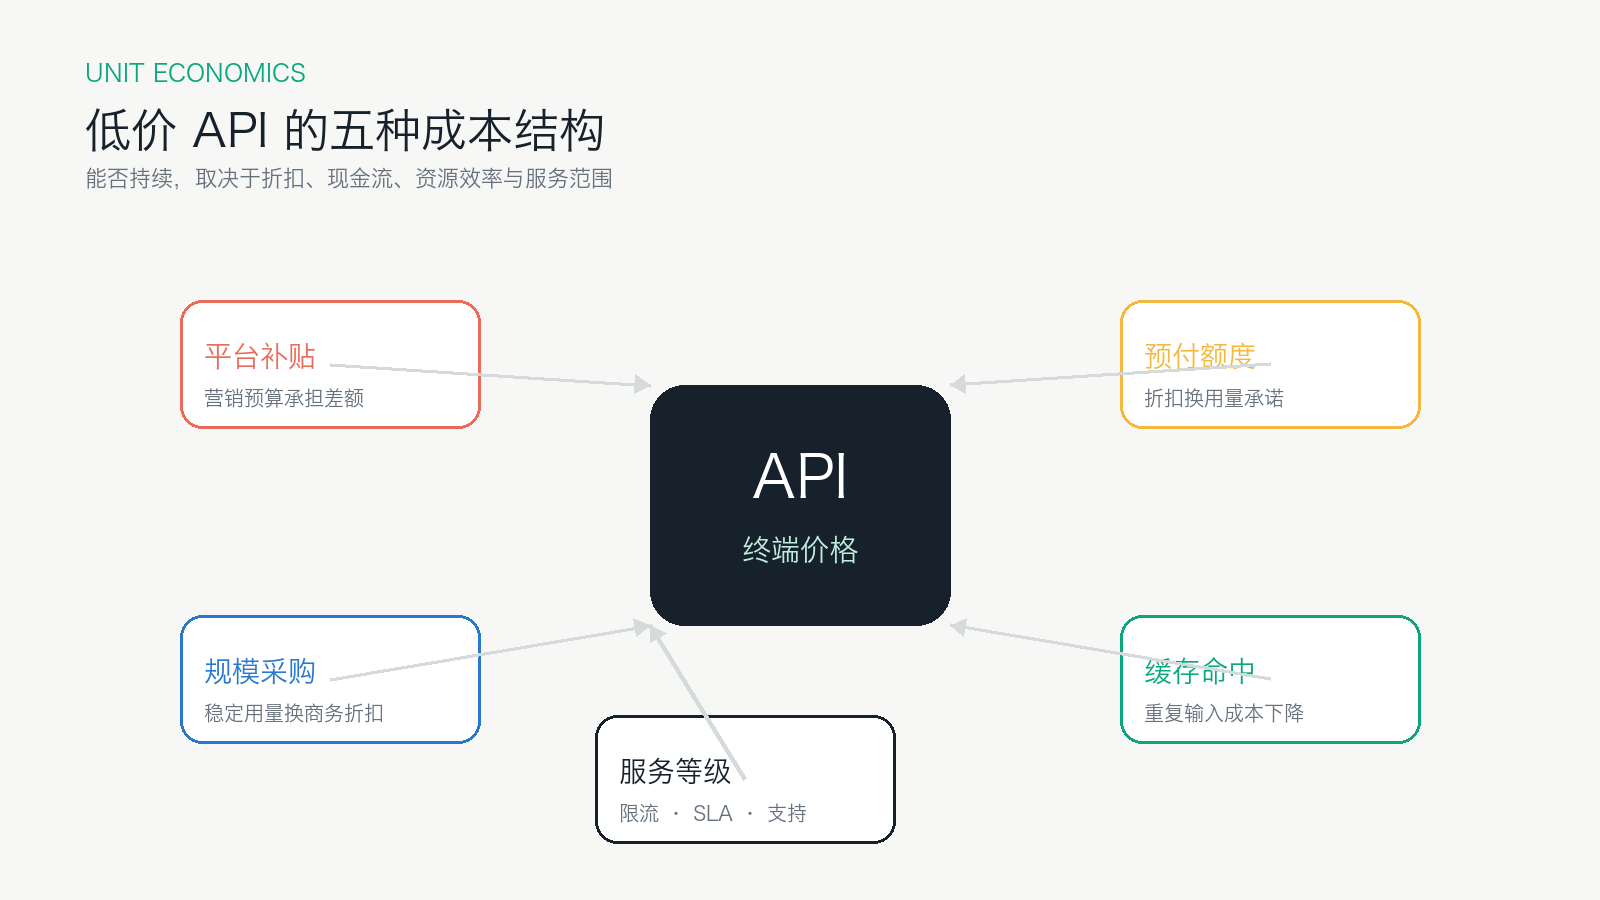
长期低价只有在单位经济模型成立时才可持续,通常需要规模折扣、预付现金流、资源利用率或产品组合中的至少一项支撑。

1. 平台拿到的不是零售价

公开价是用户看到的刊例价,不一定等于大客户或渠道的实际结算价。若平台能承诺稳定用量、提前付款或集中采购,就可能把部分商务折扣让给终端用户。

但商务折扣无法从公开页面反推。没有合同或平台说明时,只能把它视为一种可能机制,不能直接断言某家平台一定获得了上游折扣。

2. 低价只覆盖缓存输入

缓存命中输入为 2 元,非缓存输入为 20 元,两者相差 10 倍。一个平台若突出“最低 2 元/百万 Token”,可能描述的是缓存命中价,而不是所有输入的统一价格。

对于 Coding Agent、长文档问答和固定系统提示词,缓存命中率确实可能较高;但首次请求、新文件、动态工具结果和不断变化的对话历史仍会按非缓存输入计算。

3. 输出 Token 被隐藏在综合单价里

Kimi K3 输出价为 100 元/百万 Token,是非缓存输入价的 5 倍、缓存输入价的 50 倍。如果低价平台只宣传输入价,却未单列输出价,实际账单可能并不低。

Agent 场景尤其要注意输出:规划、代码补丁、工具参数、失败重试和总结都可能产生输出 Token。比较时必须把三类 Token 分别计价。

4. 套餐把折扣换成了使用率风险

预付套餐可以用更低单位价换取现金流和用量承诺,但未消耗额度由用户承担。

例如某套餐按公开价值打 6 折,但用户只用掉额度的 50%,实际有效成本为:

实际有效折扣 = 套餐折扣 / 使用率
              = 60% / 50%
              = 120%

这意味着名义 6 折套餐,因一半额度浪费,实际反而相当于公开价的 1.2 倍。

5. 服务等级不是同一种商品

模型名称相同,不代表 API 服务完全等价。价格差异还可能对应:

  • RPM、TPM、并发数和排队策略不同;
  • 是否承诺 SLA、故障赔付与技术支持;
  • 是否支持企业发票、子账号、审计和用量归属;
  • 上下文上限、最大输出、Tool Calls 或多模态能力是否完整;
  • 数据保留、内容安全和合规条款是否相同。

低价平台若减少了这些成本,报价低于大云平台并不矛盾。
在这里插入图片描述

哪些低价报价不能直接和官方价比较

只要模型规格、计费单位或服务范围有一项不同,就不属于严格同口径比较。

报价写法容易遗漏的条件正确核验方式
“输入仅 X 元”可能只指缓存命中分别询问缓存与非缓存价
“每次请求 X 元”请求长度差异巨大换算为实际输入、输出 Token
“Kimi K3 同款能力”未必是相同模型 ID查看 API 返回的模型标识与文档
“不限量套餐”可能有公平使用或并发限制检查 RPM、TPM、排队和封顶规则
“低至 X 折”可能要求年付或大额预存用实际合同金额和可用额度计算
“统一 Token 单价”可能把输出摊入或限制输出获取完整账单字段与计量规则

尤其不能把开源权重的自托管成本直接等同于官方 API 价格。自托管还要计算 GPU、闲置率、运维、扩容、监控和故障恢复。

如何验证低价平台是不是同一个 Kimi K3

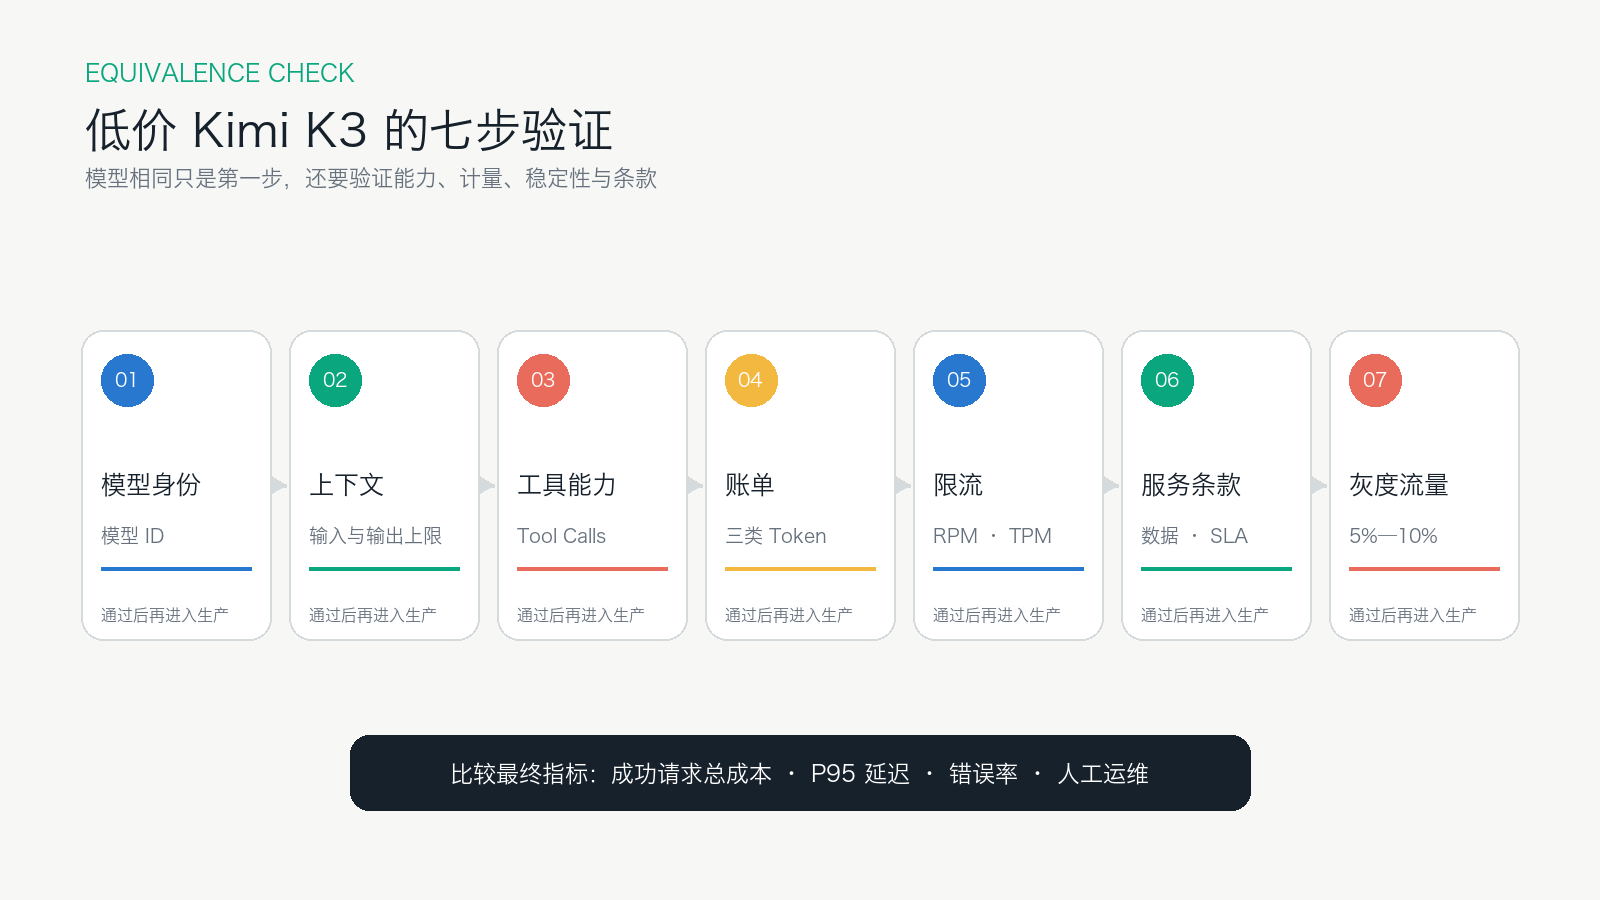
验证低价服务应同时检查身份、能力、计量和稳定性,单次聊天回答无法证明等价。

  1. 核对模型标识:确认文档、请求参数和响应中的模型名称一致,记录测试日期。
  2. 核对上下文与输出上限:用递增长度的可验证样本测试,而不是只看宣传页。
  3. 核对关键能力:分别测试 Tool Calls、结构化输出、视觉输入和长上下文。
  4. 核对三类账单:上传重复与不重复的上下文,确认缓存输入、非缓存输入、输出分别计费。
  5. 核对限流:在约定并发下记录成功率、P50/P95 延迟、429 和 5xx 比例。
  6. 核对服务条款:确认数据保留、日志、退款、模型切换和下线通知规则。
  7. 小额灰度:先让 5% 到 10% 的非关键流量运行一周,再比较质量与总成本。
在这里插入图片描述

怎样计算真实成本

Kimi K3 的真实成本取决于缓存命中率和输出比例,不能用一个“每百万 Token 单价”概括。

按公开价计算:

总费用 = 缓存输入 Token / 1,000,000 × 2 元
       + 非缓存输入 Token / 1,000,000 × 20 元
       + 输出 Token / 1,000,000 × 100 元

假设一个月使用 8000 万缓存输入、2000 万非缓存输入和 1000 万输出:

总费用 = 80 × 2 + 20 × 20 + 10 × 100
       = 1560 元

如果某平台三项价格都打 7 折,且没有额度浪费,费用才可直接按 1092 元估算。若它只对输入打折、输出仍为原价,则应重新分项计算,不能笼统写成“整体 7 折”。

常见问题

Q:低于 Kimi 官方价,就说明不是 Kimi K3 吗?
不能这样判断。补贴、批量采购、预付套餐和资源调度都可能形成真实低价。判断模型是否一致需要核对模型标识、能力、上下文和输出表现,价格只能作为风险筛查信号。

Q:三家公开价相同,应该直接选择 Kimi 官方吗?
不一定。按量单价相同时,还要比较接口兼容性、已有云资源、并发、账单管理、技术支持和故障切换。官方端点路径最直接,大云平台或多模型平台则可能降低企业接入和管理成本。

Q:缓存输入 2 元是不是所有长上下文都按 2 元计费?
不是。只有平台判定命中的重复前缀或上下文部分按缓存价计算。首次请求、发生变化的内容和未命中部分仍按非缓存输入价计算,具体命中规则以平台文档与账单字段为准。

Q:怎样识别不可持续的超低价?
关注折扣期限、充值门槛、退款规则、价格调整权、服务状态页和历史账单。若平台无法说明模型标识、三类 Token 单价、限流与数据条款,即使短期便宜,也不适合直接承载生产流量。

Q:企业选低价平台最重要的指标是什么?
最重要的不是单次请求价格,而是同一验收标准下的成功请求总成本。它应同时包含 Token 费用、失败重试、延迟、人工运维、迁移和不可用损失。

结论

Kimi K3 出现低于公开价的渠道并不反常,真正需要核对的是低价来自商业折扣还是口径差异。根据 Kimi 官方定价页和本文采集的 2026 年价格快照,2/20/100 元是三类 Token 的公开按量锚点,而不是所有渠道必须遵守的最低价格。

Halcon手眼标定实战:从九点标定到机械臂精准抓取(附完整代码) 本文详细介绍了Halcon手眼标定技术在实际工业场景中的应用,重点讲解了九点标定法在机械臂精准抓取中的实现步骤和优化技巧。通过对比Eye-to-Hand和Eye-in-Hand两种模式的特点,提供完整的代码示例和误差分析,帮助工程师快速掌握标定技术,提升自动化系统的精度和稳定性。 阅读详情

相关推荐

2. Netty使用JSerialComm进行串口读取(二)

现在开始处理这些问题 第一个问题:串口读取超时异常一路传播到最后也没有处理。 ​ 第二个问题:即使处理了该异常,程序仍然退出,这不能满足一些实际使用要求需求。该问题与设置很长的读取超时时间没关系,无论多长到时间后总会退出。

s3c2410的博客 2463

Kimi K3 能力确实顶,价格也确实顶:国产模型这次不卷低价了

Kimi K3 发布:2.8T 参数、1M 上下文、Agent Swarm,前端代码榜登顶全球第一,定价却创国产新高。本文拆解它强在哪、贵在哪、值不值得订阅

程序员天天困的博客 454

编译原理考试大题分析【太原理工大学】

看完本篇大题拿 85% 的分应该没问题,TYUT 太原理工大学编译原理期末考试。

m0_52861684的博客 1万+

Kimi K3 API 哪个平台便宜?价格全一样,差距在这三个地方

摘要: Kimi K3 作为月之暗面发布的旗舰大模型(2.8万亿参数,100万token上下文),其API在官方、阿里云百炼、七牛云MaaS等平台定价统一:输出¥100/百万token,非缓存输入¥20,缓存命中输入¥2。实际成本差异取决于缓存命中率、平台限流及免费额度。关键建议: 选平台依据生态需求:阿里云用户优选百炼(低延迟),多模型用户可选七牛云(兼容OpenAI接口)。 成本优化靠缓存:固定前缀请求(如RAG、长文本多轮问答)可降低输入成本90%(¥2/M)。 横向对比:Kimi K3长上下文性价比

vibecoding77的博客 1556

第十一届全国大学生GIS应用技能大赛——广西区域发展布局示意图

我们需要制作一幅广西区域发展布局示意图,最终成图参考“数据”文件夹中的广西区域发展布局示意图.png。地图使用的投影坐标系是 Asia_North_Albers_Equal_Area_Conic,其中地理坐标系是China_Geodetic_Coordinate_System_2000,中央经线东经 105°,标准纬线是北纬 25°和北纬 47°,出图比例尺 1:4,780,000。

@HNUSTer的博客 7802

RV1126 ROS2环境交叉编译及部署(基于官方Docker)

我的所有基于`RV1126`的机器人项目都是在`Ubuntu22.04`下进行开发的,在`Ubuntu18.04 Docker`容器中实现`RV1126`的`SDK`编译,详细可参考我之前的博客[《Ubuntu20.04/22.04下Docker方案实现多平台SDK编译》第2章](https://blog.youkuaiyun.com/w1820020635/article/details/147342689),`RV1126`的`ROS1`部署没什么难度,可以参考我之前的博客,这里记录了`ROS2`交叉编译及问题解决

w1820020635的博客 1143

Kimi开启付费了,你还会陪它一起登月吗?

Kimi开启付费了,你还会陪它一起登月吗?

hunteritself的博客 1万+

如何用IDEA查看jar包中代码

我们在使用Java进行开放时经常会需要下载些第三方的jar包进行相应的开发。有时候相关jar包的使用文档不足,满足不了我们的特定开发使用要求,这就需要我们查看jar包内的相关代码逻辑,本文将基于IDEA工具介绍如何查看相关jar包的代码逻辑

mystonelxj的博客 2287

Kimi K3 定价解构:表观便宜背后,思考 token 与 1M 上下文改写了真实账单

K3 表观 2/20/100 元每 M token,但思考 token 算输出价、1M 不分档、缓存只覆盖编程场景——四天后还暂停了 C 端订阅。本文拆 API 计费层架构,给出可复用算账公式。

qq_42817415的博客 704

AUTOSAE软件配置-项目标准配置 (PSC) 导入达芬奇( DaVinci Configurator)

文件是“可拆分的”,这意味着如果格式符合 AUTOSAR 拆分规则,则可以与其他。)是一个ARXML文件,主要由OEM提供,其中包含。)工件,可以作为输入文件导入到达芬奇配置器专业版。导入的参数将以只读方式处理。不允许在多个 ARXML 文件中导入一个。的已存在数据或从输入文件派生的数据。可以作为输入文件导入到另一个。文件会覆盖用户配置的基本。元素和诊断数据预配置。定义 [数据结构]。中,可以导出一个或多个。

m0_49148264的博客 1019

Unity 之如何使用Pico4u锚点功能实现一个世界锁GameRoot

摘要 空间锚点技术是混合现实(MR)应用的核心,能永久记录虚拟物体的空间位置。文章介绍了在Unity中使用Pico SDK实现空间锚点的完整流程:1)环境配置需安装XR模块和Pico SDK;2)关键操作包括启动空间感知、创建/删除/查询/更新锚点;3)提供了经典应用案例,通过GameRoot节点实现场景固定和锚点同步。源码展示了基于XR交互工具包的锚点抓取与位置更新实现,为MR开发提供了实用参考方案。

TxNet 975

deepseek、glm、kimi价格对比:用TaoToken统一Key实测三家模型调用成本

用同一批请求实测 deepseek、glm、kimi 价格对比:先建 models.json 与 Python 脚本,经 TaoToken 统一 Key 调用三家模型,记录 usage 折算成本并生成 CSV 对照表。含 401、模型不存在等报错排查与按用量估算预算方法。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42581003的博客 77

apple游客下单逆向分析

Apple游客下单Cookies注册激活流程逆向分析与算法实现

吴秋霖的博客 2004

Kimi新套餐上线:价格没变,额度却大变天?199元新旧套餐全网最硬核实测算账与重度编程避坑指南

先说核心结论:价格依然是每月 199 元,但你的“Token 购买力”和“耐用度”逻辑已经彻底重构!** 旧版 199 (Allegretto)**:采用“**每周独立额度 + 5小时滚动频控 + K

Margrop的博客 1484

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

2026 国产旗舰硬核横评|智谱 GLM-5.2 Ultra VS Kimi K3,参数、定价、能力全透明对比,破除网络谣言

Kimi K3 与智谱 GLM-5.2 Ultra 同为国产百万上下文旗舰,定位路线明显分化:Kimi K3 走「一站式图文混合消费路线」,面向个人创作者、前端、产品人群,网页端体验拉满,擅长带图纸、截图的 VibeCoding 与长文档阅读;商用 API 输出定价偏高,不适合无缓存大批量自动化生产。智谱 GLM-5.2 Ultra 走「工程化文本基座路线」,主打后端大型代码项目、企业 API 服务、私有化部署,纯文本场景 API 成本优势巨大;短板是缺少原生图文一体化能力。

十年老程序猿,AI 疯狂研究专家,前沿硬核知识分享 1753

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

2026 大模型 API 定价全景图:DeepSeek、豆包、Qwen、GLM、MiniMax、Kimi、Claude、Gemini、GPT 谁最便宜?

随着大模型竞争进入"成本大战"阶段,本文汇总了国内外主流AI模型的API定价策略。国产模型中,DeepSeek V4系列性价比突出,特别是缓存命中场景下输入成本低至0.02元/百万Tokens;字节豆包采用上下文长度分档计费,适合不同规模应用;阿里通义和智谱GLM在长上下文和企业场景有优势。国际方面,Anthropic Claude的Prompt Cache商业化最成熟,提供多级缓存计费;Google Gemini和OpenAI GPT系列则按不同模型版本和上下文长度差异化定价。整体来看,企业选型需综合考虑

清风徐来 5061

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

深度解读爆火国产大模型Kimi(附教程,建议收藏!)

北京月之暗面科技有限公司(Moonshot AI)成立于2023年4月17日,短短不到1年时间,就做出了这样现象级的产品——可对外商用的Kimi智能助手,令人叹为观止。所以凭什么是月之暗面?

2301_76161259的博客 1万+

deepseek、glm、kimi 价格对比:把三家 API 的 Base URL 改到 TaoToken 后怎么算账

把 deepseek、glm、kimi 的 Base URL 统一改到 TaoToken 后,同一段 prompt 跑三家并记录 usage 字段,就能按输入输出、缓存命中、上下文分档三个维度算账。本文给出可复制的配置片段与 401、local proxy failed 等报错排查,官网见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 。

weixin_42591413的博客 76

49 元的 Kimi 订阅套餐到底值多少钱?用官方 Token 定价反推一笔账

一份 49 元档的 Kimi(k3)订阅到底值多少钱?本文用真实用量统计 + 官方 Token 单价,完整复现「用量 → 单价 → 反推套餐总价值」的计算过程:524 万 Token 已用量约值 22 元,按 13.46% 进度反推整份套餐对应算力市场价约 163 元,并解释 93.5% 缓存命中率如何大幅省钱及提升技巧。

qq_54470008的博客 2506

你的 coding plan 套餐都下架了吧?试试新出的 Kimi K2.6

AI编程套餐变局:Kimi K2.6能否成为新选择? 随着各大云厂商陆续下架低价coding plan套餐,开发者面临新的选择困境。Kimi最新推出的K2.6模型以199元Allegretto套餐进入市场,主打三大核心能力:顶尖编程性能、长程任务执行和多智能体协作。实测显示,K2.6在Terminal-Bench 2.0等基准测试中表现优异,能处理12小时以上的复杂工程任务,并支持4000+次工具调用。相比动辄200元起的其他PRO套餐,Kimi在性价比上具有一定优势,特别是其20倍Kimi Code额度对

不懂先生的博客 4631

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1454

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 434

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 341

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 279

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 283

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 616
上一篇: 大模型 Token 平台哪家靠谱?三类平台风险全拆解,附选型标准
下一篇: 初创团队怎么选大模型平台:5个维度避开3个踩坑,从免费额度到企业订阅的完整路径
vibecoding77
博客等级 码龄139天 12粉丝 79原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值