Hudi cleaning-异步操作

Apache Hudi 0.6.0版本重磅发布 1. 下载信息 源码:Apache Hudi 0.6.0 Source Release (asc, sha512) 二进制Jar包:nexus 2. 迁移指南 如果您从0.5.3以前的版本迁移至0.6.0,请仔细核对每个版本的迁移指南; 0.6.0版本从基于list的rollback策略变更为了基于marker文件的rollback策略,为进行平稳迁移,会在hoodie.properties文件中配置一个新属性hoodie.table.version;无论何时使用Hudi表新版本,如1(从0.6.0以 阅读详情

参数配置

设置参数,在建表的时候指定:

配置型设定值
hoodie.clean.automaticfalse
hoodie.clean.asynctrue
hoodie.cleaner.commits.retained1

建表语句

create table small_file_hudi_cow (
  id int,
  name string,
  age int,
  city STRING,
  date_str STRING
) using hudi
tblproperties (
  type = 'cow',
  primaryKey = 'id',
  preCombineField = 'id',
  'hoodie.clean.automatic' = 'false',
  'hoodie.clean.async' = 'true',
  'hoodie.cleaner.commits.retained' = '1'
)
partitioned by (date_str);

操作执行计划

步骤操作文件系统导入或者更新数据的命令
1insertbase fileINSERT INTO small_file_hudi_cow SELECT id, name, age, city, event_date FROM sample_data_partitioned where event_date='2023-11-03';
1updatebase fileINSERT INTO small_file_hudi_cow SELECT id, name, age, city, event_date FROM sample_data_partitioned where event_date='2023-11-03';

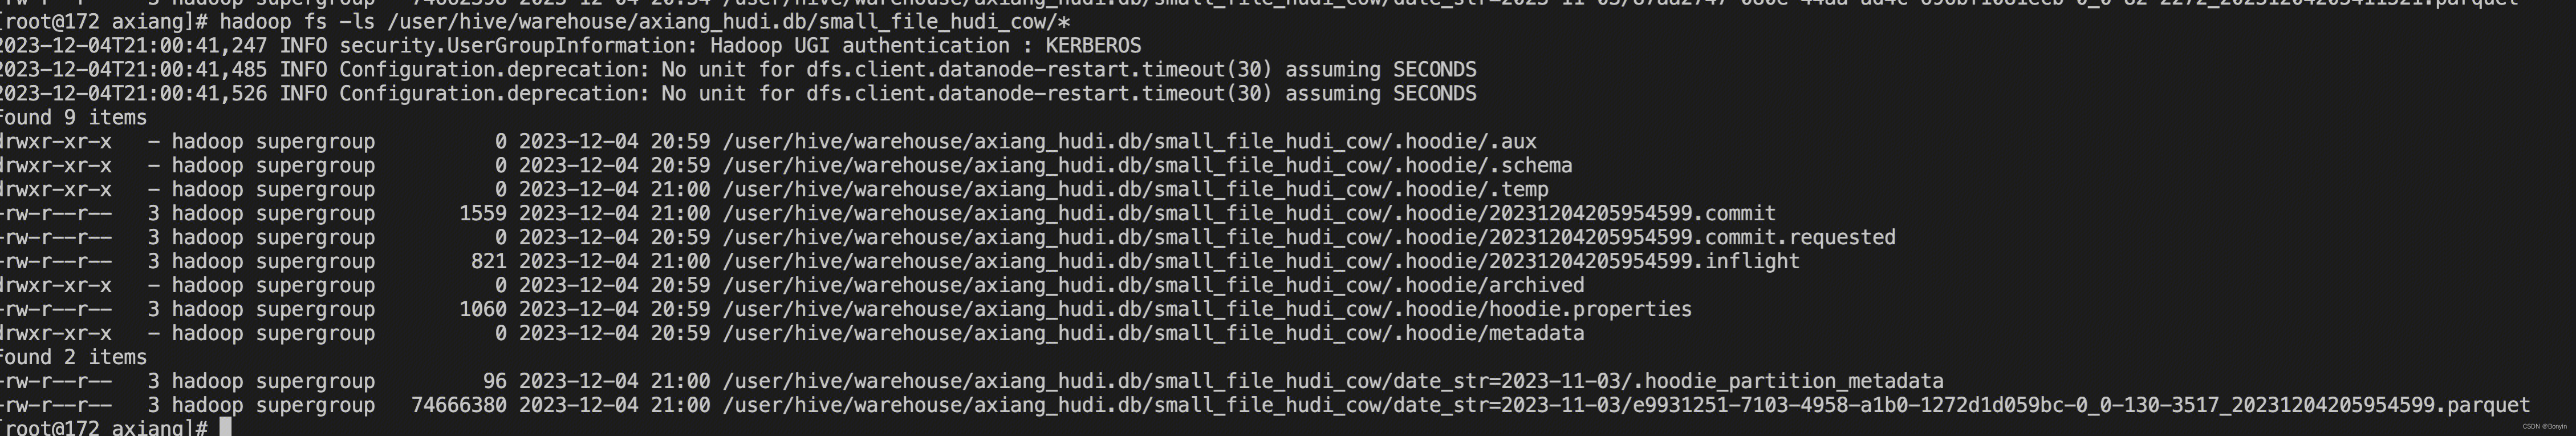
 第一步insert 

在第一次往表里面插入数据的时候,会产生第一个版本文件和时间记录信息,具体如下:
第二步 update数据

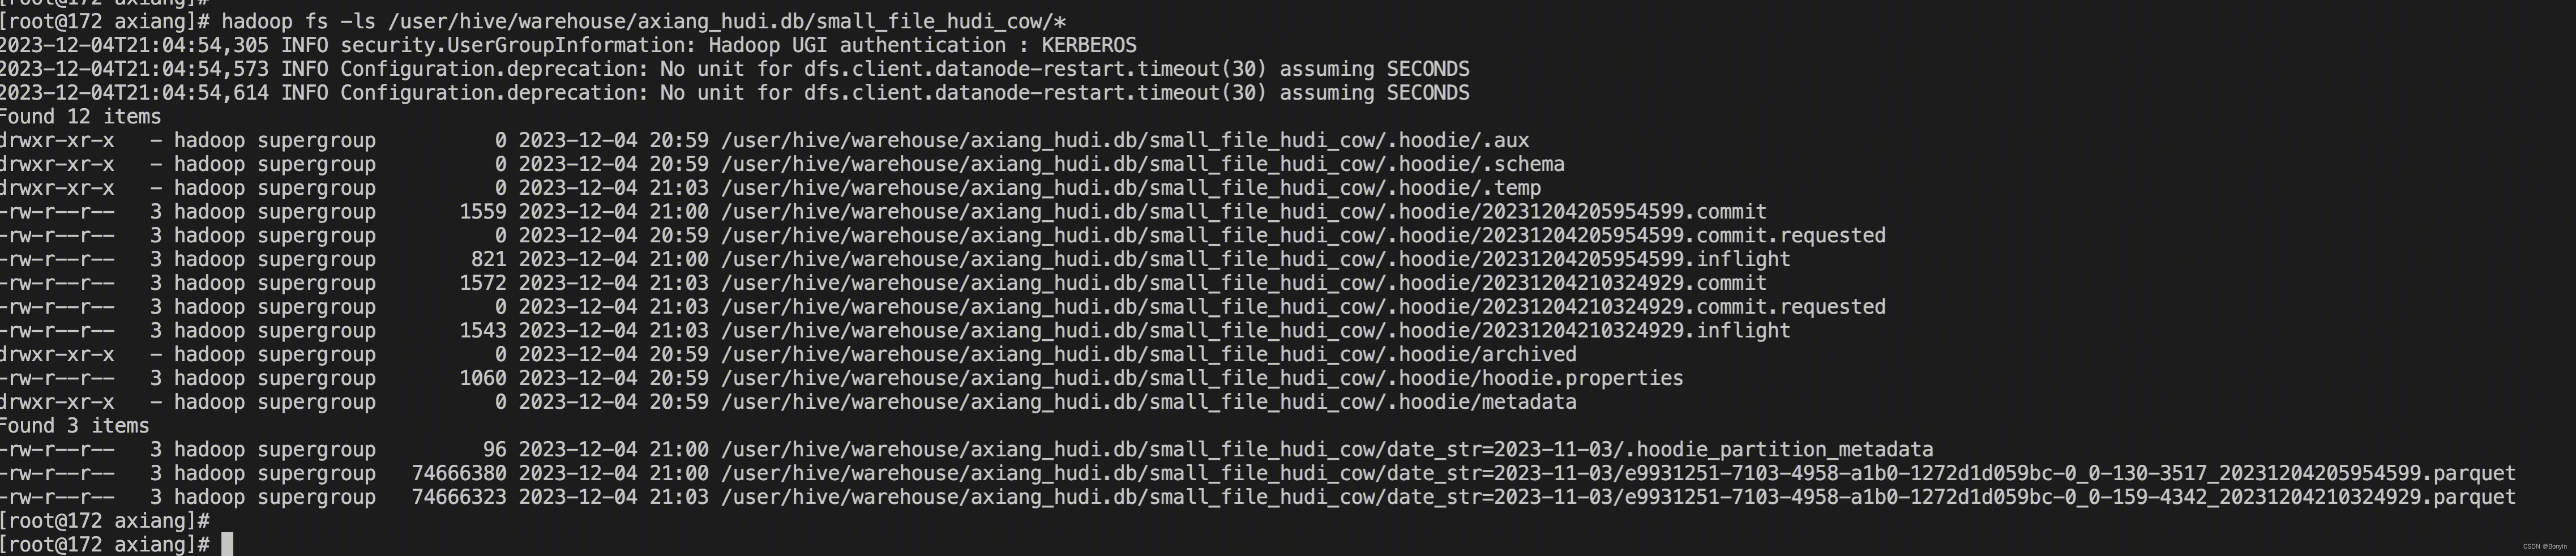
由于数据全量更新第一次的所有数据文件
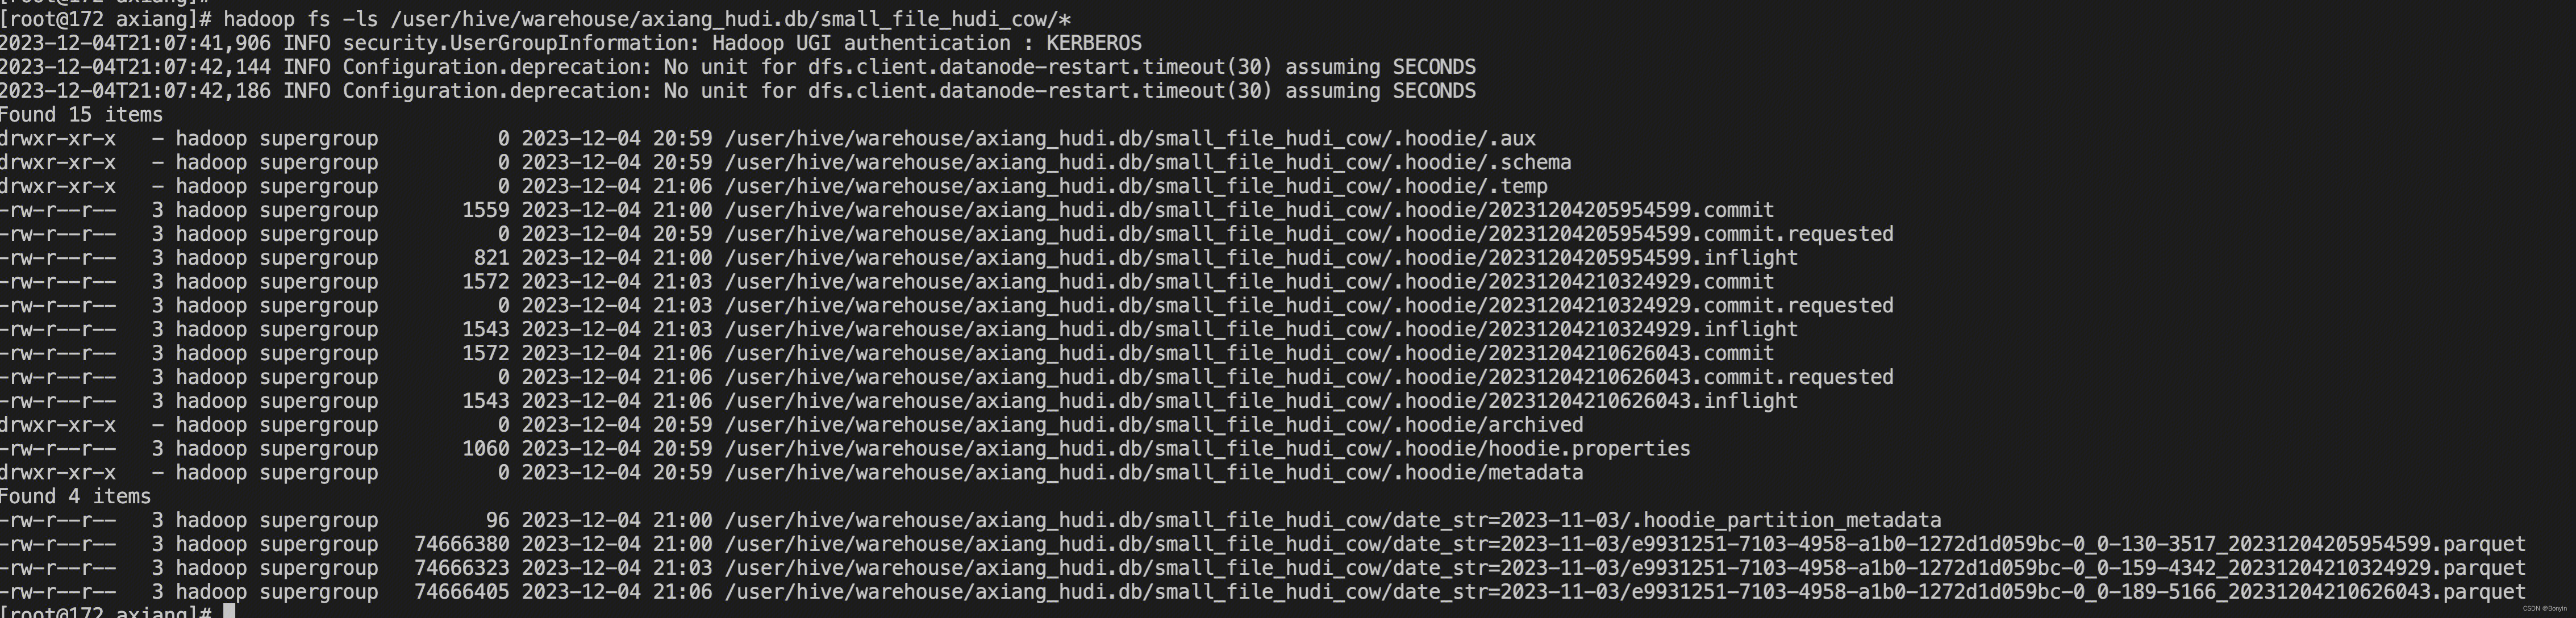
第三步update 

由于全量更新第一次的所有数据文件,更新后添加对应的一组 file 信息。其文件信息及时间线如下:
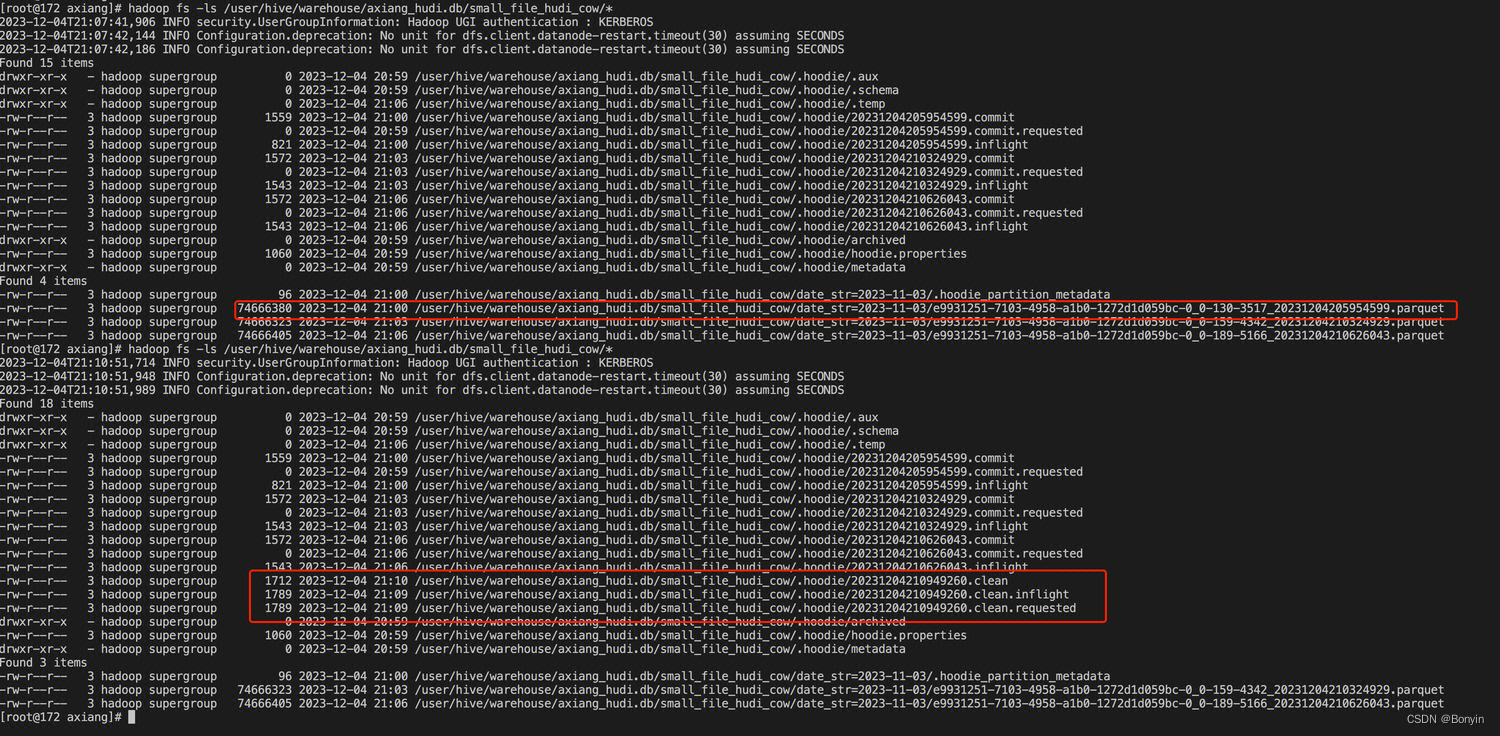
第四步 Cleaning

执行脚本:

spark-submit --class org.apache.hudi.utilities.HoodieCleaner /data/axiang/hudi-0.14.0/hudi-bundle/hudi-utilities-bundle_2.12-0.14.0.jar \
  --target-base-path /user/hive/warehouse/axiang_hudi.db/small_file_hudi_cow/ \
  --hoodie-conf hoodie.cleaner.policy=KEEP_LATEST_COMMITS \
  --hoodie-conf hoodie.cleaner.commits.retained=1 \
  --hoodie-conf hoodie.cleaner.parallelism=200 \
  --hoodie-conf hoodie.clean.async=true \
  --hoodie-conf hoodie.clean.automatic=false

执行完成后,会生成一个clean 的时间线。同时删除历史版本的数据。其文件信息及时间线如下:
hudi系列-设置合理清理策略 在中介绍了清理的大致流程,除了可以防止文件系统的无限膨胀,它是必须的。hudi提供三种查询方式:读优化、快照读、增量读,无论是哪种方式,由于hudi的文件组织是有版本的概念(FileGroup,FileSlice),旧版本的文件持续在执行清理,如果被清理的文件正在读取或者即将被读取到,那岂不是很影响使用,所以我们需要设置合理的清理策略保障上层数据处理任务的平稳运行,提高系统的容错性。可以通过来配置使用以上哪一种清理策略。 阅读详情

相关推荐

【信息科学与工程学】计算机科学与自动化——第二百二十九篇 企业级软件开发所涉及的关键因素03

在实时数据管道中,Flink作业读取Kafka的原始数据,应用脱敏UDF后写入数据湖,脱敏策略存储在ZooKeeper中,通过分布式锁同步变更,确保所有TaskManager使用同一版本策略。:在推荐系统中,使用Feast管理特征,在线特征存储在Redis Cluster,离线特征存储在Hudi,特征更新时通过ZooKeeper锁同步,确保模型推理时特征版本一致。

weixin_49199313的博客 190

Apache Hudi数据湖的Cleaning服务

目录1. 介绍2. Cleaning Retention Policies3. Run Asynchronously4. CLI 1. 介绍 默认是自动进行clean,由参数hoodie.clean.automatic设置,表示在每一次commit的时候就clean file slices。推荐设置为true开启该功能 2. Cleaning Retention Policies KEEP_LATEST_COMMITS: 默认的policy,保留最近N次commit KEEP_LATEST_FILE_VE

Bulut0907 828

【信息科学与工程学】【数据科学】第五十一篇 数据仓库00 基础设计01

数据仓库设计的系统性解决方案,涵盖架构模式、分层设计、百万级访问支撑、海量数据配置及与数据库/数据湖的对接策略: ​​ODS(操作数据层)​​:原始数据镜像,保留历史快照 ​​DWD(明细数据层)​​:清洗、标准化、维度退化 ​​DWS(汇总数据层)​​:主题宽表、轻度聚合 ​​ADS(应用数据层)​​:高度聚合,面向报表/API ​​二、百万用户访问架构设计​​ ​​1. 核心架构组件​​ ​​2. 关键配置参数(以Snowflake为例)​​ ​​3. 性能优化措

weixin_49199313的博客 1202

一文彻底理解 Apache Hudi 的清理服务

Apache Hudi 提供了 MVCC 并发模型,保证写入端和读取端之间快照级别隔离。在本篇博客中我们将介绍如何配置来管理多个文件版本,此外还将讨论用户可使用的清理机制,以了解如何维护所需数量的旧文件版本,以使长时间运行的读取端不会失败。

SmartSi 588

【信息科学与工程学】【通信工程】第一百五十五篇 网络拓扑学09

聚焦云数据中心(多region多AZ+多边缘DC)与城域网5G/6G网络一体化的拓扑学编号类型领域问题问题的数学分析(拓扑学+其他)参数列表及参数的数值范围关联知识A166图论/组合优化云原生数据湖如何用Apache Hudi的Timeline拓扑优化增量查询?​1. 拓扑学分析(详细): - 拓扑结构:Apache Hudi使用Timeline管理表的历史变更,Timeline是一个时间轴上的DAG。每个Instant(提交、 compaction、 cleaning等)是一个节点,节点之间按时间顺

weixin_49199313的博客 221

Hudi Clean Policy 清理策略实现分析

总结Hudi Clean Policy清理策略,从源码层面分析如何实现

主要分享大数据相关的知识,如Spark、Hudi 892

hudi0.13版本clean策略

hudi0.13版本清理策略

努力奔跑的蜗牛 1086

hudi系列-旧文件清理(clean)

hudi采用的是mvcc设计,提供了清理工具cleaner来把旧版本的文件分片删除,默认开启了清理功能,可以防止文件系统的存储空间和文件数量的无限增长。

1032851561的博客 8987

Hudi COW表的数据膨胀(清除历史版本)问题

本文要讨论的是这样一个问题:使用Hudi的COW表时,有一个很明显的现象:当表中有大量的更新数据写入时,落地的parquet文件往往总大小往往要double,每写入一次就会double一次,对于数据体量非常大,且每次都有大量更新的数据来说,不禁会让人担心:这种数据膨胀是否会快速耗尽存储资源?有没有可以克制的方法?其实,这并不是一个问题,而是Hudi表的正常表现,我们先从原理上来看一下产生这个问题背后的原因。 对于Huidi COW表的工作方式,下图有非常清晰的演示: 我们要注意到:Copy-On-Writ

Laurence的技术博客 3113

L298N电机驱动模块的接线使用与代码实现

#include "iostm8s208mb.h" #define u8 uint8_t #define u16 uint16_t #define u32 uint32_t typedef unsigned char uint8_t; typedef unsigned short uint16_t; typedef unsigned long uint32_t; // 关于LED灯的宏定义 #define LED2 PI_ODR_ODR2 //输出量 #define LE

Clichong 13万+

基于matlab版本的三维直流电法反演算法

可以使用RESINVM3D工具包等现成的MATLAB工具进行三维直流电法反演。反演问题求解:基于MATLAB的反演问题求解算法实现和应用,包括反演问题数值模拟、反演问题参数优化和反演问题结果分析。希望这个代码示例能帮助你入门三维直流电法反演。如果有更具体的需求或问题,可以进一步探讨。反演过程中可能需要调整正则化参数和优化算法的设置。需要根据实际问题实现,可能涉及复杂的数值计算。

ytttr873的博客 668

Hudi cleaning

随着用户向表中写入的数据越多,对于每一次的更新,hudi都会产生一个版本的数据文件保存更新后的记录(COPY_ON_WRITE)或者是将这些增量更新的数据文件写入日志文件以避免重写更新版本的数据文件(MERGE-ON_READ)。在这个情况下,随着更新频率的增加,数据版本文件无限增长。当知道在任何给定时间想要保留多少个 MAX 版本的文件时,此策略很有用,为了实现与以前相同的防止长时间运行的查询失败的行为,应该根据数据模式进行计算,或者如果用户只想维护文件的 1 个最新版本,此策略也很有用。

Rocky 1276

实战解析:如何利用MDFEND与Weibo21数据集构建多领域假新闻检测系统

本文实战解析了如何利用MDFEND模型与Weibo21数据集构建多领域假新闻检测系统。文章深入剖析了MDFEND的领域门控与专家混合机制,并提供了从数据预处理、模型理解到训练部署的完整指南,旨在解决通用模型在不同领域新闻检测中的性能衰减问题,提升检测的准确性与适应性。

vulkan6gpu的博客 580

Hudi 异步元数据索引(RFC-45)深入解析:从 INDEXING 动作到 Indexing Catchup 的完整实现

本文围绕 Apache Hudi RFC-45(JIRA HUDI-2488)提出的"异步元数据索引(Asynchronous Metadata Indexing)"机制展开,说明 Hudi 元数据表(Metadata Table,简称 MDT)如何从"单一 files 分区、同步构建"演进为"多分区、异步构建"的设计与实现。文中将梳理 INDEXING 动作的调度与执行、Indexing Cat

gitblog_00806的博客 872

SpringBoot整合JWT实战:从零构建无状态认证系统,详解Token生成、验证与安全最佳实践

JWT在SpringBoot中的实现与应用 摘要:本文介绍了JWT(JSON Web Token)的基本概念、与Session机制的对比,以及SpringBoot项目中JWT的整合实现。JWT由Header、Payload和Signature三部分组成,具有无状态、跨域支持等优势。文章详细展示了如何在SpringBoot项目中配置JWT环境,封装JWT工具类来实现Token的生成、解析和验证功能,包括密钥管理、自定义声明、签名验证等核心操作。通过对比表格和生活化比喻,帮助读者理解JWT与传统Session的

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 1774

Java SSH框架学习

Java SSH框架学习

私信可回答各种问题~ 1789

hudi学习0:目录

《Apache Hudi进阶实战学习指南》摘要: 本指南系统化拆解Hudi技术体系为三大阶段:筑基阶段深入核心原理,涵盖表类型(COW/MOR)、索引机制(布隆/HBase/桶索引)、时间旅行等关键技术;进阶阶段聚焦性能调优,包括写入并行度控制、查询加速技巧及Z-Order等高级数据布局;高阶阶段侧重生产运维,涉及TTL管理、OCC并发控制、存算分离架构设计等。全文通过200+技术要点,帮助开发者从理论到实践掌握数据湖实时更新、增量处理等核心能力,最终实现高吞吐、低延迟的生产级数据湖方案。

hzp666的博客 175

【AI Agent系列】【阿里AgentScope框架】0. 快速上手:AgentScope框架简介与你的第一个AgentScope程序

这是我们学习的第四款智能体框架了。前面我们学习了 AutoGPT、MetaGPT、LangGraph 等智能体应用开发框架,各有优缺点。今天我们开始学习AgentScope这一款多智能体开发框架。卷起来吧,多看看,多用用,没坏处。

同学小张的博客 5425

Mika 手机 AI 助理实测:为什么装完不能马上干活,新手该先准备什么

我让它干的第一件正事,是把招聘网站上三个岗位挨个打招呼发出去。Mika 全程在我手机后台的虚拟屏上自己点、自己填,我在前台刷别的 App 完全没被打断。这件事能办成,靠的不是什么魔法,而是我提前把无线调试、USB 调试、模型权限这几关都过了——它本名叫 Mika,是个住在安卓手机里的 AI 助理,你说人话,它替你操作 App 和网页。 [![Mika 在美团上凑满减点外卖,付款前会先询问](ht

gitblog_01049的博客 188

UI自动化控制PC端微信获取当前群聊的群友列表

在一个月前,某个群友在获取整个群的群友信息时遇到了一点问题: 对整个群进行群友数据获取经测试确实有点棘手,下面我将我的解决过程公布给大家。 基础教程详见: https://blog.youkuaiyun.com/as604049322/article/details/121391639 人工打开要抓取的群聊窗口后,首先获取微信窗口并点击聊天信息按钮: import uiautomation as auto auto.uiautomation.SetGlobalSearchTimeout(1) wechatWind

小小明-代码实体的专栏 3万+

【Bug已解决】Codex CLI 报错 You‘ve hit your usage limit 解决方案

Codex CLI 密集使用时触发 You've hit your usage limit 限流报错,本质是订阅套餐额度机制在正常发挥作用。文中给出等待滚动重置、拆分大任务、主动管理上下文、升级套餐、团队排队机制等完整解决方案。

博客 1万+

BepInEx 插件加载机制解析:一个 DLL 从 plugins 目录到第一行日志的完整链路

你大概见过这种现场:`plugins` 目录里 DLL 整整齐齐,游戏照常进主菜单,`BepInEx/LogOutput.log` 里却是 `0 plugins to load`,没有任何报错。BepInEx 是 Unity Mono、IL2CPP 与 .NET 游戏的插件加载框架,这篇文章要回答的就是那个核心问题:你放进目录的插件 DLL,到底有没有被读进来?如果没被加载,它死在哪一道关? [

gitblog_00742的博客 513

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Apache Hudi 1.X 愿景解读:RFC-69 如何将数据湖重塑为事务型数据库

RFC-69(Hudi 1.X)是 Apache Hudi 社区在 1.0 版本发布前夕提出的核心愿景文档,它不再把 Hudi 仅仅看作一个"开源的存储格式",而是明确提出将 Hudi 重构为面向数据湖的**事务型数据库(Transactional Database for the Lake)**。本文以 [rfc/rfc-69/rfc-69.md](https://link.gitcode.co

gitblog_00545的博客 466

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

ApacheHudi使用问题汇总(二)

1. Hudi Cleaner是做什么的? Hudi Cleaner(清理程序)通常在 commit和 deltacommit之后立即运行,删除不再需要的旧文件。如果在使用增量拉取功能,请确保配置了清理项来保留足够数量的commit(提交),以便可以回退,另一个考虑因素是为长时间运行的作业提供足够的时间来完成运行。否则,Cleaner可能会删除该作业正在读取或可能被其读取的文件,并...

风中云彩的博客 3226

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

40亿参数改写端侧AI格局:Qwen3-VL-4B视觉大模型开源评测

# 40亿参数改写端侧AI格局:Qwen3-VL-4B视觉大模型开源评测 ## 导语 阿里通义千问团队发布Qwen3-VL-4B视觉语言模型,以40亿参数实现"小而全"的多模态能力,可在16GB内存设备流畅运行,重新定义轻量化AI的技术边界。 ## 行业现状:多模态模型的"效率革命" 2025年,大语言模型领域正经历从"参数军备竞赛"向"效率革命"的关键转折。据行业分析,当前多模态模型市场呈现...

gitblog_00132的博客 1311
上一篇: Hudi cleaning
下一篇: JVM参数说明
Bonyin
博客等级 码龄10年 166粉丝 137原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值