回归(二):缩减系数

特征缩减技术(shrinkage): lasso和岭回归 1、概述通过对损失函数(即优化目标)加入惩罚项,使得训练求解参数过程中会考虑到系数的大小,通过设置缩减系数(惩罚系数),会使得影响较小的特征的系数衰减到0,只保留重要的特征。常用的缩减系数方法有lasso(L1正则化),岭回归(L2正则化)。 关于L1,L2正则化讲解:http://blog.youkuaiyun.com/wsj998689aa/article/details/395477712、正则化的目的 阅读详情

回归算法中不管是用线性回归找到最佳拟合直线,还是加权的线性回归算法,我们都是直接用矩阵相乘的方式,直接计算出对应的ω系数,这都是对应训练数据组成的矩阵是可逆的,换句话说X矩阵是满秩的,而对于某些属性个数多余样本个数的样本(样本数据组成矩阵后列数多于行数)组成的矩阵是不满秩,计算(XTX)-1的时候是会出错的。所以为了解决这个问题统计学家们引入了领回归(ridge regression)的概念。

  1. 岭回归

岭回归就是在矩阵XTX上加了一个λI,从而使得矩阵非奇异,进而能够对XTX+λI求逆。其中I是一个m×m的单位矩阵,而λ是用户自定义的一个数值。在这种情况下,回归系数的计算公式变成如下公式:

至于为什么叫岭回归,书上是这么说的,供参考:岭回归使用了单位矩阵乘以常量λ,我们观察其中的单位矩阵I,可以看到值1贯穿整个对角线,其余元素全是0。形象地,在0构成的平面上有一条1组成的“岭”,这就是岭回归中的“岭”的由来。

文章前面说了,岭回归的引入是为了解决特征数目多于样本数的情况,但是并不是说特征数目少于样本数就不能用岭回归的方式了,只不过是我们需要从另外一个方面去理解岭回归的概念:

岭回归现在也用于在估计中加入偏差,从而得到更好的估计。这里通过引入λ来限制了所有w的和,通过引入改惩罚项,能够减少不重要的参数,这个基数在统计学中也叫作缩减(这句话是书上的原话,其实我是保持怀疑的,至于为什么,到后面和lasso做下对比就知道了)。

接着引入惩罚项的说:我们先把上面岭回归系数的计算公式还原,从最初的公式看起:
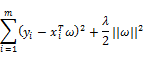
上面公式求导,等0,就可以得到我们前面说的岭回归的回归系数计算公式。但是我们这里只看这个最初的公式,相当于在原有的的平方误差的基础上加入了一项,此项是对ω的约束;正规一点的说法是引入了正则项其中的||ω||2是向量ω的L2范式;ω的L2范式也可以看做是当前模型的复杂度。其实这个引入正则化及其系数,和决策树中引入树的复杂度及其系数的做法是相似的,也是可以防止模型过拟合。

在岭回归中,会有公式: ,即限定了所有回归系数的平方和不能大于λ(λ是一个常数)。在使用普通的最小二乘法回归在当两个或更多的特征相关时,可能会得出一个很大的正系数和一个很大的负系数。正式因为上述限制条件的存在,使岭回归可以避免这个问题。

  1. lasso

lasso和岭回归类似,也是对回归系数做了限定,对应的约束条件限制为: ,和岭回归不同的是,这个约束条件用绝对值取代了平方和,专业一点的说法叫L1范式。虽然约束形式只是做了稍作变化,但是结果却大相径庭:在λ足够小的时候,一些系数会因此被迫缩减到0,这个特性可以帮助我们更好的理解数据。但是这个变化却极大的加大了计算的复杂度,因为|ω|是不可导的。

上面我们提到了有些系数会被缩减到0,如果系数是0,那么该项对应的参数值与0相乘也是零,就是对应的特征不起作用,从而可以忽略这个特征,也就是缩减系数;而岭回归中虽然也有可能缩减系数,但是程度远远没有lasso的程度大,所以lasso也可以用来特征选择。

不管是lasso和岭回归,都是对系数做了限制,使其不断缩小。我们知道系数小的模型复杂度就小,因为某一特征值的变化,不会使结果有大的变化,如果系数大的话,某一特征值对结果的影响就比较大了。

其实岭回归和lasso在回归模型中是比较重要的概念,此篇文章的上面只是提到了两者的一些性质以及用法,也并没有十分详细的说。如果想进一步了解,可以网上搜L2和L1正则化,有大神讲的更好,不过我也在另一篇文章《L1和L2正则化》中做了自己简单的总结。

  1. 前向逐步回归

前向逐步回归算法可以得到和lasso差不多的效果,但更简单,没有涉及太多的数学理论,也相对容易理解。它是一种贪心算法(所谓的贪心算法,简单说,就是在详细的每一步得到最优的结果),即每一步都尽可能的减少误差,所以一开始所有特征的权重都设为1,然后每一步所做的决策是对某个权重增加或者减少一个很小的值。这里感觉就和梯度下降法有点像了。

首先需要对数据进行标准化,标准化数据的目的是将原来的数据映射到特定的区间。否则的话不同的特征可能有不同的尺度标准,不同权重的下降速度也不一样,并且不同的特征的数值如果数量级相差太大的话,就会在机器学习的结果中占据主要的地位,所以将所有的特征值放到一个区间,增加了可比性,也增加了学习的准确性。

下面写出具体步骤

  1. 设定迭代的次数
  2. 设定当前的损失值为最大正无穷
  3. 循环每个特征值的权重ωi,对其增加或者减少,并计算当前权重下的损失;如果当前权重下的损失小于上一个损失,那么更新当前特征值的权重为ωik,并且更新当前损失值,否则不予更新。
  4. 每次迭代都要重新循环计算比较所有的权重值,直到达到相应的循环迭代次数

ωi是第i个特征的权重,ωik是在不断的迭代过程中的权重中间值。我们之间假设过,将所有的权重都设为1,那么ωik在每次循环中就可能是[-1,1]区间中梯度为0.02的一系列值。



线性回归计算回归系数 """ 线性回归: 优点:结果易于理解,计算上不复杂 缺点:对非线性的数据拟合不好 适用数据类型:数值型和标称型数据 标称型数据:一般在有限的数据中取,而且只存在“是”和“否”两种不同的结果(一般用于分类) 数值型数据:可以在无线的数据中取,而且数值比较具体化,例如4.02, 6.23这种值(一般用于回归分析) 回归的一般方法: 1收集数据:采用任... 阅读详情

相关推荐

【机器学习实战-python3】缩减系数来“理解”数据

遇到数据特征比样本点还多的情况,不再能使用线性回归的方法,因为计算逆矩阵的时候会出错。 引入岭回归来解决特征数大于样本点个数的情况 一、岭回归 岭回归就是在矩阵XTXX^{T}X中加入λI\lambda I来使矩阵非奇异,今儿能够计算其逆矩阵。矩阵I是一个m维的单位矩阵,对角线元素全为1,λ\lambda是用户定义的一个数值,因此回归系数计算公式为:w=(XTX+λI)−1XTyw=(X^{T

修行的猫ZQ 2163

回归中的缩减法

作用 通过引入惩罚项,能够减少不重要的参数。通过比较经过不同程度缩减得到的系数,我们可以看出特征的重要程度(系数越大,对结果影响越大),从而更好地理解数据,有助于模型的改进。 方法 岭回归:线性回归时,如果特征比样本点还多(n>m),此时输入矩阵X将不是满秩矩阵,则无法求逆,最小二乘法(Ordinary Least Squares)将无法求解: 此时引入一个单位矩阵 λI ,从而使矩阵非...

qq_43243022的博客 1652

三菱FX3U PLC红绿灯ST编程实战:从基础逻辑到急停功能完整实现

本文以十字路口红绿灯控制为例,详细讲解了三菱FX3U PLC使用ST编程的完整实战过程。内容涵盖从基础时序逻辑、状态机设计,到急停功能、黄灯闪烁、昼夜模式切换等高级功能的实现,并提供了代码优化与调试技巧,帮助工程师掌握结构化文本在工业控制中的清晰、结构化应用。

weixin_29070861的博客 533

《机器学习实战》8.3 线性回归之缩减系数来'理解'数据

《机器学习实战》8.3 线性回归之缩减系数来’理解’数据 搜索微信公众号:‘AI-ming3526’或者’计算机视觉这件小事’ 获取更多人工智能、机器学习干货 csdn:https://blog.youkuaiyun.com/baidu_31657889/ github:https://github.com/aimi-cn/AILearners 本文出现的所有代码,均可在github上下载,不妨来个Sta...

小明的博客 1294

DeepSeek-OCR又更新:一起看下OCR1和OCR2

DeepSeek-AI 最近又又开源了,这次是DeepSeek-OCR2,结合之前发布的DeepSeek-OCR ,可以发现DeepSeek走出了一条不同于主流 OCR 方案的技术路线。第一代模型探索了**“视觉作为文本压缩介质”的可行性,打破了传统的序列长度限制;第二代模型则通过“Visual Causal Flow(视觉因果流)”**架构,将因果推理引入视觉编码器,解决了复杂排版下的阅读顺序难题。本文将从架构设计、逻辑结构、训练范式及工程实现四个维度,深度剖析这两代模型的异同与创新。

kakaZhui的博客 622

时间同步中 TOD 与GPRMC和IRIG-B的区别

时间同步中 TOD 与GPRMC和IRIG-B的区别

ftdlk的博客 1725

线性回归的缩减方法,岭回归以及逐步线性回归

线性回归的缩减方法是用于处理多重共线性(multicollinearity)问题的一类技术,其中最常见的两种方法是岭回归(Ridge Regression)和Lasso回归(Least Absolute Shrinkage and Selection Operator)。

weixin_44943389的博客 242

状态机与RTOS的融合实践:如何避免‘状态爆炸’并提升系统响应

本文探讨了状态机与RTOS的融合实践,重点介绍了如何通过层次化状态机、表驱动设计等策略避免状态爆炸问题,并优化任务调度与事件处理机制,从而显著提升嵌入式系统的响应速度和可靠性。

net55的博客 106

八种常见回归算法解析及代码

目录 一、线性回归 1、最小二乘法-导数/偏导为0求参数 最小二乘法求解参数​优缺点 2、迭代求解参数​-梯度下降、坐标轴下降、最小角回归 2.1使用梯度下降-对回归系数中w的每个元素分别求偏导并乘以学习率,迭代更新w 2.1.1批量梯度下降:每次迭代依据全体样本的误差结果更新回归系数 2.1.2随机梯度下降:每次迭代依据某个样本的误差结果更新回归系数 2.1.3小批量梯度下降:每次迭代依据部分样本的误差结果更新回归系数 2.2.1坐标轴下降法和梯度下降法的区别 2.3、使用最...

轩逸云的博客 2万+

C51单片机驱动ILI9341彩屏实战:从Proteus仿真到绘制自定义图案(附完整代码)

本文详细介绍了使用C51单片机驱动ILI9341彩屏的完整实战流程。内容涵盖硬件连接、8080并行接口时序模拟、寄存器初始化、屏幕方向设置以及基本图形绘制原理,并重点讲解了如何在Proteus仿真环境中搭建电路、调试代码,最终实现自定义图案的显示。文章提供了完整的代码示例,为嵌入式开发学习者和复古硬件爱好者提供了一套可行的解决方案。

rnn9storyteller的博客 511

Python实战:从中国气象局天擎平台自动化获取与处理雷达基数据

本文详细介绍了如何利用Python脚本实现从中国气象局天擎平台自动化获取与处理雷达基数据。通过环境搭建、安全认证、核心代码编写及工程化优化,构建了一个包含自动查询、批量下载、错误重试和格式转换的完整数据管道,旨在帮助气象水文领域的研究者与数据分析师从繁琐的手动操作中解放出来,高效管理海量数据。

ipfs8storage的博客 919

回归问题

$$

qq_45778910的博客 477

从零构建:Trinamic API在STM32上的深度移植与TMC-IDE通信实战

本文详细介绍了如何从零开始在STM32平台上深度移植Trinamic API,并实现与TMC-IDE工具的稳定通信。内容涵盖SPI底层驱动定制、寄存器配置、高级功能实现及调试技巧,重点解析了TMC5160芯片的集成实践,帮助开发者构建可靠的嵌入式运动控制系统。

w1x2y3的博客 254

缩减系数来“ 理解”数据——岭回归

头歌实践教育平台机器学习实验

qq_62767376的博客 1505

第55篇:数据隐私保护技术盘点——差分隐私、同态加密与它们的坑(踩坑总结)

数据隐私保护是AI工程化中必须严肃对待的课题。差分隐私和同态加密是两把利器,但也都是“重武器”,使用不当反而会伤及自身。差分隐私像“模糊处理”,通过加噪来保证统计安全性,要小心管理隐私预算和效用权衡。同态加密像“保险箱里打算盘”,保证了计算的精确性,但必须承受巨大的性能和工程复杂度代价。我的建议是:从小规模实验开始,先用DP-SGD在MNIST/CIFAR-10等标准数据集上感受噪声与精度的关系;再用TenSEAL等易用的库尝试一个加密逻辑回归,体会密文膨胀和速度延迟。

ai_blue_pm的博客 280

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

【Python机器学习】回归——缩减系数来“理解”数据

为了解决上述问题,可以使用岭回归,接着是lasso法,该方法效果很好但是计算复杂。还有前向逐步回归,可以得到与lasso相似的效果,且更容易实现。

weixin_39407597的博客 888

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

系数缩减回归的原理

在只有有限个数据点的情况下,使用最小二乘法来对样本点做回归,势必会造成模型过拟合。什么意思呢?下面有两幅图: 分别是使用三阶多项式和九阶多项式对样本点做最小二乘回归的结果(红色的线),而样本点是由绿色的线加上一些噪音所生成的。可以看到,显然三阶多项式对真实模型的逼近效果更好,而九阶多项式的效果很差,虽然它做到了平方误差和为零,但你拿这个九阶模型去预测的话,预测结果会非常离谱。 那为什么对样本

629

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

缩减系数

一、岭回归 1、原理 如果对代价函数J(θ)=(Xθ−y)T(Xθ−y)J(θ)=(Xθ-y)^T(Xθ-y)J(θ)=(Xθ−y)T(Xθ−y)不加任何限制,那么对θθθ求导,可以得到θθθ矩阵形式的解θ=(XTX)−1XTyθ=(X^TX)^{-1}X^Tyθ=(XTX)−1XTy。这里会出现一个问题:如果得到的样本个数小于样本的特征数,也就是说训练集矩阵XXX的行维度mmm小于列维度ddd,...

weixin_44863781的博客 685

线性回归(2)缩减系数理解

摘要:当我们的数据特征比样本点还多怎么办,是否能够预测呢答案是否定。 那么如何解决这个问题呢?科学家们引入了岭回归这个概念,岭回归其实就是如下: 与前面的算法相比。这里通过预测误差的最小化得到系数首先抽取一部分用于训练I的系数,剩下的再来训练W def ridgeRegres(xMat,yMat,lam=0.2): xTx = xMat.T*xMat deno

hhy518518的专栏 2143

回归预测算法

1、基础 适用数据:数值型。 (1)相关系数(R2)衡量 有时候,我们需要计算预测值与实际值的匹配程度,来衡量所建立模型的好坏。此时,需要计算Y、Y‘的相关系数: 其中,Cov表示协方差,Var表示方差。 (2)缩减系数 当数据的特征比样本数目还多时,此时n>m,输入的样本矩阵非满秩矩阵,在求逆时会出错。 2、线性回归 线性回归意味着将输入数据分别乘以一些常量(回归系...

weixin_33856370的博客 5407

《机器学习实战》之八(二)——预测数值型数据:回归

回归目录一、前言二、缩减系数来“理解”数据1、岭回归2、lasson3、前向逐步回归三、权衡偏差与方差四、示例:预测乐高玩具套装的价格1、获取数据2、建立模型五、使用Sklearn的linear_model总结参考资料 一、前言   前面我们介绍了线性回归和局部加权线性回归,并配有两示例——预测鲍鱼的年龄。但是在示例中数据集是多维的,有多个数据特征。如果数据的特征比样本点多应该怎么办?是否还可以使...

潘多拉星系的专栏 1821

特征缩减系数的理解等 岭回归 lasso

出处:http://blog.youkuaiyun.com/autoliuweijie/article/details/50285881 1. 理论 概述: 通过对损失函数(即优化目标)加入惩罚项,使得训练求解参数过程中会考虑到系数的大小,通过设置缩减系数(惩罚系数),会使得影响较小的特征的系数衰减到0,只保留重要的特征。常用的缩减系数方法有lasso(L1正则化),岭回归(L2正则

爱我所享 的博客 1860

回归---OLS、LWLR、缩减方法、岭回归、lasso、前向逐步回归【含python代码】

回归的目的就是预测数值型的目标值。最直接的办法就是写出一个目标值的计算公式,即所谓的回归方程,需要求方程中的回归系数。一旦有回归系数,就可以进行预测了,具体做法是用回归系数乘以输入值,再将结果全部加起来,就得到预测值了。 下面首先介绍找出最佳拟合直线的两种方法普通最小二乘法(OLS)和局部加权线性回归(LWLR),然后介绍缩减方法,如岭回归、lasso、前向逐步回归。 普通最小二乘法(OLS,Ordinary Least Squares) 核心思想:对于给定的数据集上,找出最佳拟合直线,使得真实值与预测值之

Amy9_Miss的博客 1825

机器学习算法之回归算法

回归(Regression) 概述 分类的目标变量是标称型数据,而回归则是对连续型的数据做出处理,回归的目的是预测数值型数据的目标值。 回归 场景 回归的目的是预测数值型的目标值。最直接的办法是依据输入写出一个目标值的计算公式。 假如你想要预测兰博基尼跑车的功率大小,可能会这样计算: HorsePower = 0.0015 * annualSalary - 0.99 * hoursListeni...

tttaeyang的博客 1902

机器学习之线性回归缩减维度

机器学习之线性回归缩减维度 什么叫高维数据?维数膨胀数据降维Lasso前向逐步回归法前向逐步回归法代码实现前向逐步回归法 缩减参数参考文献 什么叫高维数据? 如上图 前面 我们求解线性回归的时候 列举的一个例子。 这个例子中: 房子的面积, 房间的数量 , 楼间距, 离学校的距离 我们的数据 从这四个维度取例 ,也称为数据的维度。 下面的每一行 表示一个 房子的样本 。 样本可以有N ...

ithinking110的博客 1804

线性回归——岭回归、lasso、前向逐步回归

线性回归——岭回归、lasso、前向逐步回归1.岭回归2.lasso3.前向逐步回归 接上一篇文章线性回归——局部加权线性回归,我们知道如何解决欠拟合,现在我们介绍一下当出现过拟合时我们怎么解决。 解决过拟合我们可以增加训练集、可以减少特征、也可通过正则化。 首先回顾一下我们的标准线性回归中我们的回归系数w=(XTX)−1XTyw=(X^TX)^{-1}X^Tyw=(XTX)−1XTy,因为其中涉...

CarryLvan的博客 4173
上一篇: 回归(一)
下一篇: L1和L2正则化
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值