


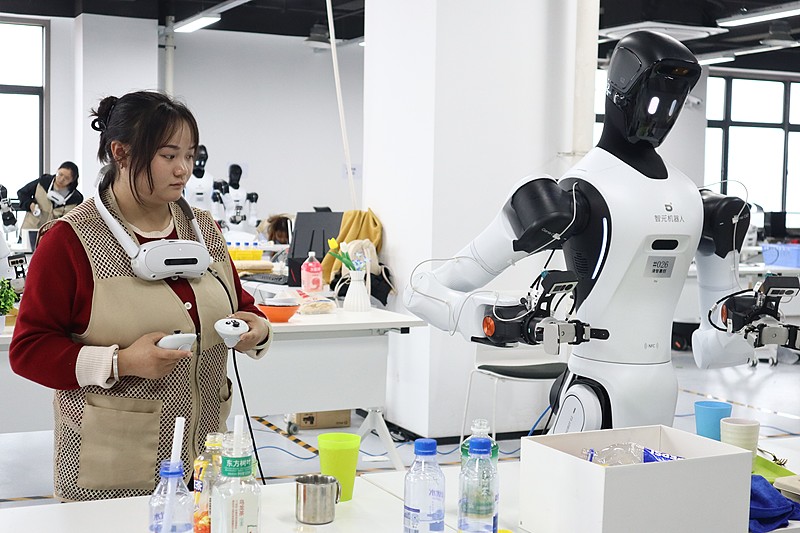
从视觉到多感知:具身智能的转变
2009 年,李飞飞团队发布 ImageNet,让人工智能首次有机会借助海量图片认识世界。十五年后,她在一次演讲中提出「空间智能」,认为 AI 的下一步,不只是识别图片内容,而是理解物体位置、相互关联,以及人行动后世界的变化。今年,这条研究路线更进一步。6 月,李飞飞参与的机器人研究 T - Rex 发布,研究者为机器人加入高频触觉反馈,使其能完成翻书页、拿鸡蛋、挤牙膏、抽取薄卡片和拧灯泡等任务。
一位以计算机视觉闻名的科学家,为何开始频繁谈论触觉、模拟器和机器人?这并非意味着视觉过时。相反,如今的具身智能厂商仍在为机器人配备更多摄像头、更精确的深度传感器和激光雷达。真正的变化是,行业逐渐意识到,「看」只是智能进入物理世界的开端,图片只是世界的表象。今年 3 月,李飞飞参与的一项研究做了个实验:研究者向多模态模型提视觉问题,却故意不传入图片。按常理,模型应回答「我没有看到图片,无法判断」,但不少前沿模型仍一本正经描述图像内容,给出完整分析过程,甚至在部分视觉问答测试中取得高分。比如在胸肺 X 光问答基准里,模型没看过 X 光片,成绩却名列前茅。
研究者将此现象称为「幻景推理」,即模型可能并非依据视觉证据回答问题,而是利用问题文字线索和训练数据常见搭配,猜测图片样子。就像大模型不一定知道自己在说什么,只是推测「下一个最有可能出现的字」。题目问「图中车辆正在等待什么信号」,即便没图,人也可能凭常识猜出是红绿灯。模型有了足够的图片说明、诊断报告和问答数据后,可能绕过视觉观察直接得出答案。它看似看见了,实则未必。
在聊天窗口,用户或许不在意答案是看图得出还是语言猜测。但在物理世界,二者区别立现。杯子在桌子左边还是右边、距手臂多远等问题,无法靠语言常识解决,对机器人而言,差几厘米就会抓空。因此,如今机器人的感知系统愈发复杂。宇树 G1 使用深度相机和 3D 激光雷达,分别判断物体远近和建立周围空间距离地图。智元灵犀 X2 除 RGB - D 相机和激光雷达外,还使用前视双目、后视相机和触摸传感器,从不同方向补充环境信息。
这些配置看似是传感器军备竞赛,实则是弥补视觉盲区。头部摄像头适合观察房间,但机械臂靠近物体时易被手遮挡;激光雷达能测距离和建地图,却分不清桌上是杯子还是苹果。对人来说,转头、眯眼或伸手试探无需思考,机器人却要整合不同摄像头、雷达和关节传感器的信息,才能确认面对的是同一个持续存在的物理空间。所以,具身智能首要问题不是模型能否认出杯子,而是能否确认杯子真实存在。
模型的局限与突破:从画世界到在世界中干活
近年来,「模型」成为 AI 行业热词。视频生成模型能根据提示词生成机器人走进客厅、拿起篮子、凑近玩具并放入篮子的画面,光影、运动和镜头都很自然,让人觉得模型已理解环境和物体运作。但从视频看,杯子重量、柜门铰链承受力、机械手是否打滑等问题无需回答,只要画面合理即可。
实际上,对机器人而言,这些细节决定任务成败。World Labs 今年将「世界模型」技术分为三类:渲染器负责生成像素供人观看;模拟器负责表示几何结构、物理属性和动态变化;规划器根据目标决定机器人下一步行动。这一分类说明,模型会画世界不代表能在其中工作。生成视频里车能穿过城市,但模型未必知道街道是否持续存在、建筑有无稳定三维结构、车轮与地面有无摩擦。对观众来说画面逼真就行,对机器人而言,世界必须可计算、可碰撞,且转身之后仍存在。
World Labs 推出的 Marble 能从文字、图片或视频生成可探索的三维环境,还能输出碰撞网格,供物理引擎判断物体能否穿墙、落地位置。英伟达的 Cosmos 则将世界生成、视频预测和机器人训练纳入同一套 Physical AI 体系,用合成场景填补真实机器人数据不足。
这条路线看似宏大,落实到机器人公司研发流程却很简单,就是让机器人先在虚拟世界反复失败。逐际动力的 TRON 1 支持 NVIDIA Isaac、MuJoCo 和 Gazebo 等仿真平台,开发者可在虚拟环境测试不同地面、坡度和碰撞情况。智元发布的 AgiBot Digital World 用仿真环境生成操作数据、训练模型并评估机器人策略。
在现实中让机器人摔倒一次,可能导致零部件磨损、增加维修成本和安全风险;在模拟器里,成千上万个虚拟机器人可同时尝试同一动作。桌子高度、地面摩擦系数、物体位置可不断变化,机器人无需打碎一万只杯子就能学会端稳杯子。然而,模拟器并非万能。虚拟世界的地面比真实地面干净,模型设定的摩擦力无法涵盖所有材料。机器人在模拟器练得再熟,进入工厂、商场和家庭仍会遇到未写入参数表的意外,即「仿真到现实差距」。World Labs 在 7 月 21 日收购 SceniX 的重要性就在于此,它开始将模拟世界与真实机器人行动反馈相连。
触觉:具身智能的即时反馈
即便视觉和模拟技术成熟,机器人接触物体时仍会遇到摄像头难以解决的问题。拿起鸡蛋时,机器人如何判断手指用力过大?抽出薄卡片时,如何区分捏住的是卡片还是桌面?拧灯泡时,如何感知螺纹卡住、避免损坏物体?摄像头能看到手接近目标,却难以及时判断接触面情况。触觉解决的是「接触后发生了什么」,如压力变化、物体滑动、材料变形、抓握稳定性等,这些信息在视觉画面之下。
Figure 今年发布的 Helix 02,将头部摄像头、手掌摄像头、指尖触觉和全身本体感知接入同一控制系统。头部摄像头被遮挡时,手掌摄像头提供近距离画面;指尖传感器能感知低至 3 克的力,让机器人从药盒取单颗药片、控制注射器推精确剂量、分离小尺寸目标。国内厂商也在快速提升触觉感知能力,像帕西尼这样的上游厂商,将触觉传感器、灵巧手、人形机器人、数据采集和多模态模型组成产品链,希望将触觉纳入机器人训练数据。
但给机器人装传感器不意味着它会用触觉。很多「常识」能力并非源于看了多少图片,而是身体在长期接触中学会让动作适应世界。李飞飞参与的 T - Rex 研究展示了这一困难。团队收集 100 小时含触觉信号的机器人操作数据,让机器人完成翻书页、转移鸡蛋、擦盘子等任务。最终,T - Rex 在 12 项任务中的平均成功率达 65%,比最强对照模型高 30 个百分点。
研究发现,直接将触觉数据融入现有视觉—语言—动作模型效果不佳。因为不同感官工作速度不同,视觉和语言适合做全局判断,机器人需先看清桌面、理解指令再选物体。但杯子滑落时,不会等模型重新分析规划。触觉需高频持续工作,在滑动瞬间调整手指力度。因此,T - Rex 让视觉和触觉按不同速度运行,视觉决定「要做什么」,触觉修正「做得对不对」。
过去几年的 AI 竞争主要围绕打造更聪明的大脑,具身智能正将竞争引向更完整的系统。机器人需要摄像头和雷达确认世界位置,需要模拟器预演行动后果,也需要触觉和力反馈应对接触后的意外。李飞飞并非从视觉直接转向触觉,她的研究是在拓展「看见」的含义:从识别图片到理解空间,再到知晓伸手碰触后世界的回应。十五年前,ImageNet 教会 AI 识别眼前事物,下一代世界模型要解决的是,AI 伸手后世界的反馈。
 53


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


