Google DeepMind推出Gemini Robotics 2:全身智能让机器人迈向真实场景应用!

具身智能新突破:Gemini Robotics On-Device,让机器人拥有“本地大脑” 谷歌DeepMind重磅发布Gemini Robotics On-Device,首个可在机器人上本地运行的视觉-语言-动作(VLA)模型,赋予机器人强大的自主学习与适应能力,开启具身智能新纪元。本文深入探讨其技术优势、应用场景及对未来机器人发展的影响。 阅读详情

WAIC2026:人形机器人成人礼

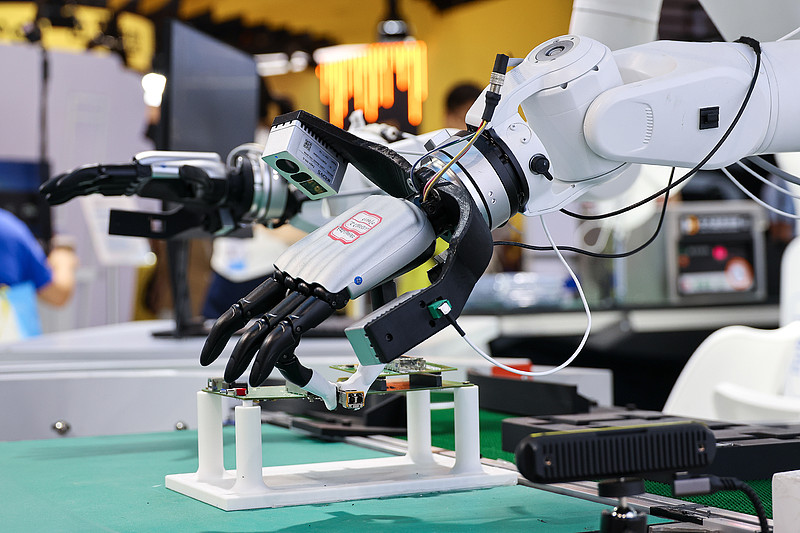
前段时间,雷科技WAIC2026报道团亲赴现场,看到了一场规模空前的人形机器人成人礼。超过200家机器人相关企业、300多台真机同台竞技,从宇树三米高的载人变形机甲来回切换形态,到智元的机器人用镊子夹起2毫米电阻焊到电路板上。过去最容易围住观众的后空翻和机械舞还在,但厂商越来越想证明机器人不只会动,还能干活,甚至干更多活。

造“身体”易,造“大脑”难

造出一副能跑、能跳、能伸手的“身体”,已经不是当下最稀缺的能力。真正的瓶颈是“大脑”,是怎么让机器人看懂混乱的环境,决定下一步做什么,再把决定稳定地送到几十个关节。

Google DeepMind推出Gemini Robotics 2

就在WAIC结束一周多后,Google DeepMind推出了Gemini Robotics 2,一个主打“全身智能”的机器人通用模型,适用于各种不同形态的机器人。谷歌这次的发布包含三个模型,Gemini Robotics ER 2负责理解环境、规划长任务和与人沟通,Gemini Robotics 2这个VLA模型把视觉与语言直接转成动作,On - Device 2则把动作模型压到本地,并能用少于200个样例、几小时数据适配新的机器人本体。

全身智能的体现

谷歌开始用一组模型协调一台人形机器人的双腿、躯干、双臂和手指,让它一边思考推理,一边移动操作。上一代Gemini Robotics主要控制机器人的上半身,处理桌面任务。到了Gemini Robotics 2,官方视频中的Apptronik Apollo 2会走向放在地上的绿色水壶,弯腰把它提起来;还会走到货架前,取出一只棒球手套,随后转身离开。这些动作背后同时依赖视野、可达范围、步态和重心。视频也特别标注,画面中的机器人均为自主运行,动作按真实速度播放。同一个模型已经用于搭载不同灵巧手的Apollo 2,以及使用两指夹爪的Franka Duo。不过,Apollo走路、下蹲和摆放物体的速度都很慢,谷歌自己也承认移动速度仍需提高。官方测试中,Apollo从桌面、地面和货架取物的平均成功率分别为68.4%、45.7%和76.3%。

机器人难在“最后几厘米”

全身控制解决的是机器人怎么抵达、怎么站稳。真正决定它能不能进入家庭和工厂的,往往还是最后几厘米。在官方视频里,Apollo 2使用一只拥有22个自由度的五指SharpaWave灵巧手,尝试拧灯泡、封自封袋、给垃圾袋打结;Franka Duo的两只夹爪负责把形状各异的工具紧密装进工具箱。过去机器人最常见的抓取演示,只是把一个硬物从A点搬到B点,而这些任务涉及连续接触、双手配合和形变。谷歌公布的成绩显示,两指夹爪在通用抓放、工具配套和精密插入上的平均成功率达到74.2%、78.9%和89.6%,到了多指灵巧手,差距迅速拉开,拧下灯泡达到92%,拧上灯泡只有36%,扎垃圾袋是44%,使用簸箕和封自封袋分别只有32%和40%。

机器人协作新尝试

视频中,Apollo与Franka Duo共同整理工具箱。Apollo发出任务,Duo把工具装入盒内,两台机器人各自运行一套模型,通过高层推理分配和衔接工作,而不是由一个中央神经网络同时操纵两副身体。ER 2还会持续查看视频,判断任务进度、发现失败并决定是否重试。不过,官方视频展示的是一个经过设计、总长几分钟的工具收纳场景,离多台机器人在真实工厂里连续协作几个月,还隔着很长的稳定性验证。

谷歌没有抛弃“大小脑”

具身智能行业目前普遍将机器人架构概括成“大脑”和“小脑”,大模型负责看懂指令、拆解任务,小模型和传统控制器负责导航、平衡、抓取。但物理世界并不喜欢整齐的模块边界,高层计划与底层动作理解不一致,错误会在长任务中累积。严格来说,谷歌并没有放弃“大小脑”,ER 2依然是高层大脑,负责看、想、规划和调用工具,再把动作执行交给VLA。Gemini Robotics 2用一个VLA统一全身动作,ER 2则可以一边观察执行,一边思考后续步骤,减少机器人每做一步都要“停下来想想”的割裂感。而且这条路线也不是谷歌独有,Figure在今年初发布的Helix 02,智元最新的GO - 2都有类似做法。

全身智能要经得起生活场景“拷打”

目前具身智能模型的前沿探索,大致都在追三件事:更多本体、更长任务和更少的专用数据。英伟达开源的GR00T N1.6,Physical Intelligence的π0.5,蚂蚁灵波开源LingBot - VLA 2.0都有相关成果。Gemini Robotics On - Device 2用不到200个样例适配新本体,值得关注。但机器人比聊天模型更难糊弄,英伟达在GR00T N1.6的说明中仍承认,多任务语言跟随和分布外泛化是持续挑战,谷歌的五指任务成功率也表明,同一个模型能控制不同身体,不等于它已经稳定掌握所有身体。Gemini Robotics 2最重要的地方,是让具身智能模型开始越过桌面和上半身,把走路、平衡、精细操作、长任务与多机协作放进同一张考卷。而WAIC上那些成熟的芯片、关节和整机,已经为AI准备了很多副身体,谷歌这次试图证明,模型也开始学会把身体当作一个整体来使用。至于它什么时候能真正走进我们的生活,那不只需要全身智能。

Gemini Robotics 1.5:基于VLA与具身推理模型实现机器人自主规划与工具调用 在人工智能与机器人技术融合的浪潮中,多模态大模型正成为实现机器智能的关键。其核心原理在于,通过视觉-语言-动作(VLA)模型的深度融合,让机器能够同步理解视觉信息、自然语言指令并生成控制动作。这项技术的核心价值在于,它使机器人从依赖预设程序的“自动化工具”,转变为具备自主任务分解与规划能力的“智能体”。具体到应用场景,这为机器人应对开放世界、长周期、多步骤的复杂任务(如家庭服务、工业分拣)提供了可能。本文聚焦的Gemini Robotics 1.5,正是这一方向的典型代表,它通过创新的双模型架构——将负责实 阅读详情

相关推荐

四大VLA模型对比:OpenVLA、π0、RT-2与Gemini Robotics技术解析

视觉-语言-行动模型是机器人领域实现端到端智能控制的核心技术。其基本原理是通过统一的深度学习架构,将视觉感知、语言理解与动作生成进行模态对齐与融合,从而让机器人能直接根据视觉观察和自然语言指令输出控制动作。这项技术的价值在于摒弃了传统机器人技术栈中感知、规划、控制分离的复杂流水线,大幅提升了系统的灵活性与泛化能力。其典型应用场景包括工业分拣、家庭服务、灵巧操作等需要复杂环境理解与任务执行的场合。本文聚焦于当前该领域的四个代表性模型:开源的OpenVLA、高效落地的π0、谷歌的RT-2以及基于原生多模态大模型

weixin_34081595的博客 383

Gemini Robotics:Google DeepMind 让 AI 机器人真正“动”起来!

订阅我们的简报,深入解析最新的技术突破、实际应用案例和未来的趋势。,一款基于 Gemini 2.0 的 AI 机器人模型。等机构合作,确保 Gemini Robotics-ER 适用于各种场景。,让机器人具备更强的物理世界交互能力。除了 Gemini Robotics,Google 还推出了专注于。这两款 AI 机器人模型将彻底改变机器人行业,使机器人能够执行。:以 AI 规则集约束机器人行为,确保符合人类伦理。:结合 AI 代码生成能力,动态规划复杂任务。,专门用于评估机器人行动的安全性,并与。

2301_79342058的博客 1018

Obsidian从零搭建:可验证、可回溯、可演进的知识库工具链

个人知识库不是开箱即用的软件,而是基于Markdown内核构建的可演进系统。其核心原理在于分离‘稳定内核’与‘可插拔扩展’:Obsidian原生支持双链、嵌入、Frontmatter等基础能力,构成不可降级的知识骨架;而Dataview、Templater等插件则作为可验证、可回溯的增强层,需通过三问验证(解决痛点?有原生替代?失效可降级?)方可引入。这种设计赋予知识库技术价值——抗版本升级、跨平台兼容、离线可用,并支撑技术文档管理、项目复盘、读书笔记等真实场景。当面对computer use插件不可用或h

weixin_30660027的博客 684

Google DeepMind推出Gemini Robotics 2:具身智能迈向全身智能新高度!

全身控制解决了机器人抵达和站稳的问题,但决定其能否进入家庭和工厂的往往是最后几厘米的操作。在官方视频里,Apollo 2用五指SharpaWave灵巧手尝试拧灯泡、封自封袋、给垃圾袋打结,Franka Duo的夹爪负责装工具。过去机器人常见抓取演示较简单,而这些任务涉及连续接触、双手配合和形变。Gemini Robotics 2要从视觉和指令直接生成高频、连续动作。

IT界那些事儿 24

ICCompiler II实战:从NDM生成到APR流程的完整避坑指南

本文是一份针对ICCompiler II(ICC II)后端物理实现流程的实战避坑指南。文章详细解析了从NDM库生成、设计初始化、布局规划到时钟树综合与布线的完整APR流程,重点分享了各环节的常见陷阱、精细化配置命令与调试经验,旨在帮助工程师高效达成PPA目标,确保设计一次成功。

p4q5r6s7t的博客 533

3个PLC进阶教程实战项目,学完立即接私单!

此处应插入清晰的硬件电路图,包含土壤湿度传感器、水泵、PLC的输入输出端子,并标注清晰的接线方式。同样的,也需要插入清晰的梯形图,用简单的逻辑表达控制过程,比如:土壤湿度传感器信号低于设定值 -> PLC输出信号 -> 水泵启动。我是老王,一个在自动化行业摸爬滚打多年的老工程师,今天咱们不聊那些枯燥的理论,直接上手三个PLC进阶实战项目,学完保证你信心满满,立马就能接私单!想想你家里的空调,它也是通过检测室温,并根据设定的温度进行制冷或制热,这个项目就是类似的原理。

qq_38220914的博客 1477

机器人迎来 “离线大脑”:谷歌 DeepMind Gemini Robotics On-Device 如何改写行业规则?

【摘要】Gemini Robotics On-Device是谷歌DeepMind发布的首个可在机器人本地独立运行的视觉-语言-动作(VLA)模型,彻底摆脱云端依赖,实现离线智能。其多模态融合、极强泛化与迁移能力、开发者友好生态和双重安全机制,正推动机器人行业迈向“去中心化”与“设备即大脑”的新纪元。

欢迎来到运通链达的官方博客!我们深度探讨人工智能技术与应用,贯彻科技向善理念,推动科技进步与社会福祉和谐共生。 1655

HyperMesh实战:5种复杂载荷场景下的field映射技巧(附TCL脚本)

本文详细介绍了HyperMesh在5种复杂载荷场景下的field映射技巧,包括轴承载荷的圆柱坐标系映射、粉末压力中的切向力处理、实验数据到有限元模型的场映射、多工况载荷的组合映射以及局部细化网格的边界条件传递。通过实战案例和TCL脚本,帮助工程师高效解决有限元分析中的载荷映射难题,提升工作效率。

fanta的博客 297

Google DeepMind推出Gemini Robotics 2,具身智能模型能否走进生活场景?

全身控制解决机器人抵达和站稳问题,真正决定其能否进入家庭和工厂的是「最后几厘米」。官方视频里,Apollo 2用五指SharpaWave灵巧手尝试拧灯泡、封自封袋、给垃圾袋打结,Franka Duo的夹爪把工具装进工具箱。这些任务涉及连续接触、双手配合和形变,与过去简单抓取演示不同。Gemini Robotics 2要从视觉和指令直接生成高频、连续动作。

IT界那些事儿 72

基于 YOLOv26 的遥感图像目标检测系统:从原理到模型

本文介绍了基于YOLOv26的遥感图像目标检测系统。YOLOv26凭借端到端设计、轻量化架构和小目标优化能力,有效解决了遥感图像中多尺度目标、复杂背景、小目标检测等挑战。系统采用CSPDarknet骨干网络和FPN+PAN特征融合模块,通过MuSGD优化器和改进损失函数提升训练效果。文章详细阐述了数据预处理、模型训练流程和优化技巧,包括Tile推理和混合精度训练。系统支持多种部署方式,在CPU上推理速度提升43%,能实现高精度、实时性的遥感目标检测,适用于城市规划、农业监测等场景。

一键难忘的博客 572

【2026OD新机考】【哈希表】20260422-文章特征提取【Py/Java/C++/C/JS/Go六种语言OD真题】【欧弟算法】全网注释最详细分类最全的华子OD真题题解

90+天陪伴式学习,100+直播课时,300+动画图解视频,500+LeetCode经典题,500+华为OD真题/大厂真题,还有简历修改、模拟面试、陪伴小群、资深HR对接将为你解锁。这道题的本质是多集合交集问题的变形,属于非常典型的哈希表应用题。,储存全局的每个片段中,各个字符最少出现的次数。表示该字母并非所有片段的公共字母。,按照顺序构建答案即可。没有字母在所有三个字符串中都出现。每个字母在各字符串中都至少出现。次,所以结果中每个字母出现一次。这样,当上述循环结束后,最终。显然在上述代码中,如果字母。

weixin_48157259的博客 66

Google DeepMind与Apptronik展示家用人形机器人执行真实世界任务

Google DeepMind与Apptronik展示家用人形机器人执行真实世界任务

zhidingkeji的博客 948

GEE:随机森林分类教程(样本制作、特征添加、训练、精度、参数优化、贡献度、统计面积)

本文将介绍在Google Earth Engine (GEE)平台上进行随机森林分类的方法和代码,其中包括制作样本点教程(本地、在线和本地在线混合制作样本点,合并样本点等),加入特征变量,运行随机森林分类器教程,计算随机森林分类结果的精度,优化随机森林分类算法的参数,打印各个变量特征的贡献度等步骤的方法和代码。本教程可以应用于多种分类场景,包括土地利用分类、种植区提取(大蒜、小麦、玉米等)、局部气候区分类、植被分类等多种场景。

养乐多的博客 1万+

Gemini Robotics 2:当机器人学会用“全身”思考

想拥有一个能真正“动手”的AI吗?Gemini Robotics 2 打破“聪明大脑、笨拙身体”的魔咒,让机器人用全身感知物理世界。从连续动作控制到端到端训练,这篇文章手把手拆解VLA模型的技术内核,带你见证机器人从“纸上谈兵”到“心灵手巧”的进化。🤖✨

weixin_44063643的博客 343

华为OD面试手撕真题 【合并相邻且相等的元素】多语言题解

华为OD面试高频手撕真题【合并相邻且相等的元素】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解。

qq_45776114的博客 552

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

机器人 “离线觉醒” ? 摆脱人类“控制”!Google DeepMind 优化 AI 让机器人断网不断智!

在科技浪潮奔涌向前的时代,人工智能与机器人的深度融合正掀开无限可能的智能篇章。Google DeepMind 重磅推出 Gemini Robotics AI 模型的设备端版本,作为视觉 - 语言 - 行动模型(VLA),它不仅延续了 3 月份发布的灵巧功能,更以 “体积小且效率高” 的特性实现突破,无需互联网连接即可直接在机器人上运行。这一创举犹如巨石投入平静湖面,激起千层浪,标志着机器人技术迎来里程碑时刻 ——AI 模型彻底摆脱云端束缚,在设备端扎根,实现高效离线的智能决策与操作,为重塑人机协作未来、解锁

敖行客 Allthinker的博客 599

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Gemini Robotics 1.5:VLA模型如何重塑机器人任务规划与执行范式

在机器人技术领域,任务规划与执行一直是核心挑战。传统方法依赖于基于规则的、分模块的预设系统,虽然实现了特定场景的自动化,但存在泛化能力差、开发成本高等瓶颈。其原理是通过独立的视觉、规划和控制模块串联工作,将复杂任务分解为可执行的代码逻辑。随着人工智能的发展,Vision-Language-Action模型带来了技术价值的跃升,它通过端到端的方式,将视觉感知、语言理解和动作生成统一起来,使机器人能够基于自然语言指令和实时视觉观察,自主进行常识推理和任务分解。这种技术特别适用于应对非结构化环境和处理复杂的长尾任

weixin_30940783的博客 427

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

从“动作迁移”到“思考VLA”:Gemini Robotics技术拆解

谷歌DeepMind推出Gemini Robotics 1.5系列模型,标志着AI大脑与机器人身体的深度融合。该系统由两个协同模型组成:具身推理模型GR-ER 1.5负责高级规划与工具调用,视觉-语言-动作模型GR 1.5负责精确执行,并具备动作迁移能力。通过思考机制连接大脑与身体,使机器人能理解复杂指令并自主调整动作。该技术已在仓储物流、家庭服务、医疗辅助等领域展现应用潜力,为通用机器人发展提供了可行路径,推动AI从数字世界走向物理实

aidoudoulong的博客 799

【AI前沿】2026.08.05 端侧AI元年+Gemini机器人全身控制+千问办公公测+英伟达CMX存储

2026年8月5日这一天,可能不会像GPT发布那样被写入AI史册,但它可能是一个更重要的转折点——AI不再只是云端的一个聊天框,而是开始真正渗入我们生活的每一个角落:手机里、汽车上、机器人的身体里、企业的工作流里。从"大模型竞赛"到"落地竞赛",从"比谁参数大"到"比谁用得好",AI产业的竞争正在进入深水区。对工程师来说,这既是挑战也是机遇——当基础设施逐步成熟,真正的价值创造才刚刚开始。

求知若渴、虚心若愚 455

VLA模型与Gemini Robotics:解决机器人“最后几厘米”操作难题

随着大模型技术深入物理世界,具身智能成为机器人领域的新焦点。传统机械臂控制依赖感知、规划、控制分离的串行流程,在夹爪接触工件的“最后几厘米”常因误差累积而失效。VLA(视觉-语言-动作)模型将视觉理解与动作生成统一在同一架构中,让机器人从“看懂”迈向“操控”。Google DeepMind 推出的 Gemini Robotics 系列通过动作模型与具身推理模型的分工,既保证实时响应,又提升空间推理精度。这一技术路径可应用于物体抓取、整理分拣、长程任务分解等场景。对于开发者而言,结合具身推理与现有控制栈,构建

weixin_34015336的博客 337

Gemini Robotics 1.5:双模型架构如何实现机器人的自主规划与执行

在人工智能与机器人技术融合的浪潮中,视觉-语言-动作模型已成为实现机器人智能化的核心技术路径。其核心原理在于构建一个能够将视觉感知、语言理解与物理动作生成相统一的端到端学习框架,通过多模态数据融合,使机器人能直接理解环境并生成控制指令。这项技术的核心价值在于突破了传统机器人依赖预设程序的局限,赋予机器人在非结构化环境中自主执行复杂任务的能力。其典型应用场景包括柔性制造、家庭服务与高风险环境作业,机器人需要根据动态环境进行实时决策。而Gemini Robotics 1.5系统正是这一技术方向的集大成者,它创新

weixin_34396902的博客 473

豪揽5.2亿美元!Apptronik融资逼近10亿,Apollo人形机器人剑指量产

本文深度解析美国人形机器人龙头企业Apptronik完成5.2亿美元A-X轮融资延伸的核心事件,分析此次融资对Apptronik的战略意义,解析其豪华投资方阵容的协同价值,详细介绍Apollo旗舰人形机器人的技术参数、量产规划与场景应用,解读Apptronik与Google DeepMind的技术合作及子公司Elevate Robotics的多元化布局,剖析其核心优势与量产成本、行业竞争等潜在挑战,探讨Apptronik在全球人形机器人赛道的发展前景与行业影响,为技术从业者、行业观察者提供最专业、最全面的深

牛喀具身智能社区的博客 751

调查研究-209 Apptronik Robot Park 深度解析:人形机器人竞争,开始拼“真实世界数据工厂“

本文围绕 2026 年 6 月 Apptronik 在德州奥斯汀开放的 Robot Park 与 Apollo 2 人形机器人平台展开。Robot Park 占地接近 9 万平方英尺,是一个用于持续采集真实世界任务数据的训练与生产设施,覆盖物流、制造、零售等场景;Apollo 2 同时提供双足与轮式两种形态,目的是在统一的上身、感知、任务系统下做跨形态任务抽象。Google DeepMind 与 Apptronik 自 2024 年起持续合作,2025 年 9 月发布的 Gemini Robotics 1.

谢谢你的喜欢 我们一起无限进步 726

Google最新!Gemini Robotics 1.5:通用机器人领域的突破进展

Google DeepMind 发布的《Gemini Robotics 1.5.pdf》系统呈现了通用机器人领域的突破性进展,该系列包含与两大核心模型。通过 “思考 - 动作融合”“跨形态运动迁移”“嵌入式推理升级” 三大创新,结合 “协调器 + 动作模型” 的智能体架构,实现了机器人 “感知 - 思考 - 行动” 的闭环,为复杂多步骤物理任务解决提供了全新路径。以下结合报告关键图表,从技术架构、核心创新、性能验证、安全机制四方面展开深度解读。

qq_29462849的博客 912

Google DeepMind 发布 Gemini Robotics 2:大模型长出“手“和“脚“,AI 正式进入物理世界

Google DeepMind 推出了 Gemini Robotics 2,将 AI 的能力从虚拟屏幕延伸到了现实的物理空间。这个模型能感知、理解并操控真实物体,DeepMind 研究者将其称为"物理 AGI"的开端。

Winzheng_Index的博客 187

哪些公司在解决具身智能长程任务?全身控制、任务推理与世界记忆各有侧重

机器人完成一次抓取,与连续整理一个房间,是两种不同的任务。后者需要在移动、观察、操作之间不断更新进度:目标物在哪里,刚才哪一步成功了,环境有没有被人改变。因而,“哪些公司具备解决具身智能长程任务的能力”更适合按公开任务和技术切口讨论,而不是给公司排座次。

KLL91801的博客 40
上一篇: 李飞飞研究再突破:从 ImageNet 到空间智能,具身智能竞争迈向更完整系统
下一篇: 贝索斯押注AI找“硅”,CuspAI获4.5亿美元融资,AI材料研发前景几何?
IT界那些事儿
博客等级 码龄6年 2万+粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值