RTX 5080 + RTX 3090 配置:Qwen 3.6 27B Q8 实现 80+ 令牌/秒高速运行!

本地部署大模型与AI Agent实战指南 模型量化技术通过降低神经网络参数的精度来减少计算资源消耗,其核心原理包括权重量化和激活量化两个维度。这项技术能大幅降低显存占用和计算开销,使大模型在消费级硬件上的部署成为可能。在工程实践中,结合AutoGPTQ等工具链,开发者可以在保持模型精度的前提下实现4-8倍的显存压缩。特别是在AI Agent场景中,量化模型与本地化部署的组合既能保障数据隐私,又能满足实时交互需求。以医疗和法律行业为例,通过合理的硬件选型和量化方案,企业可以在RTX 3090等消费级显卡上实现专业级的文本分析与生成能力,将关键业务流程 阅读详情

RTX 5080与RTX 3090的配置契机

一年前,购买了一张RTX 5080用于游戏和AI实验,当时没想到会沉浸在本地大语言模型(LLM)配置的乐趣中。到了2026年,随着Qwen 3.5、Gemma、Qwen 3.6等模型的出现,16GB显存不够用了,于是买了一张翻新的24GB RTX 3090。运行Qwen 3.6 Q4量化模型,起初速度约为30令牌/秒,使用多线程处理(MTP)后能达到50 - 60令牌/秒,但仍感觉受限制,且RTX 5080几乎没怎么用到。

双显卡协同工作的准备

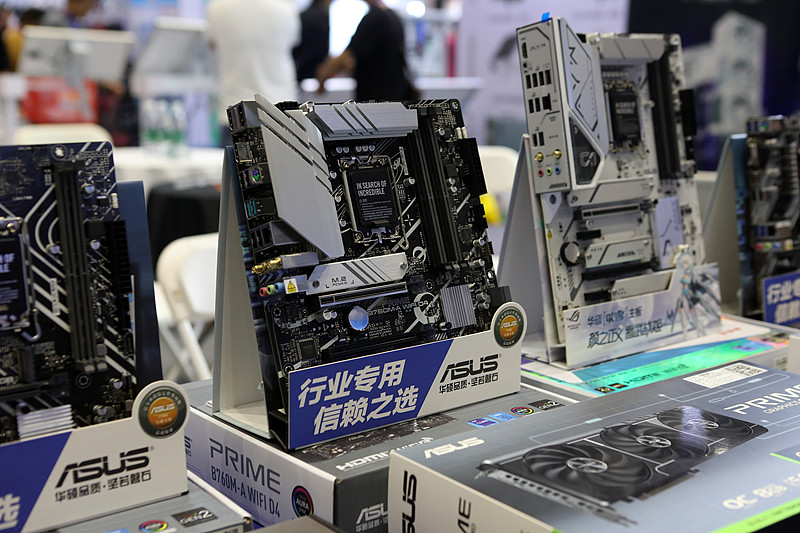
开始研究让两张显卡协同工作,已准备好DDR4内存和SSD硬盘,选择了华硕Prime X570 - Pro主板,“Pro”版本能确保16x PCIe接口可以拆分为2x8。由于RTX 5080功耗较大,买了一根高质量的PCIe 4延长线,将其插在第二个插槽上。

BIOS设置

BIOS设置比预想复杂。不能以BIOS/MBR模式启动操作系统,否则两张显卡都无法使用,即便使用其中一张,也需对内核参数进行不必要的调整。需要设置的参数如下:进入 “Boot” 选项卡,将 “CSM(兼容性支持模块)” 设置为 “Disabled”;进入 “Advanced” 选项卡 -> “PCI Subsystem Settings”;将 “Above 4G Decoding” 设置为 “Enabled”;将 “ReSize BAR Support” 设置为 “Auto” 或 “Enabled”;仍然在 “Advanced” 选项卡中,将 “PCIEX16_1 Link Mode” 设置为 “Gen 4”;将 “PCIEX16_2 Link Mode” 设置为 “Gen 4”。

内核设置

NVIDIA的文档有些混乱,驱动安装步骤链接可查看相关内容。由于两张GPU型号不同,无法使用相关配置。测试发现不同型号、不同代的GPU很可能会失败。不过,对于拥有两张相同型号显卡的幸运读者,在构建/安装补丁驱动后,需卸载 `nvidia - dkms - open`,屏蔽新的 `nova` 驱动,这样新补丁驱动才能在启动时加载。若拥有不同型号的NVIDIA显卡,直接使用 `nvidia - open` 驱动即可。使用 `nvidia` 驱动重启后,可检查驱动是否能识别显卡。

llama.cpp设置

使用特定编译标志来支持这两代显卡,关键标志是 `CMAKE_CUDA_ARCHITECTURES = "86;120"`,能同时启用 “Ampere” 和 “Blackwell” 架构。注意 `-DGGML_CUDA_NCCL = OFF` 这个标志,`nccl` 实际上会起反作用。启动选项有具体要求,要点如下:[Huihui - Qwen3.6 - 27B - abliterated - ggml - model - Q8_0.gguf] 这个模型的 `q8` 量化版本在230k上下文和KV缓存量化为 `q8` 的情况下,能适配总共39GB的显存;`--spec - type ngram - mod,draft - mtp --spec - draft - n - max 3` 结合了 `ngram` 提示和MTP推测加速;`-sm tensor` 参考了相关文档;`-ts 2,3` 是显卡使用比例,对充分利用每张显卡的显存很重要。

结果

通过这样的配置,能够以 `q8` 量化运行完整的 [Qwen3.6] 模型,速度高达80 + 令牌/秒,根据任务不同,最高可达90 + 令牌/秒。在显卡计算时,可用命令检查它们是否全速运行,对于每个PCIe端口,若在16x/2拆分模式下运行工作负载,会看到相应结果。

RTX 5060Ti双卡实战:LLaMA-Factory微调环境配置与多GPU优化指南 本文详细介绍了在双RTX 5060Ti显卡上配置LLaMA-Factory大模型微调环境的完整实战指南。内容涵盖从CUDA 12.8、PyTorch 2.7.0等基础环境搭建,到多GPU并行配置、DeepSpeed与DDP等分布式训练优化,以及FlashAttention等加速库的安装与调优,旨在帮助用户充分利用硬件性能,高效完成大模型微调任务。 阅读详情

相关推荐

Lucebox:让单张 RTX 3090 跑 Qwen3.5-27B,速度飙到 207 tok/s

Lucebox是一个革命性的开源LLM推理引擎,通过深度优化让普通显卡也能高效运行大模型。其核心创新包括Megakernel技术(Qwen3.5-0.8B单内核加速)和DFlash优化(24GB显存即可运行27B模型),在RTX3090上实现207.6tok/s的惊人速度。项目采用C++编写,支持128K长上下文,比传统方法快3-5倍,且能效提升2倍以上。安装只需克隆GitHub仓库、编译代码、下载模型即可快速体验。未来规划包括更多硬件优化和正式版发布,致力于让本地AI不再是高端用户的专利。

飞翔的SA 624

中文微调版llama3来了,附ollama部署方法

在人工智能的浩瀚星空中,刚发布不久的Llama 3如同一颗璀璨的星辰,以其强大的能力照亮了智能对话的未来。然而,即便是如此耀眼的存在,也因为某些不可说的原因在中文世界面前显得有些力不从心。但现在,一道曙光划破了这片迷雾——中文微调版的Llama 3正式登场,它的地址是:https://github.com/ymcui/Chinese-LLaMA-Alpaca-3。这个版本并非官方出品,因此,我们不能直接使用ollama进行下载。但别担心,魔搭社区为我们提供了下载的途径。

xiangxueerfei的博客 1834

Matlab实现使用遗传算法的混合能源系统优化.rar

Matlab实现使用遗传算法的混合能源系统优化.rar

ubuntu 本地部署体验Llama3的中文微调模型Llama3-Chinese-8B-Instruct

ubuntu 本地部署体验Llama3的中文微调模型Llama3-Chinese-8B-Instruct

huachangzai的博客 3396

基于斜坡补偿的Buck电路峰值电流+电压电流双闭环控制【附说明文档】(Simulink仿真实现)优快云首页发布文章优快云同步助手LLC谐振变换器开环+闭环软启动仿真设计(Simulink

内容概要:本文围绕三电平VIENNA整流器的双闭环控制与中点电位平衡问题展开仿真研究,提出了一种基于上下电容电压差值补偿的中点电位平衡策略。该策略在传统电压电流双闭环PI控制的基础上,引入电容电压差值作为反馈信号,通过SVPWM调制中冗余小矢量的时间分配实现中点电荷的定向调节,从而在不改变主控制结构的前提下有效抑制中点电位偏差。仿真结果表明,该方法不仅确保直流母线电压稳定跟踪800V给定值,还能显著提升上下电容电压的均衡度,同时保持输入电流低谐波水平,验证了控制策略的可行性和有效性。; 适合人群:电力电子、电气自动化及相关专业的研究生、科研人员及工程技术人员,具备一定的MATLAB/Simulink仿真基础和电力电子拓扑知识背景者更佳。; 使用场景及目标:①掌握三电平VIENNA整流器的工作原理与中点电位波动的成因;②理解电压电流双闭环PI控制的设计要点与参数整定原则;③学习基于差值补偿的中点电位平衡控制策略及其与SVPWM的协同机制;④应用于充电桩、航空电源、通信电源等中大功率单向整流场合的控制系统设计与优化。; 阅读建议:建议结合文中提供的仿真模型与参数设置进行动手实践,重点关注中点电位平衡投入前后电容电压波形的变化,对比分析不同工况下的系统动态响应,深入理解控制策略的作用机理。同时可进一步探索在电网不平衡、轻载等复杂工况下的控制性能,以拓展应用场景。

自适应多机器人编队规划,以包围和跟踪具有运动和可见性约束的目标(Matlab代码实现)

内容概要:本文针对“自适应多机器人编队规划,以包围和跟踪具有运动和可见性约束的目标”开展研究,提出一种基于Matlab的仿真方法,实现多机器人在动态环境中对移动目标的协同包围与持续跟踪。该方法综合考虑了机器人的运动学约束与传感器的视线(visibility)限制,设计了分布式控制策略与自适应编队算法,能够在复杂环境下有效维持编队结构的稳定性和任务执行的鲁棒性。研究详细阐述了系统建模过程、控制律设计原理、编队形成与保持机制,并通过Matlab代码实现了完整的仿真验证,展示了算法在不同动态场景下的适应能力与性能优势; 适合人群:具备机器人学、自动控制理论、多智能体系统等相关基础知识,熟悉Matlab编程语言,从事智能系统、协同控制、路径规划与自主导航等方向的研究生、科研人员及工程技术人员; 使用场景及目标:①应用于安防监控、环境探测、灾害救援等场景中的多机器人目标围捕与跟踪任务;②为多智能体协同控制、分布式编队保持、避障与可见性维护等关键技术提供可复现的算法框架与仿真平台;③辅助高校与科研机构在相关领域的教学演示与科研创新,深化对自适应控制与分布式协同机制的理解; 阅读建议:建议读者结合提供的Matlab代码逐模块分析其实现逻辑,重点关注控制律设计、约束处理与自适应机制部分,可通过调整机器人数量、目标轨迹、传感器参数等进行扩展性实验,以深入掌握多机器人协同系统的动态行为与优化方法。

保姆级指南:轻松部署最强开源语言大模型Llama3及中文微调版!

2.1。

m0_63171455的博客 1216

patch_1.23.0.2584_game_No6.android.pak

patch_1.23.0.2584_game_No6.android.pak

GGML 或GGUF的14种不同量化模式说明

将 Q5_K 用于 attention.wv、attention.wo 和 feed_forward.w2 张量,否则Q3_K。:将 Q4_K 用于 attention.wv、attention.wo 和 feed_forward.w2 张量,否则Q3_K。:将 Q4_K 用于 attention.vw 和 feed_forward.w2 张量,Q2_K用于其他张量。:将 Q6_K 用于一半的 attention.wv 和 feed_forward.w2 张量,否则Q5_K。:将Q5_K用于所有张量。

顺其自然~专栏 1883

状态估计【卡尔曼滤波kalman】UKF、EKF、粒子滤波PF学习与研究(Matlab代码实现)

内容概要:本文系统地研究了无迹卡尔曼滤波(UKF)、扩展卡尔曼滤波(EKF)和粒子滤波(PF)在非线性系统状态估计中的理论基础与实际应用,并结合Matlab代码实现进行了深入剖析。内容涵盖三种滤波算法的核心原理、数学推导及其在轨迹估计等工程问题中的具体实施方法。通过详尽的Matlab编程实例,展示了如何利用这些先进滤波技术解决如目标跟踪、传感器融合等复杂问题,并特别探讨了BP神经网络与EKF结合的优化训练策略以及粒子滤波在提高状态跟踪精度方面的潜力。该资料为希望掌握现代状态估计算法的研究人员和技术爱好者提供了一套完整的理论与实践指南; 适合人群:具备一定编程基础,尤其是熟练使用Matlab工具,且对控制理论、信号处理或相关工程技术领域有初步了解的研发人员和高校学生; 使用场景及目标:① 深入理解UKF、EKF和PF的基本概念及其在非线性动态系统中进行状态变量估计的应用;② 通过Matlab代码实践加深对各滤波器工作机制的理解,能够独立开发相应的算法以应对诸如轨迹预测、多源信息融合等实际挑战;③ 探索将BP神经网络与EKF相结合的新途径,以期提升模型的学习效率和预测准确性; 阅读建议:此资源不仅提供了坚实的理论支撑,还包括丰富的代码示例,建议读者按照文档结构循序渐进地学习,同时动手实现每一个案例,以便更深刻地把握各种滤波技术的关键细节。对于致力于深入研究状态估计领域的专业人士而言,这是一份极具价值的学习材料。

DXF、DWG工程制图文件查看器

DXF、DWG工程制图文件查看器。 可以在界面中进行测量(包括距离、面积、角度等等) 无需版权,放心使用。

本地大模型部署指南:16G/32G/64GB内存配置全解析(附最新模型速查表)

本文针对不同内存配置(16GB/32GB/64GB)提供了本地大模型选型指南。16GB设备推荐2B-9B量级模型如Qwen3.5 9B,32GB可运行27B-35B级别模型如Qwen3.5 27B,64GB则能驾驭70B级旗舰模型和视觉多模态应用。文章详细列出了各场景下的最优模型组合,并解释了GGUF量化等级的选择策略,帮助用户根据硬件条件平衡模型性能与推理质量。

爱学习的程序员 4429

iStore增强插件 如何重塑家庭网络与存储体验

本文深入解析了iStore增强插件如何重塑家庭数字生活体验。它通过集成智能流控、一键式文件共享、媒体服务器及智能家居网关等功能,将复杂的网络配置、存储管理与设备协同简化为图形化操作,有效解决了家庭网络卡顿、数据割裂与使用门槛高等核心痛点,让普通用户也能轻松打造高效、稳定、安全的家庭数字中枢。

prometheus9mon的博客 652

Qwen3.6-27B-GGUF量化怎么选?IQ4_XS、Q4_K_M、Q6_K、Q8_0与UD系列全对比清单

**Qwen3.6-27B-GGUF 量化怎么选?** 本文面向新手,用一张清单讲清楚 Qwen3.6-27B 全部 20+ 种 GGUF 量化格式:IQ4_XS、Q4_K_M、Q5_K_M、Q6_K、Q8_0 与 Unsloth UD 动态量化系列各自适合多大的显存、损失多少效果、该怎么下载,帮你一次选对不踩坑。 ## 📌 30秒速查:按显存选量化 不知道选哪个?直接对号入座: | 你的

gitblog_00175的博客 170

Axure RP9汉化+授权全攻略:从下载到激活一步到位(附最新授权码)

本文提供Axure RP9从下载安装到界面汉化的完整指南,帮助设计师和产品经理快速上手这款原型设计工具。详细讲解了如何安全获取软件、执行汉化操作、理解核心界面布局,并介绍了创建交互原型和生成HTML文件的基础步骤,助力用户高效开展设计工作。

cuda7parallel的博客 1150

IGBT单管并联方案全解析:从均流设计到热管理实战技巧

本文深入解析了IGBT单管并联技术在新能源车电驱系统中的应用,重点探讨了均流设计与热管理实战技巧。通过优化寄生电感控制、动态均流和驱动电路设计,提升系统稳定性和效率,为工程师提供了一套完整的解决方案。

weixin_28720573的博客 442

千问3.5-27B模型量化实践:降低OpenClaw运行成本

本文介绍了如何在星图GPU平台上自动化部署千问3.5-27B量化镜像,显著降低OpenClaw运行成本。通过4bit/8bit量化技术,该镜像在保持模型可用性的同时减少60%显存占用,适用于个人开发者的日常AI任务处理、代码生成等场景,实现高效能低成本的大模型应用。

weixin_33670640的博客 453

Sentence-BERT 语义相似度双塔模型

论文介绍 发表:2019,EMNLP 论文题目:《Sentence-BERT:sentence embeddings using siaese BERT-networks》 论文地址:https://arxiv.org/abs/1908.10084 Github:https://github.com/UKPLab/sentence-transformers 适用领域: 句向量生成 语义相似度计算 语义搜索 无监督任务(聚类) 1 概述 在20年之前的各种预训练模型中,比如bert,XLNet,Alb

weiyaner的博客 9195

RTX5060TI 16G运行大语言模型的速度实测 (Qwen3)

测试了RTX5060TI在大预言模型推理方面的性能

weixin_45737474的博客 9989

从ISCXTor2016到CICIDS2017:手把手教你下载和使用UNB的网络安全数据集

本文详细介绍了UNB大学发布的ISCXTor2016和CICIDS2017等网络安全数据集的下载与使用方法,特别适合加密流量识别和网络行为分析研究。文章提供了多种高效获取路径、文件结构解析及实战分析示例,帮助研究者快速上手这些真实场景捕获的精细标注数据集。

weixin_42524945的博客 641

云服务器安装ros教程

要在 CentOS 7 系统上安装 RouterOS,您需要将 RouterOS 安装为虚拟机或直接安装到物理硬盘上。这里提供的是将 RouterOS 安装到物理硬盘上的步骤,这将完全替换现有的 CentOS 7 系统。请确保您已经备份了所有重要数据。

qq_37662563的博客 2146

llama.cpp数据格式:BF16/F16/Q8_0量化对比

在大语言模型(Large Language Model,LLM)部署过程中,模型大小和推理速度是两个关键瓶颈。一个70B参数的模型在FP32精度下需要约280GB存储空间,这远远超出了大多数消费级硬件的承载能力。量化技术通过降低数值精度来压缩模型大小,同时保持可接受的性能损失,成为解决这一问题的关键技术。 llama.cpp作为领先的C/C++ LLM推理框架,支持多种量化格式,其中BF16(B...

gitblog_00128的博客 2089

零基础实战:云开发家政维修小程序搭建指南

欢迎来到这本关于构建家政维修小程序的电子书!在当今数字化的浪潮中,线上服务已成为我们生活中不可或缺的一部分。从点餐购物到居家维修,人们越来越习惯通过指尖轻点来解决各种需求。正是基于这样的背景,我们希望通过这个系列,手把手地带领大家从零开始,搭建一个功能完备、体验流畅的家政维修平台。这不仅仅是一本技术教程,更是一次将想法变为现实的探索之旅。我们将深入浅出地讲解如何运用云开发等现代技术,实现从用户下单、支付,到客服派单、工人接单,再到订单完成和权限管理等一系列核心业务流程。

低代码布道师的博客 3434

新手必看:Qwen3.6-27B-TQ3_4S模型文件与chat_template.jinja配置指南

Qwen3.6-27B-TQ3_4S是基于Qwen3.6-27B基础模型优化的TurboQuant量化版本,专为本地部署设计,以GGUF格式提供高效运行体验。本文将详细介绍模型文件组成、核心功能特性及chat_template.jinja配置方法,帮助新手快速上手使用这一强大的开源模型。 ## 模型文件核心组成 Qwen3.6-27B-TQ3_4S项目包含以下关键文件,各组件协同实现模型的完整

gitblog_00389的博客 572

Android 12 大屏时底下显示任务栏以及虚拟按键靠右问题

Android 12 点大屏时,底下导航栏变成显示任务栏,虚拟按键靠右的分析以及修改

Android系统开发笔记 4687

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Qwen3.6-27B-OBLITERATED模型量化详解:Q4_K_M到Q8_0的完整对比

Qwen3.6-27B-OBLITERATED是一款由OBLITERATUS团队基于Qwen3.6-27B开发的高性能开源大语言模型,通过权重空间优化技术显著降低了拒绝行为,同时保持了270亿参数级别的强大能力。本文将深入解析该模型提供的Q4_K_M、Q5_K_M、Q6_K和Q8_0四种GGUF量化版本,帮助用户根据自身需求选择最适合的本地部署方案。 ## 为什么选择量化版本? 量化是将模型权

gitblog_00648的博客 507

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

上一篇: 揭秘 Intel 8087 浮点芯片加法器:69 位运算提速 100 倍,性能优化有何奥秘?
下一篇: 开源可编程科学计算器 C47 与实体计算器 R47:社区驱动,RPN 计算高效有趣!
IT界那些事儿
博客等级 码龄6年 2万+粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值