


梁文锋点明核心问题,研发逻辑转变
梁文锋2024年谈到融资时表示:“我们面临的问题从来不是钱,而是高端芯片被禁运。”模型公司通常聚焦数据、算法和人才,芯片多为成本项,而非战略项。而DeepSeek将芯片视为核心问题,意味着其从一开始就关注如何在算力受限的情况下重建运行体系。回溯其技术创新,从MLA到MoE,从FP8训练到极致推理效率,都是为了用更少、更受限的算力做出顶级模型,这体现了从模型公司到基础设施公司的研发逻辑转变。若DeepSeek并非传统模型公司,其定价和参考对象也需重新考量,此次融资结构或能提供判断思路。
融资背后的多重逻辑
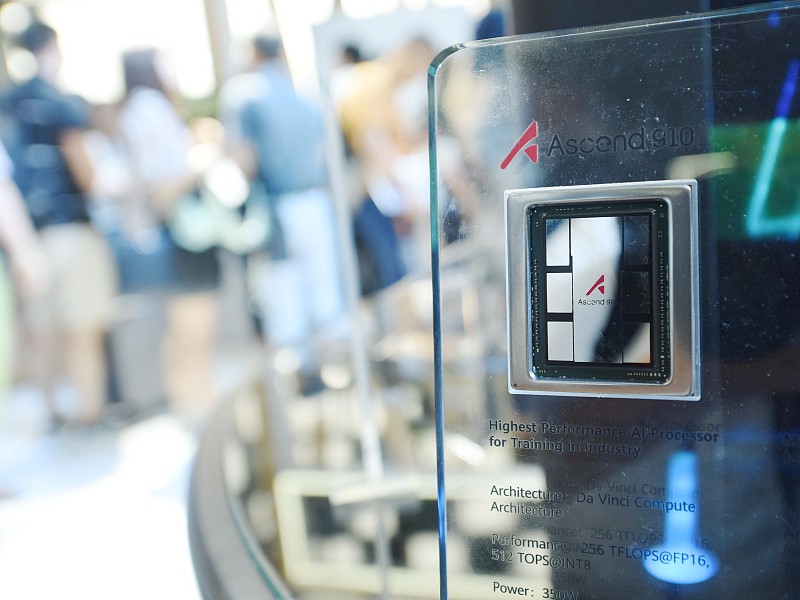
4月24日,DeepSeek - V4发布,技术报告首次将华为昇腾NPU和英伟达GPU纳入同一硬件验证清单,万亿参数级模型首次在正式文档中完成对国产AI芯片的官方认定。发布当天,8家国产芯片完成适配,打破数月调试惯例。据悉,DeepSeek团队为此与华为及寒武纪密切合作,甚至推迟发布计划。融资在此期间启动,与其他公司为做事而融资不同,DeepSeek是因事已做成且可公开验证而融资,梁文锋用模型发布完成了尽职调查。此次融资有三笔钱,三种逻辑。大基金(全称国家集成电路产业投资基金)作为半导体行业重要的国家级产业资本,历史上投资中芯国际、长江存储等半导体基础设施,此前未涉足大模型公司。DeepSeek V4用国产芯片适配证明其非传统模型公司,让大基金可从国产算力生态战略节点角度投资,构建“国产芯片 + 国产模型”自主闭环。传言中腾讯等产业资本入股,是为避免被排除在中国AI基础设施之外,因其能带来生态入口、企业客户和云资源,恰是DeepSeek商业化短板。而其他有基础设施野心的大厂可能不入股,因DeepSeek已被视为潜在基础设施竞争对手。
融资结构的“割裂”特质
此次融资带来“割裂”感,一边锁定国家战略资本确认基础设施身份,一边引入产业生态资本打开商业化入口,二者通常矛盾,但DeepSeek试图让其独立运转。融资后,商业化进展与宏大叙事互不影响。大基金对应的是长期的算力自主、国产芯片生态命题,无需季度回报;腾讯等产业资本对应的商业化节奏可紧跟其他模型公司。人们讨论其商业化困境时,常忽略DeepSeek API定价击穿行业底线,V4 - Flash缓存命中输入低至0.02元/百万词元,综合成本仅为GPT - 5.5的1%左右,推理成本低使其API业务不亏钱。a16z报告显示,DeepSeek跨越中美用户分布,网页流量在中国(33.5%)、美国(6.6%)分布,移动端用户基本盘未崩塌,理论上能跟上其他模型公司的赚钱方式且边际成本更低。这种“割裂”特质从幻方时代就存在,幻方量化赚钱,DeepSeek做研究,双方无需互相证明商业回报。但这种依赖个人意志的“割裂”较脆弱,此次融资将其固化到股权结构中。梁文锋个人出资最高200亿元人民币(约28亿美元),远超月之暗面Kimi刚完成的20亿美元融资。外部资本进入并非为让DeepSeek作为模型公司“活下去”,而是因其不再是传统模型公司,梁文锋的出资确保了核心决策不被稀释。
人才流失情况或被夸大
外界曾认为此次融资的最大原因是人才流失,但实际情况可能被夸大。王炳宣、郭达雅、罗福莉、阮翀等核心技术人员离职,但根据《财经》数据,27篇论文高频出现的15人里仅2人离职,DeepSeek - LLM发布时的86人中有71人出现在V4论文名单中,300人走10个,离职率3.3%,这在AI公司人才争夺中是较低水平。期权定价对留人有价值,但这是融资顺带解决的问题,DeepSeek做正确长期的事,能顺带解决留人等眼前问题。
竞争对手与估值逻辑
要理解DeepSeek的融资和估值逻辑,需明确其竞争对手。英伟达定义了AI时代算力规则,所有模型公司都受其限制,而DeepSeek试图重新划定边界,V4昇腾适配落地验证了这一点,其最在意英伟达。DeepSeek 500亿美元估值并非基于当前模型能力、ARR或用户规模。全球可比模型公司中,Kimi融资后估值约200亿美元且有真实ARR支撑,Anthropic上一轮投后估值3800亿美元且年化收入已在2026年初突破300亿美元。DeepSeek商业化收入基本为零,但估值超Kimi两倍,且资金主要来自半导体国家基金,而非成长型VC。从投资人结构看,差价源于基础设施溢价。若DeepSeek建成不依赖英伟达的前沿AI算力体系和中国AI基础设施,其比较对象介于星际之门版的OpenAI和英伟达之间,全球暂无类似公司。从这个角度看,500亿美元估值虽破纪录但仍可能被低估。此次融资定价的是未发生之事,能否实现取决于梁文锋,从幻方到DeepSeek的路径看,他长期主义执行彻底,做正确长期的事能自然解决具体问题,这轮融资或让外界首次看到其完整轮廓。
 999


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


