


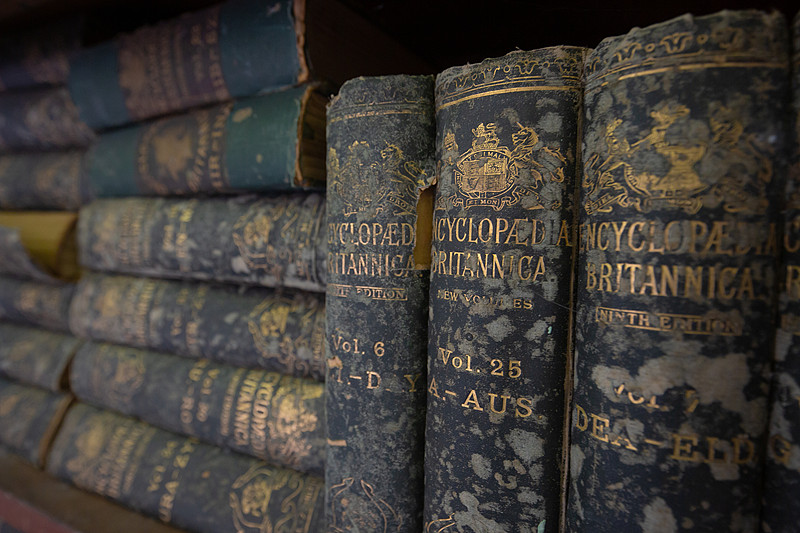
《大英百科全书》及其子公司韦氏词典起诉OpenAI,指控其未经许可使用《大英百科全书》的内容来训练AI模型。诉讼指出,OpenAI的聊天机器人ChatGPT复制了《大英百科全书》受版权保护的内容用于训练大语言模型,其针对用户查询提供的叙述性回复,常常逐字或近乎逐字地复制、总结或缩写原始内容,包括《大英百科全书》受版权保护的作品。
《大英百科全书》和韦氏词典的这起诉讼延续了内容所有者起诉AI公司侵犯版权的趋势。此前,CNET的母公司Ziff Davis于2025年起诉了OpenAI,指控其在训练和运行AI系统时侵犯了版权。《大英百科全书》去年还起诉了Perplexity,该案件目前仍在审理中。这表明内容所有者维护自身版权的意识在不断增强,对AI公司使用受版权保护内容的行为愈发关注。
针对这起新诉讼,OpenAI一位发言人通过电子邮件表示,其模型推动了创新,是基于公开数据进行训练的,并且符合合理使用原则。然而,《大英百科全书》方面认为,基于ChatGPT的产品对其内容的总结会分流流量,而且OpenAI“未经授权或支付报酬就复制网络出版商受版权保护的内容”。
去年,Anthropic和Meta在基于合理使用原则的诉讼中胜诉,该原则允许它们在未经创作者许可的情况下使用受版权保护的内容。这一案例为AI公司在版权使用方面提供了一定的参考,但也引发了关于合理使用原则在AI领域应用的争议。此次《大英百科全书》起诉OpenAI的案件,将进一步考验合理使用原则在AI版权纠纷中的适用性。
编辑观点:这起诉讼凸显了AI发展中版权保护的重要性。随着AI技术的不断进步,如何平衡创新与版权保护成为关键。此次诉讼结果将对AI行业的版权使用规则产生深远影响,推动行业在合规的道路上不断探索。
 20


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


