IP欺诈风险查询+动态信用分模型:如何作为特征融入用户信用分

机器学习模型上线后的系统性风险与防御实践 机器学习模型部署不是终点,而是进入真实分布式系统的起点。当模型脱离Jupyter沙盒,它便成为依赖特征服务、网络链路、上下游契约的活体组件,其稳定性不再由AUC等离线指标决定,而取决于系统工程能力——包括特征漂移检测、输入Schema校验、fallback降级机制、延迟归因分析与多维健康监控。尤其在金融风控等高敏场景中,数据契约断裂、训练-推理不一致、依赖绑架等系统性问题,远比模型精度缺陷更常引发线上故障。本文聚焦MLOps中被长期低估的‘生产可靠性’维度,结合27个线上模型实战案例,拆解如何构建具备确定性 阅读详情

大部分风控系统对查IP欺诈结果的使用止步于“实时拦截”——评分高于阈值就拒绝,低于阈值就放行。这浪费了IP风险数据80%的价值。它本应进入用户画像,成为动态信用分的一个特征维度,而非一次性消费品。

一、IP风险数据作为特征的三个独特价值
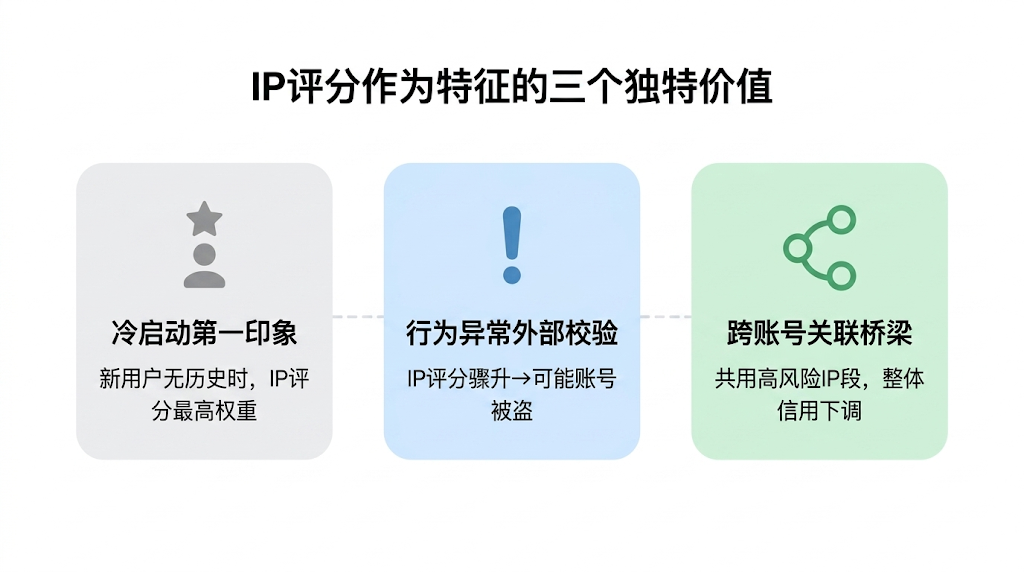
三列卡片图,展示IP风险数据冷启动、行为校验、跨账号关联三大价值

价值一:冷启动时的“第一印象”
新用户没有行为历史时,IP风险信号是最高权重的特征。一个新注册账号,如果其IP被标记为“数据中心”且带有“垃圾注册”风险标签,即便尚未产生任何异常行为,其信用基线也应显著低于来自住宅IP的新用户。

价值二:行为异常的“外部校验”
当用户行为看似正常但IP风险等级骤升(如从低风险变为高风险),可能是账号被盗的信号——攻击者正在使用代理IP登录。IP风险数据作为外部信号,可以校验行为特征的可信度。

价值三:跨账号关联的“隐形桥梁”
多个账号共用同一个高风险IP段,即使各自行为正常,整体信用也应下调。风险数据能揭示账号之间隐藏的关联关系,这是单一行为分析无法做到的。

二、特征工程:IP风险数据如何进入信用分模型

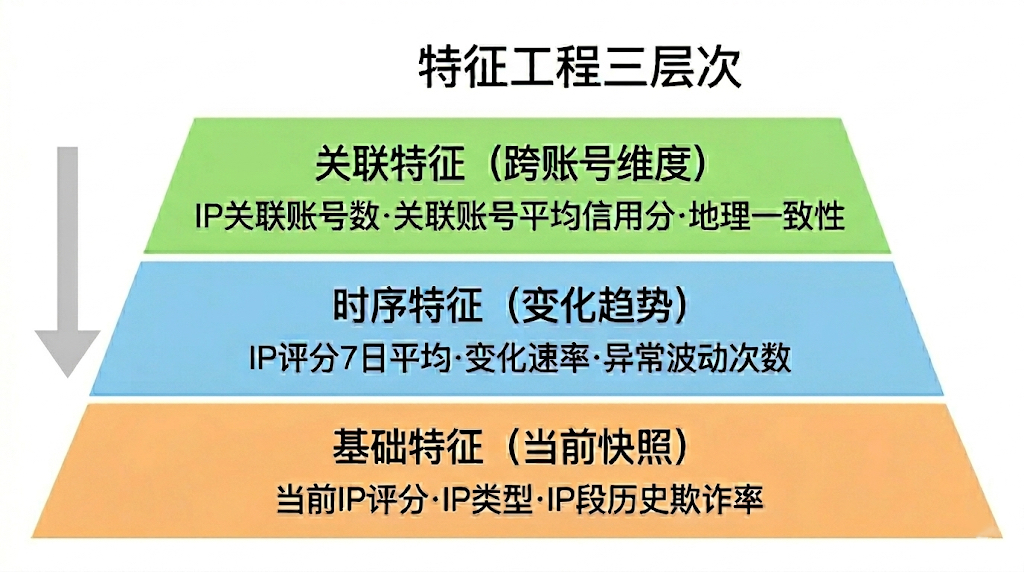
将IP查询结果转化为可供模型使用的特征,至少需要三个层次:

基础特征(当前快照)

  • 当前IP风险等级(如低/中/高)

  • IP类型:住宅/数据中心/代理/移动

  • IP段历史欺诈率:该/24网段过去30天的欺诈账号占比

时序特征(变化趋势)

  • IP风险等级7日滑动平均:反映近期IP质量稳定性

  • 风险等级变化速率:如从低到高所需天数

  • 异常波动次数:单日波动超过两级的次数

关联特征(跨账号维度)

  • 该IP曾关联的账号数量

  • 关联账号的平均信用分

  • IP归属地与用户常用地的地理一致性(经纬度距离)

分层金字塔图,从基础特征到时序特征到关联特征,特征工程

每次请求时更新风险历史,信用分随每次行为实时计算。冷启动依赖基础特征,外部校验依赖时序特征,跨账号关联依赖关联特征。以IP数据云的风险画像为例,其返回的risk_score、net_type、risk_tags、location等字段可直接用于上述特征提取,无需额外加工。

三、实战案例:某社交平台的信用分演进

某社交平台经历了三个阶段:

阶段一:仅用IP风险数据做注册拦截,高风险直接拒绝。拦截率尚可,但误报率较高,大量真实用户被误拦。
阶段二:将IP风险数据作为特征存入用户画像,结合行为数据构建信用分模型。不再单一拦截,而是给每个用户一个动态信用分。

代码示例:IP特征提取(伪代码)

def extract_ip_features(user_id, current_ip, api_key):
    # 调用IP数据云API获取当前IP画像
    ip_info = ipdatacloud_api.query(current_ip, api_key)
    features = {
        'ip_risk_level': encode(ip_info['risk_level']),  # 低/中/高
        'ip_type': encode(ip_info['net_type']),          # 住宅/IDC/代理
        'ip_segment_fraud_rate': query_redis(f'/24/{ip_info['segment']}'),
        'ip_risk_trend': get_user_attr(user_id, 'ip_risk_trend_7d'),
        'ip_risk_change_rate': calc_change_rate(user_id),
        'ip_account_count': get_ip_accounts(current_ip),
        'geo_distance': calc_distance(ip_info['location'], user_home)
    }
    return features

阶段三:用信用分驱动差异化体验——高信用分用户免验证、中信用分正常验证、低信用分限制功能并加强监控。

结果:欺诈账号识别率从72%提升至91%,误报率从5.2%降至1.8%,高信用用户投诉量下降60%。IP数据云的IP画像数据在此过程中提供了稳定、连续的特征输入,支撑了模型的持续迭代。

四、结语

查询IP欺诈风险的真正价值不在“拦住坏人”的瞬间,而在“认识用户”的长期过程中。它不是终点决策,而是用户信用画像的一块积木。当风险数据进入特征工程、融入动态模型,它的价值才能被充分释放——从一次性消费品,升级为可持续的数据资产。

模型上线不是终点:生产环境中的系统性风险与治理实践 机器学习模型部署并非简单封装为API,而是将其嵌入复杂业务系统后的全生命周期工程。从特征供给稳定性、协议兼容性到熔断降级策略,每一个环节都可能成为故障源头。在金融等强监管场景中,模型必须具备时间确定性、结果一致性与可审计性,同时支持漂移检测、决策溯源和合规解释。本文聚焦模型在生产环境中的真实挑战——如特征空值率突增、gRPC/HTTP协议不匹配、重试导致重复计费等高频问题,并提供可落地的集成验证清单、五维监控矩阵与影子模型兜底方案,助力AI系统实现从‘能跑通’到‘可信赖’的关键跃迁。 阅读详情

相关推荐

生产级机器学习系统:从模型部署到鲁棒运维的完整实践

机器学习系统在真实场景中面临的挑战,远不止模型准确率——它本质是一个融合数据管道、服务治理、可观测性与合规要求的复杂软件系统。理解‘模型即服务’(MaaS)的接口契约、特征新鲜度保障、多级熔断降级机制及决策可追溯性设计,是构建高可用AI系统的前提。尤其在金融、支付等强实时、高后果领域,系统鲁棒性直接决定业务连续性;而PSI漂移检测、Failure Design思维和Decision Provenance等工程实践,则将ML运维从被动救火升级为预测性治理。本文聚焦于让模型真正‘活’在生产环境中的关键能力。

weixin_30263073的博客 359

机器学习模型上线后如何应对系统性风险与工程集成挑战

机器学习模型部署不是算法落地的终点,而是跨系统、跨团队的工程集成起点。其核心在于理解模型服务在真实业务流中的行为逻辑:从特征时效性、接口契约、错误容忍到资源隔离与弹性降级。技术价值体现在将不确定性转化为可监控、可回滚、可审计的确定性系统能力;典型应用场景覆盖金融风控、电商大促、保险理赔等高并发、强合规、低延迟领域。本文聚焦生产环境中模型与上下游系统的耦合治理,深入探讨特征漂移检测、决策链路追踪、混沌压测及审计就绪设计等关键实践。

weixin_33795093的博客 534

偏差-方差权衡实战诊断:工业级模型性能瓶颈定位与干预

偏差-方差权衡是机器学习泛化能力的核心基础概念,其本质源于模型复杂度与数据分布之间的动态张力。理解偏差(系统性欠拟合)与方差(噪声敏感型过拟合)的耦合机制,是提升模型鲁棒性的关键前提。在真实工业场景中,二者常被数据噪声、概念漂移和不合理的交叉验证所掩盖,导致调参失效、线上指标崩塌。掌握基于训练/验证/测试三曲线对比、学习曲线分析、预测分布直方图及特征重要性漂移检测的四步诊断法,可快速识别高偏差、高方差或噪声主导型失衡,并针对性实施特征工程优化、正则化动态调节或数据质量治理。本文聚焦金融风控、电商推荐与IoT

weixin_30263277的博客 437

Gemini数据科学Agent:重构特征工程与模型闭环的工作流

数据科学工作流长期受限于低效的手动操作,核心瓶颈在于数据探查、特征工程和模型验证三大环节。其本质是统计原理与业务语义未能被系统化编码为可执行逻辑。Gemini Data Science Agent通过意图理解优先、端到端闭环设计和原生可解释性,将因果推断、PSI漂移检测、SHAP归因等关键技术深度嵌入工作流,显著提升建模效率与业务对齐度。它适用于需快速响应业务需求、处理高维异构数据、并保障模型稳定上线的实战场景,尤其在电商复购预测、金融风控、工业设备预测等强时序与强解释性要求领域展现出工程落地优势。

cixu3288的博客 414

模型服务化实战:从Notebook到高可用生产环境

模型服务化(Model Serving)是机器学习落地的关键环节,指将训练完成的模型封装为稳定、低延迟、可观测的API服务。其核心原理在于解耦特征计算与模型推理,统一采用ONNX等标准化格式,并依托Kubernetes+Triton等基础设施实现资源弹性与持续交付。技术价值体现在提升上线效率、保障服务SLA、支持数据漂移监控与快速回滚。典型应用场景包括金融实时风控、电商个性化推荐和IoT设备预测。本文聚焦真实工程中模型加载预热、请求流水线编排、三维可观测性建设及MLOps CI/CD落地细节,覆盖模型服务化

weixin_33834075的博客 593

AI赋能自动化查询:智能模拟人类行为应对谷歌检测机制

自动化查询是数据采集、市场分析和SEO监控等领域的基础技术,其核心原理在于通过程序模拟用户行为以获取网络公开数据。传统方法依赖硬编码规则,如设置请求头、代理IP池和随机延时,但在面对谷歌等平台日益智能的检测机制时,其维护成本高且易失效。AI技术的引入,特别是大语言模型和智能代理,为这一领域带来了技术价值的跃升。通过行为建模、浏览器环境仿真和语义理解导航,AI能够更智能地模拟人类的流量模式、交互行为和会话上下文,从而提升自动化过程的适应性与隐蔽性。这种AI增强的方法主要应用于合规的学术研究、公开价格监控和舆情

weixin_34210740的博客 345

智能体AI集成异常检测:实现主动风险管理的架构与实战

异常检测作为数据分析和机器学习领域的基础技术,其核心原理是通过识别数据中偏离正常模式的观测值,来发现潜在的问题或风险。在工程实践中,将异常检测能力深度集成到智能体(Agentic AI)的决策循环中,能够赋予AI系统主动的风险感知与干预能力,实现从被动响应到主动预警的范式升级。这种技术融合在金融风控、工业运维、网络安全等对稳定性要求极高的场景中具有重要价值,能够将风险管理从事后补救推向事中干预甚至事前预防。本文以智能体AI集成异常检测为例,探讨了如何通过双循环决策架构、轻量级模型选型及动态阈值调优等工程方法

weixin_30411239的博客 309

ML模型生产化:从 notebook 到高可用决策系统的实战指南

机器学习模型部署不是终点,而是系统性工程挑战的起点。当模型脱离训练环境进入真实业务系统,其核心诉求从‘预测精度’转向‘运行韧性’——这涉及特征服务稳定性、训练与推理的一致性假设、多层集成链路的容错设计,以及人在环路中的责任映射。在金融、支付等强监管场景中,模型的可审计性、决策可追溯性与故障自愈能力,直接决定业务连续性与合规底线。本文基于真实生产事故复盘,深入拆解模型服务的三明治架构、四维压测方法、三级监控预警及夜间告警SOP,聚焦‘如何让模型在噪声、延迟与人为异常中持续输出可信决策’这一根本命题。

weixin_33871366的博客 428

机器学习模型上线:从 notebook 到生产系统的工程化落地

机器学习模型部署不是算法任务的终点,而是分布式系统工程的起点。其核心在于将模型嵌入真实业务流,保障低延迟、高可用、可审计与强治理。模型上线需应对特征供给稳定性、服务契约定义、实时性约束(如P99延迟)、数据漂移检测及合规可解释性等关键挑战。尤其在金融风控、信贷审批等强监管场景中,模型必须具备故障降级、决策溯源、人工否决与自动归因能力。本文聚焦模型生产化中的工程实践、监控体系与治理闭环,覆盖从特征管道重构、gRPC性能优化到PSI漂移响应、审计友好日志设计等真实落地要素。

weixin_34268169的博客 407

生产级机器学习系统:从模型部署到责任落地的四大支柱

机器学习模型上线并非开发终点,而是进入真实业务场景的起点。其核心挑战在于将单点算法正确性,扩展为涵盖服务可用性、行为可预测性、治理可追溯性的全链路系统韧性。尤其在金融等强监管领域,特征管道断裂、接口契约缺失、数据漂移未监控、压力场景未验证等问题,远比模型精度更常引发线上故障。因此,构建生产级ML系统需以‘集成即契约’为前提,依托弹性推理管道、分层监控与漂移检测、多级降级协议及审计就绪治理框架,实现模型从‘能运行’到‘可信赖、可问责、可持续’的跃迁。

weixin_33724046的博客 396

生产级机器学习系统:从模型上线到持续可靠运行

机器学习模型部署不是终点,而是系统性工程挑战的起点。其核心在于将算法嵌入真实业务链路后,如何保障数据输入稳定性、服务响应确定性、故障恢复可预期性及决策结果可审计性。本文聚焦ML系统在延迟敏感场景(如实时风控、推荐)下的性能韧性构建,涵盖特征SLA契约、混沌工程验证、漂移检测与自动化响应、多维健康监控及治理元数据闭环等关键技术实践,强调‘模型即服务’需以工程化思维贯穿全生命周期。

weixin_33834628的博客 447

生产级机器学习系统:从模型上线到稳定运行的工程实践

机器学习模型部署不是终点,而是进入复杂业务系统的起点。在金融、电信等强集成场景中,模型健康度由端到端延迟、特征一致性、依赖稳定性及监管可解释性共同定义,而非孤立的AUC或F1指标。本文聚焦Production ML核心挑战——数据漂移检测、特征管道治理、熔断降级机制与全链路监控,结合银行风控等真实案例,解析如何构建具备可观测性、可回滚性与合规韧性的ML服务。关键词涵盖模型监控、特征一致性、延迟预算、熔断降级、数据漂移检测,直击MLOps落地中最易被忽视却最致命的系统性风险。

weixin_30252709的博客 455

机器学习生产化:从模型上线到系统韧性建设

机器学习模型部署不是简单封装为API,而是将算法深度嵌入真实业务系统的过程。其核心在于理解模型推理、特征获取、服务编排与业务规则之间的耦合关系,解决数据漂移、特征延迟、依赖故障等典型生产问题。技术价值体现在保障毫秒级决策稳定性、构建可审计的fallback机制、实现自动漂移检测与闭环治理。典型应用场景覆盖金融风控、保险核保、电商推荐等高可靠性要求领域。本文聚焦于生产环境中模型‘如何呼吸、受伤与自愈’的工程实践体系。

weixin_34023982的博客 294

让机器学习模型真正落地:银行级ML生产化四大支柱

机器学习模型从开发到上线,本质是从静态数学对象向动态业务系统的演进。其核心挑战不在于算法精度,而在于系统集成能力、毫秒级性能保障、全链路可观测性以及符合强监管要求的模型治理。在银行业等高可靠性场景中,特征供给韧性、决策链路安全网、实时漂移检测、可审计的决策解释等能力,已成为生产就绪(Production Readiness)的刚性门槛。本文聚焦ML系统工程化实践,深入解析集成、性能、可观测、治理四大支柱如何协同构建稳定、可信、可追溯的AI服务,为金融、电商、风控等关键业务提供可复用的落地框架。

weixin_34095889的博客 458

STM32实战:手把手教你移植CanFestival协议栈(附完整代码)

本文提供了一份详尽的STM32平台移植CanFestival协议栈的实战指南。文章从工程搭建、定时器驱动、CAN硬件适配到对象字典配置,手把手讲解核心步骤,并附完整代码示例。重点剖析了时间管理、报文收发等关键环节的实现与常见问题解决方案,旨在帮助开发者深入理解并成功实现CANopen通信。

kiwi8的博客 274

从DBC到ARXML:详解DaVinci Configurator中通信栈的自动化配置逻辑

本文深入解析了Vector公司DaVinci Configurator工具如何将DBC文件自动转换为符合AUTOSAR标准的ARXML配置,详细介绍了从DBC到ARXML的映射逻辑、自动化配置的边界与陷阱,以及工程实践中的优化策略。帮助工程师高效配置汽车电子系统中的通信协议,提升项目开发效率。

weixin_30279671的博客 717

生产级机器学习:从模型上线到系统可靠性的实战指南

机器学习模型部署不是开发终点,而是系统性工程挑战的起点。其核心在于将数学模型转化为可监控、可扩展、可审计的软件服务——这涉及特征管道与决策管道的时间对齐、输入输出语义契约的强制定义、实时性约束下的性能归因优化,以及覆盖数据层/特征层/模型层的前摄式漂移检测体系。尤其在金融风控等高可靠性场景中,‘模型正确’远不如‘决策准时、可追溯、可降级’关键。本文基于Towards AI系列深度实践,聚焦模型在真实业务脉搏中的鲁棒性构建,涵盖契约化集成、混沌压测、审计就绪设计与漂移响应SOP等落地方法论。

weixin_33966095的博客 348

gtsam官方文档: The new IMU Factor学习笔记

gtsam官方文档:The new IMU Factor 本文为gtsam imu预积分文档学习笔记,为gtsam基于切向量实现的imu预积分的理论基础。 导航状态 定义导航状态为 Xbn={Rbn,Pbn,Vbn}X^n_b=\{R^n_b,P^n_b,V^n_b\}Xbn​={Rbn​,Pbn​,Vbn​} 上角标n:导航(navigation)坐标系 下角标b:载体(body)坐标系 下文均省略上下标 矢量场与微分方程 对于导航问题我们用如下微分方程描述 X˙(t)=F(t,X)\dot X(t)

南柯一梦的博客 1608

数据科学家必备的BI能力:从模型输出到业务决策的闭环

Business Intelligence(BI)是支撑数据驱动决策的基础技术体系,其核心在于将原始数据转化为可理解、可操作、可追溯的业务洞察。它依托维度建模、语义层封装与自助式分析等原理,显著降低数据理解门槛(data literacy),提升指标一致性与响应敏捷性。在实际工程中,BI不仅是报表工具,更是数据科学家构建可信数据沙盒、实现特征预验证、监控业务指标漂移、打通模型到行动闭环的关键支撑。尤其在金融风控、电商增长、智能运维等高价值场景中,BI能力直接决定模型能否被业务方采纳并产生真实GMV或运营效率

weixin_34341229的博客 372

谈谈人大金仓数据库

人大金仓数据库(Kingbase)是国产自主研发的关系型数据库管理系统,兼容主流数据库语法,支持高并发、高安全性及国产化适配。该数据库提供完整的安装部署方案,包括环境准备、初始化配置和验证流程,并配备专业的数据迁移工具(KDMS)实现从Oracle/MySQL等数据库的平滑迁移。系统提供KStudio等图形化管理工具,支持性能监控、备份恢复等运维功能,同时具备性能调优、高可用架构、分区表管理等高级特性,满足政府、金融等领域的企业级需求。

蜚鸣的博客 2099

uniapp 实现RFID识别的实战指南

本文提供了在uniapp中实现RFID识别的完整实战指南。核心在于通过Android系统广播机制,利用uni-app的plus对象调用原生接口,完成与RFID手持设备的“软硬件握手”。文章详细介绍了从环境准备、设备选型、核心代码实现到避坑优化的全流程,帮助开发者快速构建高效的RFID盘点或管理应用。

weixin_29161719的博客 405

机器学习生产化:模型上线后的系统稳定性与数据漂移治理

机器学习模型部署不是开发终点,而是系统性风险的起点。在真实生产环境中,模型稳定性高度依赖数据管道可靠性、服务契约一致性与实时监控能力。数据漂移并非模型缺陷,而是业务世界动态演化的信号;特征缺失、接口延迟、语义偏移等‘系统级断层’导致的故障占比超94%,远高于算法本身问题。因此,构建具备弹性降级、多维可观测性、滚动基准漂移检测和全链路决策留痕的ML系统,已成为金融、电商等高敏场景的核心工程能力。本文聚焦模型从Notebook走向Production过程中最关键的稳定性保障与可信治理实践。

weixin_33682790的博客 396

360加固DEX解密与ELF修复技术解析

本文深入解析360加固的DEX解密与ELF修复技术,详细介绍了其多层保护机制、Java层入口分析、Native层加载流程及反调试绕过技巧。通过RC4和zlib解密技术,结合Frida工具实现内存Dump和ELF文件修复,为逆向工程师提供实用解决方案。

weixin_29327525的博客 511

生产级机器学习系统:从模型部署到可观测性与治理

机器学习模型在生产环境中的稳定运行,本质上是系统工程问题而非单纯算法优化。其核心在于构建具备可观测性、优雅降级能力与清晰治理链路的服务系统。当模型脱离Jupyter进入真实业务流,它必须应对数据漂移、依赖雪崩、契约破裂等系统性风险,尤其在银行等强监管场景中,实时性、可解释性与全链路审计能力成为刚性要求。本文聚焦ML系统落地的四大支柱——服务契约设计、低延迟特征供给、多层监控体系与合规验证机制,结合金融级实战案例,解析如何让模型真正成为可信赖、可追责、可持续演进的业务基础设施。

areen7003的博客 362

手把手教你学PCIE--所有 PF(Physical Function)共同管理和分配 VF

但具体如何分配和使用 VF 取决于硬件设计、驱动程序配置以及实际应用场景。

MHD0815的博客 1462

2026.5.3:Ubuntu26.04下uv所需的环境变量pyproject.toml

本文档提供了Python开发环境的配置指南。主要包括: 设置环境变量(HF_ENDPOINT、UV_PYTHON_INSTALL_MIRROR等) 创建pyproject.toml配置文件,定义项目元数据(名称、版本等) 指定依赖项(torch系列库)及其安装源(PyTorch官方CUDA 12.8镜像) 配置Python版本要求(>=3.13,<3.14) 设置平台限制(Linux/Windows) 该配置适用于需要PyTorch CUDA 12.8支持的项目开发环境搭建。

拥抱具身智能,昇腾Ascend C 590
上一篇: IP归属地诊断5步法:定位账号限流的技术根源
下一篇: IP风险等级评估在保险承保中的三个核心应用场景——从投保核验到持续监控
聊点儿技术
博客等级 码龄1年 5粉丝 56原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值