AI入门学习--AI模型评测

AI大模型评测方法总结! 大语言模型评测对应用和后续发展至关重要,其评测范式包括经典和新型两种。经典评测范式涵盖自然语言理解和生成任务,本文介绍了流行的经典评测基准及新型评测范式下的代表性基准和实例,并总结了现有评测的不足。随后,文章提出了全面的大语言模型评测思想、相关指标和方法,并探讨了新的研究问题、挑战和未来方向。 阅读详情

一、AI模型评测目标

传统质量主要关注功能、性能、安全、兼容性等。
AI模型评测在此基础上,引入了全新的、更复杂的评估维度:
1.性能/准确性:这是基础,在一系列复杂的评测基准上评价个性能指标。
2.安全性:模型是否可能被用于恶意目的?是否会生成有害、违法或有毒的内容?是否容易受到数据投毒等攻击?
3.幻觉:对于大语言模型等生成式模型,它是否会"一本正经地胡说八道",捏造事实?
4.鲁棒性:模型在面对非理想输入时的表现。例如,输入有噪声声、有拼写错误、甚至是经过精心设计的对抗性攻击
时,模型的性能是否会急剧下降?
5.公平性与偏见:模型是否对不同群体(如性别、种族、地域)表现出一致的性能?是否存在歧视性行为?这是传
统质量很少触及的伦理维度。
6.可解释性:我们能理解模型为什么做出某个特定的决策吗?这对于金融、医疗等高风险领域至关重要。

二、评测的数据驱动

AI模型评测的核心是评估数据集。
1.评测基准:包含大量高质量、有代表性的标注数据,作为衡量模型性能的"标尺"。
2.人类参与的评估:对于创造性、主观性很强的任务(如文案生主成、对话质量),机器指标是不够的,由人类来打
分和判断。
3.对抗性测试:不再是测试常规场景,而是主动寻找模型的"盲区"和弱点,通过生成对抗样本来攻击模型。

三、评测周期

  • 数据准备阶段:确保输入给模型的数据是高质量、多样化、无无偏见且安全的。数据质量评测、数据分布评测、数据安全评测,从源头上保证模型的质量。
  • 预训练阶段:监控训练进程,验证模型是否在正确学习,并选择最佳的模型版本。检查点(Checkpoint)评测、超参数调优评测,也叫做边训边评,评测结果可以帮助工程师判断当前训练策略是否有效。
  • 后训练阶段:让模型学会人类的偏好,变得更"有用、诚实、无言害"。奖励模型的构建与评测、对齐效果评测,这个阶段,评测本身就是训练的核心驱动力。
  • 部署后:监控模型在真实世界中的表现,发现未知问题,并为下一代模型提供改进方向。

四、AI模型评测的关键技术

Benchmark

  • Benchmark 是用于量化评估AI模型/系统性能的标准测试集与评价体系,其核心价值在于:
    • ✅ 横向对比:不同模型在同一标准下的能力排序

    • ✅ 性能标尺:衡量模型是否达到工业级可用标准

    • ✅ 缺陷定位:识别模型在特定任务上的薄弱环节

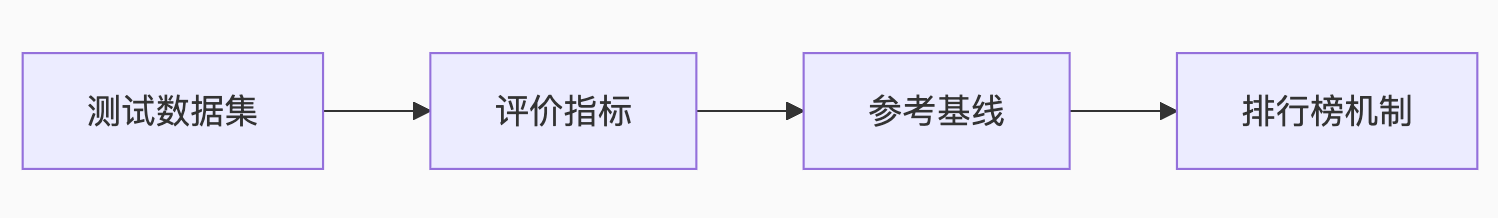
  • Benchmark核心要素

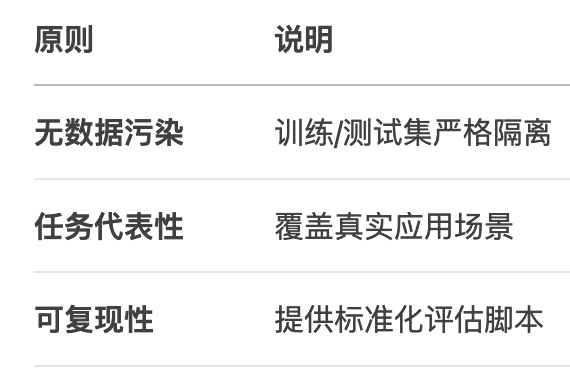
  • Benchmark设计原则

  • 静态Benchmark VS 动态Benchmark

静态Benchmark:是筛选基础知识和基本逻辑能力的的有效工具
优点:

  1. 可复现性与公平性:为不同模型提供了一个公平比较的平台。
  2. 诊断短板:可以针对性地测试模型在某个特定能力(如数学推理、代码生成、知识问答)上的强弱。
  3. 推动基础研究:清晰的指标可以引导学术界和工业界在特定方向上攻关。

缺点:

  1. 过拟合:模型可能会"刷分",学会Benchmark的套路,而非真正的能力。
  2. 时效性差:知识和能力要求在快速变化,静态Benchmark很快会过时。
  3. 与应用脱节:高分不等于在实际应用中有用。

动态Benchmark:检验的是解决实际问题的综合能力
优点:

  1. 真实反映用户需求:直接与用户体感和商业价值挂钩。
  2. 捕捉"涌现"问题:能发现模型在受控环境中暴露不出的新问题、偏见和安全漏洞(Red Teaming就是一种形
  3. 式)。
  4. 驱动模型"反脆弱":充满噪声和变化的数据强迫模型变得更更鲁棒、更具适应性

缺点:

  1. 评估成本高、信噪比低:需要大量人工标注或复杂的A/B测记式系统,且用户反馈充满主观性和噪声。
  2. 可复现性差:动态数据流难以精确复现,使得模型间的"apples-to-aapples"比较变得困难。
  3. 指标定义模糊:如何量化"用户满意度"、"创造性"等指标本身就是难题。

如何应用:

在基础模型研发阶段:更关注静态Benchmark。这个阶段的目标是构建模型的通用基础能力。
我们需要标准化的尺子来衡量模型在数学、逻辑、知识等核心维度上是否取得了突破。没有这个基础,谈论应用是不切实际的。
在产品应用迭代阶段:更关注动态Benchmark。这个阶段的目标是解决用户的具体问题,创造价值。
A/B测试、用户留存率、满意度调查等指标是金标准。

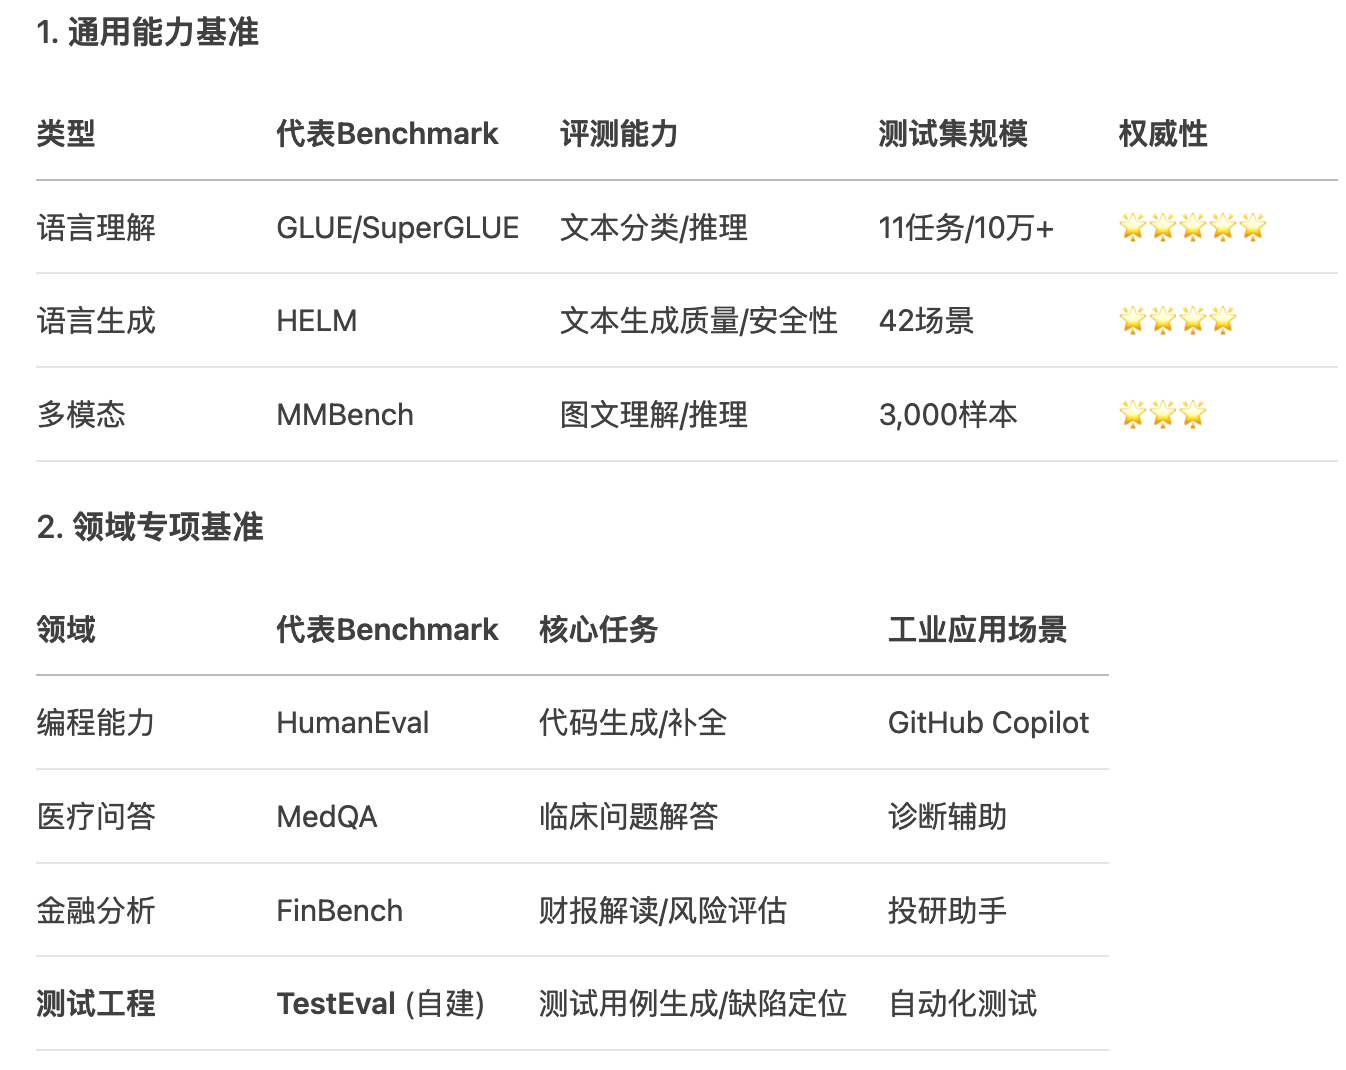
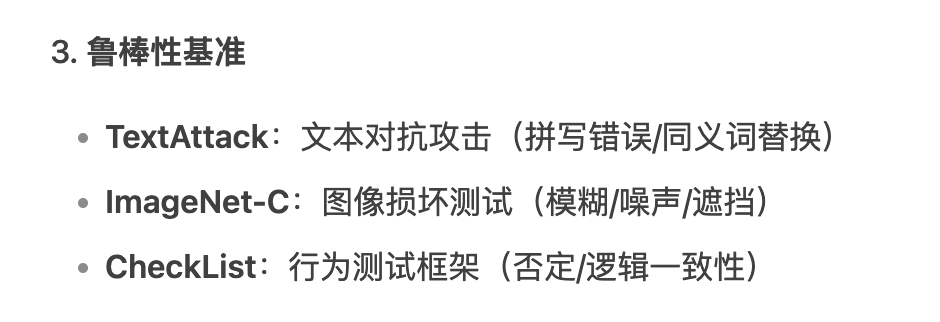
  • Benchmark分类体系

  • 高质量的Benchmark
  1. 广度与深度:不仅覆盖多领域知识,更要考察多步推理、规划、创造等深层能力。
  2. 抗"应试"性:题目设计巧妙,难以通过搜索或简单的模式匹配来"作弊"。最好是过程性评估,而非仅仅看最终答案。例如,评估代码不仅看运行结果,也看代码质量和解题思路。
  3. 动态与演化性:Benchmark本身应该是一个"动态"的系系统。它可以定期从真实世界数据中采样新问题,或者由人类专家、甚至其他AI持续地生成新的问题。
  4. 诊断性与可解释性:不仅给出分数,更能揭示模型在哪些模块上存在缺陷。它应该能回答"模型为什么错",而不仅仅是"模型错了"。
  5. 对齐人类价值观:必须包含对安全性、公平性、偏见、伦理等方面面的严格测试。例如,Safety Benchmarks
  6. 衡量泛化而非记忆:确保评测数据在模型的训练集中是"零样本"或"少样本"的,真正考验其泛化能力。
  7. 交互式与环境感知:未来的Benchmark必然会走向了交互式,在一个模拟或真实的环境中,评估模型完成复杂任务的能力,而不仅是"一问一答"。Agent的评测就是这个方向的体现

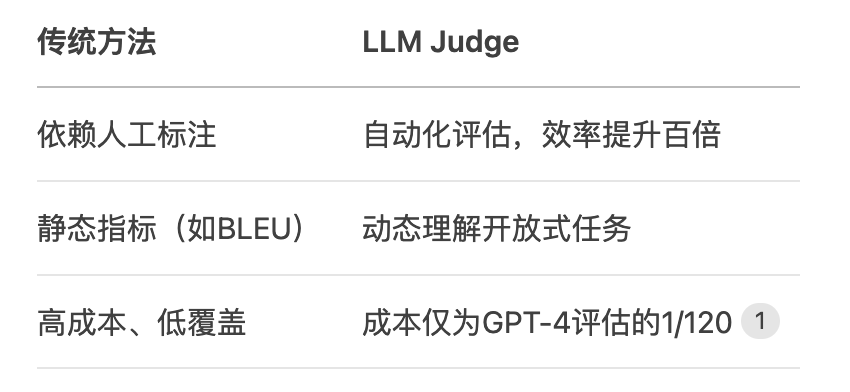
LLM Judge

LLM Judge(大型语言模型即裁判)是一种利用微调后的大语言模型(LLM)作为“裁判员”,自动化评估其他AI模型输出的技术范式。它通过理解任务需求、分析候选答案,并输出评分、排序或改进建议,显著提升了模型评估的效率和覆盖范围。

  • 核心框架
    • 输入:用户问题 + 待评估模型的答案(可单答案、多答案对比或多模态数据)。

    • 处理:LLM Judge 解析语义,结合预定义的评估维度(如帮助性、无害性、可靠性等)进行判断68。

    • 输出:

      • 评分(如1-5分)、排序(A > B > C)或选择(最佳答案)

      • 详细理由(可选生成改进建议)

  • 相比传统评估的优势

  • 核心应用场景
  1. 模型能力横向评测

    • 对比不同LLM在代码生成(HumanEval)、问答(MedQA)等任务的表现,输出排名报告。

  2. 生成内容质量审核

    • 评估文本的无害性(如过滤暴力内容)、帮助性(客服回答有效性)、事实准确性(医疗建议可靠性)。

  3. 多模态与复杂任务

    • 评判图文匹配度、RAG系统检索质量,甚至跨模态生成(草图→代码)的还原度。

  4. 训练过程优化

    • 替代人工标注生成偏好数据,驱动RLHF(人类反馈强化学习)微调

  • LLM Judge的偏见问题

位置偏见:这是最被广泛证实的一种偏见。在进行 A/B 对比评测时,LLM Judge 倾向于更喜欢排在第一个位置 (Answer A)的答案。即使将两个答案的顺序调换,它也可能仍然选择第一个,导致评估结果不一致和不准确。

长度偏见:LLM Judge 通常会偏爱更长、更详细、看起来更全面的回答,即使这些回答可能包含冗余信息、不相 关内容甚至是“幻觉”。这会鼓励被评估的模型生成冗长而非精炼的答案。

迎合偏见:LLM Judge 在评估其他模型的回答时,可能会偏爱那些风格、格式、观点与其自身相似的回答。它倾 向于奖励那些“看起来像自己”的答案,而不是真正更优的答案。这会导致评估的同质化,阻碍模型多样性的发 展。

格式偏见:对特定格式(如使用Markdown列表、加粗等)的偏好,即使内容质量相当,格式更规整的回答也更 容易获得高分。

  • LLM Judge的缺陷

对提示词敏感:评估结果很大程度依赖于你如何设计提示词,提示词中一个关键词的改变就可能影响评估结果。 这使得设计一个公平、稳定、普适的评估提示词本身就是一个巨大的挑战。

评估标准无法完全对齐人类偏好:LLM Judge 的“价值观”和判断标准来自于其训练数据,这不一定完全符合真 实、多样化的人类偏好。过度依赖 LLM Judge 进行模型迭代,可能会导致模型“过拟合”到 Judge 的偏好上, 而不是真正的人类用户偏好。

谁来评估裁判的循环问题:如何确定一个 LLM Judge 本身是高质量的?我们通常需要用高质量的人类标注数据 来验证它。但这又回到了最初试图用 LLM Judge 来解决的问题——对人类标注的依赖。这形成了一个方法论上 的循环困境。

  • 如何提高LLM Judge的准确性

✓ 优化提示工程

1. CoT: 要求模型在给出最终判断前,先逐步分析、推理

2. 精细化的评分标准 (Detailed Rubrics): 分解多个正交的、可量化的维度

3. 少样本提示

✓ 模型与数据层面的优化

1. 使用更强的基础模型

2. 在“困难样本”上进行微调

3. 多模型投票: 不依赖单一的裁判模型

✓ 人机协同(半自动评估):不追求用 LLM 完全取代人类,而是构建一个人机协同的评测系统

1. 分层审核: 使用 LLM Judge 进行大规模的、初步的筛选和打分,将模型打分处于“模糊地带” 的交由人类 专家进行精细复核

2. 持续校准: 定期用最新的“金标准”测试集来校准裁判模型

【科学文献计量】标准参考出版年谱(Standard RPYS)和多维参考出版年谱(Multi RPYS) @[TOC](标准参考出版年谱(Standard RPYS)和多维参考出版年谱(Multi RPYS)) 1 标准参考出版年谱与多维参考出版年谱 1.1 标准参考出版年谱(Standard RPYS) 标准参考出版年谱(Standard Reference Publication Year Spectroscopy)是由Marx, Bornmann, Barth, and Leydesdorff(2014)和Marx and Bornmann(2014)提出的一种量化历史出版物对研究领域影响的方法。该方法通 阅读详情

相关推荐

JMeter 压测实战全教程

脚本结构:测试计划 → 线程组 → HTTP 请求 → 监听器运行方式:图形化调试,命令行生产压测核心指标:QPS、RT、错误率、CPU、GC。

weixin_48309090的博客 652

收藏!一文读懂AI大模型评测体系,小白也能快速上手选对模型!

本文系统介绍了AI大模型评测体系,指出评测不仅是“跑分”,而是涵盖能力、质量、性能、安全与价值的“多维体检”。文章详细阐述了5大核心评测维度(基础能力、生成质量、系统性能、安全合规、业务价值)和4类评测方法(自动、人工、AI裁判、压力/鲁棒/对抗),并补充了主流评测基准和企业落地流程,旨在帮助读者避开“跑分陷阱”,精准判断AI模型真实能力,为模型选型、研发和落地提供实用指导。

Android_XG的博客 1729

o型圈沟槽设计_O型密封圈——详细选型过程及步骤

一、密封圈常用材料二、密封圈常用密封形式密封圈分为活塞密封,活塞杆密封,端面密封,旋转密封。三、O型密封圈的选型规则O型密封圈的尺寸图径向安装O型圈选型(静态和动态运动)活塞杆密封选择适当规格的O形圈时,应该保证其外径(d1+2*d2)至少等于或者大于沟槽外径d6;当选择的O形圈直径d1大于250 mm时, O形圈外径将不能超过沟槽外径的3%;当选择的O形圈直径d1小于250mm时, O形圈外径将...

weixin_39856630的博客 2万+

初步探索AI质量评测

本篇文章记录的是我对AI质量评测的初探索,欢迎专业人员评价指正~也欢迎对AI系统测评感兴趣的小伙伴一起交流学习~

Ersin555的博客 1971

压电阀控制器设计-总章

本文章用于回顾记录本人制作压电阀控制器的关键技术,本人所制作压电阀控制器已经上市得到应用,特在此对一些关键技术进行回顾记录,欢迎从事压电控制及压电阀相关人员一起讨论

qq_42712859的博客 849

Python办公自动化:用python-docx打造专业级Word表格边框(附完整代码)

本文深入探讨了如何利用python-docx库精细控制Word表格边框,实现办公自动化。通过解析底层XML结构,提供了通用的`set_cell_border`函数,并附上完整代码,帮助用户轻松打造符合商业规范的专业级表格,提升报告、合同等文档的生成效率与视觉效果。

weixin_29089057的博客 546

AI大模型是如何测试效果的?

AI大模型的测试和评估是一个复杂的过程,通常包括多个方面的考量,因此对大模型的测试也称为多度测试。模型参数计算(以ALexNet为例):参数量在6000万,假设每个参数都是一个float,即4个字节,总字节就是24000万字节,则24000万字节/1024/1024 = 228MB一个针对大型语言模型(LLMs),采用众包方法进行匿名、随机化的对战的评分系统。根据清华发布2024年3月版《SuperBench大模型综合能力评测报告》。

python123456_的博客 5380

UG\NX二次开发 分割曲线

分割曲线没有ufun函数?那就换一种思路实现。

王牌飞行员_里海的博客 1146

LLM大模型测试维度

测试AI大模型是一个多维度和多步骤的过程,涉及多个方面,包括但不限于道德和伦理、偏见性、毒性、诚实性、安全评测等。7. 平台化评测:使用如PAI大模型评测平台等工具,支持不同基础模型、微调版本和量化版本的对比分析,以及自定义数据集的评测。4. 诚实性评测:检测AI生成内容的真实性和准确性,包括问答、对话和摘要任务的数据集,以及基于自然语言推理等评测方法。5. 安全评测:确保AI大模型在各种应用场景中的安全使用,包括鲁棒性评测和风险评测,例如越狱攻击方法的评估。

laybourne的博客 1591

化工模拟与优化软件:Aspen HYSYS二次开发_(15).工业应用与项目管理

项目背景、目标和主要流程。

kkchenjj的博客 1130

【k8s故障处理篇】calico-node启动失败“Felix is not live: Get “http://localhost:9099/liveness” 解决办法(V1.30.3版本)

【k8s故障处理篇】calico-node启动失败“Felix is not live: Get “http://localhost:9099/liveness” 解决办法(V1.30.3版本)

jks212454的博客 1091

收藏!228万年包刷屏!大模型岗位全解析,小白/程序员入门必看

估计不少打工人刷到这则消息都要破防了!😭最近圈内热议:北京邮电大学25届毕业生,成功入职字节跳动Seed部门,岗位是大模型研究员,!评论区里,网友们的羡慕之情简直要溢出屏幕~互联网行业的薪资本就让很多普通打工人望尘莫及,没想到人工智能大模型赛道的薪资更是卷出新高度!在当前的就业环境下,想冲刺年薪百万,人工智能大模型方向显然是优质选择,甚至比传统互联网岗位更具竞争力。这几年,随着AI技术深度渗透到各行各业,大模型相关岗位已然成为科技圈的“香饽饽”。

weixin_72959097的博客 761

触摸芯片RM1015B基本使用方法

RM1015B触摸芯片使用指南:该芯片采用4通道设计(实际使用3通道),通过I2C接口通信(设备地址0x2B)。硬件设计需注意中断/复位引脚复用,需上拉处理。软件配置包括初始化、中断处理和定时器扫描,通过设置各通道阈值(0-300W)调节灵敏度,值越小越灵敏。调试时可调用rm1015B_debug_func()输出波形数据。典型应用场景包括接近检测和手势识别,中断触发后需在8ms内响应。特别注意不同通道的寄存器映射关系及校准流程,确保检测准确性。

云淡风轻 178

初学者入门大模型Agent必学:深度分析不同的开源智能体框架

我们确实需要参考社区的实际案例来评估框架的表现,但最流行的框架未必总是最优选。大家常听说的有 CrewAI 和 AutoGen。

jennycisp的博客 1405

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

AI产品经理入门:从大语言模型原理到评测闭环的实战学习路线

大语言模型基于海量文本学习词语概率关系,输出具有随机性与不确定性,这决定了AI功能与确定性软件的本质差异。RAG架构通过检索知识库约束模型生成,Agent则让模型调用工具完成多阶段任务,这些技术为控制模型行为提供了工程化手段。然而,无论采用何种方案,产品经理面临的核心挑战都是如何将不可控的模型输出纳入可评估、可迭代的体系。要真正胜任AI产品经理岗位,既需理解Token、幻觉、上下文窗口等基础概念,更要掌握评测集设计、badcase收敛等实践方法。本文从技术原理出发,梳理了一条从熟悉工具、理解原理到跑通最小闭

weixin_30603633的博客 369

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

收藏!小白程序员转行AI训练师,这些岗位都在这里!带你找到最适合你的方向!

很多小伙伴和我一样认为:学AI训练师,就是为了找一个叫“AI训练师”的工作。但现实是:AI训练师更像是一张职业地图。我们可以往数据方向发展;可以往评测方向发展;可以往Prompt方向发展;可以往AIGC方向发展;也可以进入智能体和自动化领域。重要的不是一开始选对方向。而是先迈出第一步。因为当我们真正接触项目、接触企业需求之后,我们才会越来越清楚:哪条路最适合自己。而AI行业,或许正是我们下一次职业成长的机会。

2301_76168381的博客 403

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

大语言模型评测方法全面总结!

自2017年Transformer模型提出以来,自然语言处理研究逐步转向基于该框架的预训练模型,如BERT、GPT、BART和T5等。这些预训练模型与下游任务适配后,持续刷新最优结果。然而,现有评测方法存在广度和深度不足、数据偏差、忽视模型其他能力或属性评估等问题。因此,需要全面评测和深入研究模型的各项能力、属性、应用局限性、潜在风险及其可控性等。本文回顾了自然语言处理中的评测基准与指标,将大语言模型评估分为经典和新型评测范式,分析了现有评测的不足。

2401_85373898的博客 1414

大模型能力评测方式很多?

AI评测是系统工程,需多维度、多方法协同。基础框架包括参考式/非参考式评测、各类交互模式及多层级评分指标。主流基准覆盖通用能力(MMLU)、专业领域(GSM8K、HumanEval)、安全效率(TruthfulQA)及多模态(MMMU)。关键方法包括人类偏好双盲测试(ChatbotArena)、AI辅助评测及严格统计设计。评测需场景匹配:通用能力看MMLU+人类偏好,代码能力重SWE-bench,安全指标侧重拒答率。通过多维指标联动,才能全面评估AI模型真实能力。

Q2024107的博客 1007

一文快速搞懂LLM评测-Benchmark,大模型入门到精通,收藏这篇就足够了!

今天我们就来聊聊这个听起来高大上,但其实很接地气的概念——benchmark!

pythonhy的博客 1591

AI绘画最强开源模型 Flux【模型比较】:Flux.1模型与SDXL模型效果比较 未来城市,星际连接

接下来,我们就来看看,FLux模型和SDXL模型在同一提示词下,生成的画面进行对比,看看谁的出图质量最高!

Android 开发架构 1805

LLM 大模型学习:大模型评估框架详解_llmuses框架

大语言模型(LLM)评测是LLM开发和应用中的关键环节。目前评测方法可以分为人工评测和自动评测,其中,自动评测技术相比人工评测来讲,具有效率高、一致性好、可复现、鲁棒性好等特点,逐渐成为业界研究的重点。模型的自动评测技术可以分为rule-based和model-based两大类:rule-based方法:benchmark以客观题为主,例如多选题,被测的LLM通过理解context/question,来指定最佳答案解析LLM的response,与标准答案做对比。

jennycisp的博客 1433

【大模型入门】从零开始训练大模型:详细梳理一个完整的 LLM 训练流程

在这篇文章中,我们将尽可能详细地梳理一个完整的 LLM 训练流程。包括模型预训练(Pretrain)、Tokenizer 训练、指令微调(Instruction Tuning)等环节。

xxue345678的博客 2378

国内大模型排名大盘点(非常详细)

国内大模型排名大盘点(非常详细)

Java癫疯的博客 2万+

最新人工智能硬件培训AI基础入门学习课程参考2025版(离线AI语音视觉识别篇)

基于CSK6开发板开箱即用的离线AI能力,分类列出学习课程知识点和实操参考,希望能够帮助大家快速掌握离线 AI 智能硬件的基础知识与实战技能,同时了解相关AI技术在实际场景的应用情况。

分享AI芯片开发经验 739

吴恩达《Agentic AI》智能体课程五分钟速读,大模型入门到精通,收藏这篇就足够了!

吴恩达开篇定义了Agentic AI工作流,即LLM通过执行多步骤、迭代式的过程来完成复杂任务,相比单次提示能产生更优质的结果。

huang9604的博客 1248

OmAgent v0.2.2 重磅更新!智能体算子来袭,智能体评测平台同步启用!

OmAgentv0.2.2新版本正式发布,新版本引入了智能体算子「AgentOperator」,使开发者能够便捷地在项目中调用子工作流实现复杂智能体功能,目前已涵盖CoT、SC-CoT、PoT、ReAct等算子,能够帮助开发者快速构建复杂智能体功能,极大地拓展了应用的可能性。

2401_85375298的博客 939
上一篇: AI入门学习--如何写好prompt?
下一篇: AI入门学习--用python实现意图识别
sssammmm
博客等级 码龄9年 368粉丝 42原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值