


本文主要知识点:
①三个诸葛亮顶一个臭皮匠——Blending,函数式融合——Stacking
②bagging
③随机森林、adboost、梯度提升树、xgboost
为什么要做模型融合?
引用下林轩田老师举的例子。假如我们需要买一支股票,但是我们不会炒股,需要咨询身边朋友的建议。这个时候我们可能会咨询多个人,得出我们的最终决定。谚语也有“三个诸葛亮顶一个臭皮匠”的说法。这里我们可能采取几种方式来权衡各个朋友的意见:
- 从数个建议中选择自己认为最优的建议,即我们觉得哪个人说的最好,我们就买他推荐的股票。
- 让他们投票,多数服从少数,选择得票最高的方案
- 谁炒股厉害就给他更多的投票权
- 在不同的情况下,给他们的权重不一样。例如股票是家电股,我们就会给经常炒家电股的朋友更多的投票权。
以上四个方案其实都是给予一个权重。例如第一个是除了选中的人,其他人的权重都为0,第二个是权重都一样,第三个是不一样的定值,第四个是一个变量。
下面举例说明融合模型可能能够提高算法的能力。

如上图,分类直线的能力没得加粗折线的强,通过直线得到折线相当于做了特征转换。

再如图,融合相当于中间加粗的那条线,和其他线比起来,在中点的两端都抑制了线向两边的倾斜。相当于正则化。
对于一个单一的模型,通常特征转换和正则化是相对立的,一个强了,另一个就弱了。但是模型融合能够结合这两点的优势,更有可能得到更好的模型。
第三个例子算一个特例,但有数学上的证明。假设每个朋友给出的建议是函数
g
t
g_t
gt,G是所有建议的均值,f是真函数。则有如下推导

可知
g
t
g_t
gt与f的差值比G与f的差值大,故G比f更稳定。右边第一项是不同
g
t
g_t
gt之间的偏差情况,也即方差公式,机器学习中通常称之为方差。第二项表示不同
g
t
g_t
gt的平均情况与真实f之间差距,称之为偏差。对偏差和方差比较懵逼的同学可以记下这个推导。
对于第四情况,还有一个别称stacking。
一般的blending和stacking都是两层的学习结构。实践中有些许差别。
blending:第一层通常把训练集按7:3来分,在70%的训练集上训练多个模型,在30%数据上预测label。第二层把第一层得到的预测label作为新特征来学习(权重为一个固定常数,可以相等,可以不等,可以部分为0,总之只要不是所有都为0就可以)。
stacking:第一层用所有的数据来做K折交叉验证得到多个模型,将模型得到的预测作为新特征来学习(这里的权重是一个不全为0的函数),过程如下图。
stacking是任意形式的blending,我们也可以把得到的预测值作为高阶特征,加上原始特征后再次学习(这里的权重是一个不全为0的函数)。
有如下特点:
- 更灵活,通常得到的模型复杂度更高,准确的更高
- 模型复杂度高,更容易过拟合。可以尝试加强正则化来解决。
Blending优点:
- 没有交叉验证,计算量少
- 两层的数据不同,避免了信息泄露
- 在团队建模过程中,不需要给队友分享自己的随机种子
Blending缺点:
- 第二层使用的数据少,信息少
- 容易过拟合
- stacking使用了cv,更稳健
实践中两种方法的效果差别不是太大。
参考文章:
https://blog.youkuaiyun.com/sinat_35821976/article/details/83622594
https://blog.youkuaiyun.com/u010412858/article/details/80785429
https://blog.youkuaiyun.com/u012969412/article/details/76636336
bagging
对于普通的blending,我们希望每个
g
t
g_t
gt都有差别,如果都一样,则融合毫无意义。有很多种方式得到不同的
g
t
g_t
gt。例如:使用不同的模型、不同的参数、不同的训练集、不同的随机种子等等。在只有一份数据时,我们可以使用bootstrapping的方法是构造不同的
g
t
g_t
gt。
bootstrapping:
假如有N个样本,每次随机从中抽取一个样本,记录,然后放回去。一直重复(可以是N次,也可以是其他任何的合理次数)。这样我们就得到了一个训练集。多次试验后就得到了多个独立同分布的训练集,可以构造不同的
g
t
g_t
gt了。
采用bootstrapping构造不同
g
t
g_t
gt并融合的方法称为bagging。bagging需要基模型对数据分布较敏感,这样容易获得不同的
g
t
g_t
gt,融合后效果才更好。
随机森林
上面我们提到blending用于特征转换和正则化的效果,bagging使用一份数据来构造不同的
g
t
g_t
gt,能减少不同
g
t
g_t
gt之间的方差。又决策树的每一条分支都是一个不同的
g
t
g_t
gt,每一次细分,都能降低子节点内的不纯度,增加不同叶子节点间的区别,即增加方差。我们希望两者结合起来,发挥各自的优势。将决策树和bagging结合起来,这称之为随机森林。
随机森林的实践中主要有两种方式来构造不同的训练集,从而得到不同的
g
t
g_t
gt
- 随机森林=bagging+完全成长的决策树
- 随机森林=bagging+random-subspace决策树
第一种:我们用bootstrapping的方式从样本量来构造不同的训练集
第二种:我们从特征维度构造不同的训练集。每次随机获取不同的特征来构成新的训练集,我们也可以对被选择的特征做加权计算后作为新的特征加入原始特征来构造不同训练集。
Out-Of-Bag Estimate如果我们是通过bootstrap的方式来获取样本,则没被选择到的样本量称为out-of-bag(OOB) example。某个样本是OOB的概率为:
(
1
−
1
N
)
N
=
(
1
(
N
N
−
1
)
N
)
=
1
(
1
+
1
N
−
1
)
N
≈
1
e
(1-\frac1N)^N=(\frac{1}{(\frac{N}{N-1})^N})=\frac{1}{(1+\frac{1}{N-1})^N}\approx\frac1e
(1−N1)N=((N−1N)N1)=(1+N−11)N1≈e1
即大约有三分之一的样本没有被抽到。
如果一个样本对某个
g
t
g_t
gt是OOB,则这个样本相当于他的验证集。由于我们主要关心的是G,所以我们只需要考虑G的整体表现即可。
使用OOB来验证G的好坏:对每一个样本,看他是哪个
g
t
g_t
gt的OOB,计算其在这些
g
t
g_t
gt上的平均表现作为其在G上的表现。最后再算所有样本的表现的平均值作为G的表现。称为self-validation。过程和留一交叉验证法类似。
self-validation在模型的调整系数过程中就自动完成了,故不再需要重新训练。但是交叉验证就需要在选出最优模型后再次训练,以确定模型的最终系数。
随机森林算法过程中的特征选择
如果数据体的特征过多,则要么过拟合、要么在训练或者后期运算成本太大。故我们希望只选择其中的一部分特征来训练。我们希望排除两大类特征:冗余特征、不相关特征。
具有如下优点:
- 提高效率,特征越少,模型越简单
- 正则化,防止特征过多出现过拟合
- 去除无关特征,保留相关性大的特征,解释性强
缺点:
- 特征选择的过程中计算量较大(但通常都是值得的,以短期劣势换取长期优势)
- 不同的特征组合也容易发生过拟合
- 有些特征看起来相关,实际上无关,即数学上相关,但实际上不相关。容易选到这类特征,解释性差。
线性模型中的特征选择: 在线性模型中,如果某个特征很重要,则他的系数通常较大,可以直接对系数排序,选出符合阈值的特征。例如LASSO算法就是选择系数不为0 的特征。
但是在非线性模型中,特征间可能是互相交叉在一起的,并不能简单依靠系数大小来确定特征重要性。
在随机森林中,我们采用一种random test的方式来做特征选择。
**random test:**对于某个特征,如果有其他随机值来替代后,模型表现无多大差别,则舍弃。通常有两种实现方式:
- 使用均匀分布或者高斯函数来获得随机值序列替代特征
- 把现有特征值随机打乱后替换原始特征。称为permutation test
permutation test保证了打乱前或者打乱后特征值的分布相似,通常更能确保特征重要性的准确性。
在实际应用做,permutation test后,仍然需要对其他特征进行训练,RF的作者提出了一种简化思路:只在OOB验证时使用permutation test,在训练时不使用permutation test。
boosting
如林轩田老师课中举的例子一样,每一次判断是否是苹果时,我们都仅仅只用一个简单的条件,经过多次的对前面的条件做补充修正后,我们基本上就能正确判断大多数的苹果。
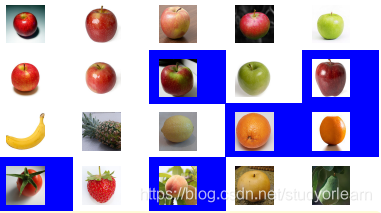
每一轮增加的一个判断条件就是一个决策桩,效果可能很差,是一个弱学习器。经过若干个若学习共同作用后,得到一个强的学习器。
那么是否都可以通过弱学习器相互作用得到强学习器呢,好消息就是已经有人在PAC的框架下证明了通过弱学习器能得到强学习器。
boosting的核心思想就是:最开始使用一些比随机猜测好一点的学习器来学习,然后增大错误样本的权重,减小正确样本的权重。这样在训练集上使错误一直减少,通常效果会更好,但也更容易过拟合。例如:弱学习器是决策桩,多个决策桩就可以构成一个决策树。
bagging、stack、boosting的对比可以参考文章:
https://blog.youkuaiyun.com/u012969412/article/details/76636336
https://blog.youkuaiyun.com/cppjava_/article/details/68485565
adboost
adboost是bossting的代表算法之一。boosting是把所有数据都拿去训练,训练一轮后,增大分类错误的权重,减小正确分类的权重。然后再次拿这些数据去训练。则每次的训练错误率为
e
m
=
∑
w
m
i
I
(
G
m
(
x
i
)
=
̸
y
i
)
∑
w
m
i
e_m=\frac{\sum w_{mi}I(G_m(x_i)=\not y_i)}{\sum w_{mi}}
em=∑wmi∑wmiI(Gm(xi)≠yi)
即分类错误率等于分类错误点的权重之和占总权重的百分比。boost的每一轮都是一个弱分类器,即我们希望
G
m
G_m
Gm的分类能力和随机猜测差不多,即分类误差率约为0.5。为了使
e
m
=
0.5
e_m=0.5
em=0.5,只能使分类正确的权重和等于分类错误的权重和(为1:1),分别乘上他们占总权重比的倒数即可.例如分类正确率为0.2,错误率为0.8,
0.2
∗
0.8
:
0.8
∗
0.2
=
1
:
1
0.2*0.8 :0.8*0.2=1:1
0.2∗0.8:0.8∗0.2=1:1
引入尺度因子:
e
t
=
1
−
e
m
e
m
e_t=\sqrt\frac{1-e_m}{e_m}
et=em1−em如果
e
m
≤
1
2
,
则
e
t
≥
1
e_m\leq\frac12,则e_t\geq 1
em≤21,则et≥1。对于错误的点,我们乘上
e
t
e_t
et,正确的点,我们乘除以
e
t
e_t
et。则会放大了错误点的权重,减小了正确点的权重。
以上解决了如何更新下一轮权重的问题(初始权重设为
1
N
\frac1N
N1)。但是各个分类器该怎么组合呢?由于
g
t
+
1
g_{t+1}
gt+1是由上一个分类器
g
t
g_{t}
gt得到的,他们在
E
i
n
E_{in}
Ein上的表现差距较大,我们不能让他们采取投票的方式决定最终结果。例如一个人说往东,一个说往西,难道我们要停留在原地吗?所以我们可以根据不同的人采取不同的权重,也可以根据不同的情形采取不同的权重,即线性或者非线性组合。adboost采取的方式是令
α
m
=
1
2
ln
(
1
−
e
m
e
m
)
\alpha_m = \frac12\ln(\frac{1-e_m}{e_m})
αm=21ln(em1−em)
物理解释为:
α
m
是
一
个
单
调
递
减
函
数
,
当
e
m
=
1
2
时
\alpha_m是一个单调递减函数,当e_m = \frac12时
αm是一个单调递减函数,当em=21时,和随机猜测没什么两样,此时
α
m
=
0
\alpha_m=0
αm=0;当
e
m
=
0
或
1
e_m = 0或1
em=0或1时,
α
m
\alpha_m
αm为无穷大。反应了准确率越高的分类器,我们给与他更高的权重。
算法流程:
- 初始化权重 w 1 i = 1 N w_{1i}=\frac1N w1i=N1
- 学习获得基分类器 G m ( x ) G_m(x) Gm(x)
- 计算分类误差率 e m e_m em e m = ∑ w m i I ( G m ( x i ) = ̸ y i ) ∑ w m i e_m=\frac{\sum w_{mi}I(G_m(x_i)=\not y_i)}{\sum w_{mi}} em=∑wmi∑wmiI(Gm(xi)≠yi)
- 计算 G m ( x ) G_m(x) Gm(x)的系数 α m = 1 2 ln ( 1 − e m e m ) \alpha_m = \frac12\ln(\frac{1-e_m}{e_m}) αm=21ln(em1−em)
- 为下一轮训练更新样本权重 w m + 1 , i = w m i Z m exp ( − α m y i G m ( x i ) ) w_{m+1,i}=\frac{w_{mi}}{Z_m}\exp(-\alpha_my_iG_m(x_i)) wm+1,i=Zmwmiexp(−αmyiGm(xi))对指数部分展开后就会得到尺度因子 e t e_t et或者其导数,具体取决于是否分类错误。 Z m = ∑ i w m i exp ( − α m y i G m ( x i ) ) Z_m=\sum_iw_{mi}\exp(-\alpha_my_iG_m(x_i)) Zm=∑iwmiexp(−αmyiGm(xi))仅仅就是一个归一化因子,作用为:①使所有权重和为1,②避免权重过大过小(如果了解过神经网络里的梯度消失或者爆炸,会更有感觉)。如果对理解造成困扰可以直接忽略归一化。
- 最终分类器 G ( x ) = s i g n ( f ( x ) ) = s i g n ( ∑ m α m G m ( x ) ) G(x)=sign(f(x))=sign(\sum_m\alpha_mG_m(x)) G(x)=sign(f(x))=sign(m∑αmGm(x))
下面从梯度下降角度解释adboost
对0/1分类错误率有
1
N
∑
i
N
I
(
y
=
̸
∑
α
t
G
t
(
x
i
)
)
)
≤
1
N
∑
i
N
exp
(
−
y
i
∑
α
t
G
t
(
x
i
)
)
\frac 1 N\sum_i^N I(y =\not \sum\alpha_tG_t(x_i)))\leq\frac 1 N\sum_i^N \exp(-y_i\sum\alpha_tG_t(x_i))
N1i∑NI(y≠∑αtGt(xi)))≤N1i∑Nexp(−yi∑αtGt(xi))故右式为分类误差上界,可以作代替0/1分类误差公式
L
o
s
s
=
1
N
∑
i
N
exp
(
−
y
i
∑
t
α
t
G
t
(
x
i
)
)
Loss=\frac1N\sum_i^N \exp(-y_i\sum_t\alpha_tG_t(x_i))
Loss=N1i∑Nexp(−yit∑αtGt(xi))
还有另一个方向的解释:
对于第m+1轮,
w
m
+
1
,
i
=
w
m
i
Z
m
exp
(
−
α
m
y
i
G
m
(
x
i
)
)
w_{m+1,i}= \frac{w_{mi}}{Z_m}\exp(-\alpha_my_iG_m(x_i))
wm+1,i=Zmwmiexp(−αmyiGm(xi))
=
w
1
i
∏
t
=
1
m
w
t
i
Z
t
exp
(
−
α
t
y
i
G
t
(
x
i
)
)
= w_{1i}\prod_{t=1}^{m}\frac{w_{ti}}{Z_t}\exp(-\alpha_ty_iG_t(x_i))
=w1it=1∏mZtwtiexp(−αtyiGt(xi))
=
1
N
∏
t
=
1
m
1
Z
t
exp
(
−
y
i
∑
α
t
G
t
(
x
i
)
)
=\frac 1 N\prod_{t=1}^m\frac1 Z_t\exp(-y_i\sum\alpha_tG_t(x_i))
=N1t=1∏mZ1texp(−yi∑αtGt(xi))上面我们说过
Z
t
Z_t
Zt仅仅只是归一化因子,可以忽略。随着分类器个数的增加,分类误差率会降低,正确样本的权重会下降。所以某种意义上我们的优化变成了使正确样本权重最小。那么对于整个样本集,就变成了使归一化前的所有样本权重和最小。
下面我们使用梯度下降的方法来最小化Loss。对于第m轮学习:
L
o
s
s
=
1
N
∑
i
N
exp
(
−
y
i
∑
t
m
α
t
G
t
(
x
i
)
)
Loss = \frac1N\sum_i^N \exp(-y_i\sum_t^m\alpha_tG_t(x_i))
Loss=N1i∑Nexp(−yit∑mαtGt(xi))
=
1
N
∑
i
N
exp
(
−
y
i
(
∑
t
m
−
1
α
t
G
t
(
x
i
)
+
α
G
(
x
i
)
)
)
= \frac1N\sum_i^N \exp(-y_i(\sum_{t}^{m-1}\alpha_tG_t(x_i)+\alpha G(x_i)))
=N1i∑Nexp(−yi(t∑m−1αtGt(xi)+αG(xi)))
=
∑
i
N
w
m
i
exp
(
−
y
i
α
G
(
x
i
)
)
=\sum_i^N w_{mi}\exp(-y_i\alpha G(x_i))
=i∑Nwmiexp(−yiαG(xi))
≈
∑
i
N
w
m
i
(
1
−
y
i
α
G
(
x
i
)
)
\approx \sum_i^N w_{mi}(1-y_i\alpha G(x_i))
≈i∑Nwmi(1−yiαG(xi))
=
∑
i
N
w
m
i
−
α
∑
i
N
w
m
i
y
i
G
(
x
i
)
=\sum_i^N w_{mi}-\alpha\sum_i^N w_{mi}y_iG(x_i)
=i∑Nwmi−αi∑NwmiyiG(xi)上式就是L在
−
y
i
α
G
(
x
i
)
=
0
-y_i\alpha G(x_i)=0
−yiαG(xi)=0处的一阶泰勒展开。则L最小等价于第二项
−
α
∑
i
N
w
m
i
y
i
G
(
x
i
)
-\alpha\sum_i^N w_{mi}y_iG(x_i)
−α∑iNwmiyiG(xi)最小。如果是二分类,我们先优化G后优化步长
α
\alpha
α
∑
i
N
w
m
i
(
−
y
i
G
(
x
i
)
)
=
∑
y
i
=
̸
G
(
x
i
)
w
m
i
y
i
G
(
x
i
)
+
∑
y
i
=
G
(
x
i
)
w
m
i
y
i
G
(
x
i
)
\sum_i^N w_{mi}(-y_iG(x_i))=\sum_{y_i =\not G(x_i)} w_{mi}y_iG(x_i)+\sum_{y_i = G(x_i)} w_{mi}y_iG(x_i)
i∑Nwmi(−yiG(xi))=yi≠G(xi)∑wmiyiG(xi)+yi=G(xi)∑wmiyiG(xi)
=
∑
y
i
=
̸
G
(
x
i
)
w
m
i
−
∑
y
i
=
G
(
x
i
)
w
m
i
=\sum_{y_i =\not G(x_i)} w_{mi}-\sum_{y_i = G(x_i)} w_{mi}
=yi≠G(xi)∑wmi−yi=G(xi)∑wmi
=
−
∑
i
N
w
m
i
+
2
∑
y
i
=
̸
G
(
x
i
)
w
m
i
=-\sum_i^Nw_{mi}+2\sum_{y_i =\not G(x_i)} w_{mi}
=−i∑Nwmi+2yi≠G(xi)∑wmi
=
∑
i
N
w
m
i
+
2
E
i
n
m
=\sum_i^Nw_{mi}+2E_{in}^{m}
=i∑Nwmi+2Einm问题转化为了最小化第m轮的分类器
G
G
G。也就是说最小化分类器的函数方向就是Loss损失函数的负梯度方向。现在我们来最优化步长
α
\alpha
α。对于损失函数有
L
=
1
N
∑
i
N
w
m
i
exp
(
−
y
i
α
G
t
(
x
i
)
)
L=\frac1N\sum_i^N w_{mi}\exp(-y_i\alpha G_t(x_i))
L=N1i∑Nwmiexp(−yiαGt(xi))
=
∑
y
=
̸
G
w
m
i
e
α
+
∑
y
=
G
w
m
i
e
−
α
=\sum_{y=\not G}w_{mi}e^{\alpha}+\sum_{y= G}w_{mi}e^{-\alpha}
=y≠G∑wmieα+y=G∑wmie−α
=
e
m
e
α
+
(
1
−
e
m
)
e
−
α
=e_me^{\alpha}+(1-e_m)e^{-\alpha}
=emeα+(1−em)e−α
⟹
  
∂
L
∂
α
=
α
e
m
e
α
−
α
(
1
−
e
m
)
e
−
α
=
0
\Longrightarrow\; \frac{\partial L}{\partial \alpha}=\alpha e_me^{\alpha}-\alpha(1-e_m)e^{-\alpha}=0
⟹∂α∂L=αemeα−α(1−em)e−α=0求出解为
α
=
ln
1
−
e
m
e
m
\alpha=\ln\sqrt \frac{1-e_m}{e_m}
α=lnem1−em
从来这里我们也可以看出算法中的
α
\alpha
α不是随意构造的,是通过最优化Loss得到的。
α
\alpha
α代表了最佳步长。
GBDT
上节我们用梯度下降的方式解释了0/1分类误差函数的情况。但我们期望可以对任一种误差函数使用梯度下降来优化。则最优化函数为
min
α
min
G
1
N
∑
i
N
e
r
r
(
∑
t
m
−
1
α
t
G
t
(
x
i
)
+
α
G
(
x
)
,
y
n
)
\min_\alpha \min_G \frac1N\sum_i^N err(\sum_t^{m-1}\alpha_tG_t(x_i)+\alpha G(x),y_n)
αminGminN1i∑Nerr(t∑m−1αtGt(xi)+αG(x),yn)仍然可用梯度下降的方式求出他的函数负梯度和最佳步长。
上面我们详细说了0/1分类时的梯度下降方式,下面我们来探讨下squared-error形式的回归问题。
仍然暂时不考虑
α
\alpha
α的优化。为了少写点公式(暂时就当是这个原因),令
s
=
∑
t
m
−
1
α
t
G
t
(
x
i
)
s = \sum_t^{m-1}\alpha_tG_t(x_i)
s=t∑m−1αtGt(xi)对优化函数的内层使用一阶级泰勒展开有
min
G
(
.
.
.
)
=
1
N
∑
i
N
(
e
r
r
(
s
n
,
y
n
)
+
α
G
∂
e
r
r
(
s
,
y
n
)
∂
s
∣
s
=
s
n
)
\min_G (...) = \frac1N\sum_i^N (err(s_n,y_n)+\alpha G \frac{\partial err(s,y_n)}{\partial s}\mid_{s=s_n})
Gmin(...)=N1i∑N(err(sn,yn)+αG∂s∂err(s,yn)∣s=sn)
=
1
N
∑
i
N
(
e
r
r
(
s
n
,
y
n
)
+
2
α
G
(
x
n
)
(
s
n
−
y
n
)
)
=\frac1N\sum_i^N (err(s_n,y_n)+2\alpha G(x_n)(s_n-y_n))
=N1i∑N(err(sn,yn)+2αG(xn)(sn−yn))
此时最小化损失函数等价于最小化第二项:
=
α
N
∑
i
N
2
(
s
n
−
y
n
)
G
=\frac{\alpha}N\sum_i^N 2 (s_n-y_n)G
=Nαi∑N2(sn−yn)G
≤
α
N
∑
i
N
(
(
s
n
−
y
n
)
+
G
)
2
\leq \frac{\alpha}N\sum_i^N ((s_n-y_n)+G)^2
≤Nαi∑N((sn−yn)+G)2即解为
G
=
−
(
s
n
−
y
n
)
G=-(s_n-y_n)
G=−(sn−yn)
如果直接把上面的解带入,对G没有任何限制,我们希望G不要太大,故把
G
2
G^2
G2加入最小化的第二式中。只要
G
2
G^2
G2足够小,加入
G
2
G^2
G2对损失函数的改变可以在
ϵ
\epsilon
ϵ内。又
α
\alpha
α是一个变量,所以我们可以使
G
2
G^2
G2足够小。则最小化可以用下式来近似:
α
N
∑
i
N
(
2
(
s
n
−
y
n
)
G
+
G
2
)
\frac{\alpha}N\sum_i^N (2 (s_n-y_n)G+G^2)
Nαi∑N(2(sn−yn)G+G2)
=
α
N
∑
i
N
(
(
y
n
−
s
n
)
−
G
)
2
−
(
y
n
−
s
n
)
2
=\frac{\alpha}N\sum_i^N ((y_n-s_n)-G)^2-(y_n-s_n)^2
=Nαi∑N((yn−sn)−G)2−(yn−sn)2
(
y
n
−
s
n
)
2
(y_n-s_n)^2
(yn−sn)2是一个常数项,为上一轮学习后,算法预测结果和真实值的残差方。则算法变成了拟合残差。
α
\alpha
α也可以像上面分类时一样求解出来。
使用回归cart算法作为基算法时,算法有个专门的名字——GBDT。其实仅仅也就是adboost的一种变种而已。adboost树是使用分类cart树作为基算法。
xgboost
xgboost是机器学习竞赛中的一大热门模型。
xgboost也是boosting家族中的一员。对GBDT做了一些改进。
先放上论文
数学原理
xgboost和boosting算法一样,构建一棵树后,计算出当前的得分,然后继续在当前的基础上构建下一棵树,把新的得分加入上一轮得到的得分。如下图 总共构建了两棵树。小男孩第一次的得分就是2+0.9=2.9。即模型是
y
^
i
=
ϕ
(
x
i
)
=
∑
k
f
k
(
x
i
)
,
    
f
k
∈
F
\hat y_i=\phi(x_i)=\sum_kf_k(x_i),\;\;f_k\in\mathcal{F}
y^i=ϕ(xi)=k∑fk(xi),fk∈F
F
=
{
f
(
x
)
=
w
q
(
x
)
}
\mathcal{F}=\{f(x)=w_{q(x)}\}
F={f(x)=wq(x)}
w
q
(
x
)
w_{q(x)}
wq(x)是叶子节点的分数,q(x)是叶子节点的索引生成函数。
GBDT是使损失函数最小,xgboost在他的基础上显示定义了正则项,避免过拟合。目标函数如下:
L
(
ϕ
)
=
∑
i
l
(
y
^
i
,
y
i
)
+
∑
k
Ω
(
f
k
)
L(\phi)=\sum_il(\hat y_i,y_i)+\sum_k \Omega(f_k)
L(ϕ)=i∑l(y^i,yi)+k∑Ω(fk)
Ω
(
f
k
)
=
γ
T
+
1
2
λ
∣
∣
w
∣
∣
2
\Omega(f_k)=\gamma T+\frac12\lambda||w||^2
Ω(fk)=γT+21λ∣∣w∣∣2
l
(
y
^
i
,
y
i
)
l(\hat y_i,y_i)
l(y^i,yi)是损失函数,T是当前树的叶子节点数。
由于上面的式子不容易直接优化,所以我们使用前向加法算法来优化。改写成加法的形式:
L
(
t
)
=
∑
i
l
(
y
i
,
y
^
i
(
t
−
1
)
+
f
t
)
+
Ω
(
f
t
)
L^{(t)}=\sum_i l(y_i,\hat y_i^{(t-1)}+f_t)+\Omega(f_t)
L(t)=i∑l(yi,y^i(t−1)+ft)+Ω(ft)
仍然使用二阶泰勒展开来近似目标函数。不过这里有点细微的差别,使用了二阶泰勒展开而不仅仅是一阶。二阶展开从数学上来说误差会更小,能加快收敛。另一主要原因是xgboost官网上说了,当损失函数为MSE时使用的是二阶展开,为了程序的扩展性,干脆全整成二阶展开了。展开如下:
L
(
t
)
=
∑
i
[
l
(
y
i
,
y
^
i
(
t
−
1
)
)
+
g
i
f
t
(
x
i
)
+
1
2
h
i
f
t
2
(
x
i
)
]
+
Ω
(
f
t
)
L^{(t)}=\sum_i [l(y_i,\hat y_i^{(t-1)})+g_if_t(x_i)+\frac12h_if_t^2(x_i)]+\Omega(f_t)
L(t)=i∑[l(yi,y^i(t−1))+gift(xi)+21hift2(xi)]+Ω(ft)其中
g
i
=
∂
y
^
i
(
t
−
1
)
l
(
y
i
,
y
^
i
(
t
−
1
)
)
,
g
i
=
∂
y
^
i
(
t
−
1
)
2
l
(
y
i
,
y
^
i
(
t
−
1
)
)
g_i=\partial_{\hat y_i^{(t-1)}}l(y_i,\hat y_i^{(t-1)}),g_i=\partial_{\hat y_i^{(t-1)}}^2l(y_i,\hat y_i^{(t-1)})
gi=∂y^i(t−1)l(yi,y^i(t−1)),gi=∂y^i(t−1)2l(yi,y^i(t−1))
定义在叶子节点j上的实例集:
I
j
=
{
i
∣
q
(
x
i
)
=
j
}
I_j=\{i|q(x_i)=j\}
Ij={i∣q(xi)=j}
常数项不影响目标函数的优化,忽略目标函数的常数项并展开
Ω
(
f
t
)
\Omega(f_t)
Ω(ft),如下:
L
(
t
)
=
∑
i
n
[
g
i
f
t
(
x
i
)
+
1
2
h
i
f
t
2
(
x
i
)
]
+
γ
T
+
1
2
λ
∑
j
T
w
j
2
L^{(t)}=\sum_i^n [g_if_t(x_i)+\frac12h_if_t^2(x_i)]+\gamma T+\frac12\lambda\sum_j^Tw_j^2
L(t)=i∑n[gift(xi)+21hift2(xi)]+γT+21λj∑Twj2
=
∑
j
T
[
(
∑
i
∈
I
j
g
i
)
w
j
+
1
2
(
∑
i
∈
I
j
h
i
+
λ
)
w
j
2
]
+
γ
T
=\sum_j^T[(\sum_{i\in I_j}g_i)w_j+\frac12(\sum_{i\in I_j}h_i+\lambda)w_j^2]+\gamma T
=j∑T[(i∈Ij∑gi)wj+21(i∈Ij∑hi+λ)wj2]+γT
=
∑
j
T
[
G
j
w
j
+
1
2
(
H
j
+
λ
)
w
j
2
]
+
γ
T
=\sum_j^T[G_jw_j+\frac12(H_j+\lambda)w_j^2]+\gamma T
=j∑T[Gjwj+21(Hj+λ)wj2]+γT
=
∑
j
T
1
2
(
H
j
+
λ
)
(
w
j
+
G
j
H
j
+
λ
)
2
+
γ
T
−
∑
j
T
(
G
j
H
j
+
λ
)
2
=\sum_j^T\frac12(H_j+\lambda)(w_j+\frac{G_j}{H_j+\lambda})^2+\gamma T-\sum_j^T(\frac{G_j}{H_j+\lambda})^2
=j∑T21(Hj+λ)(wj+Hj+λGj)2+γT−j∑T(Hj+λGj)2由此可知最佳解满足:
w
j
=
−
G
j
H
j
+
λ
w_j=-\frac{G_j}{H_j+\lambda}
wj=−Hj+λGj故最终的损失函数变为:
L
(
t
)
=
−
∑
j
T
(
G
j
H
j
+
λ
)
2
+
γ
T
L^{(t)}=-\sum_j^T(\frac{G_j}{H_j+\lambda})^2+\gamma T
L(t)=−j∑T(Hj+λGj)2+γT
GBDT和adboost构建树时都使用了启发式的准则(如Gini系数等),与目标函数无关。但xgboost将在这里有很大不同。
某个节点处的实例集为I,分裂后有
I
=
I
L
∪
I
R
I=I_L\cup I_R
I=IL∪IR。则在分裂前损失为
−
(
G
L
+
G
R
H
L
+
H
R
+
λ
)
2
+
γ
T
-(\frac{G_L+G_R}{H_L+H_R+\lambda})^2+\gamma T
−(HL+HR+λGL+GR)2+γT分裂后为
−
(
G
L
H
L
+
λ
)
2
−
(
G
R
H
R
+
λ
)
2
+
γ
(
T
+
1
)
-(\frac{G_L}{H_L+\lambda})^2-(\frac{G_R}{H_R+\lambda})^2+\gamma (T+1)
−(HL+λGL)2−(HR+λGR)2+γ(T+1)可知分裂后的损失减少为
−
(
G
L
H
L
+
λ
)
2
−
(
G
R
H
R
+
λ
)
2
+
(
G
L
+
G
R
H
L
+
H
R
+
λ
)
2
+
γ
-(\frac{G_L}{H_L+\lambda})^2-(\frac{G_R}{H_R+\lambda})^2+(\frac{G_L+G_R}{H_L+H_R+\lambda})^2+\gamma
−(HL+λGL)2−(HR+λGR)2+(HL+HR+λGL+GR)2+γ上式是求最小的值,故我们可以如下定义增益
G
a
i
n
=
(
G
L
H
L
+
λ
)
2
+
(
G
R
H
R
+
λ
)
2
−
(
G
L
+
G
R
H
L
+
H
R
+
λ
)
2
−
γ
Gain=(\frac{G_L}{H_L+\lambda})^2+(\frac{G_R}{H_R+\lambda})^2-(\frac{G_L+G_R}{H_L+H_R+\lambda})^2-\gamma
Gain=(HL+λGL)2+(HR+λGR)2−(HL+HR+λGL+GR)2−γ即如果继续分裂,则必须降低不纯度(即损失减少),建树时选择增益最大的特征来分裂。当得分增加小于
γ
\gamma
γ时停止分裂,在这里起到了预剪枝的作用。树的结构分数计算如下图: 由上我们可只xgboost计算快的原因:我们只需要在第一次分裂时计算一遍一阶导和二级导,每次分裂时只需要把对应实例集的一阶导和二级导相加,不再需要从新计算;同时各个样本的
g
i
g_i
gi、
h
i
h_i
hi都是独立的,能并行运算。
优化模型常用参数和一些模型实现细节
- eta:由上我们知道了优化目标函数的最佳方向就是构建损失最小的树(因为是对 f k f_k fk求最佳)。但是boosting中每棵树的权重是不一样的,越往后的树,其权重越小。xgboost也没有放弃这一点。故也通过shrinkage的方式来确定最佳步长。这能起到避免过拟合的作用。该参数默认为3。具体更新时把系数乘上该值后得最终步长。可以当成步长缩放器、初始步长。
- gamma:树分裂的的阈值,能很大程度上防止过拟合。但是最开始不要设置太大,可设置为0。否则有欠拟合的风险
- max_depth:树的层数,如果层数太多,①速度慢,②容易过拟合。默认为6,我通常设置3-5。如果样本够多,可以增加到10。基本上是最重要的参数了。
- min_child_weight :最小分裂权重和(二阶导数和),默认为1。当分裂后的二阶导数和小于阈值min_child_weight 时,停止分裂。可以如下理解。当误差为平方误差时,二阶导恒为 1 N \frac1N N1。min_child_weight 在一定程度上反应了叶子节点最小包含的样本数。能起到防止过拟合的作用。
- max_delta_step:更新时的最大步长,防止迈步太大。默认值为0.官网建议;当样本极度不平衡时可以设置为1-10
- subsample:样本采样率
- colsample_bytree, colsample_bylevel, colsample_bynode:
除了shrinkage,xgboost的另一防止过拟合的主要方式是引入列采样。以上三个的基本分别是:整体、层、节点。最终的采样率是三个值相乘。如果三个值都设置为0.8,则最终采样的列数只有原来的51.2%。通常只需要设置colsample_bytree就够了,我通常初始设置为0.7、0.8。 - alpha、lambda:分别对应L1、L2正则。通常gamma粗调,这两个细调。不过最开始时最好都设置为0.除非你已经明确它需要稀疏或者已经过拟合了。对于第二种情况最先的处理方式不是设置正则化参数,如处理outlier、重建特征工程。
- tree_method:默认为auto可选auto, exact, approx, hist, gpu_hist。在我们分裂时,一般情况下,xgboost使用贪心算法来选择最佳分割点。但如果特征取值很多,遍历选择最佳分割点时需要更多计算力。故**xgboost引入了近似算法。把特征取值排序,然后按百分位取值来确定分割点计算增益。这是xgboost的另一改进地方。**设置为自动时,当样本不是很多时使用贪心算法,多时使用近似算法。
- 处理样本不平衡:如果只关心AUC,则调整scale_pos_weight(默认为1,官网建议设置为负正样本实例数之比);如果关心正确率;则调整max_delta_step
- 处理过拟合:首先控制模型复杂度(对应参数:max_depth、 min_child_weight 、gamma);其次可以增加随机性(对应参数为subsample和列采样的三个参数);减小eta,同时增加迭代次数num_round
- 处理缺失值:xgboost自己拥有处理缺失值的能力。具体实现:分布把缺失样本放入右边和左边,最终把缺失值归入增益最大的那一个子节点。
- 引入了当前最火的深度学习中处理过拟合的方式——dropouts(只有当boost=dart时有用)、earlying stop
- 做特征选择:get_fscore()获取特征被选择来做最佳分裂特征的次数。通常次数越多越重要。
- base_score:默认为0.5,通常不需要调整。计算一阶导和二阶导时需要上一轮的输出值,在第一轮时我们需要设置默认值。设置为0.5即假设我们的预测准确率为50%。当样本很大时更改它对结果并没有太大影响。
- 一些好的地方:内置交叉验证,很容易获取最佳迭代次数;可以接着上一轮的模型进行学习;可以自定义目标函数和评价函数。
初步调参顺序:
- 设置初始值,通常eta不要设置太大,获取最佳迭代次数
- 调整拟合情况的参数:min_child_weight以及max_depth
- xgboost通常都会过拟合,处理过拟合。过拟合的顺序如下:gamma——>subsamplecolsample_bytree——>reg_alpha、reg_lambda
- 调小学习率,增加树的数量,减小偏差。重复1-4。
- 1-4只是大致的思路,通常没调整完一个参数就得观察学习曲线,判断是过拟合还是欠拟合,然后选择对应的参数来调整。

 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


