相关推荐
faceparsing_79999_iter.pth
faceparsing_79999_iter.pth,人脸分割faceparsing的预训练模型,PyTorch版本。
facsing-parsing之annotation merge oneannotation label
源码地址https://github.com/switchablenorms/CelebAMask-HQ/blob/master/face_parsing/Data_preprocessing/g_mask.py 代码功能为将分散的label也就是鼻子脸,头发等合成一个label 首先引入包,之后循环读入label,之后新建一个numpy大小为512,512 使用cv2读入, 返回h,w,c im_base[im!=0]=(idx+1) import os import cv2 import glob im
79999_iter.7z
来自github的zllrunning的face-parsing.PyTorch项目,这个是此项目的预训练模型(pre-trained model), 原链接是放在google drive的... 当用于Simswap的时候, 请把这个文件解压缩后放进目录:./parsing_model/checkpoint/
FaceParsing 项目使用教程
FaceParsing 项目使用教程 1. 项目目录结构及介绍 FaceParsing/ ├── data/ │ ├── celeba-hq/ │ ├── lfw/ │ └── ... ├── models/ │ ├── bisenet.py │ ├── resnet.py │ └── ... ├── utils/ │ ├── data_loader.py │ ├─...
Pytorch中CrossEntropyLoss()详解
交叉熵主要是用来判定实际的输出与期望的输出的接近程度。举个例子:在做分类训练的时候,如果一个样本属于第 K 类,那么这个类别所对应的输出节点的输出值应该为1,而其他节点的输出都为0,即 [0,0,1,0,….0,0] ,这个数组也就是样本的 Label,是神经网络最期望的输出结果。我们用交叉熵损失函数来衡量网络的实际输出与正确标签的差异,利用这种差异经过反向传播去更新网络参数。交叉熵:它主要刻画的是实际输出(概率)与期望输出(概率)的距离,也就是交叉熵的值越小,两个概率分布就越接近。
生成式引擎优化(GEO)全景指南:技术架构、实施策略与未来趋势
生成式引擎优化(GEO)全景指南摘要 GEO(生成式引擎优化)是针对AI生成内容(如ChatGPT、文心一言等)的优化策略,通过结构化数据、权威建设与语义优化提升企业内容在AI答案中的引用优先级,实现“无点击曝光”。其核心价值在于从流量竞争转向信任构建,突破传统SEO局限。技术架构依托RAG(检索增强生成)、向量数据库及反馈学习机制,动态优化内容生成与引用逻辑。实施策略包括:部署结构化数据(如JSON-LD)、维护动态知识图谱、适配多模态内容(3D/VR)、联合权威机构发布白皮书。行业案例显示,美妆、智能家
人脸解析(Face Parsing)和人体解析Human Parsing:方法、数据集和论文
人脸解析 人脸解析(Face Parsing)即把人脸的各个部分分割出来。下图左侧是原图,中间是标注,右侧是我输出的结果: 这方面网上资料不多,论文也不火,很少看到商用的。目前看到华为有提供这个功能。 华为人脸解析地址:https://developer.huawei.com/consumer/cn/hiai/engine/face-parsing 人脸解析可预见的应用场景就是虚拟试妆,或者电...
ABP框架实战:从零搭建多租户应用(含完整代码示例)
本文详细介绍了如何使用ABP框架从零构建多租户SaaS应用,涵盖多租户架构设计、数据隔离实现、租户管理及性能优化等核心内容。通过完整的代码示例,帮助开发者快速掌握企业级数据隔离系统的开发技巧,提升SaaS应用开发效率。
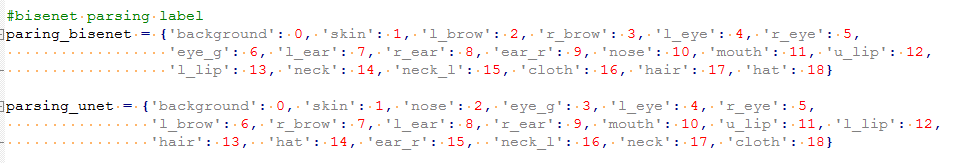
BiSeNet脸部解析
BiSeNet脸部解析
Ubuntu 24.04 新增用户并禁用 root 账户操作指南
Python爬取腾讯视频m3u8加密流实战(附完整代码)
本文提供了一份详细的Python实战教程,指导如何通过抓包分析、模拟请求头与载荷,破解腾讯视频的m3u8加密流防盗链机制,并附上完整代码实现视频片段的下载与合并。教程涵盖从侦察到代码实现的完整流程,并包含参数动态化、多线程下载等高级技巧与避坑指南,旨在帮助开发者掌握流媒体下载的核心技术。
jonathandinu/face-parsing用户体验设计:API易用性与文档优化
jonathandinu/face-parsing是一款基于Transformer的面部语义分割工具,能够精准识别面部18个关键区域,为开发者提供简单高效的人脸解析解决方案。无论是Python后端开发还是浏览器端应用,都能通过直观的API快速实现专业级面部特征提取。 ## 核心功能:从像素到语义的智能转换 🧠 面部解析技术通过语义分割算法将人脸图像分解为多个独立区域,为美颜美妆、虚拟试戴、表
二、FM1288调试方案-工具软件使用
分析音频数据的软件需要满足以下几点:1、能打开原始pcm音频文件;2、基本的音频播放软件的操作;3、能查看分析音频数据的频率成分;4、能查看分析音频音量幅度;5、能完成基本音频处理:降噪、音量增幅限幅、滤波和均衡;
人脸解析技术实战指南:3步掌握Face Parsing核心应用
人脸解析技术作为计算机视觉领域的重要分支,正在重塑我们对面部识别和图像处理的理解。jonathandinu/face-parsing项目基于Segformer架构,通过19个精细类别实现了对人脸区域的精准分割,为美颜特效、虚拟试妆、人脸动画等应用提供了强大的技术支撑。我们将从核心理念出发,逐步深入实践路径,最终探索深度应用场景,帮助开发者全面掌握这项前沿技术。 ## 🔍 核心理念:为什么需要人
Oracle EBS 寄销/VMI(2)-->采购篇
上篇有一部分设置需要建BPA后,将BPA编号与批准的供应商相关联. 本篇主要是讲的内容:一揽子采购协议-->准标采购订单-->收接入库-->子库转移-->创建冲减通知-->'按接收开票' 自动开票程序 1. PO-->采购订单à采购订单 创建一揽子采购协议,确定物料
基于反事实的因果推理Causal inference based on counterfactuals--一万六千字文献详细解读(因果关系的推理应用)【全文总结】
基于反事实的因果推理Causal inference based on counterfactuals--一万六千字文献详细解读(因果关系的推理应用)【全文总结】---来自一位即将入学的准研一,也希望这篇文章能够激励自己不断走下去!!
开发者必看!jonathandinu/face-parsing深度开发指南
jonathandinu/face-parsing是一款基于Segformer架构的面部解析工具,能够精准识别并分割人脸的19个关键区域,包括皮肤、鼻子、眼睛、眉毛等。本文将为开发者提供完整的开发指南,帮助你快速集成这一强大功能到自己的项目中。 ## 核心功能解析 ✨ 该项目采用SegformerForSemanticSegmentation架构,通过多层注意力机制实现高精度面部特征分割。模型
老版QQ原生表情gif动态
这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。
人脸解析模型部署与调优:5 步跑通生产级推理
做美颜、试妆或 AR 滤镜的第一步,都是把人脸切成头发、五官、配饰等独立区域。当你需要在实时视频通话里输出面部语义标注,jonathandinu/face-parsing 这个人脸解析模型可以直接把一张人像转成 19 类逐像素掩码,CPU 就能跑,适合作为整条特效链路的起点。 ## 模型速览:输入、输出与能力边界 它是基于 nvidia/mit-b5(Segformer B5)在 CelebA
ET2012新版免狗免安装绿色软件
ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,
温度PID控制PLC程序
温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值
how2:革命性AI命令行工具,让终端搜索告别繁琐流程
在命令行环境中寻找正确的命令语法和参数组合常常让开发者和系统管理员感到头疼。传统的解决方案需要翻阅冗长的手册页面,或者在浏览器中搜索Stack Overflow答案。现在,how2工具的出现彻底改变了这一局面,将人工智能的强大能力直接融入终端环境,让命令行搜索变得前所未有的简单高效。 ## 🔍 什么是how2? how2是一个革命性的AI命令行工具,它能够理解你的自然语言问题,并立即返回相应
Camera2Demo
在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作
LogAI完全指南:开源日志智能分析框架如何革新你的系统监控
LogAI是一款一站式开源日志智能分析框架,它支持日志摘要、日志聚类、日志异常检测等多种日志分析任务。通过采用OpenTelemetry数据模型,LogAI能够与不同的日志管理平台兼容,为系统监控带来全新的革新体验。 ## 一、LogAI简介:重新定义日志分析的开源工具 在当今复杂的系统环境中,日志数据犹如系统的“脉搏”,蕴含着丰富的运行状态信息。然而,传统的日志分析方法往往面临效率低下、准确
Ludwig低代码框架实现大模型LoRA微调实战
大语言模型微调(Fine-tuning)是将预训练能力适配到垂直场景的核心技术,其本质是通过参数高效方法(如LoRA)在冻结主干权重的前提下注入任务知识。LoRA通过低秩矩阵分解实现轻量更新,显著降低显存与计算开销,已成为中小算力环境下落地微调的主流选择。Ludwig作为开源低代码AI框架,将模型、适配器、提示模板与训练策略解耦为声明式YAML配置,自动完成Tokenizer集成、模块发现、QLoRA优化及推理一致性保障,使LoRA微调从环境调试密集型工程降维为业务可参与的配置任务。本文基于Qwen、Mis
Dolphin 文档图像解析模型实战指南:两阶段异构锚点提示架构、部署安装与三种解析方式
本篇技术指南以 Dolphin(**Do**cument Image **P**arsing via **H**eterogeneous Anchor Prompt**in**g,ACL 2025 论文开源项目)官方 [README.md](https://link.gitcode.com/i/dab799c75fcd6e66a81772befb3344f4) 为核心脉络,系统讲解其"分析-解析"
生产级NLP库选型指南:5个经三年实战验证的GitHub项目
自然语言处理(NLP)工程落地中,模型能力只是起点,真正决定系统稳定性的核心在于底层库的生产就绪度。本文从中文分词、命名实体识别(NER)、预训练模型推理、文本标准化到依存句法分析等基础技术环节切入,解析库在内存控制、长文本处理、GPU资源调度、CI/CD兼容性及中文语义鲁棒性等关键维度的表现逻辑。重点围绕Transformers和spaCy两大高频搜索关键词展开,揭示其在真实服务场景中的性能边界与隐藏陷阱——例如Transformers的from_pretrained网络依赖风险、spaCy中文NER对嵌
本地证件照平台搭建:ONNXRuntime+Gradio+OpenCV轻量部署指南
证件照生成是计算机视觉在日常办公中的典型落地场景,其核心涉及人脸检测、语义分割、图像几何校正与背景合成等基础技术。传统方案依赖云端API或臃肿客户端,存在隐私泄露、响应延迟与跨平台兼容性差等问题。基于ONNXRuntime的模型推理、Gradio的零前端交互构建、OpenCV原生C++图像管线,可实现纯本地、低资源、高可控的端到端处理。该技术组合显著降低部署门槛,支持Windows/macOS/Linux及树莓派等边缘设备,满足GB/T 14991-2021等合规要求,适用于政务自助终端、家庭办公及开发者二
Transformers 模型家族全景:从 ViT、BERT 到 Whisper,按编码器-解码器视角分类 Transformer 模型
本文基于 Transformers 仓库文档 `docs/source/ar/model_summary.md`(“Transformer 模型家族”章节)整理并扩充,按照“编码器 / 解码器 / 编码器-解码器”这一架构视角,系统梳理计算机视觉、NLP、音频、多模态与强化学习五大领域中经典 Transformer 模型的设计动机、预训练目标与结构差异。读完本文,你可以快速定位任意一个 Trans
pyannote.audio说话人分离实战:从安装认证到生产调优的7步走通
多人会议、呼叫中心坐席通话这类录音,绕不开一个问题:每一段话到底是谁说的。pyannote.audio 说话人分离 pipeline 就是解决这件事的开源 Python 工具。本文面向有 Python 基础、在 Hugging Face 上下载过模型、但没接触过语音分析的开发者,目标是十分钟内跑通最小 demo,并说清楚它在生产链路中的位置:输入一段音频,输出一份带说话人标签的转写时间轴。 ##

253


被折叠的 条评论
为什么被折叠?