Java实现PDF文字内容识别,结合OCR实现PDF图片实现

使用Tesseract-OCR识别图片中的文字并生成双层PDF 识别图片中的文字并不是很困难。如果自己训练一个文字识别的深度学习程序去识别也是可以,但是太费劲。 Tesseract-OCR是一个开源的文字识别引擎,并且支持包括中文在内的多国语言。只要将语言配置上去,就可以识别对应的语言。 如果是印刷字体,识别是没有问题的,几乎是100%准确识别,一般用于识别印刷体的话是不需要再另外训练的,如果要识别手写体就需要额外的训练,这部分以后有时间再研究。 下面是... 阅读详情
AI摘要

博客介绍了使用UMI - OCR、PDFBOX插件实现PDF文字识别的思路。先通过PDFBOX识别文字,若为图片则调用OCR识别;OCR识别慢且长图有问题,需用PDFBOX转图片再拼接。还给出UMI - OCR下载地址、安装设置及PDFBOX配置等内容。

使用插件:UMI-OCR、PDFBOX

实现思路:通过PDFBOX识别PDF文字,如果是图片,则识别不出来,再调用OCR进行识别返回文字;OCR识别较慢,长图识别不出来,目前HTTP方式只支持图片格式,还需使用PDFBOX要将每一页PDF转换为图片再进行识别拼接。

UMI-OCR下载地址:https://github.com/hiroi-sora/Umi-OCR/releases/latest

git仓库地址:GitHub - hiroi-sora/Umi-OCR: OCR software, free and offline. 开源、免费的离线OCR软件。支持截屏/批量导入图片,PDF文档识别,排除水印/页眉页脚,扫描/生成二维码。内置多国语言库。

下载后直接在WIN系统安装(目前只支持WIN系统),安装包内含PaddleOCR-json,无需再进行下载;安装启动,设置HTTP请求参数
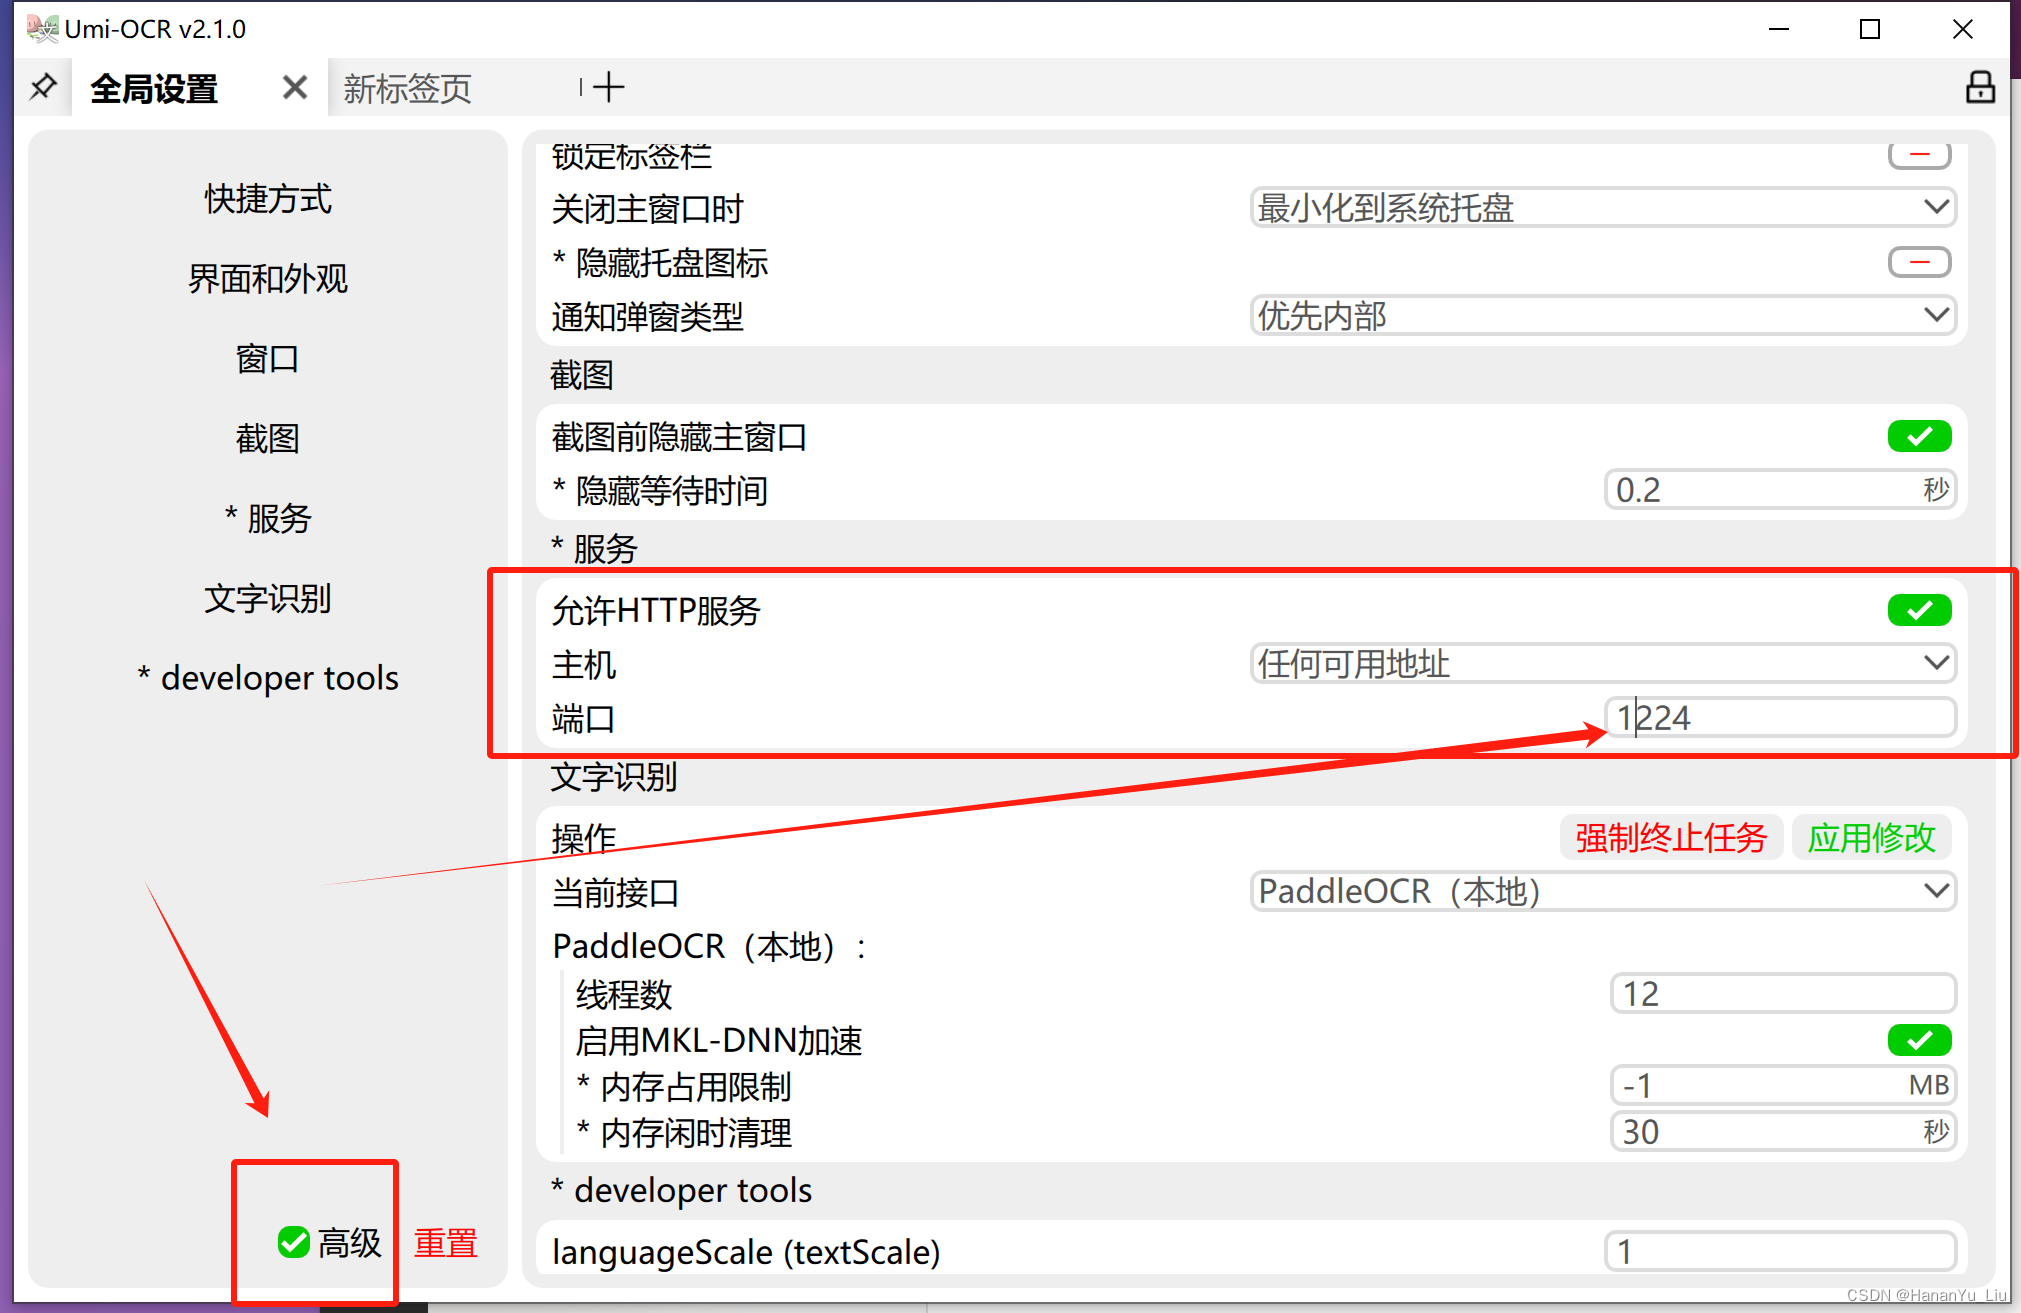
全局设置 --> 高级 --> 允许HTTP服务:

主机设置为:任何可用地址

端口:自己设置

PDFBOX MAVEN版本配置:

 <!-- PDF文档处理 -->
        <dependency>
            <groupId>org.apache.pdfbox</groupId>
            <artifactId>pdfbox</artifactId>
            <version>2.0.8</version>
        </dependency>

代码实现文字识别:

String text = "";
        try {
            PDDocument pdDocument = PDDocument.load(image.getInputStream());
            PDFTextStripper pdfTextStripper = new PDFTextStripper();
            //读取pdf中所有的文件
            //前端HTML不识别><,需要进行更换
            text = pdfTextStripper.getText(pdDocument);
            text = text.replace(" ", "")
                    .replace("\r", "")
                    .replace("\t", "")
                    .replace("\n", "");
            if (StrUtil.isNotEmpty(text)){
                text = text.replace("<","&lt;").replace(">","&gt;");
            }else{
                /**
                 * 如果没有识别到文字,
                 * 则转成图片
                 * 进行OCR识别获取文本
                 */
                text = uploadPDF2OcrGetText(accessUrl, image);
            }
        }catch (IOException e){
            log.error(e.getMessage());
        }

如果文档里面含有"<"">",前端HTML不识别,则需要进行转换

uploadPDF2OcrGetText:
    /**
     * 上传图片文件至OCR
     * @param accessUrl 访问地址
     * @param image 图片文件
     * @return
     */
    public static String uploadPDF2OcrGetText(String accessUrl, MultipartFile image) {
        List<ByteArrayOutputStream> list = getStreamList(image);
        StringBuilder sb = new StringBuilder();
        if (list != null && !list.isEmpty()){
            for (ByteArrayOutputStream outputStream : list) {
                String str = getData(accessUrl, outputStream);
                if (StrUtil.isNotEmpty(str)){
                    sb.append(str);
                }
            }
        }
        return sb.toString();
    }

将PDF转为图片流方法getStreamList:

    /**
     * PDFBOX将PDF转成png流
     * @param file 图片文件
     * @return List
     */
    public static List<ByteArrayOutputStream> getStreamList(MultipartFile file) {
        List<ByteArrayOutputStream> list = new ArrayList<>();
        try{
            PDDocument pdf = PDDocument.load(file.getInputStream());
            PDFRenderer renderer = new PDFRenderer(pdf);
            int pageCount = pdf.getNumberOfPages();
            for (int i = 0; i < pageCount; i++){
                BufferedImage image = renderer.renderImageWithDPI(i, 120);//120为DPI根据自己设置
                ByteArrayOutputStream bas = new ByteArrayOutputStream();
                ImageIO.write(image, "png", bas);
                list.add(bas);
            }
        }catch (IOException e){
            log.error(e.getMessage());
        }
        return list;
    }

调用OCR识别文字方法getData:

 /**
     * 上传图片文件至OCR
     * @param accessUrl 访问地址
     * @param outputStream 图片流
     * @return
     */
    public static String getData(String accessUrl, ByteArrayOutputStream outputStream){
        //转换为Base64
        String base64Image = new String(Base64.encodeBase64(outputStream.toByteArray()));
        //如果文件属于图片则进行文件转换
        JSONObject jb = new JSONObject();
        jb.set("base64", base64Image);
        JSONObject jb1 = new JSONObject();
        jb1.set("tbpu.parser", "multi_para");
        jb1.set("data.format", "text");
        jb.set("options", jb1);
        String result2 = HttpRequest.post(accessUrl)
                .body(jb.toString())//表单内容
                .timeout(300000)//数据可能较大,超时时间调的较长
                .execute().body();
        JSONObject jsonObject = JSONUtil.parseObj(result2);
        String text = null;
        if ("100".equals(jsonObject.getStr("code"))){
            text = jsonObject.getStr("data");
        }
        return text;
    }
PDFBox + Tess4J 从PDF中提取图片OCR识别文字 一个完整的 Java 示例,展示如何使用 PDFBox + Tess4J 从 PDF 中提取图片,并通过 OCR 识别图片中的文字 阅读详情

相关推荐

java识别pdf图片中的文字

java识别pdf图片中的文字,代码,demo,都有

Java识别获取pdf中文字信息(此方法任意pdf的信息都可以拿到)

Java识别获取pdf中文字信息(此方法任意pdf的信息都可以拿到) 平时工作或者开发过程中如果遇到需要识别pdf发票中信息的情况,如获取发票代码号码,开票日期,校验码等,比如下面的发票,项目中需要读取发票中信息使用java中的pdfbox组件引用jar包使用,其中PDFTextStripper负责读取pdf中的文字信息,使用正则表达式寻找文字信息或者使用字符串定位寻找信息首先在pom文件中引用pdfbox, 引用pdfbox代码如下

卓怡工作室的博客 1万+

Java调用OCR进行图片识别[归纳].pdf

Java调用OCR进行图片识别[归纳].pdf

一段比较浅显易懂的java识别pdf 文字及图片

图片有些问题 如果图片在保存的时候修改了他的原本后缀则识别会提示与原先图片类型不符(比如原先的图片是png后缀改成jpg就识别不了);另识别出来的文字会有乱码和多余的一些符号。使用pdfbox及orc进行pdf文件的文字及图片的识别。运行可以得到pdf 的相关文字图片信息。

weixin_39209728的博客 3433

Java 读取PDF中的文本和图片的方法

本文将介绍通过Java程序来读取PDF文档中的文本和图片的方法。分别调用方法extractText()和extractImages()来读取,需要的朋友可以参考下

四阶龙格库塔法求解一次常微分方程组(python实现)

之前在博客发布了关于使用四阶龙格库塔方法求解一次常微分方程组的文章,由于代码缺少具体的验证,部分朋友可能存在疑问,因此这里打算再重新写一篇博客来验证一下程序的正确性,另外,这里是使用python语言来实现的。

HelloWorldTM的博客 8543

Java识别图片或扫描PDF中的文字

本文详细介绍了如何使用JAVA识别图片和扫描PDF中的文字。包含详细的步骤介绍和代码示例。

nuclear2011的博客 6473

高分六号GF-6 WFV数据处理全流程:从原始数据解压到经纬度投影转换

本文详细解析了高分六号GF-6 WFV遥感数据的完整处理流程。从原始数据解压与分块结构理解入手,指导如何安装ENVI国产卫星支持工具进行自动拼接,并重点阐述了利用RPC模型进行正射校正以消除几何畸变,以及将UTM投影转换为地理经纬度坐标的关键步骤。文章旨在帮助用户高效地将原始卫星数据转化为可直接用于农业监测、生态环境分析等领域的标准地理空间图像。

weixin_29047919的博客 196

【项目管理】Java OCR实现图片文字识别

Java OCR实现图片文字识别

李晋江的博客 2万+

RC滤波电路实战解析:无源与有源设计的性能对比与应用选择

本文深入解析了RC滤波电路的核心原理,重点对比了无源滤波电路与有源滤波电路的性能差异。文章通过实测波形与仿真数据,详细阐述了两者在带载能力、频率响应精度、噪声特性等方面的优劣,并提供了清晰的应用选择指南,帮助工程师根据信号属性、负载条件和性能要求做出最优设计决策。

weixin_29268637的博客 431

树莓派计算模块摄像头连接与配置全攻略:从硬件跳线到软件驱动

在嵌入式视觉项目中,摄像头模组的连接与驱动是图像采集和视频分析的基础。其核心原理是通过CSI-2高速串行接口协议传输图像数据,并依赖I2C总线进行传感器寄存器配置。这一技术方案的价值在于为工业控制、机器人等嵌入式设备提供了稳定、高性价比的视觉感知能力。在实际应用中,开发者常面临摄像头无法识别、I2C通信失败等挑战,尤其是在使用树莓派计算模块时,其硬件接口需要通过I/O板引出,配置过程涉及设备树参数调整等关键步骤。本文聚焦于解决这些实际问题,详细拆解了从硬件连接到软件驱动的完整流程,特别是针对CM4、CM3+

weixin_29184075的博客 337

Java 实现 图片OCR文字识别

Java 实现图片OCR文字识别功能 前言: 由于网上很多算法, 以及语言库无法做到精准识别, 所以综合条件下 使用了一款 space OCR API 的产品进行使用, 每个月有25000条的 使用额度, 日常使用或开发绰绰有余 网址链接 : https://ocr.space/OCRAPI 一. 注册 API 秘钥 1. 进入网址点击下面的注册链接输入自己的邮箱以及开发用途就会收到一个秘钥 2. 注册好的API如下 二. API解析 1. 上传方式选择 通过阅读API 文档我们可以得知, 发

weixin_45213446的博客 1万+

TSmaster CANFD配置避坑指南:为什么你的PCAN盒不支持最新版本?

本文针对TSmaster配置PCAN硬件进行CANFD通信时的常见问题,提供了详细的避坑指南。重点解析了CANFD配置中TSEG1等关键参数的理解误区,并深入探讨了TSmaster新版本与PCAN硬件驱动之间的兼容性变化,帮助工程师快速定位并解决连接失败或无法发送CANFD报文等问题。

alpha的博客 546

利用百度AI OCR图片识别,Java实现PDF中的图片转换成文字

序言:我们在读一些PDF版书籍的时候,如果PDF中不是图片,做起读书笔记的还好;如果PDF中的是图片的话,根本无法编辑,做起笔记来,还是很痛苦的。我是遇到过了。我们搞技术的,当然得自己学着解决现在的痛点。 一. 现状 为了不重复造轮子,当然得看看现在市面上是否有已经实现过的,如果有,那自然是拿来即用。 首先,说说一些在线版的PDF图片转文字,对文件大小有限制为2M(似乎有很多的文件处理都是限制...

weixin_30325793的博客 883

红外小目标检测新思路:当DETR遇上Mamba状态空间模型,速度提升3倍

本文探讨了将Mamba状态空间模型与DETR框架结合,用于解决红外小目标检测的难题。该创新方案通过线性复杂度的Mamba模块替代传统Transformer的自注意力机制,在保持高检测精度的同时,显著提升了推理速度,实现了实时性能的突破,为无人机巡检、安防监控等场景提供了高效解决方案。

hhh00的博客 666

【人工智能】国产开源大模型聊天 AquilaChat 快速开始上手实战&效果评测

Aquila语言大模型在技术上继承了GPT-3、LLaMA等的架构设计优点,替换了一批更高效的底层算子实现、重新设计实现了中英双语的tokenizer,升级了BMTrain并行训练方法,在Aquila的训练过程中实现了比Magtron+DeepSpeed zero-2将近8倍的训练效率。Aquila语言大模型是在中英文高质量语料基础上从0开始训练的,通过数据质量的控制、多种训练的优化方法,实现在更小的数据集、更短的训练时间,获得比其它开源模型更优的性能。

AI天才研究院 2万+

java使用Tess4J实现OCR图片文字识别

Tess4J是 Tesseract OCR 的 java api 实现库,你可以通过 java 调用来轻松的实现图片识别并提取文字,也就是 OCR 图片提取文字技术。TIFF、JPEG、GIF、PNG 和 BMP 图像格式多页 TIFF 图像PDF文档格式Tesseract OCR的github官网Tesseract OCR 使用手册Tess4J 官网。

西凉的悲伤博客 1万+

PCL RANSAC拟合直线并插值

空间直线线性插值的原理与实现方法。

点云侠的博客 137

java读取图片、PDF中图片上的文字

java获取pdf、图片中的文字

qq_38653981的博客 4300

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

java识别pdf图片中文字_java从图片中识别文字

package com.dream.common;import java.awt.image.BufferedImage;import java.io.File;import java.io.IOException;import java.util.Iterator;import java.util.Locale;import javax.imageio.IIOImage;import javax...

weixin_39633134的博客 1246

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

java读取图片文字

java自动读取图片文字信息代码片工具类 java中识别文字使用的软件是tesseractocr(使用的版本是3.02,3以后的版本才支持中文),这个软件需要安装在本地电脑中,安装的过程中全部都按照默认进行安装(以便于Java直接调用), 想要完整的程序私信我 ,打包下载完成后导入即可运行测试。 代码片 代码片. public class ImageIOHelper { //设置语言 ...

qq_35571894的博客 6368

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

java ocr引擎_java 实现 OCR 图片文字识别

OCR图像识别技术的JAVA实现最近有个需求需要用图像识别,学习记录一下。目前网络上的开源的图像识别技术有很多,例如 OCRE(OCR Easy)、Clara OCR、OCRAD、TESSERACT-OCR 等。今天本blog将记录下tesseract-ocr的JAVA实现,便于以后查阅使用。开源 ocr 引擎我们本次直接以排名第一的 TESSERACT-OCR 作为例子。TESSERACT-OC...

weixin_42300879的博客 3268

java中如何实现OCR文字提取

java 实现ORC文字提取

qq_36566311的博客 2161

java 把pdf图片文档和文章文档转成文字的方法(此方法不好用,转换成文字可以,转成pdf不行)

java 把pdf图片文档和文章文档转成文字的方法

liuruiaaa的博客 2729

Java实现pdf/word文字识别,调用OCR提取图片文字聚合

【代码】Java实现pdf/word文字识别,调用OCR提取图片文字聚合。

chen的博客 1773
上一篇: Bash命令启动、关闭、重启Jar包
下一篇: 【搜索引擎1】Ubuntu通过deb方式安装ElasticSearch和Kibana、ik中文分词插件
HananYu_Liu
博客等级 码龄10年 99粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值