


【GPT入门】第69课 分类任务: 基于BERT训练情感分类与区别二分类本质思考
1. 方案设计
2. 数据介绍
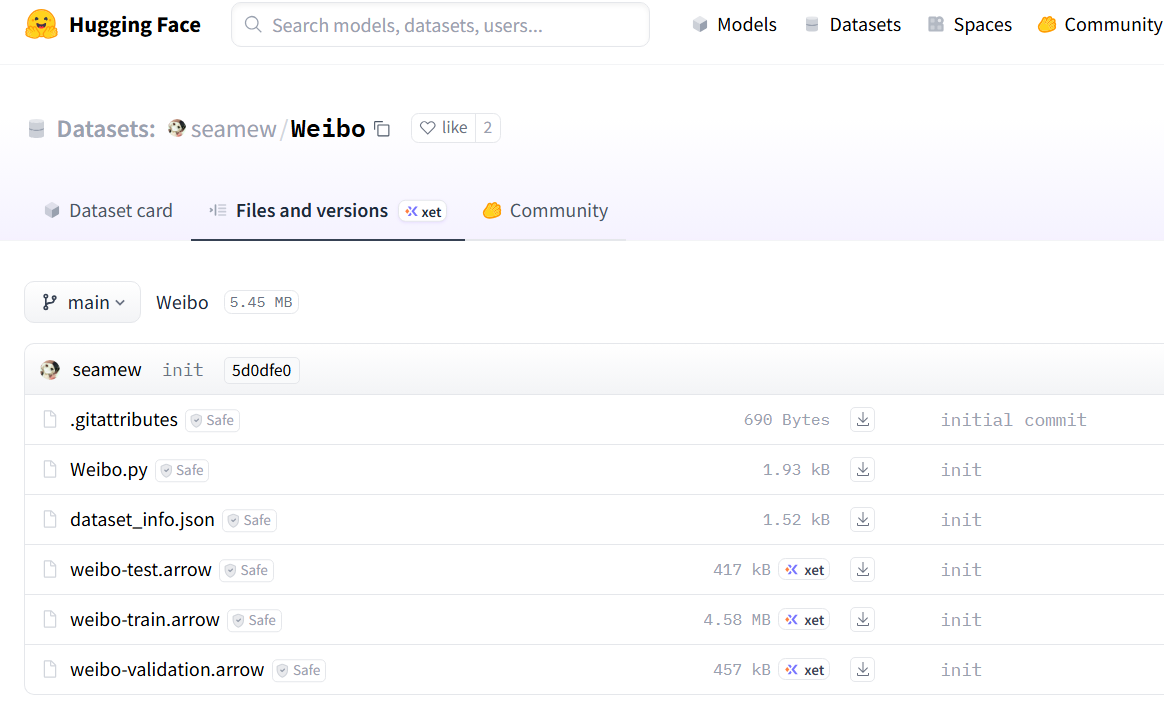
2.1 下载微博情感分类数据
命令行下载:
huggingface-cli download --repo-type dataset seamew/Weibo --local-dir /root/autodl-tmp/xxzh/bert/weibo_data2
seamew/Weibo
2.2 数据样例
7,怎么送?
7,为节目忽悠呗~
7,"老头子:老太婆,我想求你一件事。"
7,太平天国刑律规定,男女别营,授受不亲,夫妻之间私自约会,按律处斩.
7,回复,帖子里面一个是231的破解版本,一个是231的完全镜头解密文件,用同步助手等第三方PC端软件上传到指定的目录里,就能使用了。
2,[1/2]三八妇女节快乐[哈哈]怎么刚好在这天我们就九个月了呢?
7,现在的国债法定上限为14.3万亿美元,预计将在7月前后冲击这一上限,如果国会不能立法提高该上限,则美国国债将出现违约。
2,"[晕][晕][晕][晕] 其实我还是刚出生得婴儿啦[害羞] [害羞] [害羞] ,[六一快乐] 各位六一快乐[六一快乐] !"
4,死圣母
7,鼓励、支持企业跨地区重组并购,加强产业资源整合。
7,我才发现原来是奔G……
7,敢问你还能活到下一个11年11月11日吗!
7,我想看到 我在寻找 那所谓的爱情的美好
1,"别说血性,你们能有点幽默感就算对得起生你们的女人了."
7,形象需要重塑~~
7,本次选举的一大亮点是鼓励党外人士和自荐候选人参选国会代表。
3,下午真的痛晕了。
2,集体的力量,我感受到了集体的力量就是:再累,为了不掉队也要坚持,还有在险处有人提醒或帮扶一把,再就是发现自己不是那么差劲,[哈哈] 一路上捡拾垃圾,发现自己眼神真好使,那么小的糖纸被树枝压着都能看见,不过我只负责看不管捡,这次,真的有些累了,下次,下次......
3,不是我不能原谅你,而是我无法原谅我自己。
2,老天不负苦心人昂!!!
5,各种店铺,市场都关了,连洗澡堂和药店也关了,整个商业停摆了,连瓶酱油都买不到!
7,岁月总是一晃就那么多年,小时候不顾一切的想要离开家,长大了又不顾一切的想回去。
2,我反应一向很迟钝哈~~嘿嘿~~加油加油加油~~~明天要破釜沉舟的奋战哈~~~为了你·我这个胆小菇都变成不怕死不怕毒的大蘑菇;啦~~~~~!!!
2,哈哈哈哈~
0,求TB链接~ 还有那本《洋溢幸福的青苔小世界》小妖同学不要太喜欢哦!
7,那些纠结李赫宰进M的傻瓜们~就算赫宰进了M 他也会好好照顾自己的。
3,我的世界,你不在乎;你的世界,我被驱逐。
7,亲,快来“分担”一下吧!
7,#素食主义#
3,回到宿舍连续拉肚子,崩溃…
1,再扣除出让金和土增税又如何呢?
7,这时候的认真和专业,在成品里会展现的淋漓尽致!
4,看到这个帖子我就想说句:TMD!
7,加油吧…
7,细看则是山谷幽深、云气缭绕、万仞深涧。
7,好吧,我偷懒了,手脚神马的……
3. 训练
3.1 代码
import os
import numpy as np
import torch
from datasets import load_dataset, DatasetDict
import transformers
from transformers import (
    AutoModelForSequenceClassification,
    AutoTokenizer,
    TrainingArguments,
    Trainer,
    DataCollatorWithPadding
)

# 检查transformers版本
transformers_version = transformers.__version__
print(f"Transformers版本: {transformers_version}")
eval_strategy_param = "eval_strategy" if transformers_version >= "4.17.0" else "evaluation_strategy"
save_strategy_param = "save_strategy" if transformers_version >= "4.17.0" else "save_strategy"

# 设备配置
device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"使用设备: {device}")

# ----------------------
# 配置参数
# ----------------------
class Config:
    model_path = "/root/autodl-tmp/models_xxzh/bert-base-chinese/models--bert-base-chinese/snapshots/8f23c25b06e129b6c986331a13d8d025a92cf0ea"

    # 本地数据集路径(关键修改)
    data_dir = "/root/autodl-tmp/xxzh/bert/data_weibo"
    train_file = os.path.join(data_dir, "train.csv")
    test_file = os.path.join(data_dir, "test.csv")
    val_file = os.path.join(data_dir, "validation.csv")

    # 训练参数
    output_dir = "./bert_weibo_sentiment_local"
    num_labels = 8
    batch_size = 200
    learning_rate = 2e-5
    num_train_epochs = 10
    max_length = 128
    logging_dir = "./logs/weibo_local"
    logging_steps = 100
    eval_strategy = "epoch"
    save_strategy = "epoch"
    save_total_limit = 3
    device = device

# ----------------------
# 数据加载与预处理 - 核心修改
# ----------------------
def load_and_preprocess_data(config):
    # 1. 检查文件是否存在
    required_files = [config.train_file, config.test_file, config.val_file]
    for file in required_files:
        if not os.path.exists(file):
            raise FileNotFoundError(f"数据集文件不存在: {file}")

    # 2. 使用load_dataset的csv格式加载(按要求修改)
    dataset_train = load_dataset(path="csv", data_files=config.train_file, split="train")
    dataset_test = load_dataset(path="csv", data_files=config.test_file, split="train")
    dataset_val = load_dataset(path="csv", data_files=config.val_file, split="train")

    # 3. 构建DatasetDict
    dataset = DatasetDict({
        "train": dataset_train,
        "test": dataset_test,
        "validation": dataset_val
    })
    print(f"数据集结构: {dataset}")
    print(f"数据集样例: {dataset['train'][0]}")  # 打印第一条数据,确认列名是否正确

    # 4. 加载分词器
    tokenizer = AutoTokenizer.from_pretrained(config.model_path)

    # 5. 预处理函数(注意:需与CSV中的文本列名匹配)
    def preprocess_function(examples):
        # 假设CSV中的文本列名为'review',标签列为'label'
        # 若实际列名不同(如'text'),需修改此处
        return tokenizer(
            examples["text"],
            truncation=True,
            max_length=config.max_length,
            padding="max_length"
        )

    # 6. 应用预处理
    tokenized_dataset = dataset.map(preprocess_function, batched=True)

    # 7. 格式化标签列
    tokenized_dataset = tokenized_dataset.rename_column("label", "labels")
    tokenized_dataset.set_format("torch", columns=["input_ids", "token_type_ids", "attention_mask", "labels"])

    return tokenized_dataset, tokenizer

# ----------------------
# 评估指标(不变)
# ----------------------
def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return {"accuracy": (predictions == labels).mean()}

# ----------------------
# 训练模型(不变)
# ----------------------
def train_model(config):
    tokenized_dataset

 420


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


