


泰坦尼克号数据处理
【1】 实验目录
- 1 解释步骤
- 2 处理数据
- 3 数据可视化
- 4 修改数据
- 5 训练模型
【2】 实验步骤
1 解释步骤
*  识别和定义问题
 * 获取训练和测试数据
 * 质疑,准备,清理数据
 * 分析,识别模式并探索数据
 * 建模,预测并解决问题
 * 可视化,报告并提出问题解决步骤和最终解决方案
 * 提供并提交结果
首先了解一下问题的定义:在泰坦尼克号沉船事
件中,有人幸存了就有人牺牲,那有什么因素会影响到成员的幸存几率了?这就是问题所在。
 所以,实验中会提供两份数据列表,一份是带有分类结果的有多项特征(因素)的数据
然后用前一份数据(之后称为训练数据)来训练学习模型,后一份数据(之后称为测试数据)
 用在学习模型上得到测试结果(就是分类测试数据)
 这里有几条信息要注意一下:
 * 1912 年 4 月 15 日,泰坦尼克号首次航行,然后撞上冰山后沉没,
 2224 名乘客和机组人 员中有 1502 人遇难,大概有 32%的存活率。
 * 沉船导致生命损失的原因之一是乘客和船员没有足够的救生艇。
 *  虽然运气有一定因素,但一些人比其他人更有可能生存,比如妇女,儿童和上层阶级。
 最后一条就分析数据方面可以带来一些方向
 上面七个流程是为了以下几个目标:
* 分类:对样本进行归类或分类。也可能要了解不同课程与解决方案目标的含义或相关性
* 关联:哪些特征影响到哪些特征,哪些特征会更加影响到结果(权重)等,认识到
特征的关联性可以帮助另外一些目标的实践,如创建,完成,纠正特征等。
* 转换:在建模阶段,可能有些算法模型需要全部特征都为数字类型,那就要将分类特
征转换为表示正确的数字类型。
* 完成:数据准备时会要求将一些空值或缺失值填上一个值,一些算法模型会在没有缺失值
的情况下表现得更好。
* 纠正:有时会对训练数据中一些错误或不自然的数据用其他值代替,或者排除掉。
要纠正就要能检测出‘离群值’(outlier),还有可以判断某个特征对结果没有多大影响或某个特征
完全扭曲了结果。
* 创建:有时为了关联性,转换和完成的目标,会将几个特征合并创建某个特征。
* 制图:如何根据数据的性质和解决方案目标来选择正确的可视化图表
后面就按照这几个目标来处理数据
(一) 数据处理
找出与存活率有关的变量
1 导入工具包:
%python
#数据分析包
import pandas as pd
import numpy as np
import random as rnd

#可视化包
import seaborn as sns
import matplotlib.pyplot as plt
%matplotlib inline

#机器学习包
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC,LinearSVC
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.naive_bayes import GaussianNB
from sklearn.linear_model import Perceptron
from sklearn.linear_model import SGDClassifier
from sklearn.tree import DecisionTreeClassifier

#获取数据
train_df = pd.read_csv('train.csv')
test_df = pd.read_csv('test.csv')
#combine变量将两数据集合并,以备后面用
combine = [train_df,test_df]
#查看数据有哪些特征
train_df.columns.values
#输出
array(['PassengerId', 'Survived', 'Pclass', 'Name', 'Sex', 'Age', 'SibSp',
       'Parch', 'Ticket', 'Fare', 'Cabin', 'Embarked'], dtype=object)
2 解释标签数据
PassengerId:乘客Id
Survived:0代表NO,1代表YES
Pclass:1,2,3代表成员的经济社会地位1最高,3最低
Name:乘客姓名
Sex:代表性别
Age:年龄
SibSp:由两部分组成,Sibling(兄弟姐妹,堂妹都合适),Spouse代表(丈夫或妻子)
Parch:父母和孩子组成,若只跟保姆写0
Ticket:票的数字
Fare:乘客票价
Cabin:船舱数字
Embarked:登船仓:C=Cherbourg,Q=Queenstown,S=Southampton
3 操作数据
train_df.head(5)#输出前五行
train_df.tail(5)#输出后五行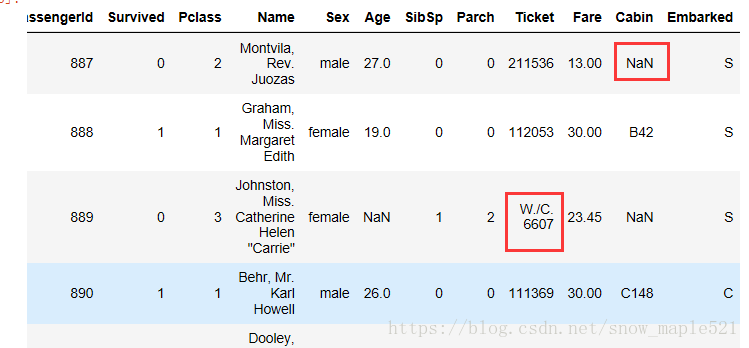
- 补缺:比较前五行和后五行发现有的数据缺失,后面将会处理缺失数据
- 转换:还发现Ticket特征的变量是字符和数字的混合,需要转换
**通过pandas的describe()函数来查看训练数据的大概情况
train_df.describe()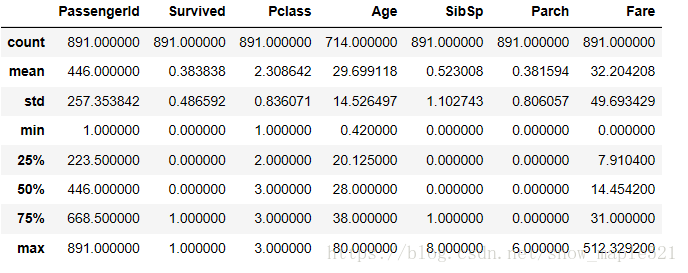
从中可以看出定义出的见解
- 泰坦尼克号实际的成员数为 2224,而训练数据样本总数目是 891,只占 40%
- survived 是一个只具有 0 或 1 值的分类特征
- 大概 38%的生存率对比实际中 32%的生存率
- 有 75%以上的成员没有带父母或孩子(从 75%那个数值可以看出
- 近 3 成的成员有 siblings 和/或 spouse 在船上(从 75%那个数值可以看出)
- 很少有成员(<1%)的票价是接近最高的$512
- 很少有年纪大的成员(<1%)的年纪在 65 岁到 80 岁之间。
4 验证地位高的成员存活率会高于地位低的
先从训练数据中单独取出’Pclass’和’Survived’这两个特征数 据,然后根据’Pclass’特征来做分组,
并就每组计算平局值(mean),然后就平均值做一个倒序.
最后可以看到地位高(Pclass=1)的成员真的存活率高很多(Survived>0.62)
%python
train_df[['Pclass','Survived']].groupby(['Pclass'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)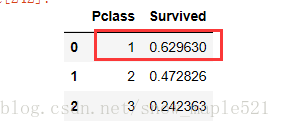
5 验证存活率和性别的关系
%python
#首先单独选出“Sex”和“Survive的”然后根据“Sex”来分组,并就每组计算平均值mean,
然后根据平均值排序(倒序)
train_df[['Sex','Survived']].groupby(['Sex'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)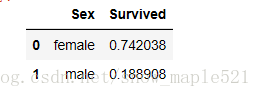
6 验证SibSp和Parch两个特征值对存货的影响
%python
train_df[['SibSp','Survived']].groupby(['SibSp'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)
train_df[['Parch','Survived']].groupby(['Parch'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)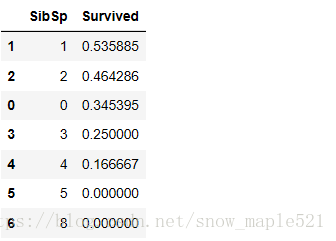
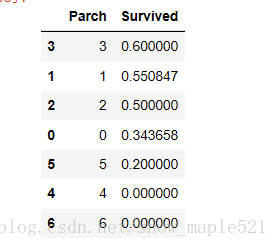
可以看出,这两个特质的值分组后的存货率都好相近,所以可以证明这两个值和存活率关 联性不大,可以放弃或者就这个特征创建新的特征.
(二) 数据可视化
2.1 用Age可视化直方图
%python
g = sns.FacetGrid(train_df,col='Survived')
g.map(plt.hist,'Age',bins=20)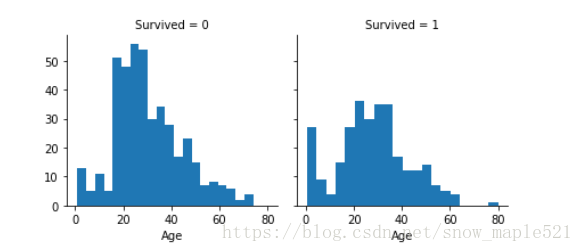
从上面可以看出,
* 婴儿(Age <= 4)生存率好高
* 大部分年龄在 15-25 的都牺牲了
* 总体来看,大部分成员的年龄在 15-35 岁之间 从而,可以校验之前的假设并可以作出一定的结论:
* 完善 Age 的空值
* 应该为 Age 特征做一个分组处理 上面是只对数字类型的图例分析,下面会作数字加分类类型数值的图例分析
2.2 地位Pclass可视化
%python
grid = sns.FacetGrid(train_df,col='Survived',row='Pclass',size=2.2,aspect=3.8)
grid.map(plt.hist,'Age',alpha=.5,bins=20)
grid.add_legend()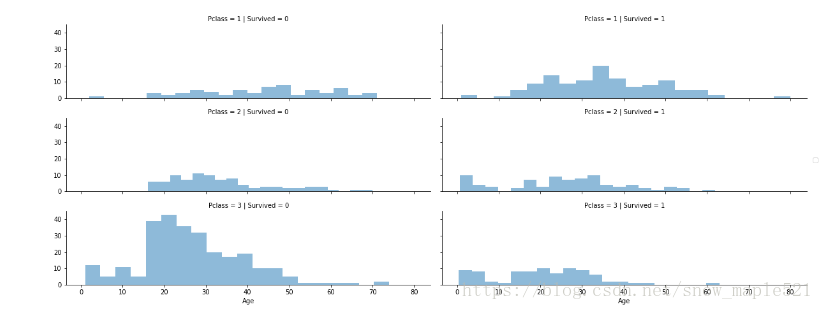
可以从上图看出:
* 地位低的(Pclass=3)成员最多,但存活率都不高
* Pclass=2 和 Pclass=3 的婴儿存活率很高.
* Pclass=1 的存活率最高 所以可以得出结论: 应该把 Pclass 特征放入训练模型中.
(三)分类特征的关联性可视化
3.1 Embarked和Sex用图表展示她们和Pclass与存活率的关联性
%python
grid = sns.FacetGrid(train_df,row='Embarked',size=2.2,aspect=1.6)
grid.map(sns.pointplot,'Pclass','Survived','Sex',palette='deep',\
        hue_order=["female","male"])
grid.add_legend()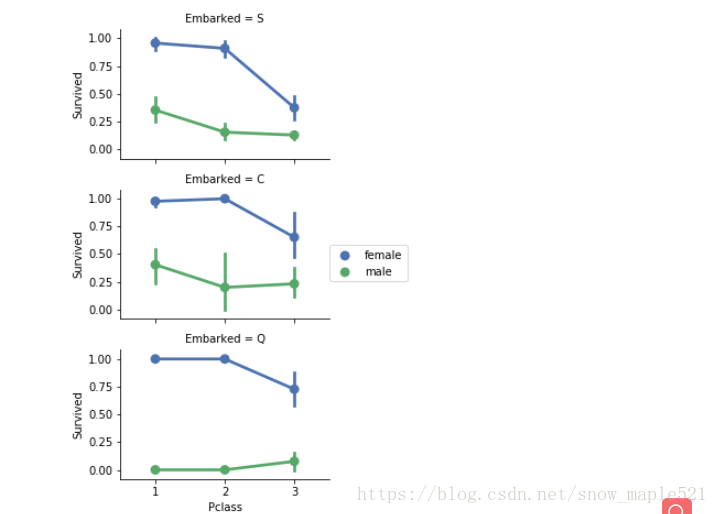
解析:seaborn包的使用,当前遇到两种图标,pointplot为点图,而hist为柱状图,而pointplot中
的参数hue_order是需要设置的,不然legend里面显示的顺序就会改变。
由图可知:
* 女比男的存活率高
* Embarked=C的男有相对高的存活率,集合了Pclass看的
得出结论如下:
* Sex特征加入到训练模型里
* 完善Embarked特征后,也把它加入到训练模型中
3.2分类特征和数值特征的关联
%python
#用seanbon画图,行(row)是Embarked,列(col)是Survived
grid = sns.FacetGrid(train_df,row='Embarked',col='Survived',size=2.2,aspect=1.6)

grid.map(sns.barplot,'Sex','Fare',alpha=.6,ci=None,order=['female','male'])
grid.add_legend()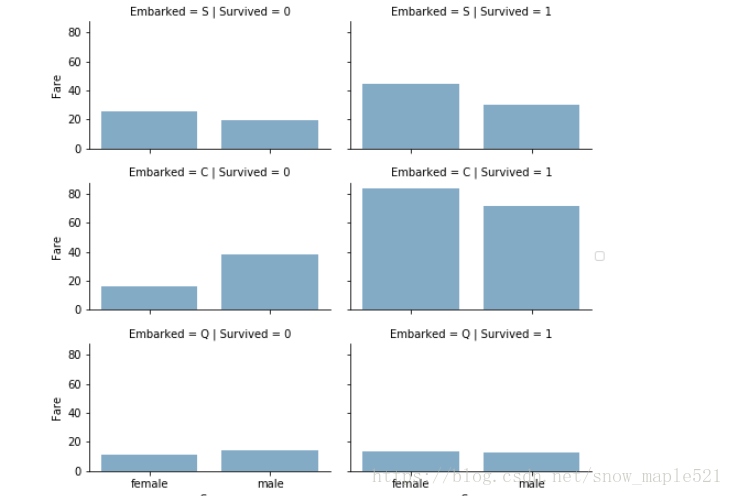
可以看出:
* 高票价(Fare)的成员的生存率高于低的
* 登船口(Embarked)和存活率有关。
* 可以考虑将Fare(票价)分成带状
(四) 修改数据
4.1 去掉Cabin和Ticket
%python
train_df = train_df.drop(['Ticket','Cabin'],axis=1)
test_df = test_df.drop(['Ticket','Cabin'],axis=1)
combine = [train_df,test_df]
4.2 处理Name
注:在去掉Name之前,还要创建一个Title头衔,看Title 是否和存活率有关
%python
#正则表达式”(\w+\.)”表示获取”.”前第一个词,用这个词来分类图示.expand=False 表示返回 DataFrame 类型.
for dataset in combine:
    dataset['Title'] = dataset.Name.str.extract(' ([A-Za-z]+)\.',expand=False)

test_crosstab = pd.crosstab(train_df['Title'],train_df['Sex'])
print(test_crosstab)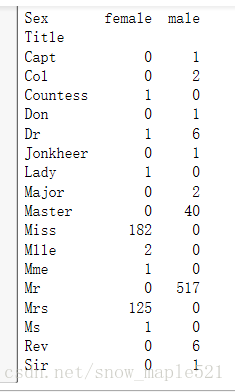
4.3 将上面得到的头衔缩小类别
%python
#用一个共同的名字代替一些头衔,其他的用Rare
for dataset in combine:
    dataset['Title'] = dataset['Title'].replace(['Lady','Countess','Capt','Col',\
                                                'Don','Dr','Major','Rev','Sir',\
                                                'Jonkheer','Dona'],'Rare')
    dataset['Title'] = dataset['Title'].replace('Mlle','Miss')
    dataset['Title'] = dataset['Title'].replace('Ms','Miss')
    dataset['Title'] = dataset['Title'].replace('Mme','Mrs')
print(train_df[['Title','Survived']].groupby(['Title'],as_index=False).mean())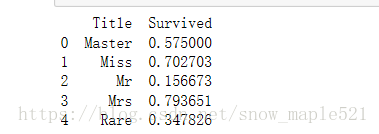
将一些好普通的名称都统一成为”Rare”,然后合并一些统称,然后作一个分类统计,就会看 到这个头衔(Title)和存活率还是有一定关系…
然后再将这个 Title 特征由分类特征转变为数字特征,并且将 None 的值变为 0.
4.4 将Title变成数字特征
%python
title_mapping = {"Mr":1,"Miss":2,"Mrs":3,"Master":4,"Rare":5}
#将同一个key的map在一起,并将None填充为0
for dataset in combine:
    dataset['Title'] = dataset['Title'].map(title_mapping)
    dataset['Title'] = dataset['Title'].fillna(0)
train_df.head()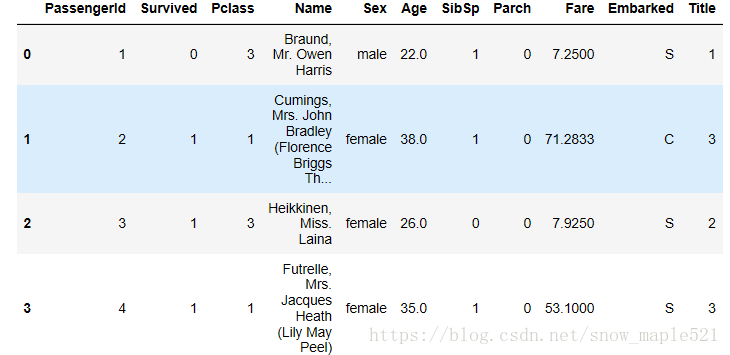
4.5 去掉Name和PassengerID
%python
train_df = train_df.drop(['Name','PassengerId'],axis=1)
test_df  = test_df.drop(['Name'],axis=1)
combine = [train_df,test_df]
print(train_df.shape,test_df.shape)
4.6 转换Sex为数字类型
%python
#将female的值换成1,male换成0。
if __name__ == '__main__':
    for dataset in combine:
        dataset['Sex'] = dataset['Sex'].map({'female':1,'male':0}).astype(int)
train_df.head()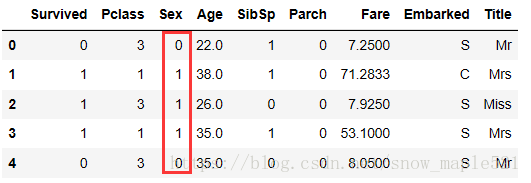
4.7 处理缺失值或空值
基于Pclass和Sex关联,处理Age,将其转换为5个连续的等级
%python
# 处理缺失值和空值
grid = sns.FacetGrid(train_df,row='Pclass',col='Sex',size=2.2,aspect=1.6)
grid.map(plt.hist,'Age',alpha=.5,bins=20)
grid.add_legend()
plt.show()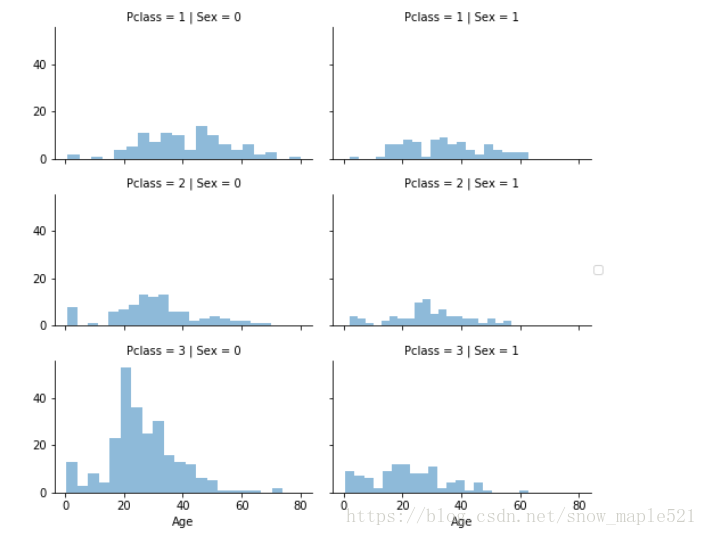
4.8 填充数据用中位数
%python
#用中位数来填充Age的缺失值
guess_ages = np.zeros((2,3))
# print(guess_ages)
for dataset in combine:
    for i in range(0,2):
        for j in range(0,3):

            guess_df = dataset[(dataset['Sex']==i)& \
                               (dataset['Pclass']==j+1)]['Age'].dropna()
#             print(guess_ages)
#         age_mean = guess_df.mean()
#         age_std = guess_df.std()
#         age_guess = rnd.uniform(age_mean - age_std,age_mean+age_std)

            age_guess = guess_df.median()
            guess_ages[i,j] = int(age_guess/0.5 + 0.5) * 0.5

    for i in range(0,2):
        for j in range(0,3):
            dataset.loc[(dataset.Age.isnull())&\
                        (dataset.Sex == i)&(dataset.Pclass==j+1),'Age']\
            =guess_ages[i,j]

    dataset['Age'] = dataset['Age'].astype(int)
print(guess_ages)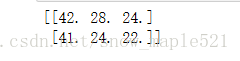
4.9 将Age切成5段看看与存活率的关系
%python
train_df['AgeBand']=pd.cut(train_df['Age'],5) #切分
train_df[['AgeBand','Survived']].groupby(['AgeBand'],as_index=False).mean()\
.sort_values(by='AgeBand',ascending=True)
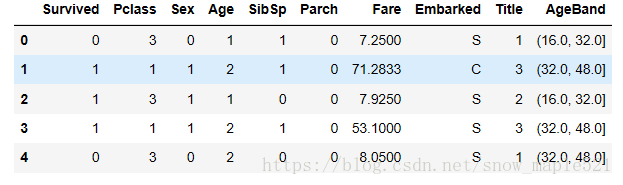
for dataset in combine:
    dataset.loc[dataset['Age']<=16,'Age'] = 0
    dataset.loc[(dataset['Age']>16) & (dataset['Age']<=32),'Age']=1
    dataset.loc[(dataset['Age']>32) & (dataset['Age']<=48),'Age']=2
    dataset.loc[(dataset['Age']>48) & (dataset['Age']<=64),'Age']=3
    dataset.loc[(dataset['Age']>64),'Age']=4
train_df.head(5)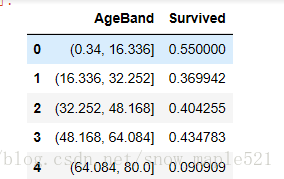
4.10 删除AgeBand
%python
train_df = train_df.drop(['AgeBand'],axis=1)
combine = [train_df,test_df]
train_df.head()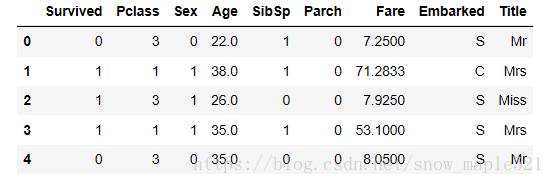
4.11 将SibSp和Parch特征加起来和存活率做关联对比
%python
#将SibSp和Parch特征的数量加起来,然后和存活率做一个关联对比
for dataset in combine:
    dataset['FamilySize'] = dataset['SibSp'] + dataset['Parch'] + 1
train_df[['FamilySize','Survived']].groupby(['FamilySize'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)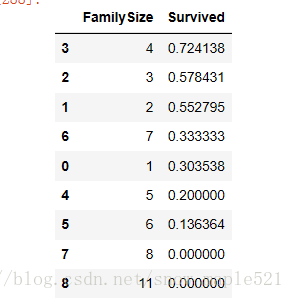
4.12 创建一个IsAlone特征值
%python
for dataset in combine:
    dataset['IsAlone'] = 0
    dataset.loc[dataset['FamilySize']==1,'IsAlone'] = 1
train_df[['IsAlone','Survived']].groupby(['IsAlone'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)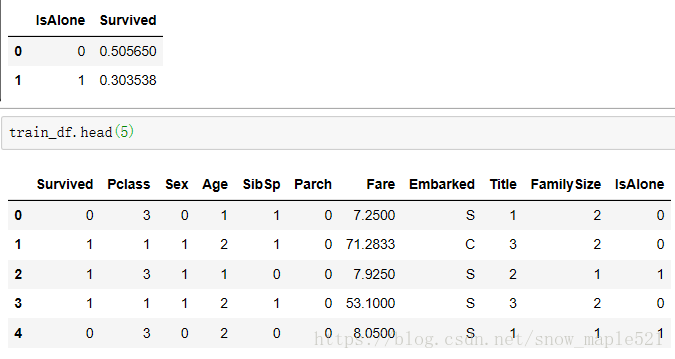
4.13 将Parch和SibSp和FamilySize三个特征去掉
%python
train_df = train_df.drop(['Parch','SibSp','FamilySize'],axis=1)
test_df = test_df.drop(['Parch','SibSp','FamilySize'],axis=1)
combine = [train_df,test_df]
train_df.head()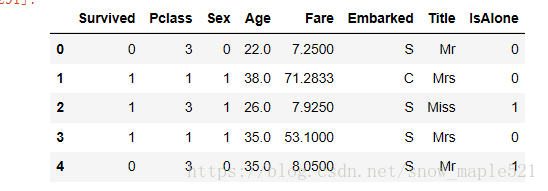
4.14 相乘Pclass和Age特征值
%python
for dataset in combine:
    dataset['Age*Class'] = dataset.Age * dataset.Pclass
train_df.loc[:,['Age*Class','Age','Pclass']].head(10)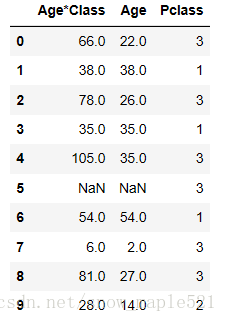
4.15 处理Embarked特征
用最长出现的值填充缺失值,然后在看关联性
%python
freq_port = train_df.Embarked.dropna().mode()[0]
for dataset in combine:
    dataset['Embarked'] = dataset['Embarked'].fillna(freq_port)
train_df[['Embarked','Survived']].groupby(['Embarked'],as_index=False).mean()\
.sort_values(by='Survived',ascending=False)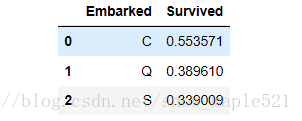
4.16 将Embarked转换成数字类型
%python
for dataset in combine:
    dataset['Embarked'] = dataset['Embarked'].map({'S':0,'C':1,'Q':2}).astype(int)
train_df.head()
train_df.head()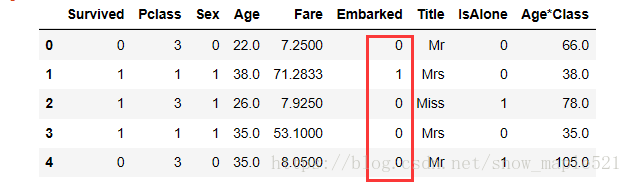
4.17 处理Fare(票价)
首先处理Fare的缺失值,然后用一个中间创建的特征验证合理性,最后将其分段,并转换成数字
%python
test_df['Fare'].fillna(test_df['Fare'].dropna().median(), inplace=True)

train_df['FareBand'] = pd.qcut(train_df['Fare'], 4)
train_df[['FareBand', 'Survived']].groupby(['FareBand'], as_index=False).mean()\
      .sort_values(by='FareBand', ascending=True)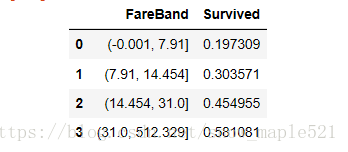
4.18 不能将FareBand特征用在训练模型中,它是中间特征而已,可以根据它来转换‘Fare’为数值类型
%python
for dataset in combine:
    dataset.loc[dataset['Fare'] <= 7.91, 'Fare'] = 0
    dataset.loc[(dataset['Fare'] > 7.91) & (dataset['Fare'] <= 14.454), 'Fare'] = 1
    dataset.loc[(dataset['Fare'] > 14.454) & (dataset['Fare'] <= 31), 'Fare'] = 2
    dataset.loc[dataset['Fare'] > 31, 'Fare'] = 3
    dataset['Fare'] = dataset['Fare'].astype(int)
train_df = train_df.drop(['FareBand'],axis=1)
combine = [train_df,test_df]
print(train_df.head(5))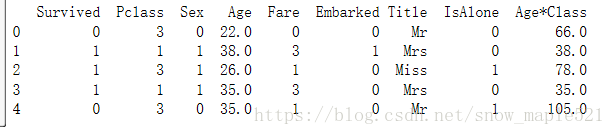
%python
print(test_df.head(5))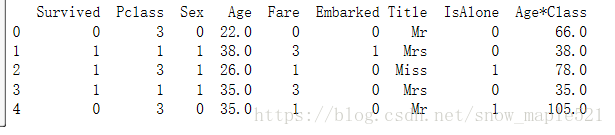
(五)训练模型
- 首先处理一下数据
%python
X_train = train_df.drop('Survived',axis=1)
Y_train = train_df['Survived']
X_test = test_df.drop('PassengerId',axis=1).copy()
print(X_train.shape,Y_train.shape,X_test.shape)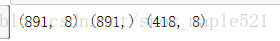
5.1 逻辑回归
%python
logreg = LogisticRegression()
Logreg.fit(X_train,Y_train)
Y_pred = logreg.predict(X_test)
acc_log = round(logreg.score(X_train,Y_train) * 100,2)
acc_log
#输出:81.26
5.2 支持向量机
%python
svc = SVC()
svc.fit(X_train,Y_train)
Y_pred = svc.predict(X_test)
acc_svc = round(svc.score(X_train,Y_train) * 100,2)
print(acc_svc)

#输出:83.5
5.3 K最邻近
%python
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train,Y_train)
Y_pred = knn.predict(X_test)
acc_knn = round(knn.score(X_train,Y_train)*100,2)
print(acc_knn)
#输出:84.06
5.4 朴素贝叶斯
%python
#朴素贝叶斯
gaussian = GaussianNB()
gaussian.fit(X_train,Y_train)
Y_pred = gaussian.predict(X_test)
acc_gaussian = round(gaussian.score(X_train,Y_train)*100,2)
print(acc_gaussian)
#输出:76.88
5.5 传导器
%python
# 传导器
perceptron = Perceptron()
perceptron.fit(X_train,Y_train)
Y_pred = perceptron.predict(X_test)
acc_perceptron = round(perceptron.score(X_train,Y_train)*100,2)
print(acc_perceptron)
#输出:78.79
5.6 线性核的向量机
%python
#线性核的向量机
linear_svc = LinearSVC()
linear_svc.fit(X_train,Y_train)
Y_pred = linear_svc.predict(X_test)
acc_linear_svc = round(linear_svc.score(X_train,Y_train)*100,2)
print(acc_linear_svc)
#输出:79.46
5.7 随机梯度下降
%python
#随机梯度下降
sgd = SGDClassifier()
sgd.fit(X_train,Y_train)
Y_pred = sgd.predict(X_test)
acc_sgd = round(sgd.score(X_train,Y_train)*100,2)
print(acc_sgd)
#输出:76.09
5.8 决策树
%python
decision_tree = DecisionTreeClassifier()
decision_tree.fit(X_train,Y_train)
Y_pred = decision_tree.predict(X_test)
acc_decision_tree = round(decision_tree.score(X_train,Y_train)*100,2)
acc_decision_tree
#输出:86.64
5.9 随机森林
%python
# 随机森林
random_forest = RandomForestClassifier(n_estimators=100)
random_forest.fit(X_train,Y_train)
Y_pred = random_forest.predict(X_test)
acc_random_forest = round(random_forest.score(X_train,Y_train)*100,2)
print(acc_random_forest)
#输出:86.64
(六)致谢
【1】感谢三盟科技提供案例笔记

 6479


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


