一文讲透Agent落地:六个角色、20个步骤,把大模型关进工程流水线

GitHub Agent Workflows:AI Agent工程化落地的拐点与实践指南 上周在 GitHub Trending 上,一个名为“Agent Workflow”的项目冲进了前五。点进去一看,不是某个全新的框架,而是 GitHub 官方推出的“GitHub Agent Workflows”。这让我停顿了一下——不是因为它有多新奇,而是因为它标志着一个拐点:我们谈论了快两年的 AI Agent,终于开始以一种“工程化”的方式,嵌入到最核心的代码协作平台里了。 过去,我们理解的 Agent 是什么?是 AutoGPT 那样的“全自动”探索,是 LangChain 里复杂的工具调用链,是各 阅读详情

本文转自:https://www.51cto.com/article/852844.html

上周和一个做企业数字化的朋友吃饭,他说他们团队刚上线了一个“智能客服Agent”,逻辑是: 用户提问 → 调GPT → 返回答案 。我问他,那这跟你们三年前做的那个基于规则的客服机器人,区别在哪?他愣了一下,说,区别就是现在用的是大模型,回答更聪明了。

我没接话,但心里想的是: 这压根不是Agent ,这只是换了个更贵的话术引擎的Chatbot。

这两年“Agent”这个词被用得太滥了,滥到几乎所有接了大模型API的产品都敢自称Agent。但真正的Agent和一个套壳的聊天机器人之间, 差的不是模型能力 ,而是背后有没有一整套让“思考”变成“行动”的 工程系统 。今天这篇文章,我想把这套系统拆开给你看——从用户敲下一句话,到最终结果返回,中间到底走了多少步、每一步在解决什么问题、为什么必须是这个顺序。

这不是一篇讲PPT概念的文章。我会尽量把每个环节 掰开揉碎 ,讲清楚它存在的必要性,而不是简单地把流程图翻译成文字。
1.先破除一个误区:Agent不是“更会聊天的模型”

很多人对Agent的理解还停留在这个公式:

Agent = 大模型 + 一段 System Prompt

如果真是这样,那市面上90%的“Agent产品”其实都名不副实。这个公式漏掉了最关键的东西:一个真正的Agent, 面对的不是“问题”,而是“目标” 。

举个例子。同样是分析销售数据,普通聊天机器人处理的是这样一句话:

“帮我分析这份销售数据”

它接收,理解,生成一段分析文字,结束。而一个真正的Agent面对的往往是这样的目标:

“分析过去一年销售趋势,找出下降原因,并生成优化方案”

这句话背后,压根不是一次模型调用能搞定的。它需要去数据库里把数据真的取出来,需要做实际的统计计算,需要判断趋势异常发生在哪个时间段,还要基于分析结果组织出一份有逻辑的方案。这中间涉及 记忆、规划、工具调用、结果校验 ——每一步都可能出错,每一步都需要被管理。

大模型在这整个过程里扮演的角色,其实 只是“大脑” 。而真正让一个系统从“能聊”变成“能干活”的,是围绕这个大脑长出来的那一整套神经和手脚。这也是我今天想讲的重点: 那些看不见的中间环节 ,才是Agent真正的技术含量所在。

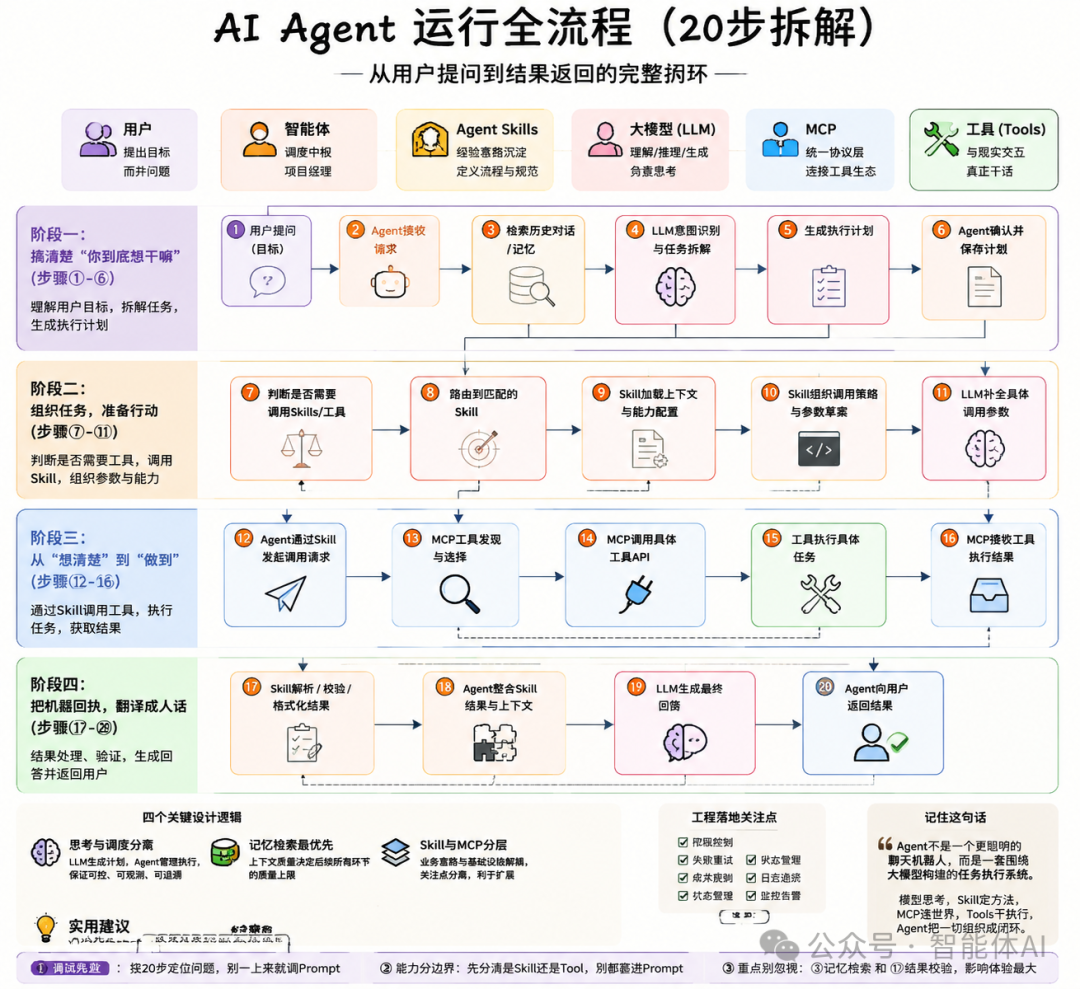
我找了一张我很喜欢的流程图(见文末),把一次完整的Agent任务拆成了 20个步骤、6个角色 。接下来我按这张图,把整个链路走一遍。

2.六个角色,先认清楚“谁在干什么”

在讲具体步骤之前,有必要先把场上的六个“演员”介绍清楚,不然后面的20步你会看得云里雾里。

用户 ,提出的不是问题,而是目标。这一点前面已经讲过,不再赘述。

智能体(Agent) ,是整个系统的 调度中枢 。这里有个容易搞混的地方:很多人以为Agent就是那个“聪明的部分”,但恰恰相反,Agent本身并不负责思考,它更像一个 项目经理 ——接需求、派任务、盯进度、交付结果。它自己不产出内容,但整个流程能不能跑通、卡在哪一步、要不要重试,都是它在管。

Agent Skills(技能层) ,这是我认为整套架构里最容易被低估的一环。Skill本质上是 把某类任务的“套路”固化下来 ——比如做数据分析该走哪几步、生成文档该用什么模板、处理客诉该遵循什么流程。它是经验和方法论的沉淀,而不是临时现想出来的。

大模型(LLM) ,负责理解、拆解、推理、生成语言。它是这套系统里“最聪明”的部分,但也恰恰因为 聪明得不稳定 ,所以它绝不能是唯一的决策者——这一点我在后面“设计哲学”那部分会重点展开,是我认为整篇文章最值得琢磨的地方。

MCP(模型上下文协议) ,简单说就是模型和外部工具之间的 统一插座 。没有它,每接入一个新工具,都要单独写一套对接逻辑;有了它,工具的发现、调用、结果回收都走标准协议。

工具(Tools) ,是 唯一“碰真实世界”的角色 ——查数据库、调接口、跑代码、改文件。没有工具,Agent只能给建议;有了工具,它才能真正把事情办成。

一句话记住这六者的分工:

「Agent管调度,LLM管思考,Skill定套路,MCP接工具,工具真干活。」

3.第一阶段:先搞清楚“你到底想干嘛”(步骤①-⑥)

任何一个靠谱的系统,第一步都不是急着动手,而是先把问题理解透。这个阶段对应流程图里的前六步。

用户提交请求之后,Agent接手,但它做的第一件事,不是马上丢给大模型去想,而是先去 检索历史对话和长期记忆 。这一步很多人会忽略,但我认为它是整条链路里 最容易被低估价值的环节 。

我打个比方:你去一家常去的理发店,理发师上来就问“您想剪什么发型”,和他先翻一眼你的会员记录、想起你上次说过不喜欢剪太短,这是完全不同的体验。没有记忆检索的Agent,本质上 每次对话都在“重新认识你” ——哪怕你上一句话刚说过的偏好,它转头就忘。这也是为什么很多所谓智能客服用起来让人恼火:不是它不聪明,是它没记性。

有了上下文之后,才轮到大模型登场: 意图识别、任务拆解、生成执行计划 。这一步模型要回答三个问题——用户到底想干嘛、要分几步完成、中间要不要借助外部能力。计划生成之后,交回给Agent,进入下一阶段的调度。

这里有个我很想强调的设计细节: “思考”和“调度”是两件被刻意分开的事 。计划由LLM生成,但计划的执行由Agent管理。这不是随便设计的,而是工程上的必然选择——如果让大模型既当决策者又当执行者,一旦它某一步判断出错,整个流程就没人能拦得住,更没法追溯问题出在哪。把这两者拆开,才有 可控性和可观测性 可言。这也是为什么“Agent工程”和“Prompt工程”是两个完全不同量级的活儿。

4.第二阶段:最容易被忽略、但技术含量最高的一段(步骤⑦-⑪)

计划有了,接下来Agent要做的第一件事,是判断这个任务到底需不需要“动手”。有些请求靠模型自己就能答完,没必要大费周章调用工具——这是个 分支判断 ,体现的是系统的严谨性,而不是所有请求都一股脑往复杂流程里塞。

如果确实需要借助外部能力,Agent会把任务 路由到匹配的Skill上 。比如销售分析类的任务,会被路由到专门的“数据分析Skill”。Skill被激活后,会先加载自己的上下文和能力配置——说白了就是把这类任务的“专业知识”和“输出规范”注入进来,然后组织出一份调用策略和 参数草案 。

到这里,参数还只是个草案,真正把它填实的动作,交给了LLM去补全。

我想在这里稍微停一下,因为这是我认为整张图里设计得最巧妙、也最能体现“工程思维”的一处细节: 为什么参数要拆成“草案”和“补全”两步,而不是一步到位?

原因在于,Skill和LLM各自擅长的东西不一样。Skill擅长的是 结构 ——它知道这类任务应该按什么顺序调用、需要哪些字段、格式该长什么样,这些是相对固定的、可以预先定义的规则。而LLM擅长的是 语义 ——它能根据当前上下文,把某个具体字段该填什么内容“现想”出来,比如根据用户这句话,该往数据库查询语句里填哪个时间区间、哪个产品线。

如果把这两件事混在一起,让LLM从零开始“既想结构又想内容”,结果往往是 格式不稳定、字段容易漏、调用容易出错 。但如果全部交给固定规则去处理,又完全没法应对语义上的灵活变化。所以更稳妥的做法,是让Skill先搭好骨架、把结构性的部分定死,再让LLM往骨架里填血肉、把语义性的部分补活。

「Skill决定调用的骨架,LLM填上血肉。」

这句话我觉得比什么“意图识别”“任务拆解”这些术语更能说明白Agent架构的精妙之处。这也是为什么我一直建议做Agent产品的团队,不要把所有逻辑都堆进一个巨大的System Prompt里,指望模型一次性把结构和内容都想明白。 该用规则的地方用规则,该留给模型发挥的地方再留给模型 ,这才是靠谱的工程做法。

5.第三阶段:从“想清楚”到“做到”(步骤⑫-⑯)

前面所有环节,严格说都还停留在“纸面上”——理解、规划、组织参数,都没有真正碰到现实世界。从这一阶段开始, 事情才真正被执行 。

Agent通过Skill正式发起调用请求,Skill在这里还要负责一次 参数校验 ,把明显不对劲的调用挡在门外。请求到了MCP这一层,MCP先做 工具发现与选择 ——在已注册的工具列表里,找到能满足这次调用的那一个,然后通过统一协议真正发起API调用。工具执行具体任务,可能是查一次数据库,可能是调一次第三方接口,也可能是跑一段代码。执行完之后,结果通过MCP被收回来。

这一段我想重点聊聊MCP这个角色,因为它常常被低估。很多人以为MCP只是个“协议标准”,听起来挺技术、挺无聊,但它解决的问题其实非常实际:如果没有MCP, 每接一个新工具,都要重新写一套对接代码 。想象一下,你的Agent要同时对接CRM、数据库、搜索引擎、文件系统,如果每一个都单独适配,工程量会指数级增长,而且模型本身还得“认识”每一个工具的调用方式,这对模型能力是极大的浪费。

MCP做的事情,本质上是把这件事“标准化”了——工具只要按照协议接进来,模型不需要认识每一个具体工具,只需要认识这一套 “插座标准” 。这就跟USB接口是一个道理:以前每个外设都有自己专属的接口和驱动,现在只要符合USB标准,插上就能用。这才是MCP真正的价值——它让Agent的能力边界, 从“模型认识多少工具”变成了“生态里接入了多少工具” ,这是两个完全不同数量级的事情。

6.第四阶段:把机器的回执,翻译成人话(步骤⑰-⑳)

工具执行完拿到的结果,往往是一堆结构化数据、状态码、甚至是报错信息,直接甩给用户是没法看的。所以Skill要先做一次 解析、校验和格式化 ,把机器语言转换成Agent能理解的信息。

接下来Agent会把这份结果和之前的记忆、计划整合到一起,判断这个任务到底是不是已经完成了——如果没完成,可能还要回到前面的环节继续跑一轮,这也是为什么很多资料把Agent的运行模式总结为 观察-思考-行动-反馈 的循环,而不是一条直线走到底。

最后一步,是LLM基于整合后的信息生成最终回答,Agent把这个结果返回给用户。你在对话框里看到的那句流畅的回答,背后其实是 这20步跑完的产物 。你花了两秒钟看到答案,系统可能已经在后台完成了好几次工具调用、好几轮校验和整合。

这里我想留一句我自己的判断: 工具给的是数据,LLM给的是答案,而真正把数据变成答案的,是中间那几步不起眼的“翻译”工作。 很多团队在做Agent产品时,把大量精力砸在“模型选型”和“Prompt调优”上,却对这几步结果处理草草了事,最后产品体验上不去,问题往往不在模型不够聪明,而在 这几步没做扎实 。

7.这张图背后,藏着四个值得反复琢磨的设计逻辑

拆完20步,我想跳出流程本身,聊聊我认为更值得记住的东西—— 这套架构为什么要这么设计 。这部分是我这篇文章里最想讲的内容,也是我觉得真正把Agent和普通聊天机器人区分开的地方。

第一,为什么“思考”和“调度”要分开?

前面提过,LLM生成计划,但Agent管理执行。这么做的核心原因是:大模型的输出本质上是 概率性的、不完全稳定的 ,而一个生产环境里的系统,需要的是确定性的流程控制。把这两者拆开,才能做到 出问题能定位、能重试、能回滚 ——这是纯粹依赖一个巨大Prompt的方案永远做不到的。

第二,为什么记忆检索排在整个流程的最前面?

因为 上下文质量决定了后面所有环节的质量上限 。业内常说“garbage in, garbage out”,放在Agent上同样成立——如果连用户是谁、之前聊过什么都没搞清楚,后面再精妙的规划和调用都是在无本之木上建楼。

第三,为什么Skill和MCP要分成两层,而不是合并成一层?

这其实是 关注点分离 的经典工程思想。Skill管的是业务套路——某类任务该怎么做;MCP管的是工具连接——某个能力该怎么接。这两者一个偏“业务”,一个偏“基础设施”,分开之后,业务团队可以专注沉淀自己领域的Skill,而不用操心底层工具怎么接;反过来,工具生态的扩展也不需要每次都改动业务逻辑。这种 解耦 ,才让整个系统具备可扩展性。

第四,为什么参数要“草案+补全”两步走?

前面已经详细讲过,本质是 结构稳定性和语义灵活性之间的平衡 ,不重复了。

把这四点串起来,我想说一句可能有点抽象但我很认同的话:

「一个好的Agent架构,本质上是把“不确定性的大模型”,装进了一套“确定性的工程流水线”里。」

模型的价值在于它的灵活和创造力,但一个能在生产环境里稳定跑的系统,靠的从来不是灵活本身,而是 把灵活性关进笼子、只在该发挥的地方释放出来 的工程能力。

8.聊点更现实的:企业真正卡在Agent落地上的,从来不是模型

写到这里,我想跳出流程图,说点这两年在跟不少企业聊落地时的真实观察。

很多企业老板问Agent产品经理的第一个问题永远是“你们用的哪个模型”,但说句得罪人的话——决定一个Agent产品能不能落地的, 从来不是模型选型,而是流程设计 。模型的能力这两年进步很快,几乎所有主流模型的推理水平都在快速逼近,但企业真正需要的是 稳定执行、可控输出、过程可追踪 ,这些恰恰是模型能力之外的东西。

再往下深挖一层, Skill的沉淀质量,决定了一个Agent到底专不专业 。未来企业之间的竞争,不会是比谁先接入了某个大模型API——这事儿早晚人人都能做到,门槛低得很。真正拉开差距的,是谁把自己行业里的经验、SOP、工作流程,扎扎实实沉淀成了可复用的Skill。这才是 护城河 。

还有一层容易被忽视的边界,是工具生态。一个Agent能干多少事, 上限从来不是模型有多聪明,而是它能访问到什么 。这也是为什么MCP这类标准化协议这两年被反复提及——它决定了一个Agent的能力天花板能长多高。

最后一点,也是最容易被低估的一点:Agent真正跑到生产环境,需要的 工程化治理 远比想象中复杂——权限控制、失败重试、成本控制、状态管理、日志追踪,这些听起来“不性感”的工作,恰恰是决定一个Agent产品是 “能演示”还是“能用”的分水岭 。我见过太多Demo阶段惊艳、上线三个月就被业务方投诉“不稳定”的案例,问题几乎都出在这里,而不是模型不够强。

9.往远了看,这可能是软件形态的一次真正转变

过去做企业软件,大体逻辑是这样的:

用户 → 软件功能 → 人工操作

用户打开一个系统,在一堆按钮和表单里找到自己要的功能,然后手动完成剩下的操作。软件的价值,是 把能力“摆”在那里,等人来用 。

而Agent架构指向的,是另一种形态:

用户目标 → Agent → Skills → Tools → 企业系统 → 结果

用户不再需要知道该点哪个按钮、走哪个流程,只需要说清楚自己想要什么,剩下的由系统自己去调度、执行、交付。软件的价值, 从“提供功能”变成了“完成任务” 。

这句话说起来简单,但如果你真的理解了前面20步里每一环在解决什么问题,就会明白这个转变背后需要多少工程积累——不是接一个大模型API就能实现的跃迁,而是记忆、规划、技能、协议、工具、治理, 一整套体系同时成熟 之后,才有可能发生的事。

写在最后

如果你只记住这篇文章里的一句话,我希望是这句:

「Agent不是一个更聪明的聊天机器人,而是一套围绕大模型构建的任务执行系统。模型负责思考,Skill负责方法,MCP负责连接,Tools负责行动,而Agent负责把这一切组织成一次完整的任务闭环。」

给正在做或者正在用Agent产品的朋友,留三条我自己觉得挺实用的建议:

1.调试Agent的时候,别一上来就死磕Prompt。 按这20步去定位问题卡在哪一棒 ——是记忆没检索对,是Skill路由错了,还是参数补全出了问题——效率会高得多。

2.新增能力的时候,先想清楚这件事 该做成Skill还是Tool ,而不是一股脑全塞进System Prompt里。分清楚“套路”和“手脚”的边界,系统才好维护。

3.第③步的记忆检索和第⑰步的结果校验,是我见过 最容易被团队忽视、但对用户体验影响最大 的两个环节,值得多花点心思。

CrewAI团队式Agent设计:角色、任务与记忆的工程化实践 Agent系统已从单体智能迈向协同智能,其核心在于模拟人类团队协作机制。理解Agent角色的本质是带约束的数字同事,而非无状态函数;任务需定义为输入源明确、上下文精准、输出可校验的工作契约;记忆则须分层管理——短期属角色、长期属团队、同步靠任务交接。这种工程化范式显著提升复杂任务的完整性、可追溯性与鲁棒性,尤其适用于行业分析、代码协作、合规审查等需多阶段推理与交叉验证的AI应用。CrewAI正是将该范式落地为角色(Agent)、任务(Task)、流程(Process)、记忆(Memory)四层结构的典型框架 阅读详情

相关推荐

Agent高级编排模式详解:从流水线到异步协作的落地实践

在多智能体系统逐步进入工程实践的过程中,如何让多个AI Agent稳定协作完成真实业务任务,已成为开发者关注的核心问题。为了提升系统可靠性与可控性,编排层引入确定性框架来管理模型的不确定性输出,通过明确的责任边界、输入输出接口和失败处理机制,让复杂的业务流程可以被拆解、执行与追踪。常见的编排模式包括顺序管道、路由分流、聚合器、编排器-工作者以及异步协作,各自适用于不同的业务场景。上下文管理、状态机设计和工具调用隔离机制,则是实现这些模式必须打通的底层基础。从内容生产流水线到代码自动生成,这类技术正在被广泛应

weixin_29032489的博客 235

小白也能看懂!Agent智能体工作流详解,收藏备用,轻松入门大模型!

如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。学AI大模型,就是冲刺高薪的最优解!零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序员和小白!👇👇扫码免费领取全部内容👇👇1、大模型系统化学习路线。

python12345_的博客 287

LangChain智能体构建流程:从工具契约到多Agent协作的工程实践

智能体(Agent)是具备目标拆解、工具调用与自我修正能力的AI工作单元,其核心原理在于将大模型的推理能力与确定性工具链进行可控协同。技术价值体现在降低LLM幻觉风险、提升任务完成鲁棒性,并支持可调试、可监控的生产级落地。典型应用场景包括客服质检、智能选品、风控审核等需多步决策与外部系统交互的业务环节。本文聚焦LangChain生态下智能体构建流程的关键实践,深入解析工具抽象层设计、三层记忆架构、提示词状态机化表达及LangGraph演进路径,尤其强调‘工具契约’与‘工作流编排’两大高频踩坑点。

weixin_33860528的博客 387

从0到1设计Agent的六步方法论

本文提出了一套从需求到落地的六步Agent设计方法论:1)明确具体可度量的业务场景和边界;2)拆解感知-决策-执行闭环能力;3)分层架构设计隔离复杂性;4)标准化工具协议和容错机制;5)MVP验证关键指标;6)建立数据驱动的优化闭环。强调Agent落地要聚焦具体场景,通过分层设计、契约约定和持续迭代,将概念验证转化为工程可用的系统。

weixin_44929001的博客 602

研发Agent落地实战:确定性架构与领域知识固化

研发Agent不是通用AI助手,而是嵌入软件研发流程的确定性协作者。其核心在于解决LLM固有不确定性与工程交付刚性要求之间的根本矛盾——通过语义锚定、契约校验、变更审计三层过滤机制,将大模型能力约束在可验证边界内;同时将分散的领域知识转化为Drools规则、OpenAPI约束和DSL语法树,实现知识的可执行固化。这种‘确定性增强’范式显著提升需求到PRD耗时、API一次通过率及测试覆盖率,适用于工业软件、金融系统等强合规、高一致性的研发场景。关键词:研发Agent、领域知识固化、确定性架构。

weixin_29046611的博客 156

scRNA-seq的fastq文件处理流程——持续更新

获得了一批新的scRNA-seq的fastq.gz文件,每个样本的数据形式为: 我打算使用10X cellranger处理fastq.gz文件,下载及安装方式在官网:https://support.10xgenomics.com/single-cell-gene-expression/software/downloads/2.0这个网址写了10X cellranger处理fastq.gz文件的命名规则https://support.10xgenomics.com/single-cell-gene-expr

watermel__的博客 3198

agent面试必备4-AI Agent 是如何工作的?揭秘 5 步核心工作流程

本文拆解了AI Agent的5步核心工作流程:1)输入处理(意图识别、安全过滤);2)任务分解(生成子任务列表);3)工具调用(执行具体操作);4)结果整合(处理数据冲突);5)输出生成(生成最终答案)。文章通过职场助手隐喻帮助理解,并提供了技术实现细节,包括结构化状态管理代码示例。针对面试常见问题,给出了防止Agent迷失的解决方案(如设置停止条件、维护任务清单)和处理数据冲突的方法(优先级规则、模型自主判断)。最后展示了用Python字典跟踪Agent状态的实践方案,强调结构化数据比简单对话记录更可靠。

kaggle expert,全球排名前1000,清华计算机研究生,兴趣算法工程 1068

别再手动调时间了!用Windows自带的tzutil命令,1分钟搞定时区错误

本文介绍了如何使用Windows自带的tzutil命令快速解决时区错误问题。通过简单的命令行操作,用户可以一键切换时区、查看全球时区代码库,并实现自动化时区同步。相比传统GUI设置,tzutil更可靠且高效,特别适合企业环境批量部署。

weixin_42531494的博客 314

大模型微调不用愁!一文搞懂五种关键技术

大模型微调指南:从理论到实战 本文系统讲解大模型微调技术,将通用AI转化为专业工具。核心内容包括: 微调本质解析 - 类比"学霸实习",使通用模型掌握行业技能 五大微调方法:全参微调(高成本高效果)、PEFT(低成本高效)、提示词微调、指令微调、RLHF(ChatGPT核心技术) 五步实操流程:数据准备→模型选择→参数设置→效果评估→部署优化 学习资源推荐:包含完整学习路线、实战项目及行业专家整理的书籍资料 文末提供全套大模型学习资料包(含视频/案例/面试题),适合零基础开发者快速入门高

优快云_224022的博客 1833

【ROS学习笔记】13.ROS中的坐标管理系统

文章目录1 机器人中的坐标变换2 TF功能包TF坐标变换如何实现?TF的一个小案例3 小程序:小海龟跟随实验打开小程序查看当前的TF树坐标相对位置关系可视化1(tf_echo)坐标相对位置关系可视化2(rviz) 本节学习ROS中的坐标管理系统。 (部分图摘自:b站【古月居】古月·ROS入门21讲) 1 机器人中的坐标变换 机器人运动学的核心,描述任意两个坐标系之中任意两个向量之间的变换,可以用一个4×4的变换矩阵(Transformation Matrices)来描述它的平移和旋转变化。 变换矩阵中有包括

takedachia的博客 4338

8.26华为OD机试真题 新系统 - 字符串回文判 (Java/Py/C/C++/Js/Go)

8.26华为OD机试真题 新系统 - 字符串回文判 (Java/Py/C/C++/Js/Go)

算法大师! 1236

Agent智能体实操全流程:从创建到发布运行,一文搞定落地部署

语义模型是Agent理解用户需求的核心,负责将用户的自然语言输入,转化为Agent可识别、可处理的语义指令,解决“用户说的话,Agent能听懂”的问题。如果语义模型定义不当,会导致Agent出现“答非所问”的情况,影响用户体验。实操要点:语义意图定义:梳理用户可能的输入场景,定义核心语义意图,例如,客服Agent的“订单查询、退款申请、投诉反馈、产品咨询”等意图;数据分析Agent的“数据统计、趋势分析、异常排查”等意图。

EAlReport的博客 1028

从底层结构开始学习FPGA(8)----Block RAM(BRAM,块RAM)

BRAM作为FPGA底层的存储资源,作用很大,比如可以RAM/ROM/FIFO。

孤独的单刀 2万+

一文讲透Agent落地:6个角色、20个步骤,把大模型关进工程流水线

真正的Agent和套壳聊天机器人之间,差的 不是模型能力 ,而是有没有一整套让思考变成行动的 工程系统 。 上周和一个做企业数字化的朋友吃饭,他说他们团队刚上线了一个“智能客服Agent”,逻辑是: 用户提问 → 调GPT → 返回答案 。我问他,那这跟你们三年前做的那个基于规则的客服机器人,区别在哪?他愣了一下,说,区别就是现在用的是大模型,回答更聪明了。

weixin_58753619的博客 299

【ESP 保姆级教程】第三方库篇 ——TimeLib库,一个非常Nice的时间库,结合第三方进行校正时间

Time,这是一个为Arduino提供时间支持的库。 这个库的例子中会教会我们多种方式去获取时间: - 一个`RTC`时钟 - 网络`NTP`时间 - `GPS`时间

单片机菜鸟哥的博客 3674

基于AnimeGAN模型生成宫崎骏风格动漫照片

用于动画风格纹理和线条转换的灰度样式丢失;新颖的颜色重建损失,以保留内容图像的颜色;新的灰度对抗损失防止生成的图像从显示为灰度图像;使用深度可分卷积和反向残块的轻量级生成器,以实现更快的传输。实验表明,AnimeGAN可以对真实世界的照片进行变换场景动画风格的图像与高质量的动画视觉效果和显著优于最先进的风格化方法。# 生成宫崎骏风格图片 model = hub . Module('animegan_v1_hayao_60' , use_gpu = True)images:输入的图片数据。

优快云 精品推荐 3630

AI编码工程化架构:ECC执行控制与Agent-First落地实践

AI编程已从IDE插件阶段迈入生产级工程化需求,核心在于解决生成代码的可验证性、一致性与可控性问题。Execution Control & Consistency(ECC)并非概念包装,而是嵌入CI/CD全链路的硬性治理机制,提供策略拦截、沙箱执行、区块链审计等能力;Agent-First则将AI能力解耦为带SLA承诺、Schema契约和自治生命周期的原子化服务单元。该架构直击金融、政务、车载等强合规场景痛点,支撑支付对账、ECU固件升级、等保三级系统等真实产线交付,实现AI生成代码一次通过率98.7%、P

weixin_30099989的博客 338

Linux驱动学习--HCI框架及源码分析

目录 一、引言 二、HCI框架 三、pcm_read简要分析 一、引言 最近一直在分析蓝牙驱动,发现在底层驱动与上层协议栈间还有一层HCI,主机控制层,两者之间通过HCI协议通讯 而Linux也将HCI协议抽象层了一个框架。 为上层提供一个统一的接口,让上层协议不依赖于具体硬件的实现。HCI在硬件中的固件与HCI在主机端的驱动通信方式有多种,比如像 UART、USB和PC Card等等。hci_core.c相当于一个框架,用于把各种具体通信方式绞合起来,并提供一些公共函数的实现。 今天就来简单的分析一下 二

文艺小少年的博客 2002

从Demo到生产:多Agent协作的工程化落地实践指南

人工智能应用正从单点演示走向复杂业务落地,智能体(Agent)作为大模型技术的重要载体,其工程化能力成为决定成败的关键。多Agent协作的核心理念是将复杂任务拆解为可独立运行、职责单一的智能体单元,通过链式编排、路由分发或黑板模式实现协同,但由此带来的状态管理、上下文管理与故障定位难题也显著增加。生产环境要求Agent具备可观测性、可评估性和可控性:借助链路追踪复现推理过程,沉淀评测集完成回归验证,并通过工具权限白名单、Prompt注入防御与数据权限隔离筑牢安全边界。同时,模型路由、缓存复用和上下文瘦身是控

weixin_29051193的博客 220

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

企业级AI Agent编排层架构设计与落地实践:2026拐点前的工程化指南

AI Agent的工程化落地正从模型能力竞争转向编排层设计。编排层作为调度大脑,负责任务规划、路由调度、状态管理、执行重试与可观测治理,其质量直接影响企业级应用的稳定性、成本与可审计性。通过静态模板与动态规划结合、数据驱动的路由决策、结构化状态对象等工程实践,可显著提升多Agent协作效率。在合同审核、退款处理等场景中,合理的编排设计能实现不阻塞、可追溯的任务执行。随着模型能力趋同,编排层将成为2026年企业AI竞争的分水岭。

weixin_29056701的博客 211

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Harness Engineering实战:Multi-Agent与自我进化Skill的企业级落地

在AI应用工程化领域,Harness Engineering提供了一套将大模型行为约束在可控范围内的设计范式。其核心思想并非依赖模型自发表现,而是通过SandBox隔离执行、多个Agent协同任务编排,以及可自我进化的Skill技能库,实现从“能写Demo”到“可交付”的跨越。从多Agent任务拆解的基本原理出发,外部机制可显著提升工具调用与权限控制的稳定性,降低模型输出波动带来的链路断裂风险。这一架构适用于智能客服、数据分析助手、自动化运维等企业级场景,支持批量任务与统一API服务。把握SandBox的隔

weixin_34072458的博客 400

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Agent-Skills工程化实战:从设计到落地的智能体技能体系

在大模型应用落地中,如何让智能体稳定执行任务而非依赖模型即兴发挥?Agent-Skills通过将高频操作封装为可复用、可组合的技能单元,实现从提示词工程到技能调度的工程化升级。其核心原理是接口契约与分层设计,将不确定性约束在确定性代码中,从而提升系统可靠性与可维护性。这一方法适用于智能体开发、任务自动化及复杂业务流程编排等场景,尤其适合需要高稳定性和可观测性的生产环境。本文深入拆解Agent-Skills的设计思路、核心细节与实操要点,助你构建可靠的智能体技能体系。

weixin_42651281的博客 219

AI幻觉率从46%到4%:Google Co-Scientist的多Agent可靠性工程实践

AI幻觉是大模型在生成开放性内容时的常见问题,尤其在科研领域,一篇看似合理的假设可能毫无依据。为抑制幻觉,业界通常引入检索增强生成(RAG)或多Agent协作架构,但其效果并不稳定。Google Co-Scientist系统的可靠性模块给出了一个有价值的工程思路:将生成内容拆解为可验证的事实点,通过外部文献进行证据分级和交叉核验,并在此基础上完成结果回注与置信度修正。这种“生成-校验-反馈”的流程约束,能够有效把输出幻觉率从46%降至4%。它强调的不是模型变得更聪明,而是工程防线对错误输出的抑制能力。对使用

weixin_34221112的博客 280

Claude Code多Agent编排实战:从单步聊天到自动化流水线

AI编程助手正从对话式交互走向自动化工作流。要理解多Agent编排,先要明白单步聊天在处理长流程任务时的上下文丢失、职责混杂与不可重复等瓶颈。其核心原理是将复杂任务拆解为独立子Agent,通过上下文隔离、标准产物传递和状态机调度,把模型随机性关进确定性流程的笼子。这种架构能显著提升软件研发的稳定性和可维护性,适用于模块化开发、批量变更、自动测试修复等工程场景。Claude Code的Routine脚本化进一步将编排逻辑固化为YAML配置,让流水线一键触发、断点续跑。本文从架构设计、闭环自愈到落地配置,给出可

weixin_33402252的博客 159

AI每日资讯|Agent落地与Skill精选:11个案例+10个爆款Skill的工程化拆解(TaoToken 视角)

用11个Agent落地案例拆解Skill工程化:把提示词拆成带SKILL.md、metadata.json、scripts与examples的目录,并给出MCP片段、settings配置与401、local proxy failed等报错排查路径。统一Key与API通道可让多跳调用可验证,TaoToken官网:https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35756892的博客 8

LLM Agent行为可复现性:量化、度量与提升多步骤AI代理的稳定性

在构建由大语言模型驱动的智能体时,行为可复现性是一个核心挑战。它指的是智能体在相同输入和环境下,其决策路径与行为序列能否稳定重现,这直接关系到系统的可靠性与可信度。从技术原理看,这源于LLM固有的随机性、复杂的环境交互以及路径依赖效应。其技术价值在于,高可复现性是AI代理在金融、医疗等高风险领域落地的前提,也是开发调试和系统集成的基石。应用场景广泛覆盖需要多步骤工具调用的自动化流程,例如数据分析、自动化客服与复杂任务编排。本文聚焦于**工具调用流水线**和**决策一致性**,系统阐述如何通过多维度量体系与工

weixin_30421809的博客 410
上一篇: Git查看最后一次提交的代码变更
UU_Yang
博客等级 码龄23年 926粉丝 213原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值