


目录
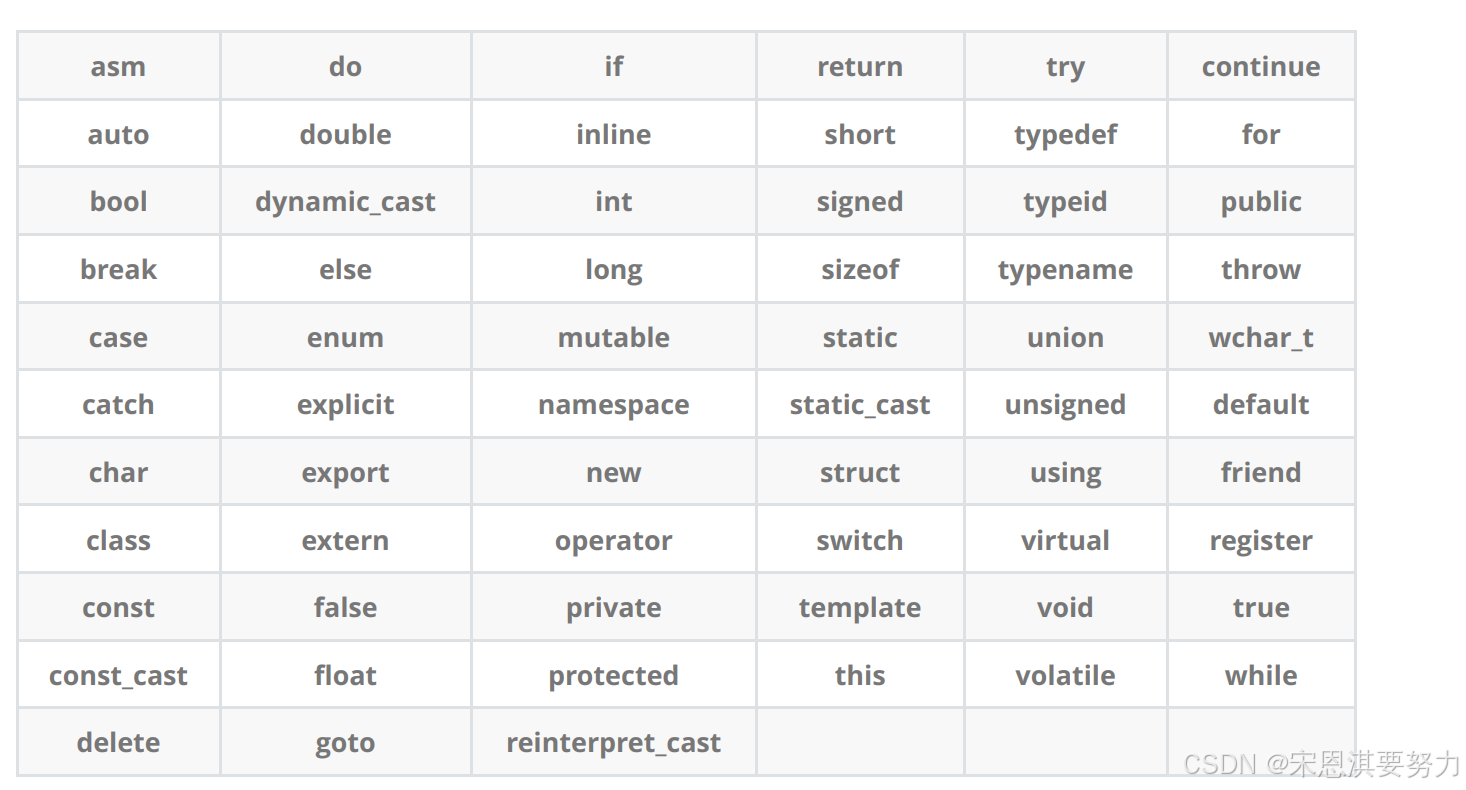
1.C++关键字
2.命名空间
使用命名空间的目的是为了对标识符名进行本地化,避免命名冲突(包含自己编写的名字与库冲突和程序员互相之间编写程序命名的冲突)和名字污染。
1.命名空间定义
需要用到namespace关键字,后面跟命名空间的名字,然后加一对花括号即可,{}内即为命名空间的成员。
命名空间中可以定义变量,函数,类型。可以嵌套。
同一工程头文件和源文件中存在相同名称的命名空间,编译器最后会合成到同一命名空间。
一个命名空间就定义了一个新的作用域。
namespace N1
{
int a;
int b;
int Add(int left, int right)
{
return left + right;
}
namespace N2
{
int c;
int d;
int Sub(int left, int right)
{
return left - right;
}
}
}
2.命名空间的使用
i.加命名空间名称及作用域限定符
ii.使用using将命名空间中某个成员引入
TIPS:::是域作用限定域符
int a=2;

namespace HY
{

int a=10;

}
::a也就是限定了在全局域中寻找a变量。
using namespace HY展开了命名空间,HY::a也就是指定了在HY域中寻找a变量.可以通过这两个方式访问命名空间域。
变量优先局部域>全局域>命名空间域。
iii.使用using namespace 命名空间名称 引入
using namespce HY;
int main()
{
printf("%d\n", HY::a);
printf("%d\n", b);
Add(10, 20);
return 0;
}
3.C++输入和输出
#include<iostream>
// std是C++标准库的命名空间名,C++将标准库的定义实现都放到这个命名空间中
using namespace std;
int main()
{
int a;
cin>>a;
cout<<"Hello world!!!"<<endl;
return 0;
}
说明:
1. 使用cout标准输出对象(控制台)和cin标准输入对象(键盘)时,必须包含< iostream >头文件
以及按命名空间使用方法使用std。
2. cout和cin是全局的流对象,endl是特殊的C++符号,表示换行输出,他们都包含在包含<
iostream >头文件中。
3. <<是流插入运算符,>>是流提取运算符。
4. 使用C++输入输出更方便,不需要像printf/scanf输入输出时那样,需要手动控制格式。
C++的输入输出可以自动识别变量类型。
| std命名空间的使用惯例:std是C++标准库的命名空间,如何展开std使用更合理呢? |
1. 在日常练习中,建议直接using namespace std即可,这样就很方便。
2. using namespace std展开,标准库就全部暴露出来了,如果我们定义跟库重名的类型/对
象/函数,就存在冲突问题。该问题在日常练习中很少出现,但是项目开发中代码较多、规模
大,就很容易出现。所以建议在项目开发中使用,像std::cout这样使用时指定命名空间 +
using std::cout展开常用的库对象/类型等方式。
4.缺省参数
缺省参数是声明或定义函数时为函数的参数制定一个缺省值,调用该函数时有指定实参,优先使用指定实参,如果没有指定实参,就采用该形参的缺省值。
举个例子
void Func(int a = 0)
{
cout<<a<<endl;
}
int main()
{
Func(); // 没有传参时,使用参数的默认值
Func(10); // 传参时,使用指定的实参
return 0;
}
缺省参数分为全缺省参数(为每一个形参都指定一个缺省值)和半缺省参数(部分形参指定)。
void Func(int a = 10, int b = 20, int c = 30)
{
cout<<"a = "<<a<<endl;
cout<<"b = "<<b<<endl;
cout<<"c = "<<c<<endl;
}//全缺省参数
void Func(int a, int b = 10, int c = 20)
{
cout<<"a = "<<a<<endl;
cout<<"b = "<<b<<endl;
cout<<"c = "<<c<<endl;
}//半缺省参数
注意:
1.从左往右传参,从右往左缺省。半缺省参数必须从右往左依次给出,不能间隔着给。
2.缺省参数不能在函数声明和定义中同时出现,声明给定义不给。
3. 缺省值必须是常量或者全局变量。
4.C语言不支持
5.函数重载
函数重载是函数的一种特殊情况,C++允许在同一作用域中声明几个功能类似的同名函数。这些同名函数的形参列表(参数个数或参数类型或参数类型顺序不同)不同,常用来处理实现功能类似数据类型不同的问题。
如下:
#include<iostream>
using namespace std;
// 1、参数类型不同
int Add(int left, int right)
{
cout << "int Add(int left, int right)" << endl;
return left + right;
}
double Add(double left, double right)
{
cout << "double Add(double left, double right)" << endl;
return left + right;
}
// 2、参数个数不同
void f()
{
cout << "f()" << endl;
}
void f(int a)
{
cout << "f(int a)" << endl;
}
// 3、参数类型顺序不同
void f(int a, char b)
{
cout << "f(int a,char b)" << endl;
}
void f(char b, int a)
{
cout << "f(char b, int a)" << endl;
}
int main()
{
Add(10, 20);
Add(10.1, 20.2);
f();
f(10);
f(10, 'a');
f('a', 10);
return 0;
}
下面这个例子是重载,但是存在无参调用时的歧义。
void f()
{
cout<<"f()"<<endl;
}
void f(int a=0)
{
cout<<"f(int a)"<<endl;
}
为什么C语言无法构成重载,C++可以?
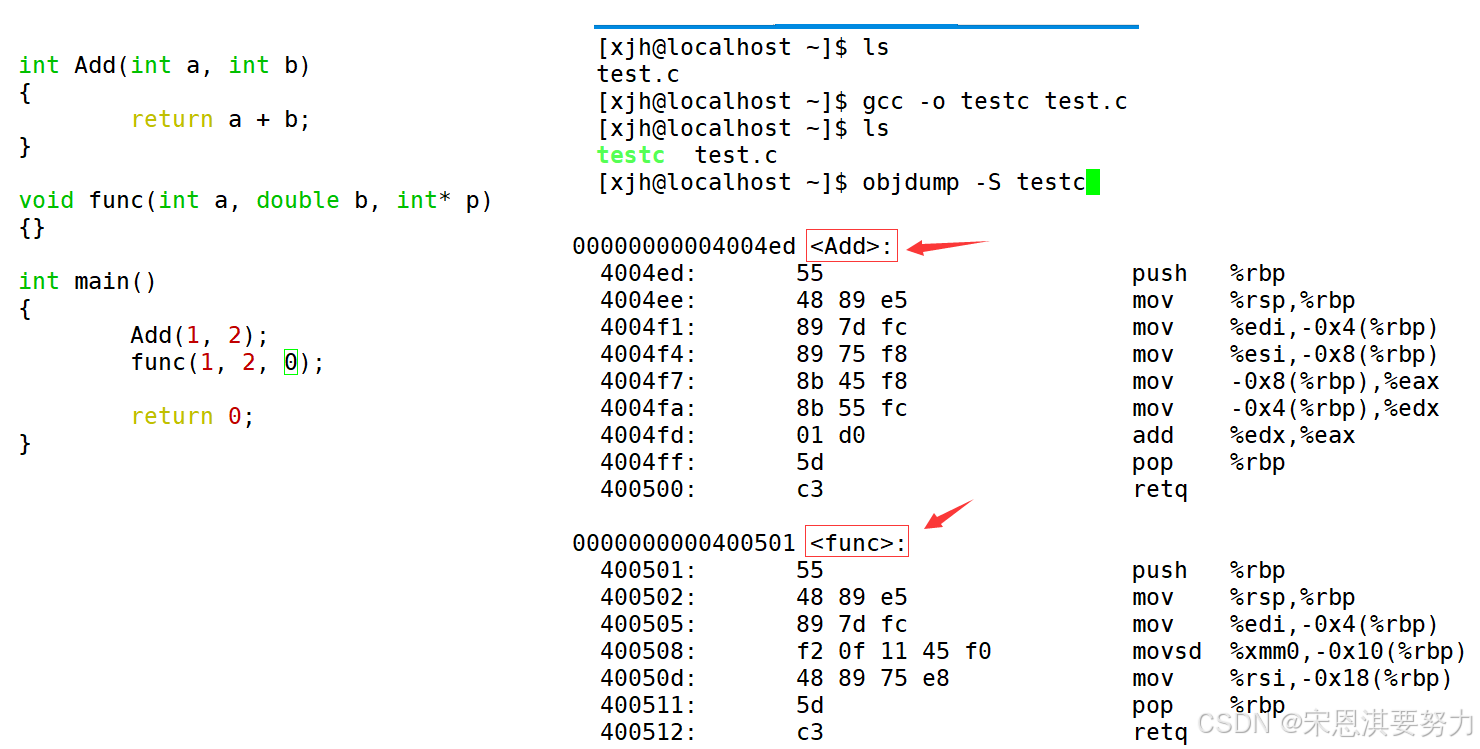
采用C语言编译器
在linux下,采用gcc编译完成后,函数名字的修饰没有发生改变。
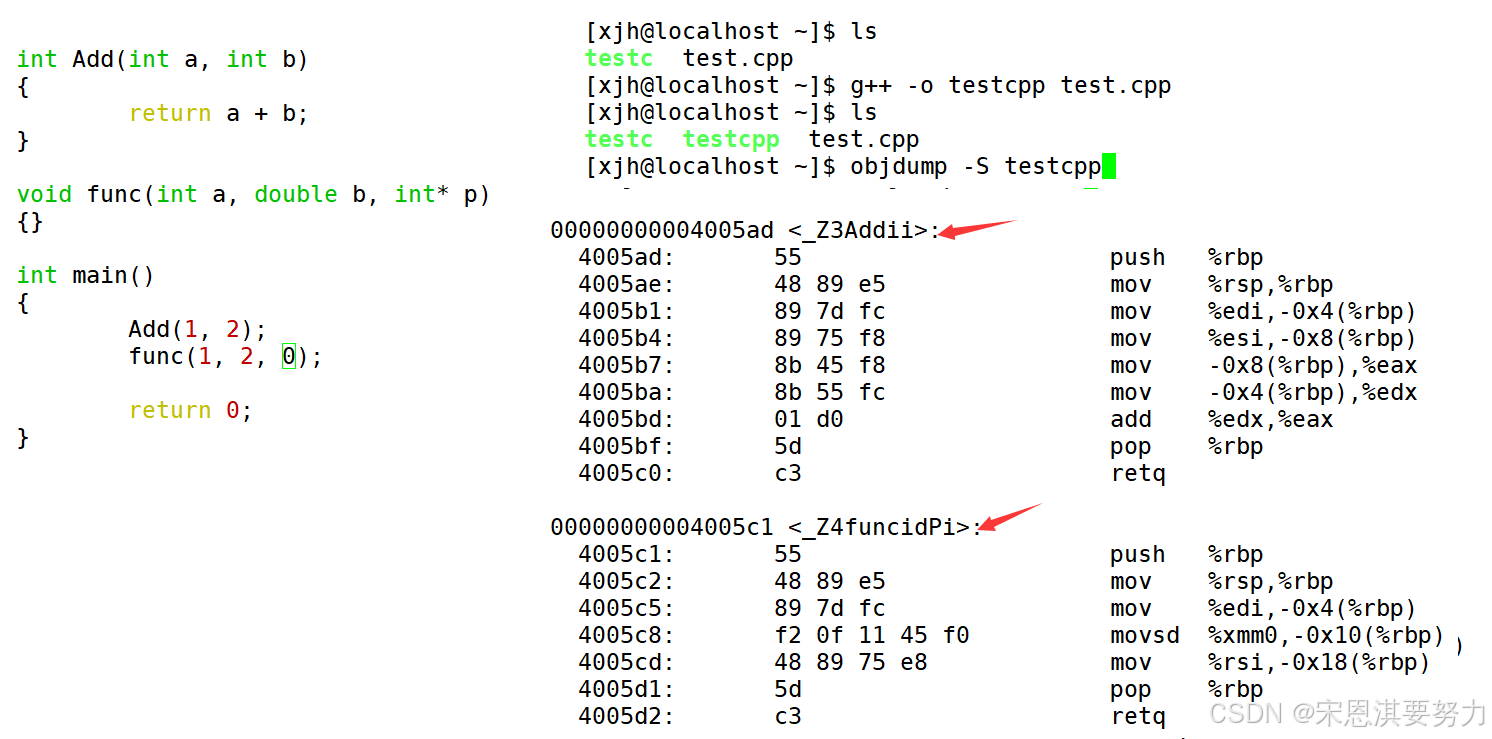
采用C++编译器
在linux下,采用g++编译完成后,函数名字的修饰发生改变,编译器将函数参数类型信息添加到修改后的名字中。
通过这里就理解了C语言没办法支持重载,因为同名函数没办法区分。而C++是通过函数修饰规则来区分,只要参数不同,修饰出来的名字就不一样,就支持了重载。
如果两个函数函数名和参数是一样的,返回值不同是不构成重载的,因为调用时编译器没办
法区分。
6.引用
1.引用概念
引用不是定义了一个新变量,而是给以存在的变量取了别名,它和它引用的变量共用一块内存空间。举个形象的例子:李逵在家里被称为铁牛,在江湖上被称为黑旋风。
类型&引用变量名(对象名)=引用实体
void TestRef()
{
int a = 10;
int& ra = a;//<====定义引用类型
printf("%p\n", &a);
printf("%p\n", &ra);
}形参是实参的别名,我们知道在调用swap函数的时候,必须传址调用,否则函数结束,栈回收空间,不会改变原来实参的值。但是学习了引用我们就可以这么声明。
void swap(int &a,int&b);同理,在链表尾插的时候,由于要修改链表的头指针,需要传二级指针,但是现在就可以这么声明。
void ListPushback(struct ListNode*&phead,int x);注:引用类型必须和引用实体同类型。
2.引用特性
1)引用在定义时必须初始化
2)一个变量可以有多个引用,一个引用只能引用一个实体。如下:
void TestRef()
{
int a = 10;
// int& ra; // 该条语句编译时会出错
int& ra = a;
int& rra = a;
printf("%p %p %p\n", &a, &ra, &rra);
}3)引用过程中权限不能放大,只能平移或缩小。
下面举例充分理解!!
1.const int a=0;
int &b=a;//错误,引用过程中权限不能放大。
2.const int c=0;
int d=c;//正确,只是将c的值拷贝给d,没有放大权限,d改变不影响c。
3.int x=0;
int &y=x;
const int&z=x;//正确,权限可以平移或缩小。
++x;//正确,y,z的值也会跟着改变
++z;//错误,x,y可以改变,z不可以
4.int func1()
{
static int x=0;
return x;
}
int &func2()
{
static int x=0;
return x;
}
int&ret1=func1();//权限放大
const int&ret1=func1();//权限平移
int ret1=func1();//拷贝
int &ret2=func2();//权限平移
const int&ret2=func2();//权限缩小
3.常引用
void test()
{
    const int a = 10;
    int& ra = a;   // 该语句编译时会出错,a为常量
    //正确写法:const int& ra = a;

    const int& ra = a;
    int& b = 10; // 该语句编译时会出错,b为常量
    //正确写法:const int& b = 10;

    const int& b = 10;
    double d = 12.34;
    int& rd = d; // 该语句编译时会出错,类型不同
    //正确写法:const int& rd = d;
}
4.使用场景
- 做输出型参数,提高效率(一般是大对象/深拷贝类对象)
void Swap(int& left, int& right) { int temp = left; left = right; right = temp; } - 做返回值,相较于普通传值访问,不会产生临时变量,减少了值拷贝的过程,引用传值访问可以修改返回的结果。
- 注:引用返回时返回的必须是静态变量(静态局部变量生命周期是整个程序运行的周期,不会在函数调用时被销毁)(如情况1)或者是堆上的变量
int& Count()
{
   static int n = 0;//情况1
   int n=0;//情况2
   n++;
   // ...
   return n;
}
int ret=Count(n);
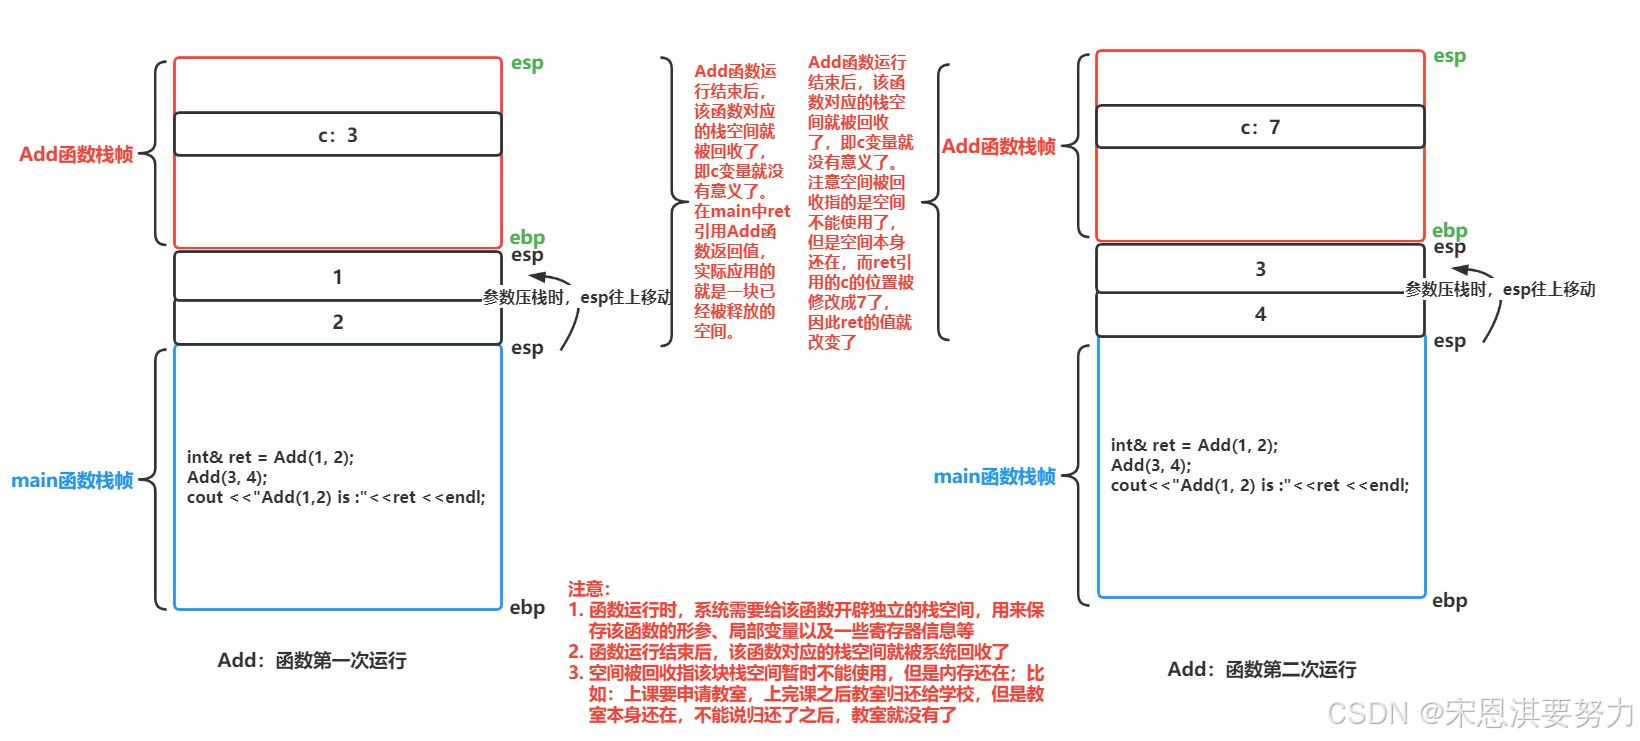
如果为情况2,count函数结束,栈帧销毁,没有清理栈帧,那么ret结果侥幸正确,若清理了栈帧,则ret的结果为随机值(因为调用其他函数建栈帧时可能会覆盖)。
下面代码输出什么结果?为什么?
{
int& Add(int a, int b)
int c = a + b;
return c;
}
int main()
{
int& ret = Add(1, 2);
Add(3, 4);
cout << "Add(1, 2) is :"<< ret <<endl;
return 0;}//结果ret=7
总结:基本任何场景都可以用引用传参,但是用引用返回时要注意:
如果函数返回时,出了函数作用域,如果返回对象还在(还没还给系统),则可以使用引用返回,如果已经还给系统了,则必须使用传值返回。 (常见的正确案例:static修饰的,malloc)
5.引用和指针的区别
1.在语法概念上引用就是一个别名,没有独立空间,和其引用实体共用同一块空间。
int main()
{
int a = 10;
int& ra = a;
cout<<"&a = "<<&a<<endl;
cout<<"&ra = "<<&ra<<endl;
return 0;}2.在底层实现上实际是有空间的,因为引用是按照指针方式来实现的。
int main()
{
int a = 10;
int& ra = a;
ra = 20;
int* pa = &a;
*pa = 20;
return 0;
}
对比引用和指针的汇编代码:
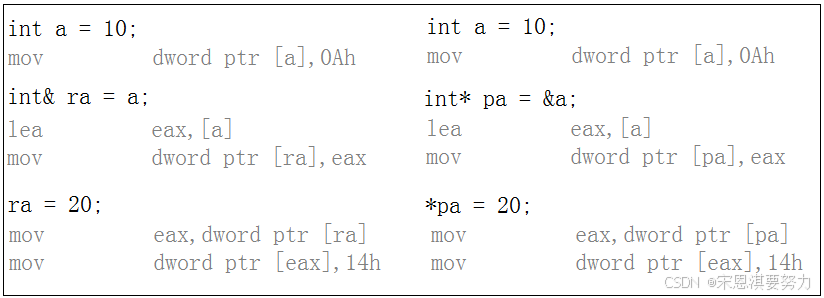
引用和指针的不同点:(面试常考,理解记忆)
1. 概念上引用定义一个变量的别名,指针存储一个变量地址。 2. 引用在定义时必须初始化,指针没有要求 3. 引用在初始化时引用一个实体后,就不能再引用其他实体,而指针可以在任何时候指向任何 一个同类型实体 4. 没有NULL引用,但有NULL指针 5. 在sizeof中含义不同:引用结果为引用类型的大小,但指针始终是地址空间所占字节个数(32 位平台下占4个字节) 6. 引用自加即引用的实体增加1,指针自加即指针向后偏移一个类型的大小 7. 有多级指针,但是没有多级引用 8. 访问实体方式不同,指针需要显式解引用,引用编译器自己处理9. 引用比指针使用起来相对更安全
7.内联函数
1.概念
以inline修饰的函数叫做内联函数,一般而言编译时C++编译器会在调用内联函数的地方展开(类似于宏,但是宏由于操作符的优先级需要添加多个括号,如下实现一个简单的加法)。
#define Add(a,b) ((a) + (b))
【面试题】宏的优缺点?
优点:
1.增强代码的复用性。
2.提高性能。 缺点:
1.不方便调试宏。(因为预编译阶段进行了替换)
2.导致代码可读性差,可维护性差,容易误用。3.没有类型安全的检查 。
C++有哪些技术替代宏? 1. 常量定义 换用const enum2. 短小函数定义 换用内联函数
因此为了避免这种错误,C++新增了内联函数inline来解决这个问题。不需要刻意的写很多括号来保证操作符的正确使用顺序。
2.inline的特性
- inline是一种以空间换时间的做法,如果编译器将函数当成内联函数处理,在编译阶段,会用函数体替换函数调用,缺陷:可能会使目标文件变大,优势:少了调用开销,提高程序运行效率。
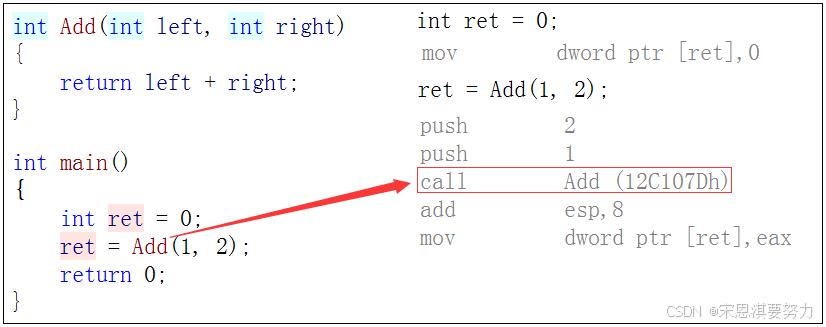
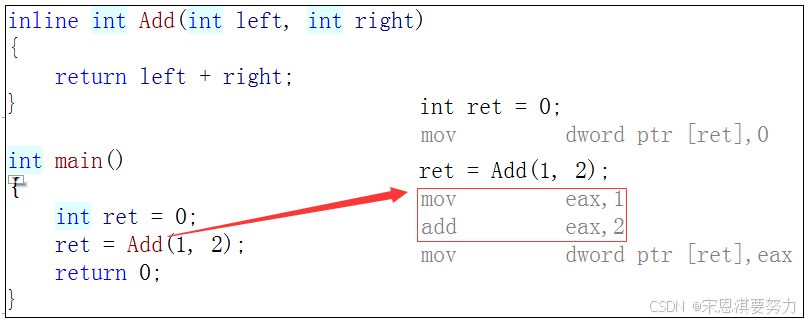
- inline对于编译器而言只是一个建议,不同编译器关于inline实现机制可能不同,一般建议:将函数规模较小(即函数不是很长,具体没有准确的说法,取决于编译器内部实现)、不是递归、且频繁调用的函数采用inline修饰,否则编译器会忽略inline特性。
- inline建议直接定义在源文件,不建议声明和定义分离,分离会导致链接错误。因为inline被展开,就没有函数地址了,链接就会找不到。
- 可以在同一个项目的不同源文件内定义函数名相同但实现不同的inline函数
8.auto关键字
auto 会自动推出变量的类型,在对于一些变量类型比较长不方便书写时可以用到。
使用auto定义变量时必须对其进行初始化,在编译阶段编译器需要根据初始化表达式来推导auto的实际类型。因此auto并非是一种“类型”的声明,而是一个类型声明时的“占位符”,编译器在编译期会将auto替换为变量实际的类型。
int TestAuto()
{
return 10;
}
int main()
{
int a = 10;
auto b = a;
auto c = 'a';
auto d = TestAuto();
cout << typeid(b).name() << endl;
cout << typeid(c).name() << endl;
cout << typeid(d).name() << endl;
//auto e; 无法通过编译,使用auto定义变量时必须对其进行初始化
return 0;
}用auto声明指针类型时,用auto和auto*没有任何区别,但用auto声明引用类型时则必须加&
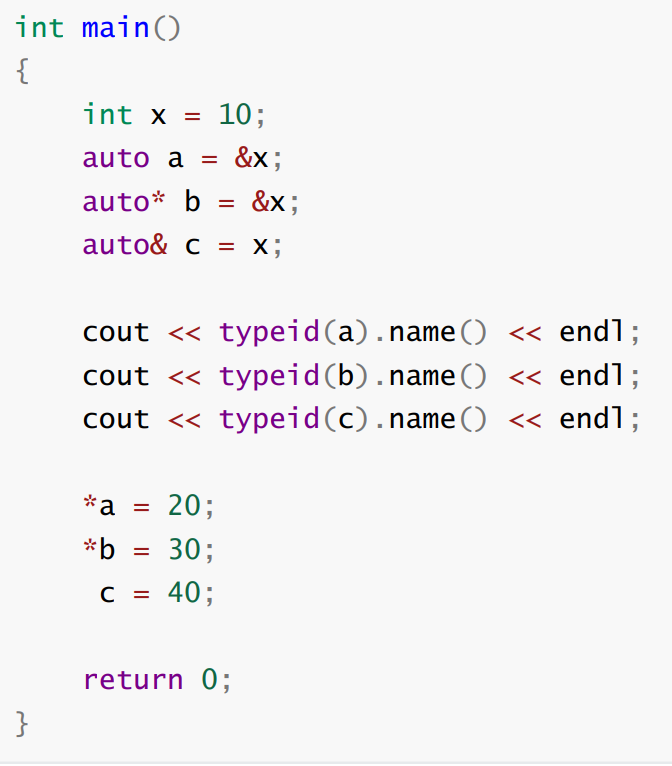
当在同一行声明多个变量时,这些变量必须是相同的类型,否则编译器将会报错,因为编译器实际只对第一个类型进行推导,然后用推导出来的类型定义其他变量
void TestAuto()
{
auto a = 1, b = 2;
auto c = 3, d = 4.0; // 该行代码会编译失败,因为c和d的初始化表达式类型不同
}
注:
- auto不能作为函数的参数。
- auto不能直接用来声明数组。
- 为了避免与C++98中的auto发生混淆,C++11只保留了auto作为类型指示符的用法。
- auto在实际中最常见的优势用法就是跟以后会讲到的C++11提供的新式for循环,还有lambda表达式等进行配合使用。
9.基于范围的for循环
对于一个有范围的集合而言,由程序员来说明循环的范围是多余的,有时候还会容易犯错误。
因此C++11中引入了基于范围的for循环。for循环后的括号由冒号“ :”分为两部分:第一部分是范围内用于迭代的变量,第二部分则表示被迭代的范围。与普通循环类似,可以用continue来结束本次循环,也可以用break来跳出整个循环。
void TestFor()
{
int array[] = { 1, 2, 3, 4, 5 };
for(auto& e : array)
e *= 2;
for(auto e : array)
cout << e << " ";
return 0;
}
实际过程是将arr中每个数放到e中乘以2,再将 arr 中的每一个数拿出来放到 e 中进行输出。
使用条件:
1.for循环迭代的范围必须是确定的
对于数组而言,就是数组中第一个元素和最后一个元素的范围;对于类而言,应该提供begin和end的方法,begin和end就是for循环迭代的范围。
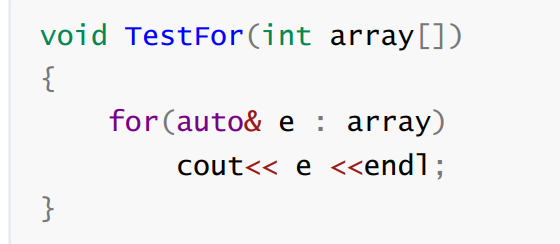
这样写就是有问题的,因为 for 的范围不确定。
2.迭代的对象要实现++和==的操作,这里针对的是类。
10.指针空值nullptr
在良好的C/C++编程习惯中,声明一个变量时最好给该变量一个合适的初始值,否则可能会出现不可预料的错误,比如未初始化的指针。如果一个指针没有合法的指向,我们基本都是按照如下方式对其进行初始化:
void test_ptr()
{
	int* p1 = NULL;
	int* p2 = 0;
	//……
}
NULL实际是一个宏,在传统的C头文件(stddef.h)中,可以看到如下代码:
#ifndef NULL
#ifdef __cplusplus
#define NULL   0
#else
#define NULL   ((void *)0)
#endif
#endif
可以看到,NULL可能被定义为字面常量0,或者被定义为无类型指针(void*)的常量。不论采取何种定义,在使用空值的指针时都不可避免的会遇到一些麻烦,比如:
void f(int)
{
 	cout<<"f(int)"<<endl;
}
void f(int*)
{
 	cout<<"f(int*)"<<endl;
}
int main()
{
 	f(0);
 	f(NULL);
 	f((int*)NULL);
 	return 0;
}
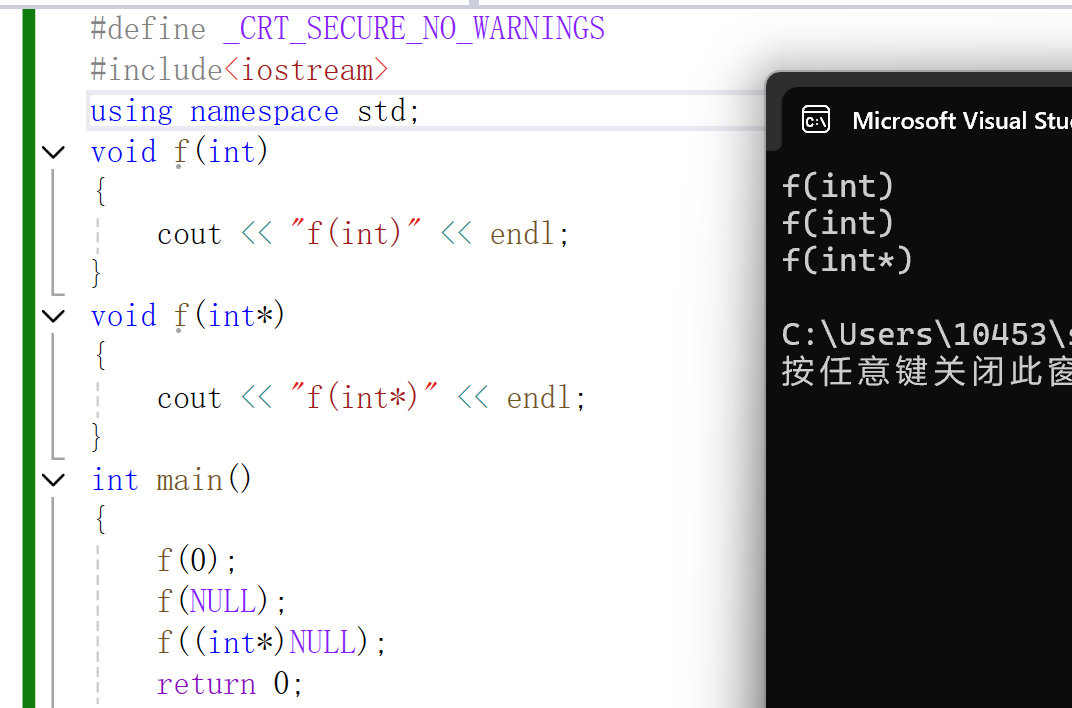
程序本意是想通过f(NULL)调用指针版本的f(int*)函数,但是由于NULL被定义成0,因此与程序的初衷相悖。
在C++98中,字面常量0既可以是一个整形数字,也可以是无类型的指针(void*)常量,但是编译器默认情况下将其看成是一个整形常量,如果要将其按照指针方式来使用,必须对其进行强转(void *)0。
注意:
- 在使用nullptr表示指针空值时,不需要包含头文件,因为nullptr是C++11作为新关键字引入的。
- 在C++11中,sizeof(nullptr) 与 sizeof((void*)0)所占的字节数相同。
- 为了提高代码的健壮性,在后续表示指针空值时建议最好使用nullptr。
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


