YOLO如何训练分类网络???

猫狗分类——yolo模型 本次做出的猫狗识别项目总的来说效果还是不错的,但是由于时间问题,我们的数据集不够大,猫狗的种类不够多,一些奇怪品种的狗是无法识别出来的,解决办法是扩大数据集,收集更多的特征,就可以完成各个品种狗类的识别,猫也是如此。对于本次实习,我的收获也是很多的,相较于学校,实习更加偏重于实际的操作,我们可以跟着老师一起分析代码,分析原理,结合代码可以让我对理论的学习更加高效,同时也会留下较深的印象,不会像纯学习理论那么无聊。 阅读详情

一般YOLO的工程应用直接上检测,源自作者提供了分类的预训练模型,但是如果自己改网络训练怎么办?预训练网络没有怎么办?

不怕,两种方法可以解决!

第一种:比较笨的方法,就是下载imagenet数据训练分类网络!

第二种:一层一层的改网路,每改一层,在原有预训练的条件下训练网络,生成新的模型时作为下一次修改网络的预训练模型!说的好像不是很清楚额,这个问题以后讨论!


今天讨论如何用yolo训练自己的分类模型!可见我们一般的分类工程都是通过caffe来做的,YOLO其实可以替代的,而且yolo是纯c,有着不可替代的优点!加上OpenBlas,效果不要太好了!


第一步:yolo配置

这个在本博文不提了,可参考我的系列博客http://blog.youkuaiyun.com/samylee/article/details/53414108


第二步:数据制作

没啥特殊要求,如下图所示,train保存训练图片,test保存测试图片,labels.txt为分类的标签,例如猫狗大战则为cat和dog!

注意一点就行,即图片名称为labels.txt中的一种,例如cat_1.jpg,cat为labels中的一种,后面_1随便写,只要没有dog就行!(WHY?全局搜索strstr函数即可豁然开朗)
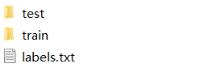
同时要分别生成train.list和test.list保存图片train和test的绝对路径,这个程序可以自己写一下啦,很简单!


第三步:数据配置文件制作

例如猫狗大战数据,cat_dog.data怎么写?如下:


classes=2
train  = data/cat_dog/train.list
valid  = data/cat_dog/test.list
labels = data/cat_dog/labels.txt
backup = cat_dog/backup/
top=2

很明显,classes表示几类,labels表示标签路径,backup表示要把模型存放在哪里,top表示准确率输出前几,类似caffe!


第四步:网络文件制作

cat_dog.cfg怎么写?如下:


[net]
batch=128
subdivisions=1
height=416
width=416
channels=3
max_crop=428
min_crop=428

hue=.1
saturation=.75
exposure=.75

learning_rate=0.1
policy=poly
power=4
max_batches = 5000
momentum=0.9
decay=0.0005

[convolutional]
batch_normalize=1
filters=32
size=3
stride=1
pad=1
activation=leaky

[maxpool]
size=2
stride=2

[convolutional]
batch_normalize=1
filters=64
size=3
stride=1
pad=1
activation=leaky

[maxpool]
size=2
stride=2

[convolutional]
batch_normalize=1
filters=128
size=3
stride=1
pad=1
activation=leaky

[convolutional]
filters=2
size=1
stride=1
pad=1
activation=leaky

[avgpool]

[softmax]
groups=1

[cost]
type=sse

很明显,max_crop表示原始图像大小,heights和weights表示剪切图像大小,最后一层conv输出为几类,这里比如猫狗为2!


第五步:训练

到了这一步,很舒服!终端写入如下命令即可:


./darknet classifier train cfg/cat_dog.data cfg/cat_dog.cfg

训练过程看啥呢?看loss,loss应该越来越小,最后趋于平稳!


第六步:测试

训练完毕过后,拿出训练结果的模型来测试,真皮!终端输入如下命令即可:


./darknet classifier predict cfg/cat_dog.data cfg/cat_dog.cfg cat_dog_final.weights data/dog.jpg

结束啦,终端可以看到输出两个结果(top=2),第一个即为判断的结果啦!


任何问题请加唯一QQ2258205918(名称samylee)  !!! 

或唯一VX:samylee_csdn

YOLO:目标检测和分类的介绍 YOLO 目标检测和分类的介绍 阅读详情

相关推荐

yolov8实战第四天——yolov8图像分类 && ResNet50图像分类(保姆式教程)

图像分类是指将输入的图像自动分类为不同的类别。它是计算机视觉领域的一个重要应用,可以用于人脸识别、物体识别、场景分类等任务。在实际应用中,可以使用各种深度学习框架(例如 TensorFlow、PyTorch、Keras 等)来构建图像分类模型,并使用各种数据增强技术(例如旋转、缩放、裁剪等)来增加数据集的多样性和数量。如果你想学习如何使用深度学习框架来构建图像分类模型,可以参考一些在线教程、书籍或者 MOOC。

qq_34717531的博客 3万+

基于YoloV5 multi task网络增加分类分支

YoloV5做目标检测任务,但是当我们需要对图像中的目标进行检测,还需要根据图像整体对该图像做分类时,我们可以在Yolo-Detect检测头前加一个分类分支,这样可以在共享Backbone情况下实现做检测任务,又做分类任务,下面具体介绍增加分类分支的操作方法简单记录一下,因为yolo版本也在不断更新,说一没有详细说明,简单对主要修改处标记了,如有类似修改需求。大致参照思路即可。不能全抄。

zengwb的博客 5348

【YOLO】单标签多分类、多标签分类及二分类概念区分

在机器学习和深度学习中,分类任务根据样本与标签的关联方式可分为三种主要类型:二分类、单标签多分类和多标签分类。二分类适用于预测样本属于两个互斥类别中的一个,如垃圾邮件检测,使用Sigmoid函数和二元交叉熵损失。单标签多分类用于预测样本属于多个互斥类别中的一个,如图像分类,使用Softmax函数和交叉熵损失。多标签分类则用于预测样本可能属于多个非互斥类别,如医学影像诊断,使用Sigmoid函数和二元交叉熵扩展损失。

浩瀚之水的专栏 997

超详细YOLOv8图像分类全程概述:环境、训练、验证与预测详解

总结来说,该内容提供了一个完整的YOLOv8项目运行指南,包括环境搭建、数据集准备、训练、验证和预测过程的详细说明,以及各个阶段所需参数的详细列表和解释。这为需要进行YOLOv8训练图片分类任务和部署的开发人员提供了一个相对较为详细的参考。希望大家能够喜欢,如果感觉哪里写的不清楚,可以留言,我这边会积极补充。

CDBmax的博客 4万+

模型训练篇 | YOLO11来了!手把手教你如何用YOLO11训练自己的数据集(含算法介绍 + 网络结构 + 模型训练等)

​YOLO11是一个尖端的、最先进(SOTA)的模型,基于之前YOLO版本的成功,并引入了新功能和改进以进一步提升性能和灵活性。YOLO11被设计得快速、准确且易于使用,是进行广泛对象检测和跟踪、实例分割、图像分类和姿态估计任务的理想选择。🌈

小哥谈 5555

Windows10下部署Heygem进行数字人生成

对于使用Heygem生成数字人,需要注意几个问题: + 需要使用Nvidia的显卡。 + 需要在Windows上进行本地部署。主要原因为客户端是Windows的,客户端对上传的视频写入硬编码的`D:\heygem_data\voice\data`目录,需要在容器上读取这些文件。 + 需要在Windows上部署Docker,将Windows的目录映射到容器中,由容器中的服务进行读取。 + 需要特别注意,一定要有D盘,这个D盘是Windows的D盘,不能是插入的USB设备后产生的D盘。 + 需要下载3个Doc

冀辉的博客 5619

YOLO-V5分类实战系列 —— 快速训练自己的数据集

YOLO-V5 训练自己的分类模型 1、获取官方源码 2、测试官方源码 2.1、公开数据集测试源码 3、源码模块解析 3.1、数据读取 4、快速开始训练自己的数据 4.1、准备自己的数据 4.2、配置训练参数

DAOCHI 1万+

(MIUI)小米手机录音文件深度寻踪:从系统缓存到数据目录的实战解析

本文深入解析了MIUI系统中录音文件丢失的常见原因及解决方案,包括系统升级兼容性问题、应用缓存机制异常和存储权限变动。通过实战操作指南,详细介绍了如何从系统目录、数据库层面恢复录音文件,并提供了预防措施和自动化备份方案,帮助小米手机用户有效找回重要录音数据。

weixin_42699679的博客 518

如何使用Ultralytics训练自己的yolo5 yolo8 yolo10 yolo11 yolo12等目标检测模型

Ultralytics正在以惊人的速度吸收优秀的CV算法,之前Ultralytics定位于YOLO8,但逐渐地扩展到支持其他版本的YOLO,最新版本的ultralytics全面支持yolo5yolo7yolo8yolo9yolo10yolo11。本文介绍如何用Ultralytics训练自己的yolo5yolo8yolo9yolo10yolo11模型,我们开门见山,直接步入正题。

qq_42681787的博客 2万+

c语言版数据结构课程设计 学生成绩管理系统

此学生成绩管理系统完成15项功能,是我经过很多次的修改得到的。花费时间不短,功能齐全,主要完成了:输入,输出,插入,修改,删除,查询,读取文件,写入文件,复制文件,建立索引,显示各种情况下的信息,追加学生信息等等功能。一共15项。   代码如下: // shujujiegou.cpp : 定义控制台应用程序的入口点。///**本程序采用数组链表形式,原因:数组查询速度快,数组也能实现动态存储

Java 1万+

摩尔线程嵌入式面试题及参考答案(2万字长文)

说一下你对 drm 框架的理解。 DRM(Direct Rendering Manager)是 Linux 系统中用于管理图形显示设备的一个重要框架。 从架构层面来讲,它处于内核空间,主要目的是为用户空间的图形应用程序提供一个统一的接口来访问图形硬件。DRM 包括内核态的驱动模块和用户态的库。内核态的驱动负责和硬件进行交互,比如对显存的管理、硬件寄存器的配置等。用户态的库则方便应用程序利用内核态提供的功能进行图形渲染等操作。 在图形显示的具体流程中,DRM 可以控制显示设备的分辨率、刷

大模型大数据攻城狮的专栏 1229

【数据集】【YOLO】【目标检测】车辆分类识别数据集 8457 张,YOLO车辆分类识别算法实战训练教程。

【数据集】【YOLO】【目标检测】车辆分类识别数据集 8457 张,YOLO车辆分类识别系统实战训练教程。 数据集中包含7种分类:names: ['bus', 'car', 'human', 'motobike', 'rect', 'square', 'truck'],代表大巴车、轿车、行人、摩托车、车牌、方形车、卡车。 大部分数据来源于无人机航拍视频截图、监控视频截图; 检测场景为道路、停车场等有车辆行驶的场景,用于智慧交通等,服务于道路监管、车流量管控等; yolo可视化界面开发。

CV 小涵的博客,计算机本硕211毕业,研究计算机视觉、模型微调、RAG等方向,收藏有国内外优质数据集,解决视觉相关项目方案,欢迎交流讨论。 8513

YOLO数据集实现数据增强的方法(裁剪、平移 、旋转、改变亮度、加噪声等)

数据集样本太少怎么办?数据集优质图像不够怎么办?如何做到更好的数据预处理?一文带你学会数据增强,还可实现带标签的扩充。

路人贾的博客 4万+

使用yolo训练自己的模型

YOLO(You Only Look Once)是一种用于目标检测的深度学习模型,旨在实时检测图像或视频中的多个对象。与传统的目标检测方法不同,YOLO一次性处理整个图像,而不是通过滑动窗口或区域提议进行多次检测。这种方法使得YOLO在速度上具有显著优势,能够实现实时目标检测。使用yoloV5训练自己的模型。关键特点:One-shot Detection: YOLO的主要特点是一次性完成整个图像的目标检测

qq_45688164的博客 1万+

半小时搞定Yolov5安装配置及使用(详细过程)

Yolov51. 下载Yolov52. 安装Yolov5 在下载配置Yolov5前,先要安装好Anaconda环境,可参考之前博文:最新Anaconda3的安装配置及使用教程(详细过程) 1. 下载Yolov5 首先下载Yolov5源码: Yolov5 Github地址:https://github.com/ultralytics/yolov5 直接git clone到本地工作目录,等待下载完成: Yolov5代码目录架构: 2. 安装Yolov5 源码下完后,下面开始安装Yolov5所需模块,

HowieXue 薛永浩的博客 12万+

FPGA DDR3实战(四):DDR地址映射自动化测试(1)—— 测试程序设计与代码逻辑

本文介绍了一种DDR地址映射自动化测试方案,旨在提高板卡调试效率。方案通过AXI4协议实现主从端通信,构建了包含地址控制器和测试数据生成器的模块化架构。测试程序支持突发传输、状态监控和错误检测,可灵活配置测试参数。采用状态机控制流程,先写入递增数据再读取比对,完成功能验证和性能评估。该方案可系统化验证DDR的正确性、稳定性和可靠性,相比传统手动测试显著提升效率。

FPGA_小田老师的博客 1977

【数据集+完整源码】【YOLO】垃圾分类数据集,垃圾分类识别数据集 2020 张,YOLO垃圾分类识别系统实战训练教程

【数据集】【YOLO】【目标检测】垃圾分类识别数据集 2020 张,YOLO垃圾分类识别系统实战训练教程,yolo垃圾分类识别。 包含5种分类:names:['glass', 'metal', 'paper', 'plastic', 'uht carton'],表示"玻璃瓶、易拉罐、纸、塑料、纸盒"。 数据集图片来自国内外网站、网络爬虫等; 检测场景为城市道路、公园、办公场所、垃圾回收工厂等需要垃圾分类的场景,可以应用于智能垃圾桶、垃圾回收站等场景,实现垃圾的分类。 基于QT的可视化界面详细教程。

CV 小涵的博客,计算机本硕211毕业,研究计算机视觉、模型微调、RAG等方向,收藏有国内外优质数据集,解决视觉相关项目方案,欢迎交流讨论。 9069

JEDEC 标准半导体功率循环热阻测试(JESD51 系列)

【代码】JEDEC 标准半导体功率循环热阻测试(JESD51 系列)

专注于前沿技术的探索与实践,热衷于从代码逻辑、架构设计到行业应用等多维度深挖技术本质。期待在技术之路上与你共同成长~ 467

YOLO神经网络

YOLO神经网络 本文准备详细介绍一下用于目标检测的YOLO神经网络,主要是个人研读《You Only Look Once: Unified, Real-Time Object Detection》与《YOLO9000: Better, Faster, Stronger》这两篇论文的所得,以及结合网上一些对YOLO网络的解读。 首先我想说明下我个人认为YOLO网络的核心突破点。 在基于神经网络的机器视觉领域,两个问题一直居于核心,大部分流传甚广的优秀网络架构基本都是围绕这两个问题展开的,一个是目标识别,一个

weixin_42708301的博客 9321

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

小白也能弄得懂的YOLO系列之YOLOv1网络训练

上期给大家介绍了YOLO模型的检测系统和具体实现,YOLO是如何进行目标定位和目标分类的,这期主要给大家介绍YOLO是如何进行网络训练的,话不多说,马上开始!前言:输入图片首先被分成S*...

哆啦A梦爱学习的博客 1613

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

一种联合分类与检测训练的方法——YOLO9000

文章目录1.YOLO9000介绍1)Hierarchical classification(分层分类)2)Dataset combination with WordTree(使用WordTree组合数据集)3)Joint classification and detection(联合分类与检测)2.总结 yolo9000是yolov2论文中的Stronger章节的内容,由于在查找总结yolov2的时候要看yolo9000看得有点迷糊,想以这篇文章进行进一步的总结与归纳。 有关yolov2的内容,此处不再提及

Clichong 2416

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Ultralytics YOLO 手写数字分类实战:MNIST 数据集完整训练指南

MNIST(Modified National Institute of Standards and Technology)是图像分类领域沿用最久的标准基准数据集,包含 7 万张 28×28 的灰度手写数字图片,覆盖 0–9 共 10 个类别。本文基于 Ultralytics 仓库中的 [MNIST 数据集文档](https://link.gitcode.com/i/07d26f713a1472b

gitblog_00740的博客 974

【YOLO】目标检测第三步——用Pascal voc 2012 数据集训练YOLO网络

0. 引言 一般博主都会说对YOLO网络训练都是通过自制的训练集,这是能一次性完成YOLO网络的参数设置,但对于之前根本没有接触过这类知识的小白,我决定慢慢来,用其他数据集尝试训练网络。 此步骤的目的在于: 1. 认识Pascal voc 2012 数据集; 2. 了解数据集的格式; 3. YOLO训练参数的配置; 4. 训练一次的大致时间。 训练的环境:CPU为Intel® Core™ i7-6700HQ CPU,GPU0为Inte® HD Graphics 530,GPU1为NVIDIA Geforce

weixin_42442319的博客 1万+

训练YOLO网络

作为目前机器学习领域最火热的研究方向之一,计算机视觉相关的技术一直备受关注。其中,目标检测是计算机视觉领域常见的问题之一,如何平衡检测的质量和算法的速度很重要。对于这个问题,计算机视觉工程师、VirtusLab 创始人 Piotr Skalski 发表了自己的心得,分享了关于他最喜欢的计算机视觉算法 YOLO 的实践资料。 以下便是他的全文。 前言 YOLO 是我最喜欢的计算机视觉算法之一,在很长...

TSINGHUAJOKING 1820

Yolo迁移训练-带训练源码

从头到尾的详细说明:Git下载、下拉仓库、如何准备训练集、训练脚本撰写

2301_78856868的博客 3159

Ultralytics YOLO 图像分类实战:在 Fashion-MNIST 数据集上训练 YOLO 分类模型

本篇技术指南围绕 [Fashion-MNIST 数据集文档](https://link.gitcode.com/i/31d2a11c800e09f2621588ba5460b5db) 展开,系统讲解这个 70,000 张 28×28 灰度服装图像基准的数据结构与划分方式,并基于 Ultralytics 仓库源码印证 `yolo classify train` 的底层实现——包括 [Classifi

gitblog_00284的博客 678
上一篇: c++入侵警报之消息机制
下一篇: LeeNet分类网络(ImageNet100(已开源):top1-73.44%,top5-91.40%,CPU_forward-30ms,model_size-2.7M)
samylee
博客等级 码龄11年 585粉丝 92原创
评论 6
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值